登录社区云,与社区用户共同成长
邀请您加入社区
计算机专业同学写开题,真的是!代码会敲、系统会跑、算法会调,唯独开题报告次次被导师驳回:选题太大太空、技术栈胡乱堆砌、研究背景全是套话、文献综述只会抄、技术路线逻辑混乱、系统模块拆分不清、创新点完全不落地。计科开题最忌讳 “泛技术堆砌”,很多同学堆叠大模型、微服务、深度学习,却写不出。一边要查海量前沿文献、梳理技术架构,一边要完善研究内容、可行性分析、创新点,反复改稿多轮,开题答辩临近直接焦虑爆棚
本文系统梳理了学习人工智能所需的核心基础知识,涵盖数学(线性代数、微积分、概率统计)、编程(Python及数据处理)、算法与数据结构(排序、树图等)、计算机基础(组成原理、网络)以及逻辑思维能力。强调扎实基础对掌握AI技术的重要性,并提供免费学习资料获取途径,助力初学者高效入门人工智能领域。
这份清单主要内容如下图所示,主要有3大部分,分别为python编程、机器学习和深度学习,在学习理论知识的同时注重实战,让大家快速上手。在各个部分,本文还推荐了学习图书和视频,可以帮助大家高效学习。
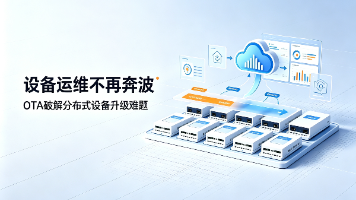
对于物联网项目团队而言,硬件交付落地仅仅是业务的起点。大量终端设备分散部署在工厂车间、楼宇机房、能源场站乃至野外作业站点,每次固件需要更新、应用补丁需要修复,设备升级就成为一大难题。:设备点位分散,固件更新需要人员实地出差,人力、差旅成本随设备规模攀升;:传统本地刷机需要逐台操作,批量升级动辄耗时数周乃至数月;:站点断电、网络波动易造成升级中断,引发设备“变砖”;:设备型号、批次繁杂,易出现升级包
使用 Python 和 NumPy 从零实现神经网络。数据标准化可以加快收敛。超参数包括层数、单元数、学习率、轮数等。正向传播、反向传播、参数更新是训练的三个核心步骤。小批量梯度下降是标准训练方法。使用 MNIST 实现手写数字识别。卷积神经网络实现使用 im2col 和 col2im 变换。ReLU 和 softmax 是卷积神经网络常用函数。权重初始化很重要,He 初始化适合 ReLU。卷积神
EMA(指数移动平均)是深度学习中广泛使用的平滑更新机制,其核心公式为 $v_t = \beta v_{t-1} + (1-\beta)\theta_t$,通过指数衰减历史数据权重,实现对新数据的渐进式融合。它具备三大优势:天然抗噪、极低显存开销(仅需存储前一状态)、自动遗忘过时信息。形象比喻如“熬百年老汤”,既保留历史底蕴又融入新鲜成分。$\beta$ 控制记忆窗口,常用于模型权重平滑、动量编码
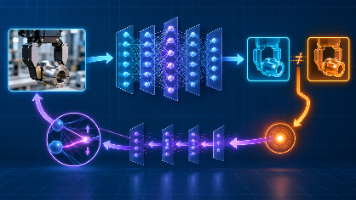
本文以机械臂视觉识别与多传感器状态判断为线索,解释深度学习为何能从原始数据中逐层形成有用特征。神经网络并不是凭空“看懂”图像,而是在损失函数与反向传播的反馈下,学习一组连续变换:浅层先保留边缘、颜色、局部波动等低级模式,中层把它们组合为纹理、轮廓和零部件,高层再形成与姿态、类别或故障状态相关的抽象表示。文章同时说明自动特征提取依赖数据、网络结构与训练目标三者共同约束,并澄清“特征可视化”不等于模型
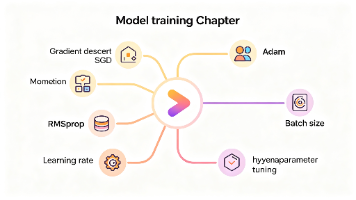
本章系统讲解深度学习模型训练的核心算法。从基础的梯度下降法出发,介绍随机梯度下降(SGD)及其小批量变体,提升计算效率并增强跳出局部最优的能力。引入动量机制,通过积累历史梯度方向加速收敛、减少震荡。重点阐述Adam优化器——结合动量与自适应学习率,实现高效稳定的参数更新。最后探讨学习率、批量大小等超参数的选择策略,并通过实验对比不同优化器的收敛性能,揭示其在实际训练中的应用价值。
广度优先搜索是图论中最基础和最重要的算法之一。它通过逐层扩展的方式遍历图,保证在无权图中找到最短路径。BFS的简单性和可预测性使其成为许多图算法的基础。从社交网络分析到网页爬虫,从迷宫寻路到人工智能的状态空间搜索,BFS的身影无处不在。虽然BFS在某些场景下可能不如其他算法高效,但其保证最优性和简单实现使其成为计算机科学教育中的经典算法。BFS的思想不仅限于图遍历,还广泛应用于各种需要逐层处理的算
智能体是能感知环境并自主行动以达成目标的实体,历经反射型、学习型演进,现基于大模型的智能体具备规划、推理、工具调用与动态修正能力。与固定流程的工作流不同,智能体可动态适应任务变化。平台如dify、coze降低了开发门槛,推动AI应用普及。未来,随着大模型发展,智能体将向通用人工智能、个性化助手及脑机融合方向迈进,为普通人带来更智能便捷的生活体验。
本文针对多层感知机(MLP)在图像识别中丢失空间信息、缺乏平移不变性的缺陷,引入卷积神经网络(CNN)实现手写数字识别。通过卷积层提取局部特征,池化层降维去冗余,结合全连接层分类,有效保留图像二维结构,提升模型精度。实验表明,该CNN模型测试准确率达99.41%,显著优于MLP,验证了CNN在图像任务中的优越性。
Agent 并不是一个新概念。Agent 是能够感知环境(Perceive)、做出决策(Decide)并采取行动(Act)以最大化某个目标或奖励信号的实体。这个定义来自 Russell 和 Norvig 的经典教材《人工智能:一种现代方法》,也是整个 RL 领域的公理式起点。在 RL 的语境下,Agent 与环境的交互构成一个马尔可夫决策过程(MDP):在每个时间步,Agent 观察到状态,根据策
前几天一个硕士期间搞的朋友,考上了某大学的人工智能博士,有点焦虑,我们聊了聊。他焦虑的重点主要集中在硕士期间一直在做材料相关的课题,编程基础薄弱,参与的人工智能课题少,担心读了博士之后,会很难上手相关的项目,做起来会很费劲。在我们沟通的过程中,我的一个观点是:人工智能专业的博士这个机会很难得,我建议把握住(博士是一辈子的事,不论以后在哪里做什么,都要相信”流水的工作,铁打的博士”,况且他考的还是个
<think>我们只需要根据内容生成摘要。内容讲了六类岗位职责要求、学习路径等。摘要要≤150字。需要概括主要信息,包括岗位分类、学习路径、就业前景和资源。注意字数。</think>大模型领域六大类岗位(研发、算法、数据、产品、深度学习、垂直应用)职责各异,需掌握相应技术与行业知识。提供从入门到精通的学习路径,助读者明确方向,应对巨大人才缺口,并附免费资源,就业前景广阔。
在这项研究中,使用卷积神经网络长期短期记忆的深度学习算法(CNN-LSTM)来分类各种珠宝岩石,如玛瑙、绿松石、方解石和天青,这些岩石来自不同历史时期和与沙尔-e Sokhteh相关的风格。所提出的方法具有较高的准确度,证实了该方法在识别过程中的有效性和适用性。值得一提的是,岩石的基质成分复杂,不同种类的LiBS等离子体的发射光谱频率和强度不同。为了将学习数据改变为可解释的信息,并另一方面包含使用
本文汇总 2026 年 10 月 EI、Scopus 可检索国际学术会议资源,涵盖人工智能、信息与控制、能源环境、计算机科学与技术等多个研究领域,面向硕博毕业、职称晋升、评奖评优的科研人群,梳理高适配度会议清单,便于科研人员快速筛选方向匹配的投稿渠道,助力科研成果高效发表。
摘要: 未来十年(2025–2035),多模态大模型(MLLM)将向端到端原生、多任务智能体平台演进,核心能力包括原生多模态、任意输入输出、边缘化及合规治理。发展分为三阶段:原生化起步(统一表征)、扩展规模化(多模态智能体)、普适治理化(机器人/公共服务)。北京将聚焦工业质检、政务文档等场景,需解决模态偏差、长尾泛化等挑战,最终实现可规模化、可治理的实体世界智能交互。
为解决传统差分进化算法(DE)在复杂函数寻优中易陷入局部最优、参数敏感性强及鲁棒性不足的问题,本文以L-SHADE-SPACMA算法为研究对象,系统开展其与传统DE算法在CEC2005标准测试函数集上的寻优性能对比研究。通过理论剖析两种算法的核心机制,结合单峰、多峰、混合复合四类函数的实验验证,从平均最优适应度、收敛速度、成功率及参数敏感性等维度量化分析性能差异。
为解决传统差分进化算法(DE)在复杂优化问题中易陷入局部最优、收敛速度慢及参数敏感性强的缺陷,本文聚焦DE算法及其代表性改进变体——自适应权重差分进化算法(JaDE),以CEC2005测试函数集为基准,开展系统性寻优性能对比研究。首先阐述DE算法的基本原理与操作流程,剖析其参数固定导致的性能瓶颈;随后深入解析JaDE算法在变异策略、参数调整及种群多样性维持方面的核心改进机制,包括自适应变异策略选择
C++中为了避免引入太多运算符,会复用C语言的一些符号,比如前面的<<和>>,这里引用也和去地址使用同一个符号&,要注意区分,但是个人觉得用更多符号反而更好,不容易混淆在这里插入图片描述创建i这个变量的时候会开辟一块空间叫i,int& j = i,就是给这块空间又去了一个名字叫j,还可以再取一个名字叫k在这里插入图片描述在这里插入图片描述引用可以给一个变量取多个别名,也可以给别名取别名。
💥💥💞💞❤️❤️💥💥博客内容尽量做到思维缜密,逻辑清晰,为了方便读者。⛳️行百里者,半于九十。
• 仿函数的类名是编译按⼀定规则⽣成的,保证不同的 lambda ⽣成的类名不同,lambda参数/返回类型/函数体就是仿函数operator()的参数/返回类型/函数体, lambda 的捕捉列表本质是⽣成的仿函数类的成员变量,也就是说捕捉列表的变量都是 lambda 类构造函数的实参,当然隐式捕捉,编译器要看使⽤哪些就传那些对象。• 在学习 lambda 表达式之前,我们的使⽤的可调⽤对象只有
代码语言:javascriptAI代码解释。
在大数据技术迅猛发展与精准医疗理念深度普及的双重推动下,肿瘤诊疗已逐步从“经验驱动”向“数据驱动”转型。多模医学图像融合算法作为整合多源影像信息的核心技术,能够打破单一模态医学图像的局限性,将CT、MRI、PET、SPECT等不同成像技术的优势互补,结合大数据时代海量肿瘤影像数据的支撑,为肿瘤的早期筛查、精准诊断、个性化治疗及疗效评估提供全方位的决策支持,成为当前医学影像领域与肿瘤诊疗交叉研究的热
💛博主介绍:大家好,我是码趣猪仔,一名拥有4年码龄的全栈程序员,Java/Python/Node 三系驾照,SpringCloud + Vue3 + 小程序 + DevOps一条龙能自己跑通,也是一位计算机老学长(本科专业计算机科学与技术)。从 0 到 1 写过 200+ 商业项目,代码量 100w+ 行,大二靠卖校园小程序赚到第一桶金 20w;大四毕业 3 个月拉起 10 人远程团队,年流水
动态多目标优化问题(Dynamic Multi-Objective Optimization Problems, DMOPs)广泛存在于智能交通、能源管理、工业调度等实际场景中,其核心特征是目标函数、约束条件或决策空间会随时间动态变化,导致帕累托最优解集(Pareto Optimal Set, POS)和帕累托最优前沿(Pareto Optimal Front, POF)持续迁移。与静态多目标优化
差分进化算法(Differential Evolution, DE)作为一种经典的全局优化算法,因其结构简单、鲁棒性强、易于实现的特点,在连续变量优化领域得到广泛应用,但固定参数设置导致其在复杂多模态优化问题中易陷入局部最优、收敛精度不足。
动态多目标优化问题(Dynamic Multi-Objective Optimization Problems, DMOPs)广泛存在于智能交通、能源管理、工业调度等实际工程领域,其核心特征是目标函数、约束条件或决策空间随时间动态变化,导致帕累托最优解集(Pareto Optimal Set, POS)和帕累托最优前沿(Pareto Optimal Front, POF)持续迁移,对算法的动态适应
本研究基于Keras框架开发深度学习图像分类系统,采用"数据驱动-模型构建-性能优化-系统实现"技术路线。通过构建多模态数据集、设计改进的CNN架构(引入残差连接和动态学习率),建立多粒度评估体系,最终实现具备可视化功能的端到端分类系统。实验表明系统在标准测试集上表现优异,未来可拓展Transformer架构、跨领域迁移学习等方向。系统采用Python+Django+Vue.j
本文针对2024年提出的12种新型元启发式算法(APO、BKA、CPO、HLOA、NRBO、GOOSE、HO、IVY、PKO、RBMO、SBOA、SSOA),通过CEC2021测试集进行系统性性能评估。实验采用10个基准函数(含单峰、多峰、混合及复合函数),测试维度为20维,通过Friedman排名、Wilcoxon秩和检验、收敛曲线、平均值与标准差、箱型图等五种指标,对比算法在寻优精度、收敛速度
语法规则:lambda表达式可以看成是一般函数的函数名被略去,返回值使用了一个 -> 的形式表示。有时候,需要在匿名函数内使用外部变量,所以用捕获列表来传递参数。手动书写捕获列表有时候是非常复杂的,这种机械性的工作可以交给编译器来处理,这时候可以在捕获列表中写一个。但是如果函数体内有多个return语句时,编译器无法自动推断出返回类型,此时必须指定返回类型。与参数传值类似,值捕获的前提是变量可以拷
春节的年味渐渐消散,程序员群体也悄然迎来了新一轮的职业挑战与机遇——在行业普遍追求降本增效的大背景下,单纯的基础开发已难以形成核心竞争力,如何通过技术深耕、抓住新兴赛道,实现个人职业价值的跨越式提升,成为每一位程序员不得不思考的问题。这场关乎职业发展的“硬仗”,正随着春节后的“金三银四”求职旺季,悄然拉开序幕。
PSO-LightGBM回归预测模型代码PSO-LightGBM回归预测模型,Python代码,粒子群优化算法,多输入单输出,有示例数据,可以直接替换,机器学习模型,可以预测未来值
在机械臂控制领域,随着工业自动化和智能化的发展,对机械臂的控制精度、鲁棒性和适应性提出了更高要求。传统的控制算法,如 PID 控制,在面对复杂的机械臂动力学特性、外部干扰和模型不确定性时,往往难以满足性能需求。因此,研究人员提出了多种改进算法,结合强化学习、深度学习、智能控制等技术,以提升机械臂的控制性能。通过对这些算法进行仿真比较,有助于深入了解各算法的优缺点,为实际应用选择最合适的控制策略。控
重新排列范围,使得指定位置的元素等于排序后的元素,并且左边的元素都不大于它,右边的元素都不小于它。算法的原理是 “覆盖” 要删除的元素,将保留的元素移到前面,返回新的逻辑尾迭代器,但。对范围内的每个元素应用一个函数,并将结果存储在另一个范围内。移除范围内连续的重复元素,返回新的逻辑结尾迭代器。旋转范围内的元素,使中间元素成为新的第一个元素。这些算法不会改变它们所操作的容器中的元素。这些算法会修改它