登录社区云,与社区用户共同成长
邀请您加入社区
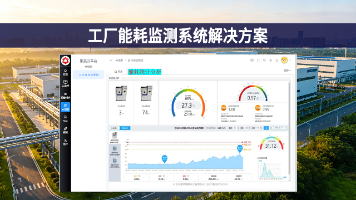
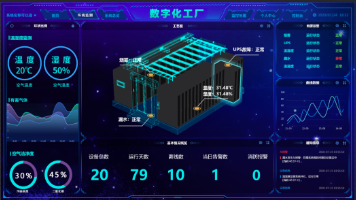
本方案基于物联网与大数据技术,构建工厂全维度、实时化能耗监测系统,实现电、水、气、压缩空气等多品类能源的自动采集、智能分析与异常预警。通过可视化大屏、多维度统计、设备能效管控及自动化报表,助力工厂精准降耗8%-15%,降低运营成本,提升能效管理水平,推动绿色低碳转型,满足双碳政策与智能制造发展需求。
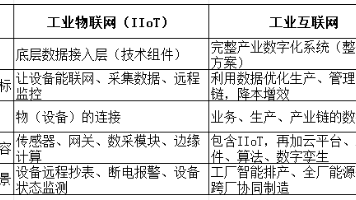
工业物联网(IIoT)是设备联网与数据采集的技术底座,侧重物理设备的连接与感知;工业互联网则是在IIoT基础上,融合平台、软件、算法与业务协同,构建覆盖全产业链的数字化生态体系。前者聚焦“连设备、采数据”,后者实现“用数据、优生产、促协同”。
物联网云平台实现远程控制的核心原理是:现场设备通过网关或通信模组(如4G/WiFi)接入云平台,用户在手机/电脑端下发指令,云平台校验后通过MQTT等协议将指令转发至设备,设备执行动作并回传状态,实现双向通信。关键环节包括设备在线、协议匹配、安全鉴权与指令回执。支持云下发远程控制与边缘本地联动结合,保障网络中断时仍可自动运行,提升系统可靠性。
企业AI,是面向组织场景设计的人工智能应用体系,依托大模型能力,结合企业内部文档、业务数据、权限体系与第三方工具,辅助员工、团队完成业务相关的信息处理、内容生产、流程自动化工作。它区别于面向普通个人用户的通用对话AI,设计逻辑优先适配组织协作、数据管控、业务上下文复用,属于企业数字化生产力工具的一类。企业AI中,Work Agent是其中的重要分支,也就是能够自主拆解目标、串联多工具完成完整交付物
随着工业物联网(IoT)技术的快速普及,传统输送设备的智能化改造正在成为仓储物流企业的必修课。据行业数据显示,中国智能输送设备的渗透率预计将从2023年的3%提升至2027年的40%,这一巨大增量空间意味着,无论是新建产线还是存量设备升级,IoT化都已是不可回避的课题。本文基于实际工程经验,系统讲解输送机加装IoT传感器、搭建预测性维护系统的完整流程,供工程技术人员参考。
基于物联网平台快速开发SaaS应用,核心思路是复用平台的设备接入、协议解析、时序存储等底层能力,上层专注业务逻辑开发,大幅缩短周期。适用于设备监控、远程控制、告警、报表等场景。推荐选用硬件配套云或开源平台(如ThingsBoard),通过物模型定义、IoT平台配置、多租户设计、API/Webhook对接等步骤快速落地。避免直接连接设备、自建时序库等常见坑点,采用共享数据库+租户ID隔离模式,结合N
企业AI是面向组织场景构建的人工智能应用集合,区别于面向个人用户的通用AI工具,它以企业业务流程、内部知识资产、团队协作规则为基础,承接组织内重复性、信息密集型、多步骤的业务任务,辅助员工完成工作决策与成果交付。企业AI并非单一模型,而是由大语言模型、向量检索、工具调用、自动化编排等能力组合形成的应用体系,可嵌入现有办公系统,和企业原有数据、权限体系协同运行。企业AI和个人AI助手的核心差异体现在
开始规模进入工业物联网领域,水表、燃气表、热量表是较早应用的一批。:虽然传输本身更耗电了,但换来的是更低的发射功率和更高的穿透能力。的极简制式,专为超低功耗、深度覆盖、海量连接优化,代价是速率极低、不支持移动切换。的方式,让它在极端弱信号环境下依然能工作,代价是速率极低、延迟较大。,把单天线设计做到极致,射频链路更简单,物料成本进一步逼近。两个通信制式,区别很大。地下室的水表、地下管网的传感器、深
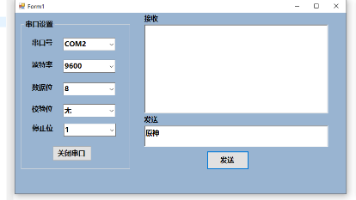
使用 C# WinForms 和 System.IO.Ports.SerialPort 实现一个简易串口通信小工具:支持串口号、波特率、数据位、校验位、停止位配置,完成双窗口中文消息收发,并在接收端通过字典匹配关键词自动展开回复内容。代码简洁、思路清晰,适合上位机 / 物联网初学者入门参考。
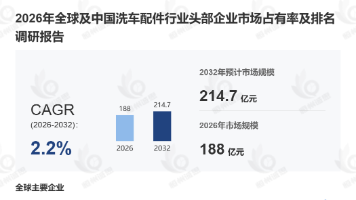
设备国产化替代,叠加环保节水政策推动,2025年中国市场规模达特定体量,预计2026至2032年CAGR将维持在较高水平。据恒州诚思调研统计,2025年全球洗车配件市场规模约184.1亿元(约合25.6亿美元),预计至2032年将增长至214.7亿元,2026至2032年间复合年增长率(CAGR)为2.2%。系统中物联网与视觉识别技术的普及,提升设备效率与节水率;与此同时,中国本土企业如南京海英机
本文汇总 2026 年 10 月 EI、Scopus 可检索国际学术会议资源,涵盖人工智能、信息与控制、能源环境、计算机科学与技术等多个研究领域,面向硕博毕业、职称晋升、评奖评优的科研人群,梳理高适配度会议清单,便于科研人员快速筛选方向匹配的投稿渠道,助力科研成果高效发表。
例如,Keras Tuner提供直观的API,支持多种搜索策略,适用于深度学习模型的调参。在机器学习模型的训练过程中,超参数的选择直接影响模型的性能表现。贝叶斯优化是一种基于概率模型的超参数调优方法,通过构建目标函数的代理模型(如高斯过程)来预测超参数组合的性能,并选择最有潜力的参数进行试验。相比之下,随机搜索通过随机采样超参数组合进行测试,能以更少的计算资源获得较好的结果。通过合理选择超参数调优
同时我深刻认识到,公有云的网络访问核心在于安全组与防火墙管理,80 端口用于 HTTP 访问、443 端口用于 HTTPS 加密、22 端口用于远程连接,这些端口若未正确放行,网站就无法被公网访问,这也是初学者最容易忽略的关键环节。每一个配置细节、每一条命令、每一处权限设置,都直接影响网站能否正常运行。通过本次公有云环境部署与网站设置课程的学习,我完整经历了从云服务器初始化、Web 环境搭建、网站
这篇面向想转向大模型方向的程序员和计算机专业学生,但不会把“AI大模型就业:普通程序员如何抓住下一轮机会”写成概念清单。我会按务实、犀利、面向就业的技术教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从团队落地角度切入,重点写协作、日志和可维护性”展开,换一组场景和例子来讲。回到“AI大模型就业:普通程序员如何抓住下一轮机会”这个主题,最重要的不是把名词
这篇面向想转向大模型方向的程序员和计算机专业学生,但不会把“AI大模型就业:把关键流程跑顺”写成概念清单。我会按务实、犀利、面向就业的技术教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“AI大模型就业:把关键流程跑顺”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。
这篇面向想从爬虫和自动化采集转向 AI 数据工程的开发者,但不会把“爬虫转大模型:一篇讲清核心用法”写成概念清单。我会按实战导向的转型指南的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从初学者转型路线切入,重点写学习顺序和误区”展开,换一组场景和例子来讲。回到“爬虫转大模型:一篇讲清核心用法”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。
这篇面向想转向大模型方向的程序员和计算机专业学生,但不会把“AI大模型就业:把学习路线变成作品集”写成概念清单。我会按务实、犀利、面向就业的技术教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“AI大模型就业:把学习路线变成作品集”这个主题,最重要的不是把名词背全,而是知道它该放在什
摘要: 大模型(如GPT-4、BERT)在软件测试中的应用日益广泛,但其“黑盒”特性引发的可解释性(XAI)挑战严重影响了测试结果的信任度。本文分析了可解释性缺失的根源,包括模型复杂性和数据偏差导致的误判风险,以及由此引发的安全、效率和道德问题。针对这些挑战,提出了集成XAI工具(如SHAP、LIME)、优化测试流程(如混合规则与AI方法)和建立信任指标等解决方案。通过将可解释性融入测试实践,从业
摘要: 退化测试是大模型可靠性验证的核心环节,通过系统性对抗输入评估模型的鲁棒性、安全性和一致性。工业级测试需涵盖六大高危输入模式(如角色扮演绕过、DAN模式等),并建立量化指标(越狱成功率、语义一致性得分等)。企业实施需构建语料库、自动化探针和熔断机制,参考行业实践(如蚂蚁双塔验证、OpenAI红队机制)。退化测试不仅是质量保障手段,更是构建AI免疫系统的关键,推动模型从“能用”到“可靠”的进化
Linux通过自动脚本自动化推送k8s Docker镜像
本文探讨了大模型在多智能体协作中的应用,从业务需求出发分析了协作的本质。文章提出协作需要从业务、认知和工程三个视角理解,并强调角色分工、能力责任和闭环机制的关键作用。工程实现上需包含消息、状态、协议等五大机制,其中状态一致性和任务可拆解性是协作成功的核心。通过招聘流程案例,展示了分工、状态同步和责任闭环如何共同实现业务目标。最后总结协作三大原则:业务决定分工、责任保障闭环、状态确保收敛。
本文介绍了如何使用 GitHub Actions 和 image-syncer 工具,实现 Docker Hub 镜像到 Azure Container Registry 的自动化同步,解决了国内及部分 Azure 区域访问 Docker Hub 速度慢的问题,提升了镜像的可用性和 Azure 环境的部署效率。为解决这些问题,我们需要建立一个自动化的镜像同步机制,将 Docker Hub 的镜像定
在跨境电商(Cross-border E-commerce)的精细化运营体系中,供应链响应速度与数据质量是两大核心命门。对于依赖 1688 作为上游货源的卖家(无论是 TikTok Shop 店群、Temu 全托管,还是 Amazon 精铺模式),普遍面临着一个“数据断层”上游(1688):数据是非结构化且语义模糊的。标题充斥着中文营销词(“包邮”、“跑量”),属性定义不规范(“均码”、“杂色”)
今天就把这份沉淀了很久的“避坑指南+实操学习干货”整理出来,不管你是想转行切入AI赛道的零基础小白,还是想拓展技能边界、破解35岁职业焦虑的程序员,都能通过这篇内容快速理清AI大模型的学习逻辑,掌握可落地、能复用的进阶方法,少走半年弯路。