
【干货收藏】一分钟精通RAG:大模型检索增强生成的核心技术详解!
·
简介
文章介绍了RAG(检索增强生成)技术,解决大模型时效性低、知识深度不足和幻觉问题。RAG通过检索相关文档增强提示词,再让大模型生成答案,类似开卷考试。基本流程包括索引化(文档分块、向量化、存储)、检索和增强生成三步。Naive RAG是基础形态,后续发展出检索重排序、模块化和智能体等优化方案,能有效提升大模型生成答案的质量和准确性。
一分钟文章速读
文章结构目录:
- 解释什么是RAG技术
- 大模型存在的问题
- 如何解决这些问题
- 介绍RAG的基本流程
核心知识点:
RAG文档索引化步骤:文档 -> 分块 -> 向量化 -> 存储
什么是RAG
RAG 名词解释是信息检索增强生成技术。
它通过先检索相关的文档,用检索出来的信息对提示词增强,再使用大模型生成答案。
人话:好比开卷考试,先翻书,再回答问题
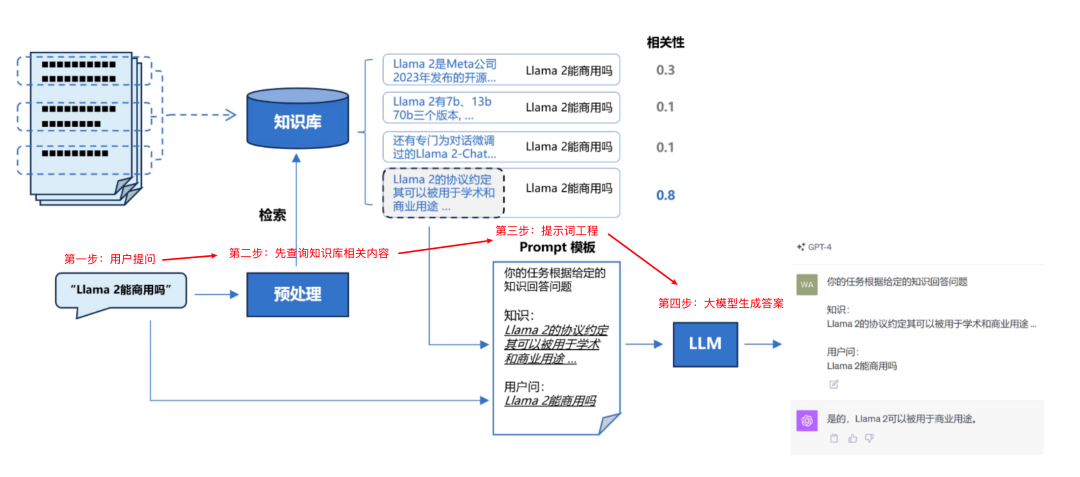
RAG的提示词工程:让大模型基于我们从知识库查询到的相关知识回答问题。
大模型存在的问题
- 时效性低:无法知道最近发生的事情(比如西贝预制菜)
- 知识覆盖深度不够:针对特定领域知识,缺乏深度信息(比如律师行业相关案例;每个行业的专业知识)
- 幻觉问题:AI 一本正经的胡说八道(缺乏事实支撑)
如何解决
- 提示词工程:可以提高大模型生成答案的质量,但是无法解决实效性问题。
- RAG技术:可以从知识库中获取到行业的最新数据。(前提是你得有自己的知识库)
- 微调:普通用户基本不需要这一步,了解即可。
了解下 Naive RAG
检索增强生成(RAG)技术的基础形态。后续基于此衍生出很多优化方案:(了解)
- Retrieve-and-Rerank(检索 - 重排序)
在检索后增加了重排序模块 - Modular RAG(模块化 RAG)
将 RAG 拆分为查询优化、多源检索、知识整合等独立模块 - Agentic RAG(智能体 RAG)
引入智能体自主决策机制
Naive RAG 的详细步骤
- 索引化
文档 -> 分块 -> 向量化 -> 存储 - 检索:
用户提问 -> 向量化 -> 检索数据库 -> 得到top-K个相关文档块 - 增强生成
增强提示词(原始问题+相关文档块) -> LLM -> 生成答案
RAG索引化实战部分
这部分我们详细了解下RAG索引化的几个步骤:
- 文档分块
递归处理:句子切分+固定字符切分+重叠长度overlap
from langchain.text_splitter import RecursiveCharacterTextSplitter - 文档向量化
本地使用 Ollama 开源框架,搭建BGE-M3 开源文本嵌入模:https://ollama.com/library/bge-m3
也可以使用在线向量嵌入模型(火山引擎,GLM,Deepseek) - 文档向量化存储
向量数据库Chroma:https://www.trychroma.com/
暂时只说明下涉及关键词,详细实战代码部分期待下一篇
更多推荐

 4
 0
- 0


 已为社区贡献457条内容

所有评论(0)