- @Mikasa33


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
今天给大家带来9月22日的github和huggingface的热点论文项目,精选12篇前沿论文,覆盖多模态智能、统一生成框架、机器人现实强化、语音-文本自适应、人机交互澄清等领域,有需要开源代码和论文的,免费领取。
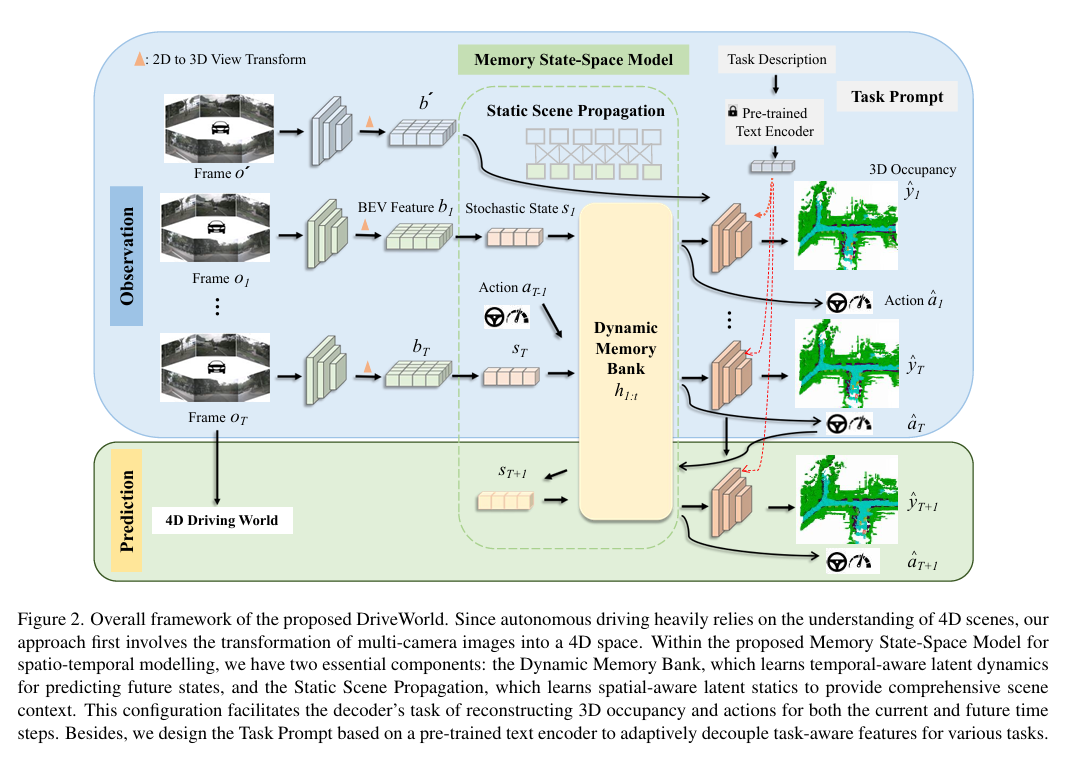
例如,在OpenScene数据集上预训练后,DriveWorld在3D目标检测的mAP上提高了7.5%,在在线映射的IoU上提高了3.0%,在多目标跟踪的AMOTA上提高了5.0%,在运动预测的minADE上降低了0.1m,在占用预测的IoU上提高了3.0%,在规划的平均L2误差上降低了0.34m。-通过在具有挑战性的NuScenes数据集上的实验,VLP在端到端规划性能上达到了最先进的水平,与之
该方向在机器人、自动驾驶、无人机、金融等对状态估计精度要求高的领域应用广泛,顶会成果频出,如登顶 Nature 封面的 Swift 系统、一区准确率近 100% 的 AdaRL-MD 模型。若目标为二三区,可聚焦具体应用问题,如用卡尔曼滤波作为 RL 的状态估计器,解决噪声环境下的性能下降,在视觉伺服、机器人定位等任务中展示比纯 RL 更高的稳定性和收敛速度。若冲击高区,则需深入理论探索,如结合部

【Video+Diffusion】是一个结合视频生成和扩散模型的研究领域,旨在通过先进的深度学习技术生成高质量、高分辨率的视频内容。这个方向利用扩散模型的强控制性和稳定性,通过逐步去除噪声并恢复数据,来生成逼真的视频序列。研究者们通过设计创新的框架和方法实现了从文本描述或图像提示到视频内容的高效转换,这些方法不仅提升了视频生成的效率和质量,同时也降低了计算资源的需求。

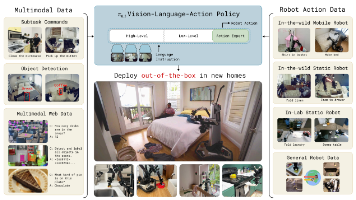
π0.5 基于 π0 构建,训练分预训练和后训练两阶段。预训练用离散标记实现高效训练,后训练引入“动作专家”支持连续动作生成与实时推理。推理时先推断高级子任务,再基于子任务预测低级动作。π₀.₅基于π₀模型,通过异构数据协同训练(融合多机器人数据、web数据等),实现了移动操作器在全新家庭环境中的端到端控制,可完成清洁厨房、整理卧室等长时复杂任务。其采用两阶段训练(预训练用离散标记,后训练引入动作
重磅重磅!!DeepSeek-R1 的研究荣登最新一期的!通讯作者正是梁文锋。如果训练出的大模型能够规划解决问题所需的步骤,那么它们往往能够更好地解决问题。这种与人类处理更复杂问题的方式类似,但这对人工智能有极大挑战,需要人工干预来添加标签和注释。在本周的期刊中,DeepSeek 的研究人员揭示了他们如何能够在极少的人工输入下训练一个模型,并使其进行推理。DeepSeek-R1 模型采用强化学习进
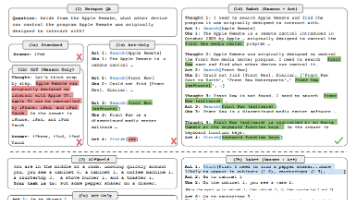
在问答、事实核查、交互式决策等多种任务上,ReAct 均展现出超越单一推理或行动基线的性能,且仅需少量示例即可学习。ReAct 生成的轨迹清晰地展示了模型的“心路历程”,使得人类可以轻松审查其决策依据,判断其结论是源于内部知识还是外部事实,从而大大提高了模型的可信度和可诊断性。通过与外部知识库的互动,ReAct 有效地缓解了 CoT 方法中普遍存在的知识幻觉问题,使其在知识密集型任务中更加可靠。
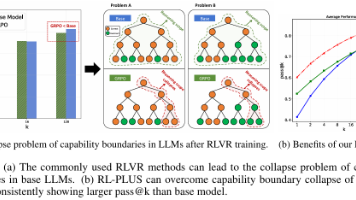
该问题的核心在于,RLVR本质上是一种在线策略(on-policy)学习,在面对LLM巨大的解空间和稀疏的奖励信号时,模型倾向于利用(Exploitation)和优化已知的推理路径,而难以进行有效的向外探索(Exploration)以发现新知识。激励模型发现新知识。实验证明,该方法不仅在多项推理任务上取得了SOTA性能,更重要的是,它有效解决了“能力边界塌缩”问题,为大型语言模型实现持续的自我进化
模型与策略表示:语言模型(LM)用策略πθy∣xπθy∣x表示,其中yyy是基于提示xxx生成的响应;目标任务TTT的最优策略记为π∗⋅∣xπ∗⋅∣x。损失函数定义监督微调(SFT):最小化交叉熵损失,LSFTθ;x∑y−π∗y∣xlogπθy∣x,基于最优策略采样的真实响应y∗y^{*}y∗计算。

2025年,何恺明团队以“简化、结构、泛化、物理性、重构”为关键词,完成了一场对深度学习核心范式的系统性反思与重塑。在生成领域,团队通过去除噪声条件、引入分形结构、设计单步流场等创新,剥离冗余组件,揭示了生成建模的本质机制;在表征学习中,以“解构退化”的反向思维,证明了简洁架构的强大潜力;在物理推理方向,融合经典力学与神经算子,实现了可解释、多任务的物理建模;在理论层面,重审数据集偏差问题,为行业