登录社区云,与社区用户共同成长
邀请您加入社区
先给出完整表格。分类必须由前三个事实列推导,不能看见“智能客服”之类的产品名称就猜答案。这里的“共同后端问题”不是说每类系统只能选表里那一个。输入校验、超时、日志、监控和版本记录四类系统都需要;表格只是为每行写出一个可以落到代码的例子。上一篇让你把“知识库客服回复”的临时改成 。不必真的破坏源码,也可以复制案例后再修改:返回值中的关键部分是:程序只能根据你提供的事实判断。现在它仍然“从样本学习”并
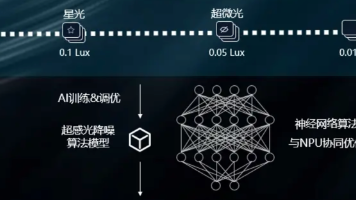
AI-ISP(人工智能图像信号处理器)正在重塑夜视成像的技术边界。本文从 ISP Pipeline 架构、降噪策略、色彩还原、动态范围、功耗、延迟六个维度,系统对比 AI-ISP 与传统 ISP 的差异,并通过 0.001Lux 极微光环境下的实测数据给出量化结论。适合图像算法工程师、夜视设备选型人员和嵌入式开发者阅读。
要把 DETR(DEtection TRansformer)的网络结构研究透彻,最硬核的方式就是跟着张量(Tensor)的形状变化走一遍全流程。在深度学习中,无论算法吹得多么天花乱坠,最终都是矩阵形状的变换。假设我们输入给 DETR 的是一张普通的图片,形状为3×800×800C×H×W),Batch Size 设为B。下面将详细拆解数据在 DETR 内部是如何一步步被“揉捏”成最终的检测框的。
大模型架构演进:从Transformer到MoE
大模型训练稳定性:优化器、数据与调度
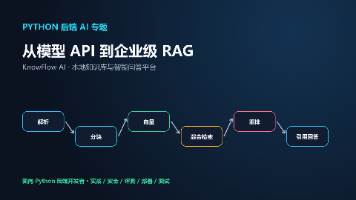
我们探讨Meta AI 的尖端 Llama 3 语言模型构建强大的检索增强生成 (RAG) 来实现。通过利用 Llama 3 和 RAG 技术的功能,我们将创建一个应用程序,允许用户与网页进行交互式对话,检索定制化、私人知识库的相关信息并生成对用户查询的准确响应。在本教程中,我们将深入探讨设置开发环境、加载和处理网页数据、创建嵌入和向量存储以及实现 RAG 链以提供卓越用户体验的分步过程。
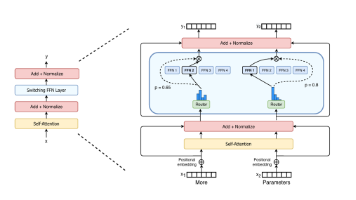
摘要:本文探讨了MoE(混合专家)架构在大模型发展中的关键作用,重点分析了SwitchTransformer论文的创新点。该论文通过简化MoE路由机制,提出仅激活单个专家的top-1路由策略,在保持计算量不变的前提下显著提升了模型性能。实验表明,SwitchTransformer在相同计算资源下可获得7倍预训练加速,并首次实现了万亿参数模型的稳定训练。同时,文章还讨论了DeepSeek最新提出的E
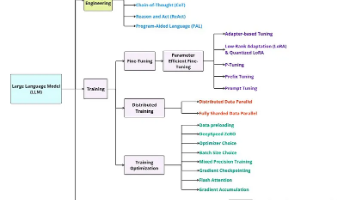
文章全面介绍了大语言模型(LLM)的基础知识、架构设计和训练方法,重点讲解了参数高效微调(PEFT)技术如适配器、LoRA和QLoRA,以及提示工程、模型压缩方法(如剪枝和量化)。同时详细讨论了各种量化技术(GPTQ、NF4、GGML)和蒸馏、剪枝等减小模型大小的技术,为开发者提供了完整的大模型应用与优化指南。
本文汇总了Transformer模型的面试问题,涵盖基础原理、训练优化和应用场景。基础部分包括多头注意力机制、位置编码、LayerNorm等核心概念解析;训练优化部分探讨Embedding层复杂度、BPE分词、参数缩减等技术细节。还提供了大模型学习资料包获取方式,适合准备AI面试的开发者参考。全文系统梳理了Transformer的关键知识点,从数学原理到工程实践均有涉及。
文章系统介绍了RAG(检索增强生成)技术的三大核心形态:传统RAG通过检索知识增强回答准确性;Graph RAG利用知识图谱理解信息间关系;Agentic RAG赋予AI自主解决问题能力。详细讲解了RAG的落地策略、注意事项、技术选型和实际应用案例,强调RAG能让AI从"瞎编乱造"变成"有据可依",提升回答准确性和可靠性,是程序员掌握大模型应用的关键技术。
RAG 虽好,但无法改变模型的“性格”。本文通过实操对比 Base 模型与 Instruct 模型,揭秘大模型“炼丹”的核心心法——微调 (SFT),并解析大模型从预训练到对齐的完整生命周期
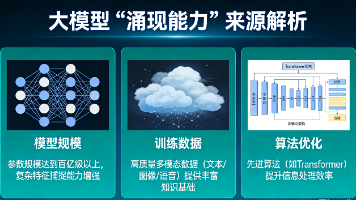
大模型“涌现能力”的来源解析
BERT:采用了双向编码器,能够同时考虑一个词左侧和右侧的上下文信息,并通过MLM和NSP任务学习语言表示。这使得BERT在理解句子中的语义关系方面具有明显优势,尤其是在需要深刻理解上下文的任务中表现突出,如问答系统、文本分类等。不过,BERT的生成能力相对较弱,因为它主要用于理解和分析文本,而不是生成新的内容。GPT:是一个单向解码器模型,其训练目标是预测下一个词,基于当前词之前的上文进行推理。
GeoAI大模型驱动的地球科学智能计算前沿实践技术应用
深度学习实战:Transformer模型文本翻译应用
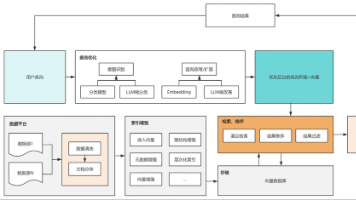
智能问答系统到底是什么? 智能问答系统的核心架构 RAG:让大模型“有据可依” 高质量问答系统的关键点 从Demo到产品:那些容易被忽略的坑
AI模型部署进阶:Docker容器化部署AI项目