- @weixin_39636364


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
hive standalone metastore 3.1.2可作为独立服务,作为spark、flink、presto等服务的元数据管理中心,然而在现有的hive授权方案中只有针对hiveserver2的授权,所以本文针对hive standalone metastore独立服务使用ranger对连接到hive metastore的用户进行授权访问,以解决hive standalone metas
基本介绍数据库、表、函数等 Hive 对象的定义存储在 Metastore 中。 根据系统的配置方式,统计数据和授权记录也可能存储在那里。 Hive 和其他执行引擎在运行时使用此数据来确定如何解析、授权和有效执行用户查询。Metastore 通过 DataNucleus 将对象定义保存到关系数据库 (RDBMS),DataNucleus 是一个基于 Java JDO 的对象关系映射 (ORM) 层
Flink从1.13版本开始支持在SQL Client从savepoint恢复作业。flink-savepoint介绍接下来我们从Flink SQL Client构建一个mysql cdc数据经kafka入hudi数据湖的例子。整体流程如下:在上述第二步中,我们通过手工停止kafka→hudi的Flink任务,然后在Flink SQL Client从savepoint进行恢复。下述工作类似于Fli
MySQL 是一个开源数据库管理系统,可作为流行的 LAMP(Linux、Apache、MySQL、PHP/Python/Perl)堆栈的一部分安装。它实现了关系模型并使用结构化查询语言( SQL)来管理其数据。本教程将介绍如何在 Ubuntu 22.04 服务器上安装 MySQL 8.0 版。通过完成它,你将拥有一个可用的关系数据库,并且可以使用它来构建您的下一个网站或应用程序。

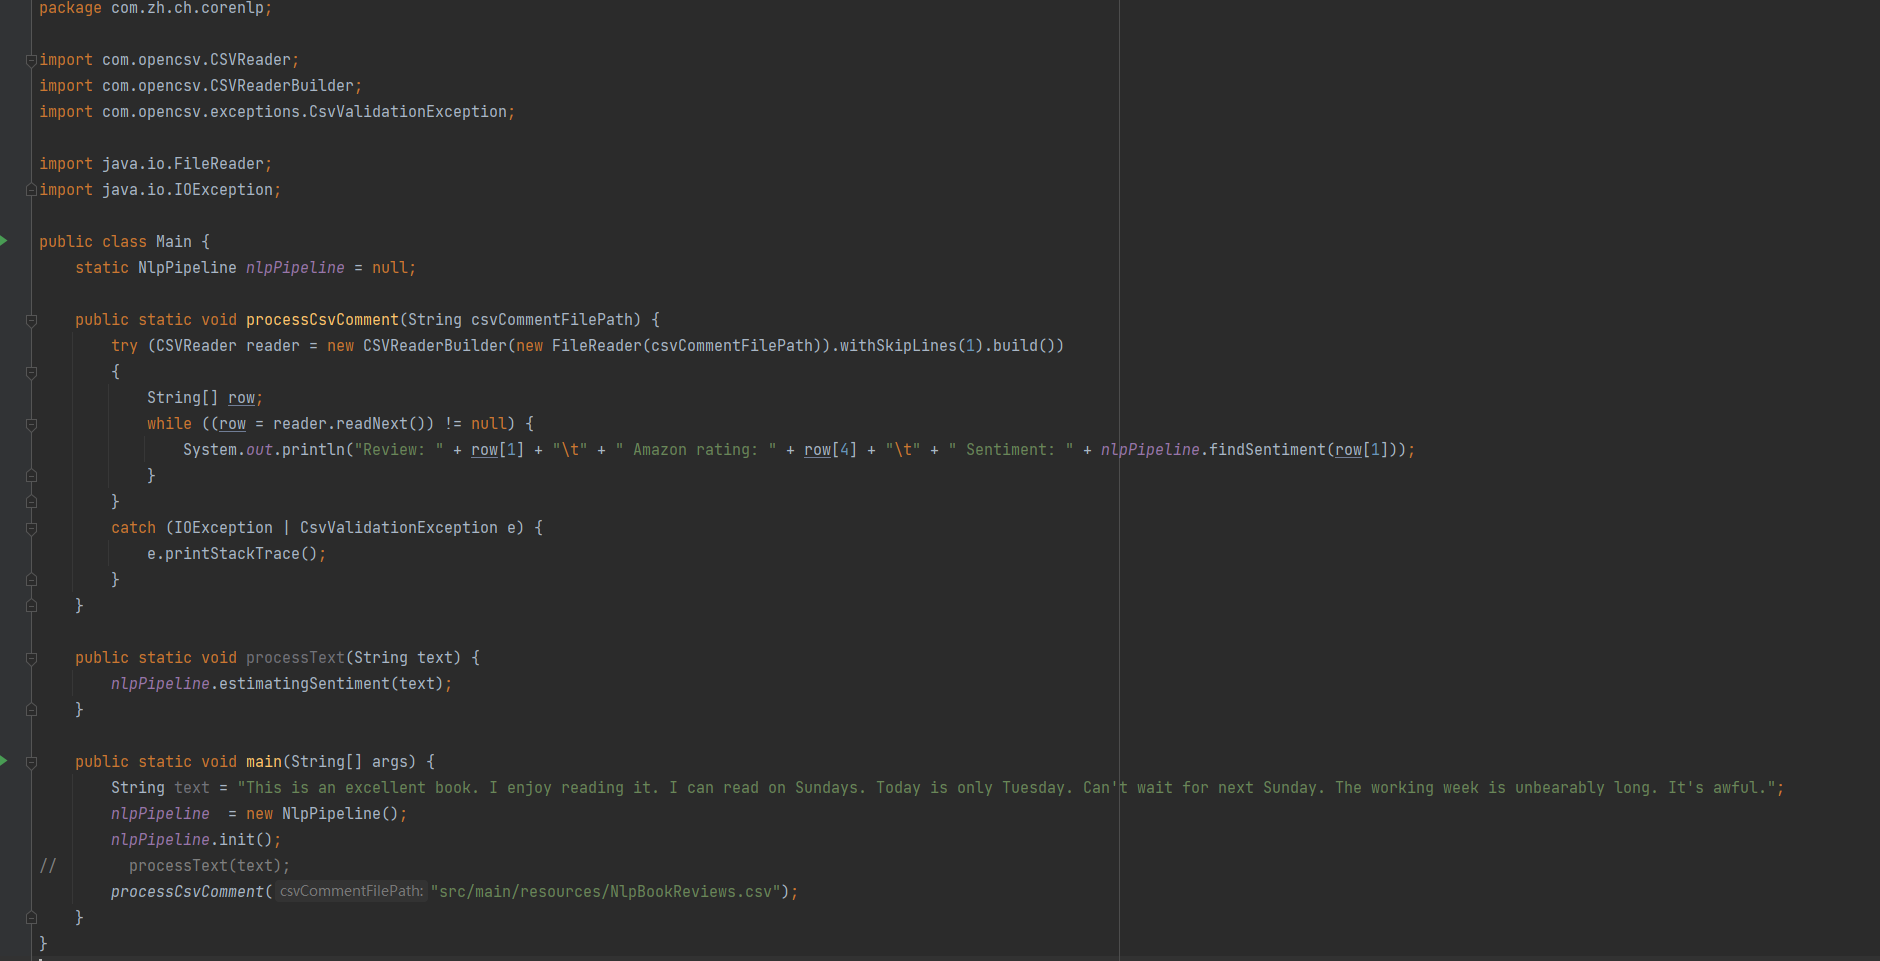
积极的? 消极的? 中性的? 使用斯坦福 CoreNLP 组件以及几行代码便可对句子进行分析。本文介绍如何使用集成到斯坦福 CoreNLP(一个用于自然语言处理的开源库)中的情感工具在 Java 中实现此类任务。斯坦福 CoreNLP 情感分类器要执行情感分析,您需要一个情感分类器,这是一种可以根据从训练数据集中学习的预测来识别情感信息的工具。在斯坦福 CoreNLP 中,情感分类器建立在递归神经
MySQL 是一个开源数据库管理系统,可作为流行的 LAMP(Linux、Apache、MySQL、PHP/Python/Perl)堆栈的一部分安装。它实现了关系模型并使用结构化查询语言( SQL)来管理其数据。本教程将介绍如何在 Ubuntu 22.04 服务器上安装 MySQL 8.0 版。通过完成它,你将拥有一个可用的关系数据库,并且可以使用它来构建您的下一个网站或应用程序。
积极的? 消极的? 中性的? 使用斯坦福 CoreNLP 组件以及几行代码便可对句子进行分析。本文介绍如何使用集成到斯坦福 CoreNLP(一个用于自然语言处理的开源库)中的情感工具在 Java 中实现此类任务。斯坦福 CoreNLP 情感分类器要执行情感分析,您需要一个情感分类器,这是一种可以根据从训练数据集中学习的预测来识别情感信息的工具。在斯坦福 CoreNLP 中,情感分类器建立在递归神经
积极的? 消极的? 中性的? 使用斯坦福 CoreNLP 组件以及几行代码便可对句子进行分析。本文介绍如何使用集成到斯坦福 CoreNLP(一个用于自然语言处理的开源库)中的情感工具在 Java 中实现此类任务。斯坦福 CoreNLP 情感分类器要执行情感分析,您需要一个情感分类器,这是一种可以根据从训练数据集中学习的预测来识别情感信息的工具。在斯坦福 CoreNLP 中,情感分类器建立在递归神经
从 0.9.0 开始 hudi 已经支持 hudi 内置的 FileIndex:HoodieFileIndex 来查询 hudi 表,支持分区剪枝和 metatable 查询。这将有助于提高查询性能。它还支持非全局查询路径,这意味着用户可以通过基本路径查询表,而无需在查询路径中指定“*”。有关支持的所有表类型和查询类型的更多信息,请参阅表类型和查询。如果使用location语句指定一个位置,或者使
在 Java 中,多线程是指同时执行两个或多个线程以最大限度地利用 CPU 的过程。 Java 中的线程是一个轻量级进程,只需要较少的资源即可创建和共享进程资源。多线程和多进程用于 Java 中的多任务处理,但我们更喜欢多线程而不是多进程。 这是因为线程使用共享内存区域有助于节省内存,而且线程之间的内容切换比进程快一点。线程的生命周期线程在其生命周期中必须经历五种状态。 此生命周期由 JVM(Ja