登录社区云,与社区用户共同成长
邀请您加入社区
LaWAM提出一种高效的动力学感知机器人策略框架,通过在冻结视觉编码器的潜在空间中构建潜在世界-动作模型(LaWM),以紧凑的潜在视觉子目标替代冗余的像素级未来预测。该模型利用潜在动作条件化预测未来观测特征,显著降低计算开销。在预训练后,动作生成以预测的子目标为条件,实现高精度与低延迟控制。实验表明,LaWAM在LIBERO、RoboTwin及真实任务中均达领先性能,单次动作预测仅需187毫秒,相
本文探讨了MELLM(多模态大语言模型)在微表情识别领域的创新应用,通过光流技术与语言模型的结合,实现了跨模态的精准解析。MELLM不仅提升了微表情识别的准确率,还解决了传统方法的时空连续性断裂问题,为刑侦、心理咨询等领域提供了新的技术突破。
多模态大型语言模型(Multimodal Large Language Models,MLLMs)已迅速发展,超越了文本生成的范畴,如今能够覆盖图像、音乐、视频、人类动作以及三维物体等多种输出模态。它们通过在统一架构下将语言与其他感知模态整合,实现了跨模态的生成能力。本文综述将六大主要生成模态进行分类,并探讨了若干核心技术——包括自监督学习(Self-Supervised Learning, SS
在OpenCompass评测中,MiniCPM-o 2.6的单图理解能力获得了70.2的平均分,超越了GPT-4o-202405、Gemini 1.5 Pro和Claude 3.5 Sonnet等专有模型。MiniCPM-o 2.6凭借其卓越的多模态能力、实时流媒体处理、先进的OCR能力、高效性与易用性等特点,在多模态任务上成功超越了GPT-4o和Claude 3.5等业界知名模型。MiniCPM
这种学习机制的核心在于利用战斗过程中产生的即时文本反馈,来动态调整智能体的行动策略。最近,由美国乔治亚理工学院的Sihao Hu、Tiansheng Huang和Ling Liu发表的论文介绍了POK´ELLMON,这是一个开创性的基于大模型(LLM)的具身智能体,它在战术战斗游戏中,特别是宝可梦战斗中,实现了与人类相媲美的表现。这种策略特别针对智能体在面对强大对手时可能出现的“恐慌切换”现象,即
大模型(LLMs)在处理复杂任务时展现出的巨大潜力,但却需要庞大的计算资源和存储空间,限制了它们在移动设备等资源受限环境中的应用。微软公司最新发布的Phi-3系列语言模型,以其卓越的性能和小巧的体积,打破了这一局限,为移动AI领域带来了革命性的变革。Phi-3系列模型的优势在于它们能够在保持较小模型体积的同时,提供与大型模型相媲美的语言处理能力。
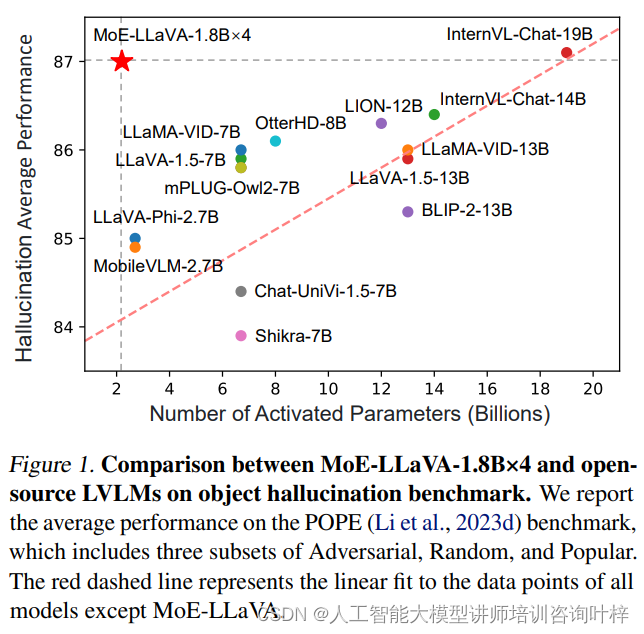
随着人工智能技术的飞速发展,大型视觉-语言模型(LVLMs)在图像理解和自然语言处理方面展现出了巨大的潜力。这些模型通过结合图像编码器和语言模型,能够处理包括图像描述、视觉问答和图像字幕生成等在内的多种任务。然而,现有模型在训练和推理时存在巨大的计算成本,这限制了它们的应用范围和效率。
最近我在恶补一些经典的LLM工作,之前也精读过MetaLM这个工作但是没有及时笔记,现在已经有些遗忘了,因此在过年期间复习了下,在此笔记希望对诸位有所帮助。
多模态视频理解是人工智能领域的前沿技术,它融合了视觉、语言、音频等多种模态的信息,能够更全面、深入地理解视频内容。在大语言模型的支持下,多模态视频理解能够实现更加智能化的视频处理和分析,为各个领域带来巨大的变革和机遇。课程将激发你的创新思维,让你学会利用多模态信息生成新的视频内容,开发个性化的视频定制服务,以及探索人工智能与人类协作的新模式。课程将为你介绍多模态视频理解的最新研究成果和应用案例,开
多模态技术正成为人工智能领域的重要发展方向,它通过整合视觉、语音、文本等不同模态的信息,实现更全面的内容理解与生成。UniVideo框架创新性地将视频理解、生成和编辑三大功能集成到统一架构中,采用多模态编码器网络、跨模态对齐引擎和任务特定头网络等核心技术组件。该框架通过动态梯度标准化和内存优化技术,有效解决了跨模态训练中的梯度平衡和长视频处理难题。在电商视频制作、智能教育等场景中,UniVideo
VideoChat3 通过 I3D-ViT 早期时空压缩 + 自适应分辨率 + 大规模重标注/合成视频指令数据 + 四阶段训练,在完全开源的前提下,用 4B 参数实现了在通用、长视频、流式视频理解上优于同/更大规模开源模型的性能,并显著提升长视频推理效率和主动流式交互能力。通用长视频多模态大模型,针对现有视频MLLM痛点:普遍将视频拆分为独立图片序列编码,丢失帧间时序运动信息;长视频输入易出现To
在AI应用从纯文本走向多模态的今天,视频理解始终是智能体落地的关键瓶颈。与静态图像不同,视频融合了连续画面、语音和时间轴,直接喂给模型会撑爆上下文、浪费token,甚至让模型失去焦点。核心解法是利用抽帧与音频转录技术,将视频拆解为带时间戳的结构化笔记,再通过工具封装成Agent可调用的Skill。这套方案既适用于Claude,也适用于开源模型或自建框架,能显著提升Agent处理教学视频、产品演示、
多模态大模型虽能处理文本和图像,却无法直接“看”视频,因为视频是包含画面、音频、字幕和时间轴的复合容器,缺少统一的token表示。要让Agent理解视频,需要将高维视频流降维成模型可消费的结构化符号表达。Agent Skill机制为此提供了优雅解法:通过按需加载的SKILL.md指令,将抽帧、语音转写、时间戳对齐封装成一条并行管线,最终生成包含画面描述与语音内容的事实表。这类设计让智能体能够回答“
多模态技术正成为AI应用落地的关键方向,而视频理解则是其中最具挑战性的环节。当前主流大模型虽具备图文处理能力,却难以直接解析动态视频内容。通过工程化手段,将视频拆解为图像帧与音频文本,再借助帧采样、语音识别(ASR)与时间线对齐,即可让Agent获得“看视频”的能力。OpenCV提供轻量级的抽帧与场景变化检测方案,Whisper负责高精度语音转写,两者结合生成的结构化时间线文档,能被任意长上下文模
用 RTC 推流加多模态 LLM 搭会看画面的语音 Agent,先复制 config.toml 里的 input_modalities 配置让模型接收图像。TaoToken 统一 Key 收拢 STT、LLM、TTS 接入,改一行即可换模型,官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 提供完整接入文档与配置骨架。
当“豆包宇宙”从聊天框裂变出角色扮演、AI编程乃至智能硬件,你还在死磕套壳对话框吗?🤔 本文拆解Chat退居底层设施后的真实增量:多模态与Agent工作流,并附Function Calling实战代码,帮你从“会调API”进阶到“能编排任务”,把项目经验写进作品集。
本文介绍的TRDA-TS框架通过多频率、多尺度时序建模提取数值动态,利用长期趋势语义聚合将外部事件重组为因果可用的趋势文本,并通过正则扩散和目标感知损失完成文本与时序表示对齐,从而提升跨领域、多预测跨度下的预测精度。欢迎阅读和转发。
从理解图像内容到凭空创造逼真的场景,Transformer 架构已经从根本上重塑了计算机视觉(CV)的版图。,它重新定义了图像识别;以及,它为新一代顶尖的图像和视频生成模型提供了动力。虽然两者共享一个通用的 Transformer 主干,但它们的设计哲学、架构细节和最终应用却大相径庭。本文将对 ViT 和 DiT 进行深入的比较,探究它们的奠基性论文、架构上的细微差别以及它们正在驱动的最新技术趋势
本文介绍了如何在星图GPU平台上自动化部署ms-swift镜像,高效开展大语言模型微调任务。基于该平台,用户可一键完成CUDA、PyTorch及多模态依赖的环境配置,快速启动Qwen系列模型(如Qwen2.5、Qwen3-VL)的LoRA微调,典型应用于中文指令微调与多模态对话模型训练。
本文深入解析Time-VLM如何通过视觉语言模型(VLM)革新时间序列预测,实现多模态数据融合。该模型将数字序列转化为图像和文本,利用预训练知识迁移提升预测精度,在少样本场景下误差降低30%。核心架构包含VAL、TAL和RAL模块,分别处理视觉转换、文本生成和记忆增强,在金融、气象等多个领域展现卓越性能。
知识蒸馏(Knowledge Distillation)是当前机器学习研究中的一个重要方向,特别是在模型压缩和效率优化等任务中。传统的深度学习模型往往依赖于复杂的大型网络,以获取卓越的性能。然而,这些庞大的模型对计算资源和存储空间的需求,使得它们在实际应用中,尤其是在边缘设备或移动端部署中面临巨大挑战。知识蒸馏技术致力于解决这一问题,其核心思想是通过一个“教师模型”向一个更小、更高效的“学生模型”
多模态推荐系统综述:特征交互
推荐已经成为许多在线内容共享服务的核心组成部分,从图像、博客公众号、音乐推荐、短视频推荐等等。与传统推荐不一样的地方,就是这些项目内容包含着丰富的多媒体信息-帧、音轨和描述,涉及多种形式的视觉、声学和文本信息。那么如此丰富的多媒体,多模态信息如何融合到推荐中呢?最普通也是最直接的方式可能就是对多模态抽特征,然后多模态融合直接作为side Information或者item的representati
计算机视觉是人工智能的核心研究领域,随着深度学习技术的演进,多模态统一、长时序视频理解与高效小模型已成为前沿热点。面对ArXiv每日海量论文,如何快速筛选高价值工作并高效复现?这里从论文阅读方法论出发,介绍一套结合标题、摘要与图表的三轮筛选法及量化打分表,并深入解析统一感知架构、扩散模型步数压缩、分钟级视频记忆等代表性工作。同时,结合工程实践,剖析数据管线、训练配置、评估指标等复现环节的常见陷阱,
长视频问答总卡在“这是谁”?🤔 传统时间线记忆会丢失物理身份,让同一只猫在检索中“分身”。本文带你了解「具身实体传记」(GEB)——从视觉观测直接建立身份链接,让检索沿着实体而非时间走,在 EgoLifeQA 上拿下 72.0% 准确率。
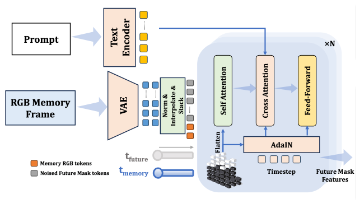
本文介绍ICML2026世界模型工作Mask World Model(MWM),一种以语义掩码动态预测为核心的机器人世界模型。通过将预测目标从高保真RGB帧转为语义掩码,MWM引入几何信息瓶颈,有效过滤光照、纹理等无关视觉噪声,聚焦物体身份与接触关系。结合掩码引导的扩散策略头,实现端到端稳健控制。实验表明,MWM在仿真(LIBERO、RLBench)和真实机器人任务中均显著优于基于RGB的基线,且
Fast-WAM提出质疑:世界动作模型(WAM)是否必须在测试时显式想象未来?研究发现,其性能提升主要源于训练阶段的视频联合建模,而非推理时的未来生成。为此,作者提出Fast-WAM——训练时保留视频预测目标,测试时跳过未来预测,仅通过一次前向计算获取世界表征。实验表明,该方法在仿真与真实任务中表现媲美先进WAM,延迟仅190毫秒,速度提升4倍,且无需具身预训练。受控对比证实,移除视频联合训练导致
同样是大模型,为什么 ChatGPT、通义能看图,DeepSeek 传图就报错?答案在'输入模态'——视觉模型训练时见过图片,纯文本模型没有。本文讲清多模态原理,用 Spring AI 的 Media + Message 组装多模态请求,OpenAI 兼容视觉端点实测识别图片文字与内容。附不支持视觉的模型如何优雅降级、图片 base64 还是 URL 传参两个坑。源码 gitee lesson-0
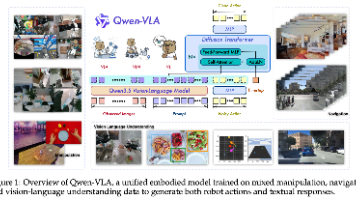
note动机: 传统具身智能模型通常针对单一任务/机器人分别训练,例如机械臂操作、导航、轨迹预测各用一套模型,跨任务、跨环境、跨本体泛化差。Qwen-VLA 希望把这些任务统一成一个“视觉+语言→连续动作/轨迹”的通用模型。核心方法: 以 Qwen3.5-4B VLM 为认知骨干,负责视觉理解、空间推理和指令理解;外接约 1.15B DiT flow-matching action decoder
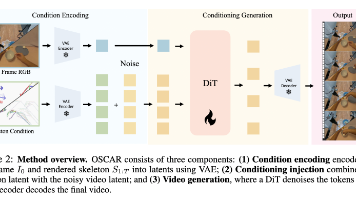
输入 = 当前场景首帧图片 + 未来一段机器人的 2D 运动学骨架序列;输出 = 按这段骨架动作发展出来的未来机器人视频。OSCAR 不是又一款追求“画面像不像”的视频生成器,而是把动作条件视频预测改造为策略筛选器:给定一个真实首帧和给定策略的动作轨迹,模型自回归生成未来视频,再由 GPT-5 判读成功率,以此预测 RoboArena 真实排名。它的核心设计是 2D 运动学骨架:把不同机械臂或人手
LR-ASD 是一种轻量化音视频主动说话人检测模型,通过联合分析人脸序列与同步音频,判断画面中的候选人是否正在发言。本文结合 IJCV 2025 论文与官方源码,介绍其分解卷积编码器、通道注意力融合、双向 GRU 检测器及训练推理流程。论文报告,该模型仅含约 0.84 M 参数,在 AVA-ActiveSpeaker 验证集上达到 94.5% mAP,兼顾检测效果与资源开销。源码分析进一步表明,默
多模态信息处理是当前人工智能应用的重要方向,其中视频因同时包含视觉、听觉和文本信息而成为最具挑战的载体。为实现视频内容的结构化理解,业界普遍采用抽帧、语音识别与文字识别相结合的技术路径,将非结构化视频转换为带时间戳的结构化文档。这种多模态融合方案可支撑视频总结、关键片段定位、会议纪要生成、知识库检索等实际业务场景。本文介绍一个基于FFmpeg、Whisper与OCR构建的Agent Skill——
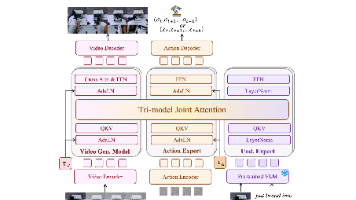
Motus(CVPR 2026)提出一种统一的潜在动作世界模型,通过混合Transformer(MoT)架构融合视觉-语言理解、视频生成与动作专家,实现五类具身建模范式的统一:VLA、WM、IDM、VGM与联合预测。引入基于光流的潜在动作表示,结合六层数据金字塔与三阶段训练流程,实现跨具身体的动作先验迁移。实验表明,该模型在仿真与真实场景中显著优于X-VLA和π⁰.⁵,性能提升达+15%至+48%
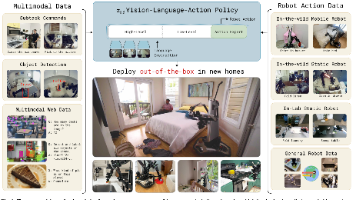
π₀.₅ 是一种具备开放世界泛化能力的视觉-语言-动作模型,通过协同训练多种异质数据源(如多机器人数据、网络文本、高层语义预测与口头指令),实现跨环境、跨任务的强泛化。该模型采用分层架构,先预测高层子任务,再生成低层动作,可在未见过的家庭环境中自主完成清洁厨房、整理卧室等持续10–15分钟的复杂操作。实验证明,其泛化能力源于多样化知识迁移,是首个实现端到端学习驱动的长时程灵巧操作的系统。
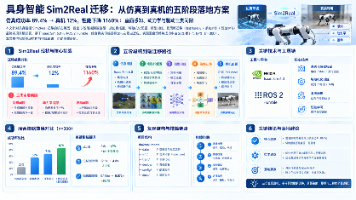
具身智能Sim2Real迁移面临严峻挑战:仿真成功率89.4%降至真机12%,性能下降1160%。核心瓶颈源于感知、动力学与驱动三类间隙。本文提出5阶段端到端路径——从仿真搭建、域随机化配置、模型训练,到策略迁移(融合域随机化+系统辨识+残差学习),最终实现真机部署。实测表明,混合策略将成功率由23%提升至87%(n=300)。依托Isaac Sim 6.0与ROS 2 Humble,结合真实传感
随着多模态生成技术的成熟,AI已从单点工具走向内容生产全链路。从AI短剧、漫剧到恋综,底层共享同一条自动化管线:剧本生成、分镜拆解、角色一致性、视频合成与音频同步。其核心原理在于将传统“拍摄”重构为“生成+拼接”,显著降低试错成本,使小团队也能批量产出内容。当生成能力富余后,如何高效筛选优质创意成为新瓶颈,于是“AI观众”作为模拟反馈机制应运而生,本质上是用Agent模拟用户情感与完播率,辅助创作
语音交互正在成为人机协同的新常态,从智能音箱到车载助手,用户越来越习惯用自然语言与系统对话。实现这一体验的核心链路,是将语音识别、语义理解与语音合成三大技术模块串成一条自动化流水线。语音识别负责将声波转化为文本,大模型推理引擎负责理解意图并调用工具,语音合成则把结构化回答重新转为拟人化的语音输出。这种三段式架构不仅大幅降低了传统语音机器人的开发门槛,还保留了上下文管理与工具调用的高级能力,适用于智
在人工智能与自动化流程中,Agent的能力边界往往取决于它对非结构化数据的感知与理解。视频作为信息密度最高的载体,却长期是Agent的认知盲区。本文从技术原理出发,解析如何通过FFmpeg抽帧、OCR字幕提取、ASR语音转写与多模态视觉理解,构建一套完整的视频解析链路。这一方案将视频转化为带时间轴的结构化报告,使Agent能够像处理文本一样处理视频内容,从而支撑会议纪要整理、课程切片、视频审核等工
多模态大模型时代,视频信息的高效解析成为AI应用落地的关键挑战。与传统文本处理不同,视频理解需要同时处理视觉与音频双通道数据。通过视频抽帧、语音转写与时间轴对齐,可将非线性视频流转换为结构化的图文剧本,从而让大模型“看懂”视频内容。这一技术路线在Agent开发中尤为重要——Agent需要扩展视频感知能力,而基于Skill机制的视频处理工具能够低成本实现多模态扩展。本文从工程实践角度,解析基于ffm
视频理解是AI Agent处理非结构化数据的关键能力之一。传统方法让模型直接读取视频流会面临上下文窗口爆炸、信息密度不均等多重挑战。解决思路是将连续视频拆解为离散的视觉、听觉与文本信号:通过ffmpeg按场景动态抽帧获取画面信息,借助whisper完成音频转写,结合OCR识别画面中烧录的文字,最后把三路结果按时间轴对齐生成结构化的Markdown文本。这种多模态信息融合方案不仅大幅降低Token消
近日,万兴科技旗下AI视频创意产品Wondershare Filmora跻身8月全球AI产品榜总榜TOP100;与此同时,人工智能领域的独立行业数据监测平台AIGCRank发布的8月AI网站出海排行榜中,万兴科技旗下云端AI创意工具集Wondershare Media.io成功位列排行榜TOP30。
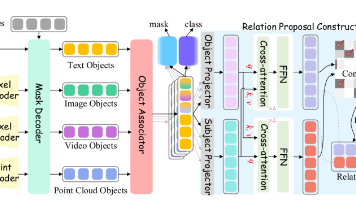
本文提出通用场景图(USG)表示法,能够整合图像(ISG)、文本(TSG)、视频(VSG)和3D(3DSG)等多种模态的场景信息。针对现有方法孤立处理单模态导致的跨模态对齐困难问题,作者设计了共享掩码解码器框架,通过模态特定编码器提取特征后,利用掩码交叉注意力隐式整合跨模态互补信息。系统包含对象关联器、目标检测头和关系检测器等模块,采用多任务损失函数和文本中心对比学习策略,有效解决了跨模态对象对齐
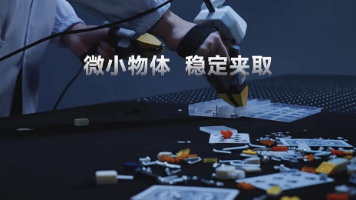
从极端工况验证到多元化场景落地,千觉机器人触觉传感器已具备工业级可靠性与规模化量产能力。未来,千觉机器人将持续推进触觉感知技术的迭代与突破,以更精准、稳定的触觉能力拓展机器人感知边界,推动触觉技术在更广泛场景加速落地。
本文详细介绍了如何在Spring AI中集成豆包多模态模型,实现图像与文本的交互处理。通过环境搭建、API开发实战和性能优化等步骤,帮助开发者快速掌握多模态AI的应用技巧,提升中文场景下的图像理解和文本生成能力。
多模态
——多模态
联系我们(工作时间:8:30-22:00)
400-660-0108 kefu@csdn.net


 DAMO开发者矩阵


 乐奇 Rokid 开放社区






 火山引擎视频云技术社区








 AtomGit AI 社区
 AI硬件创业社区





 亚马逊云科技技术品牌专区


 天工造物局
