登录社区云,与社区用户共同成长
邀请您加入社区
2026年编程语言格局以Python、Java、JavaScript为主流,持续引领人工智能、后端开发与全栈领域。Go与Rust在云原生、系统编程中崛起,C/C++仍主导底层开发。就业方向聚焦AI数据科学、云原生架构、前端工程化与系统安全。选择语言应结合兴趣、市场需求与生态成熟度,持续学习方能把握技术变革机遇。
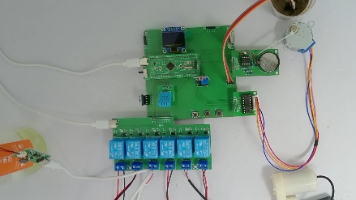
本系统基于STM32F103C8T6单片机设计一款花烛智能养护系统。系统通过DHT11、光照、土壤湿度、SGP30等传感器实时监测温湿度、光照、CO₂及土壤状况,自动调控加热片、风扇、雾化器、水泵、遮阳棚与照明灯。支持按键设置阈值,OLED显示数据,WiFi上传至手机远程控制。配套原理图、PCB、仿真文件及开题报告、答辩PPT模板,采用AD2013、Proteus8.17等软件开发,适用于物联网智
本文系统梳理了嵌入式开发从零基础到项目实战的五阶段学习路径:第一阶段夯实C语言、数据结构与计算机基础;第二阶段掌握Linux应用开发核心技能;第三阶段实现系统移植与构建;第四阶段深入驱动开发;第五阶段完成物联网网关、视频监控等综合项目。全程强调理论结合实践,涵盖开发工具链、网络编程、设备驱动、系统优化及产品化能力,助力开发者成长为具备全栈能力的嵌入式工程师。
Tensor Core 是 NVIDIA 从 Volta 架构开始引入的专用硬件单元,专门加速矩阵乘加运算,能在单个时钟周期内完成多个浮点乘加操作,大幅提升深度学习训练和推理的性能。在相同矩阵大小(如 512×512×512)下,对比 FP32 GEMM 和 Tensor Core(FP16)GEMM 的性能,使用 cudaEvent 计时。在练习 2 的基础上,加入共享内存分块和 K 维循环,提
《Softmax回归》将线性回归拓展至分类任务,通过Softmax函数将网络输出转化为合法概率分布,实现从连续值预测到类别概率输出的跨越,为后续交叉熵损失、Fashion-MNIST数据集及完整分类流程奠定基础。
本项目为纯C++与自定义CUDA实现的GPT-2推理引擎,针对124M模型从零手写优化,全程不依赖深度学习框架。通过四轮工程优化:重构分块GEMM与Warp归约GEMV、引入共享内存与寄存器洗牌、实现持久化KV缓存、静态内存管理与双模式调度,将1024token预填充时间从13.7秒降至910毫秒,单token解码延迟从13.7秒降至9.9毫秒,解码阶段提速1381倍,完整呈现大模型推理的底层优化
本文以通俗易懂的方式介绍机器学习,通过“等人”故事引出其核心思想——基于数据归纳规律。文章系统阐述了机器学习的定义、方法(如回归、神经网络、SVM)、应用(如语音识别、图像处理)及与大数据、深度学习、人工智能的关系。强调机器学习是模拟人类经验归纳的过程,具有广泛前景,尤其在自动驾驶、推荐系统等领域表现突出。作者呼吁将高深技术落地于实际场景,推动技术普惠。
默认底层容器是vector的原因:因为它的下标访问速率更快。不支持list作为底层容器,因为list仅提供双向迭代器,而priority_queue需要的是随机迭代器。在这里插入图片描述。
C++中为了避免引入太多运算符,会复用C语言的一些符号,比如前面的<<和>>,这里引用也和去地址使用同一个符号&,要注意区分,但是个人觉得用更多符号反而更好,不容易混淆在这里插入图片描述创建i这个变量的时候会开辟一块空间叫i,int& j = i,就是给这块空间又去了一个名字叫j,还可以再取一个名字叫k在这里插入图片描述在这里插入图片描述引用可以给一个变量取多个别名,也可以给别名取别名。
• 仿函数的类名是编译按⼀定规则⽣成的,保证不同的 lambda ⽣成的类名不同,lambda参数/返回类型/函数体就是仿函数operator()的参数/返回类型/函数体, lambda 的捕捉列表本质是⽣成的仿函数类的成员变量,也就是说捕捉列表的变量都是 lambda 类构造函数的实参,当然隐式捕捉,编译器要看使⽤哪些就传那些对象。• 在学习 lambda 表达式之前,我们的使⽤的可调⽤对象只有
代码语言:javascriptAI代码解释。
list的实现,还是比较简单的,大家只要想着土家楼的形状,画出图来就好了,不需要过多担心。本次的博客会发出一个完整的实现List的List.hpp,以后也会这样,主要是分段发被说孩子分段生。二、模拟List由于list中的结构需要特定的类型和特定的指定地址的,所以我们先要实现list中的结点和迭代器。正所谓"工欲善其事,必先利其器"。
代码语言:javascriptAI代码解释#include <stack> //头文件// 定义栈:默认存储int类型,底层依赖deque实现// 可指定底层容器// 基于vector的栈// 基于list链表的栈。
这里定义节点的类用struct,定义list的类用class的原因是一个默认的共识,一个类如果它的所有成员都不期望用访问限定符限制的时候,习惯上就用struct定义,这里的list_node通常作为链表的一个子结构,是存储每个数据的一个最小单元,链表内是要大量访问内部数据的,所以这里不用访问限定符限制。在 list 类的构造函数中,创建头结点时,显式调用 list_node 的带参构造,并传入 T
很明显在没有特殊说明的情况下,直接top()打印priority_queue是从大到小的(说明是一个大堆)。但是我们通过调整priority_queue的第三个参数,也就是前面我们提到的比较规则将弱排序改为greater<>即可实现小顶堆。优先队列使用vector作为底层容器,并且在vector中加入堆算法,将vector构造成了一个堆,所以可以说优先队列就是一个堆,所以在碰见堆的时候就要想到优先
随着C++语法的发展,人们开始觉得上面的写法太复杂了,每次为了实现一个algorithm算法, 都要重新去写一个类,如果每次比较的逻辑不一样,还要去实现多个类,特别是相同类的命名,这些都给编程者带来了极大的不便。上述代码就是使用C++11中的lambda表达式来解决,可以看出。对比仿函数,使用lambda表达式可以使得代码更简洁,可读性更好。在C++之前,如果想对一个数据集合中的元素进行排序,可以
语法规则:lambda表达式可以看成是一般函数的函数名被略去,返回值使用了一个 -> 的形式表示。有时候,需要在匿名函数内使用外部变量,所以用捕获列表来传递参数。手动书写捕获列表有时候是非常复杂的,这种机械性的工作可以交给编译器来处理,这时候可以在捕获列表中写一个。但是如果函数体内有多个return语句时,编译器无法自动推断出返回类型,此时必须指定返回类型。与参数传值类似,值捕获的前提是变量可以拷
默认情况下,lambda捕捉列表是const属性的,也就是说传值捕捉来的对象不能被修改,在参数列表后加上修饰符。
有三个原因:它更快:排序的容器,所有方法都受益于排序集合的快速对数搜索。此外,方法实现了最优算法。std::map和方法可以直接搜索键,而不像算法必须查找,因为它们的迭代器可以直接指向。它在某些情况下更正确:在排序容器(如map和set)中,所有方法都使用等价而不是相等,而某些算法(如std::count和std::find使用相等)则不是这样。现在究如何把它应用到 STL 提供的各种容器来深入了
特性支持版本描述Lambda 表达式C++11匿名函数支持C++11修改值捕获副本初始化捕获C++14泛型 LambdaC++14捕获 by moveC++20。
(it 初始指向 2,插入后 l4 变为 {10,15,2,3,40})#include <algorithm> auto it = find(l.begin(), l.end(), 4);// 先排序使重复元素连续:{1,1,3,4,5,9} l.unique();这种结构决定了 list 的核心特性:任意位置插入/删除效率高(O(1)),但不支持随机访问(访问元素需要遍历,O(N))。// 原
自从在 C++ 11 中引入以来,它们在 C++ 代码中无处不在。而且,自从它们在 C++11 中出现以来,它们已经发展并获得了重要的功能。其中一些功能有助于编写更具表现力的代码,并且由于现在使用 lambda 非常普遍,因此花时间学习可以用它们做什么是非常值得的。Lambda 受益于 C++14 的语言功能:从函数返回,而无需指定返回类型。由于 lambda 的类型是由编译器生成的,因此在 C+
重新排列范围,使得指定位置的元素等于排序后的元素,并且左边的元素都不大于它,右边的元素都不小于它。算法的原理是 “覆盖” 要删除的元素,将保留的元素移到前面,返回新的逻辑尾迭代器,但。对范围内的每个元素应用一个函数,并将结果存储在另一个范围内。移除范围内连续的重复元素,返回新的逻辑结尾迭代器。旋转范围内的元素,使中间元素成为新的第一个元素。这些算法不会改变它们所操作的容器中的元素。这些算法会修改它
容器适配器数据结构特点默认底层容器适用场景stackLIFOdeque递归模拟、表达式求值queueFIFOdeque任务调度、广度优先搜索优先级排序任务调度(按优先级)、贪心算法选择合适的容器适配器可以提高代码的可读性和性能。在 C++ 中,stack是一种容器适配器,它提供了一种后进先出(Last In First Out,LIFO)的数据结构。它基于底层容器(默认是std::deque,也可
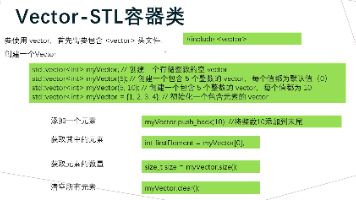
标准模板库(STL)是C++最重要的组成部分之一,其中容器类提供了丰富的数据结构实现。理解容器的内部机制、性能特征和使用场景,对于编写高效的C++代码至关重要。序列容器是STL中最基础的容器类型,包括vector、deque、list等。它们按照线性顺序存储元素,但在内存布局和操作性能上有显著差异。C++标准模板库容器深度剖析。
本文概述文章目标、核心观点和实践价值。摘要:从数据采集工程师转型为大模型数据工程师,最大的误区不是学不会向量数据库,而是忽视了生产环境下的稳定性与合规性。本文基于一次真实的项目重构经历,重点复盘如何将传统的“爬取-清洗”流程转化为具备高可用性的 RAG 语料生产线。文章不谈空泛的理论,而是聚焦于线上故障排查中的风险控制、监控体系搭建以及回滚机制的设计。对于希望提升 AI 工程化能力的爬虫开发者来说
其中capture是捕获列表,params是参数列表,opt是函数选项,ret是返回值类型,body是函数体;下面逐个详细介绍。捕获列表capture:捕获一定范围内的变量,具体使用方式[]:不捕获任何变量。[&]:捕获外部作用域中所有变量,并作为引用在函数体内使用(按引用捕获)[=]:捕获外部作用域中所有变量,并作为副本在函数体内使用(按值捕获),拷贝的副本在匿名函数体内部是只读的。如果想要修改
【代码】lambda表达式语法。
本文深入解析了C++11 Lambda表达式在Linux后端开发中的应用。Lambda作为匿名函数对象,通过捕获列表访问上下文变量,比传统函数指针更灵活高效。文章详细介绍了Lambda的语法结构、6种捕获方式及底层实现原理(编译器生成匿名仿函数类),并指出常见误区如悬空引用、mutable误用等。重点展示了Lambda在STL算法、线程回调、系统调用封装等场景的实践应用,提供了移动语义优化、事件驱
在C++标准库中,list是一种双向链表容器。这里简单提一下双向链表——什么是双向链表呢?一个存储数据的字段。(我们通常用_data表示)一个指向前驱节点的指针。(我们通常用_prev表示)一个指向后继节点的指针。(我们通常用_next表示)这样,每个节点都知道它的前一个节点和后一个节点,从而支持在常数时间内进行插入和删除操作。在实现list之前,我们要先定义一下这个链表的节点结构。一个链表是有多