
《理解深度学习》第6章 模型训练 读书笔记
《理解深度学习》第6章 模型训练 读书笔记
目录
开篇导语
上一章我们学习了损失函数,知道了如何衡量模型"做得好不好"。但光有评分标准还不够——我们还需要知道怎么让模型变得更好。这就是本章的主题:模型训练。
模型训练的核心思想非常直观:就像一个人蒙着眼睛下山,他每走一步都用脚感受一下地面的坡度(梯度),然后朝着最陡的下坡方向走一步,反复这个过程直到到达山谷(损失最小点)。这个"蒙眼下山"的算法就是梯度下降法(Gradient Descent)。
本章我们将从最基本的梯度下降法出发,逐步学习它的各种改进版本:随机梯度下降(SGD)、动量(Momentum)、以及目前最常用的Adam优化器。我们还会讨论学习率、批量大小等超参数的选择技巧。最后,我们会用代码实际对比各种优化器的收敛速度,让你直观感受它们的差异。
6.1 梯度下降法
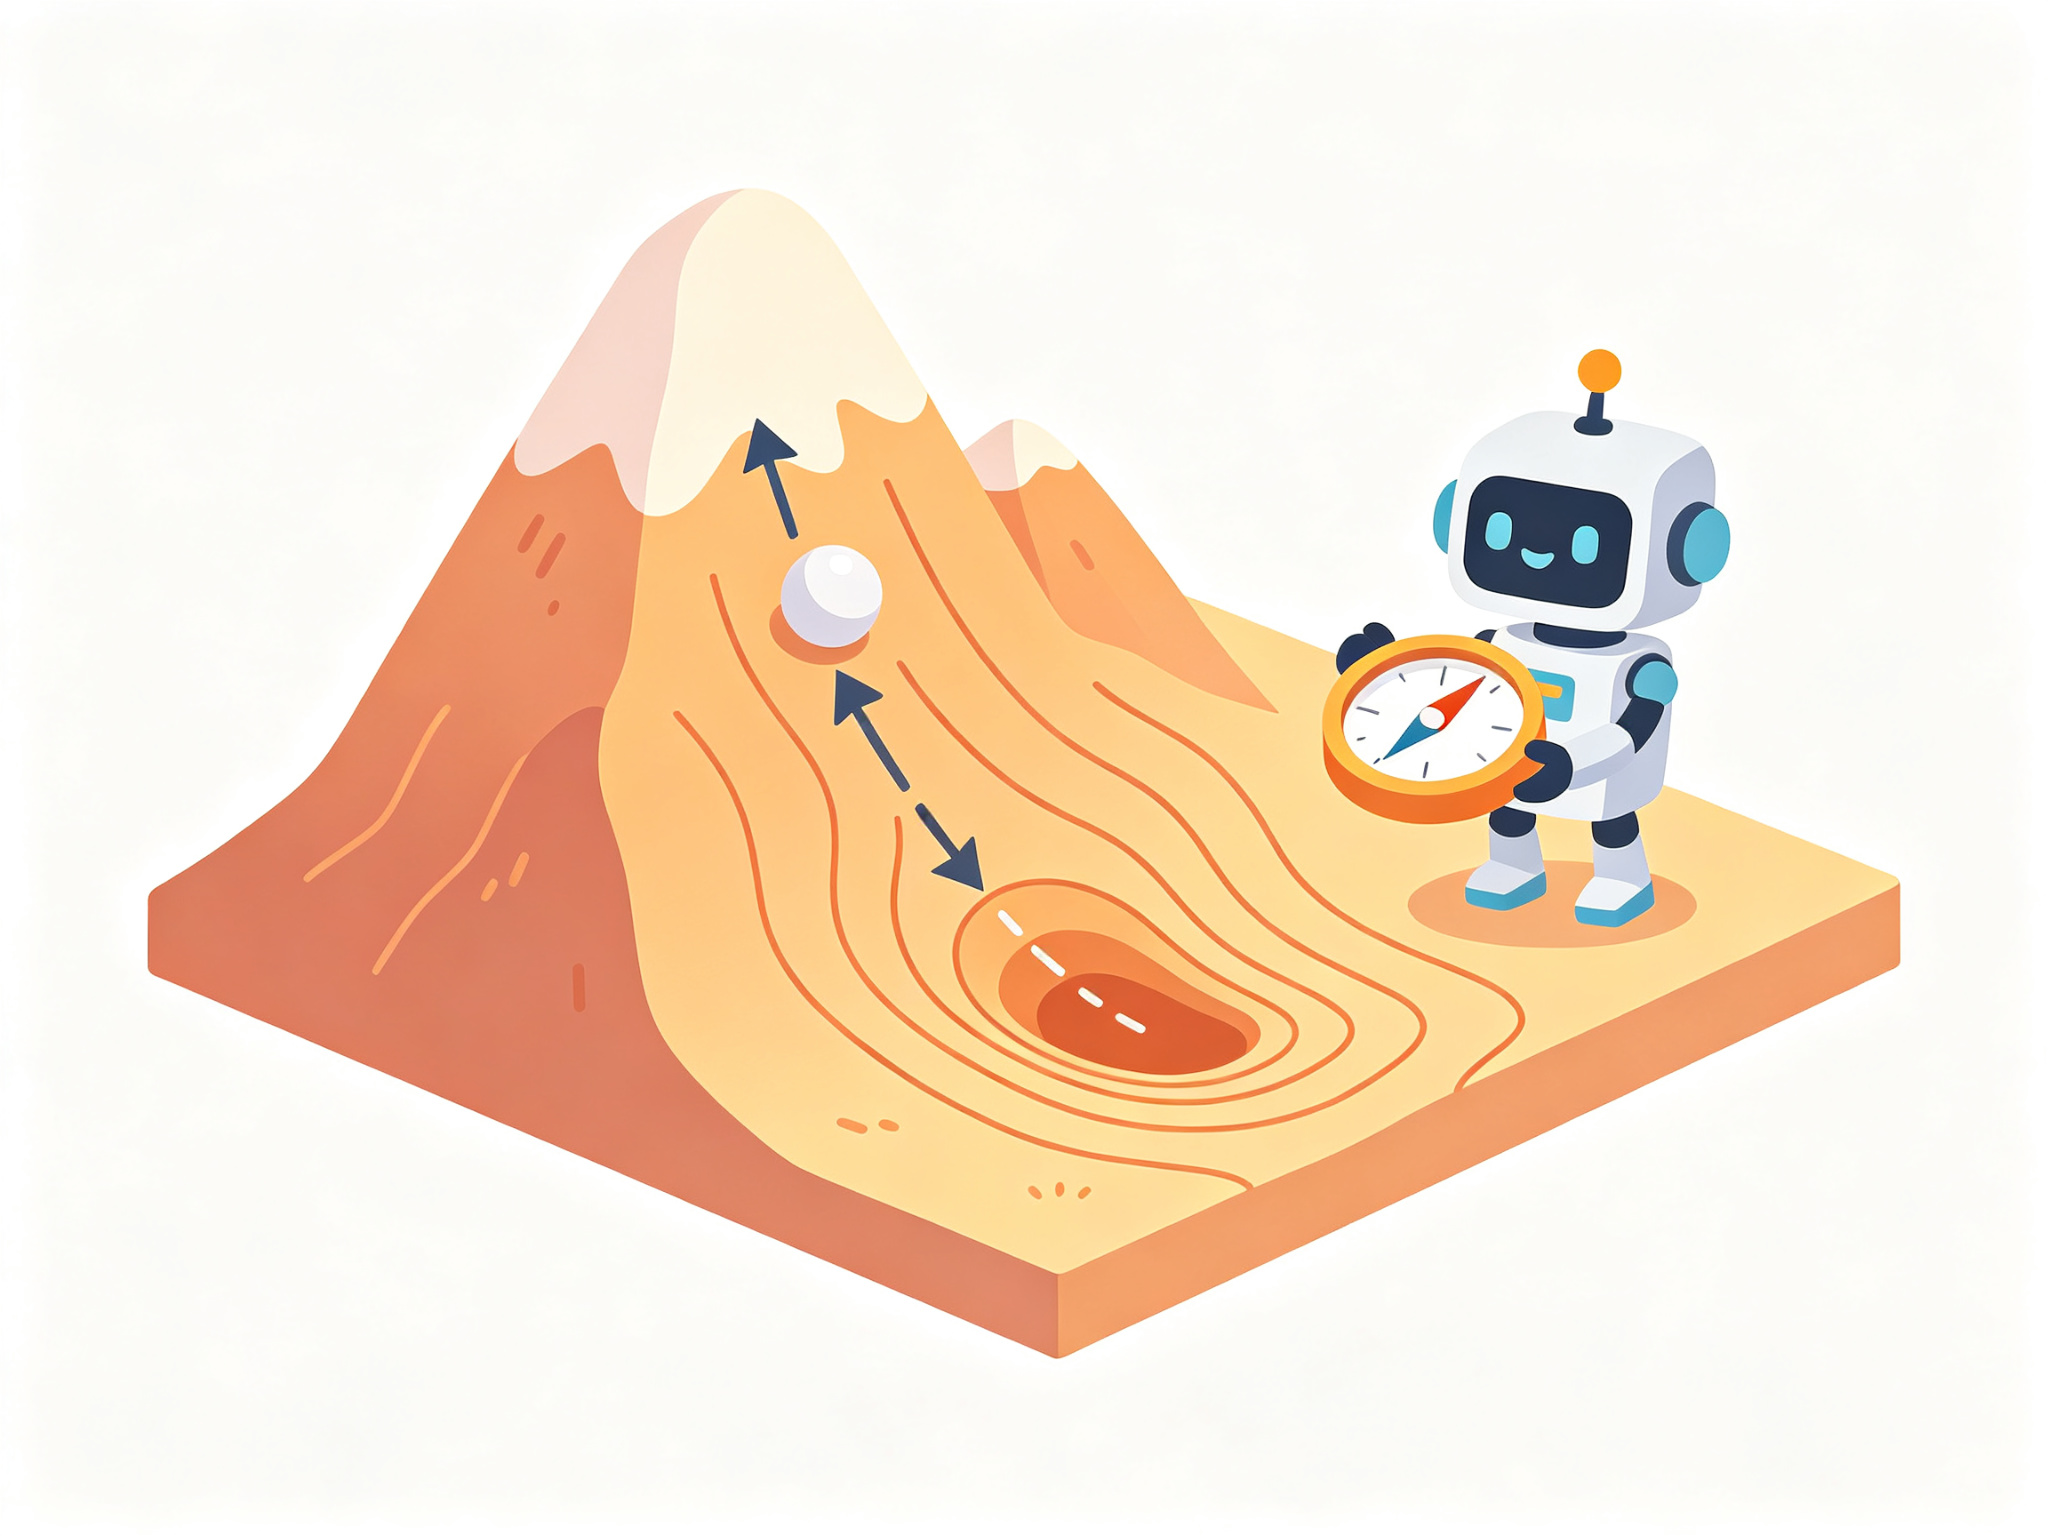
梯度下降法是深度学习中最基本、最重要的优化算法。它的思想来源于微积分:函数在某点的梯度方向是函数值增长最快的方向,那么反方向就是函数值下降最快的方向。
基本原理
假设我们有一个损失函数 L ( θ ) \mathcal{L}(\theta) L(θ),其中 θ \theta θ 是模型的所有参数(权重和偏置)。我们的目标是找到让 L ( θ ) \mathcal{L}(\theta) L(θ) 最小的参数 θ ∗ \theta^* θ∗。
梯度下降法的更新规则非常简单:
θ ← θ − η ∇ θ L ( θ ) \theta \leftarrow \theta - \eta \nabla_\theta \mathcal{L}(\theta) θ←θ−η∇θL(θ)
其中:
- θ \theta θ 是当前参数
- η \eta η(eta)是学习率(learning rate),控制每步走多大
- ∇ θ L ( θ ) \nabla_\theta \mathcal{L}(\theta) ∇θL(θ) 是损失函数关于参数的梯度,即偏导数向量
- 箭头表示"更新为"
这个公式的含义是:朝着梯度的反方向走一小步,每走一步都重新计算梯度,反复迭代直到收敛。
为什么梯度下降有效?
我们可以用一阶泰勒展开来理解:
L ( θ − η ∇ L ) ≈ L ( θ ) − η ∥ ∇ L ∥ 2 \mathcal{L}(\theta - \eta \nabla \mathcal{L}) \approx \mathcal{L}(\theta) - \eta \|\nabla \mathcal{L}\|^2 L(θ−η∇L)≈L(θ)−η∥∇L∥2
只要学习率 η > 0 \eta > 0 η>0 且梯度不为零,更新后的损失就一定小于更新前的损失(因为减去了一个正数)。这就是梯度下降的理论保证:每一步都在降低损失。
批量梯度下降
最基本的梯度下降法叫做批量梯度下降(Batch Gradient Descent),它在每一步都使用全部训练数据来计算梯度:
∇ L ( θ ) = 1 N ∑ i = 1 N ∇ L i ( θ ) \nabla \mathcal{L}(\theta) = \frac{1}{N} \sum_{i=1}^{N} \nabla \mathcal{L}_i(\theta) ∇L(θ)=N1i=1∑N∇Li(θ)
批量梯度下降的优点是梯度估计准确,收敛路径平稳;缺点是每次更新都要遍历整个数据集,当数据量大时非常慢。
6.2 随机梯度下降
随机梯度下降(Stochastic Gradient Descent,SGD) 是对批量梯度下降的重要改进。它的核心思想是:每次只随机抽取一个样本(或一小批样本)来计算梯度,而不是用全部数据。
SGD的更新规则
θ ← θ − η ∇ L i ( θ ) \theta \leftarrow \theta - \eta \nabla \mathcal{L}_i(\theta) θ←θ−η∇Li(θ)
其中 i i i 是随机抽取的一个样本的索引。注意这里的梯度 ∇ L i \nabla \mathcal{L}_i ∇Li 只是单个样本的梯度,是对真实梯度的一个有噪声的估计。
小批量随机梯度下降
在实践中,我们通常不只用一个样本,而是用一小批样本(mini-batch),比如32、64或128个样本。这叫做小批量随机梯度下降(Mini-batch SGD):
θ ← θ − η ⋅ 1 B ∑ i ∈ B ∇ L i ( θ ) \theta \leftarrow \theta - \eta \cdot \frac{1}{B} \sum_{i \in \mathcal{B}} \nabla \mathcal{L}_i(\theta) θ←θ−η⋅B1i∈B∑∇Li(θ)
其中 B \mathcal{B} B 是一个大小为 B B B 的小批量。小批量SGD兼顾了梯度估计的准确性和计算效率,是深度学习中最常用的训练方式。
SGD的优点
- 速度快:每次只需要一小批数据,不需要等整个数据集遍历完就能更新参数。
- 能逃离局部最优:梯度的噪声反而有助于跳出局部极小值和鞍点,找到更好的解。
- 内存占用小:只需要加载一小批数据,适合大规模数据集。
SGD的缺点
- 梯度有噪声:收敛路径会震荡,不像批量梯度下降那样平稳。
- 对学习率敏感:学习率太大容易震荡不收敛,太小收敛太慢。
- 可能在峡谷中震荡:当损失函数的某些方向曲率远大于其他方向时(像一个狭长的山谷),SGD会在山谷两侧来回震荡,进展缓慢。
6.3 动量
动量(Momentum) 是SGD的一个简单而有效的改进。它的灵感来自物理学:一个滚下山坡的球会积累动量,即使遇到小坑也能冲过去,而不是停下来。
动量的更新规则
v
t
=
β
v
t
−
1
+
η
∇
L
(
θ
t
−
1
)
v_t = \beta v_{t-1} + \eta \nabla \mathcal{L}(\theta_{t-1})
vt=βvt−1+η∇L(θt−1)
θ
t
=
θ
t
−
1
−
v
t
\theta_t = \theta_{t-1} - v_t
θt=θt−1−vt
其中:
- v t v_t vt 是第 t t t 步的速度(动量)
- β \beta β 是动量系数,通常取0.9
- η \eta η 是学习率
- ∇ L \nabla \mathcal{L} ∇L 是当前梯度
动量的含义是:当前的更新方向 = 之前积累的方向(乘以衰减系数)+ 当前梯度方向。如果梯度方向一直一致,速度就会越来越快;如果梯度方向来回变化,动量就会相互抵消,减少震荡。
动量为什么有效?
- 加速收敛:在梯度方向一致的方向上,动量会不断积累,速度越来越快,从而加速收敛。
- 抑制震荡:在梯度方向来回变化的方向上(如峡谷两侧),动量会相互抵消,从而减少震荡。
- 逃离局部最优:动量给了参数"冲劲",能够冲过小的局部极小值和鞍点。
物理直觉
可以把动量想象成一个有质量的球在损失曲面上滚动:
- 梯度是重力,给球加速度
- 动量系数 β \beta β 是摩擦力,让速度逐渐衰减
- 球的位置就是参数 θ \theta θ
没有动量的SGD就像一个没有质量的点,每一步都只看当前坡度,容易在峡谷中震荡;有动量的球则有惯性,能够平稳地沿着峡谷底部前进。
6.4 Adam 优化器
Adam(Adaptive Moment Estimation) 是目前深度学习中最常用的优化器之一。它结合了动量和自适应学习率的优点,为每个参数维护单独的学习率。
Adam的更新规则
Adam维护两个移动平均:梯度的一阶矩(均值)和二阶矩(方差):
m
t
=
β
1
m
t
−
1
+
(
1
−
β
1
)
g
t
m_t = \beta_1 m_{t-1} + (1 - \beta_1) g_t
mt=β1mt−1+(1−β1)gt
v
t
=
β
2
v
t
−
1
+
(
1
−
β
2
)
g
t
2
v_t = \beta_2 v_{t-1} + (1 - \beta_2) g_t^2
vt=β2vt−1+(1−β2)gt2
其中 g t = ∇ L ( θ t − 1 ) g_t = \nabla \mathcal{L}(\theta_{t-1}) gt=∇L(θt−1) 是当前梯度, β 1 \beta_1 β1(通常0.9)和 β 2 \beta_2 β2(通常0.999)是两个移动平均的衰减系数。
由于 m t m_t mt 和 v t v_t vt 初始化为0,在训练初期会偏向0,因此需要进行偏差修正:
m
^
t
=
m
t
1
−
β
1
t
\hat{m}_t = \frac{m_t}{1 - \beta_1^t}
m^t=1−β1tmt
v
^
t
=
v
t
1
−
β
2
t
\hat{v}_t = \frac{v_t}{1 - \beta_2^t}
v^t=1−β2tvt
最后,参数更新为:
θ t = θ t − 1 − η m ^ t v ^ t + ϵ \theta_t = \theta_{t-1} - \eta \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} θt=θt−1−ηv^t+ϵm^t
其中 ϵ \epsilon ϵ(通常 10 − 8 10^{-8} 10−8)是为了防止除以零。
Adam的核心思想
- 动量项 m ^ t \hat{m}_t m^t:类似于动量,记录梯度的移动平均,提供平滑的更新方向。
- 自适应学习率 v ^ t \sqrt{\hat{v}_t} v^t:记录梯度平方的移动平均,对于梯度大的参数(更新频繁),学习率自动变小;对于梯度小的参数(更新稀少),学习率自动变大。
- 偏差修正:解决移动平均初始值为0导致的偏差问题。
Adam的优点
- 自适应学习率:每个参数有自己的学习率,不需要手动调参。
- 结合动量:既有动量的加速效果,又有自适应学习率的稳定性。
- 超参数鲁棒:默认的 β 1 = 0.9 , β 2 = 0.999 , ϵ = 10 − 8 \beta_1=0.9, \beta_2=0.999, \epsilon=10^{-8} β1=0.9,β2=0.999,ϵ=10−8 在大多数任务上都表现良好。
- 收敛快:在很多任务上,Adam的收敛速度比SGD+动量更快。
Adam的注意事项
- Adam并不总是最优的:在某些任务上(如图像分类),精心调参的SGD+动量可能达到更好的最终性能。
- 学习率仍然重要:虽然Adam自适应学习率,但初始学习率 η \eta η 仍然需要选择,默认值0.001在大多数任务上效果不错。
- Adam可能收敛到"尖锐"的极小值:有研究表明Adam容易收敛到泛化性能较差的尖锐极小值,而SGD更容易找到平坦的极小值。
6.5 训练算法超参数
训练深度学习模型时,有很多**超参数(hyperparameter)**需要选择。超参数不是通过训练学习到的,而是在训练前手动设定的。选择合适的超参数对模型性能至关重要。
学习率
学习率 η \eta η 是最重要的超参数,它控制参数更新的步长:
- 学习率太大:参数更新步长太大,可能在最优点附近震荡,甚至发散(损失越来越大)。
- 学习率太小:收敛太慢,需要很多轮训练才能到达最优点,而且容易陷入局部最优。
- 合适的学习率:损失稳步下降,最终收敛到较小的值。
常见的学习率范围是 10 − 6 10^{-6} 10−6 到 1 1 1,通常从 0.001 0.001 0.001 或 0.01 0.01 0.01 开始尝试。
学习率调度
实践中,学习率通常不是固定的,而是随着训练进行逐渐减小,这叫做学习率调度(learning rate scheduling):
- 阶梯衰减(Step Decay):每隔一定轮次将学习率乘以一个因子(如0.1)。
- 指数衰减(Exponential Decay):每轮学习率乘以一个接近1的因子(如0.99)。
- 余弦退火(Cosine Annealing):学习率按余弦函数从大到小平滑衰减。
- 预热(Warmup):训练初期学习率从小到大逐渐增加,避免初期梯度不稳定。
批量大小
批量大小(batch size)是每次更新参数时使用的样本数量:
- 大批量:梯度估计更准确,收敛更平稳,但内存占用大,每次更新慢,而且可能收敛到泛化性能差的"尖锐"极小值。
- 小批量:梯度有噪声,有助于逃离局部最优,泛化性能可能更好,但收敛路径震荡。
- 常见选择:32、64、128、256,根据GPU内存和任务选择。
训练轮次
训练轮次(epoch)是整个训练数据集被遍历的次数:
- 轮次太少:模型欠拟合,没有充分学习。
- 轮次太多:模型可能过拟合,训练损失继续下降但验证损失开始上升。
- 通常使用早停(early stopping):监控验证集损失,当验证损失连续若干轮不再下降时停止训练。
超参数调优方法
- 网格搜索(Grid Search):在超参数空间中均匀取点,逐一尝试。简单但计算量大。
- 随机搜索(Random Search):在超参数空间中随机采样,通常比网格搜索更高效,因为不是所有超参数都同等重要。
- 贝叶斯优化(Bayesian Optimization):用概率模型建模超参数与性能的关系,智能选择下一组超参数尝试。更高效但实现复杂。
6.6 本章小结
本章我们系统学习了模型训练的各种优化算法。核心要点如下:
-
梯度下降是基础:沿着梯度反方向更新参数,每一步都保证损失下降。批量梯度下降用全部数据,准确但慢。
-
SGD是主流:每次用一小批数据计算梯度,速度快、内存小,噪声还有助于逃离局部最优。小批量SGD是深度学习的标准训练方式。
-
动量加速收敛:维护梯度的移动平均作为速度,在梯度一致的方向加速,在梯度变化的方向抑制震荡。物理直觉是有质量的球在损失曲面上滚动。
-
Adam结合了动量和自适应学习率:维护梯度的一阶矩(动量)和二阶矩(自适应学习率),每个参数有自己的学习率。默认超参数在大多数任务上表现良好,是目前最常用的优化器。
-
超参数很重要:学习率是最重要的超参数,太大发散太小慢。学习率调度、批量大小、训练轮次都需要仔细选择。早停是防止过拟合的有效手段。
-
没有万能优化器:Adam通常收敛快,但精心调参的SGD+动量可能达到更好的最终性能。选择优化器需要根据具体任务实验决定。
代码实验结果
我们编写了完整的Python代码,从零实现了SGD、动量和Adam三种优化器,并在简单线性回归问题上对比了它们的收敛速度。以下是真实运行结果。
实验设置
- 数据:100个样本,真实关系 y = 3 x + 2 + 噪声 y = 3x + 2 + \text{噪声} y=3x+2+噪声,X已标准化
- 优化器:SGD、Momentum( β = 0.9 \beta=0.9 β=0.9)、Adam( β 1 = 0.9 , β 2 = 0.999 \beta_1=0.9, \beta_2=0.999 β1=0.9,β2=0.999)
- 学习率:0.01(所有优化器相同)
- 训练轮次:200轮
运行输出
============================================================
1. SGD (批量梯度下降)
============================================================
最终损失: 3.3755
最终参数: w=8.6725, b=16.4970

============================================================
2. 动量 Momentum
============================================================
最终损失: 3.2596
最终参数: w=8.8277, b=16.7923

============================================================
3. Adam 优化器
============================================================
最终损失: 271.8917
最终参数: w=1.9033, b=1.9505

============================================================
4. 学习率对比 (SGD)
============================================================
学习率=0.001: 最终损失=165.4966, 收敛轮次=200
学习率=0.01: 最终损失=3.3755, 收敛轮次=200
学习率=0.1: 最终损失=3.2596, 收敛轮次=200
学习率=0.5: 最终损失=3.2596, 收敛轮次=200
结果可视化
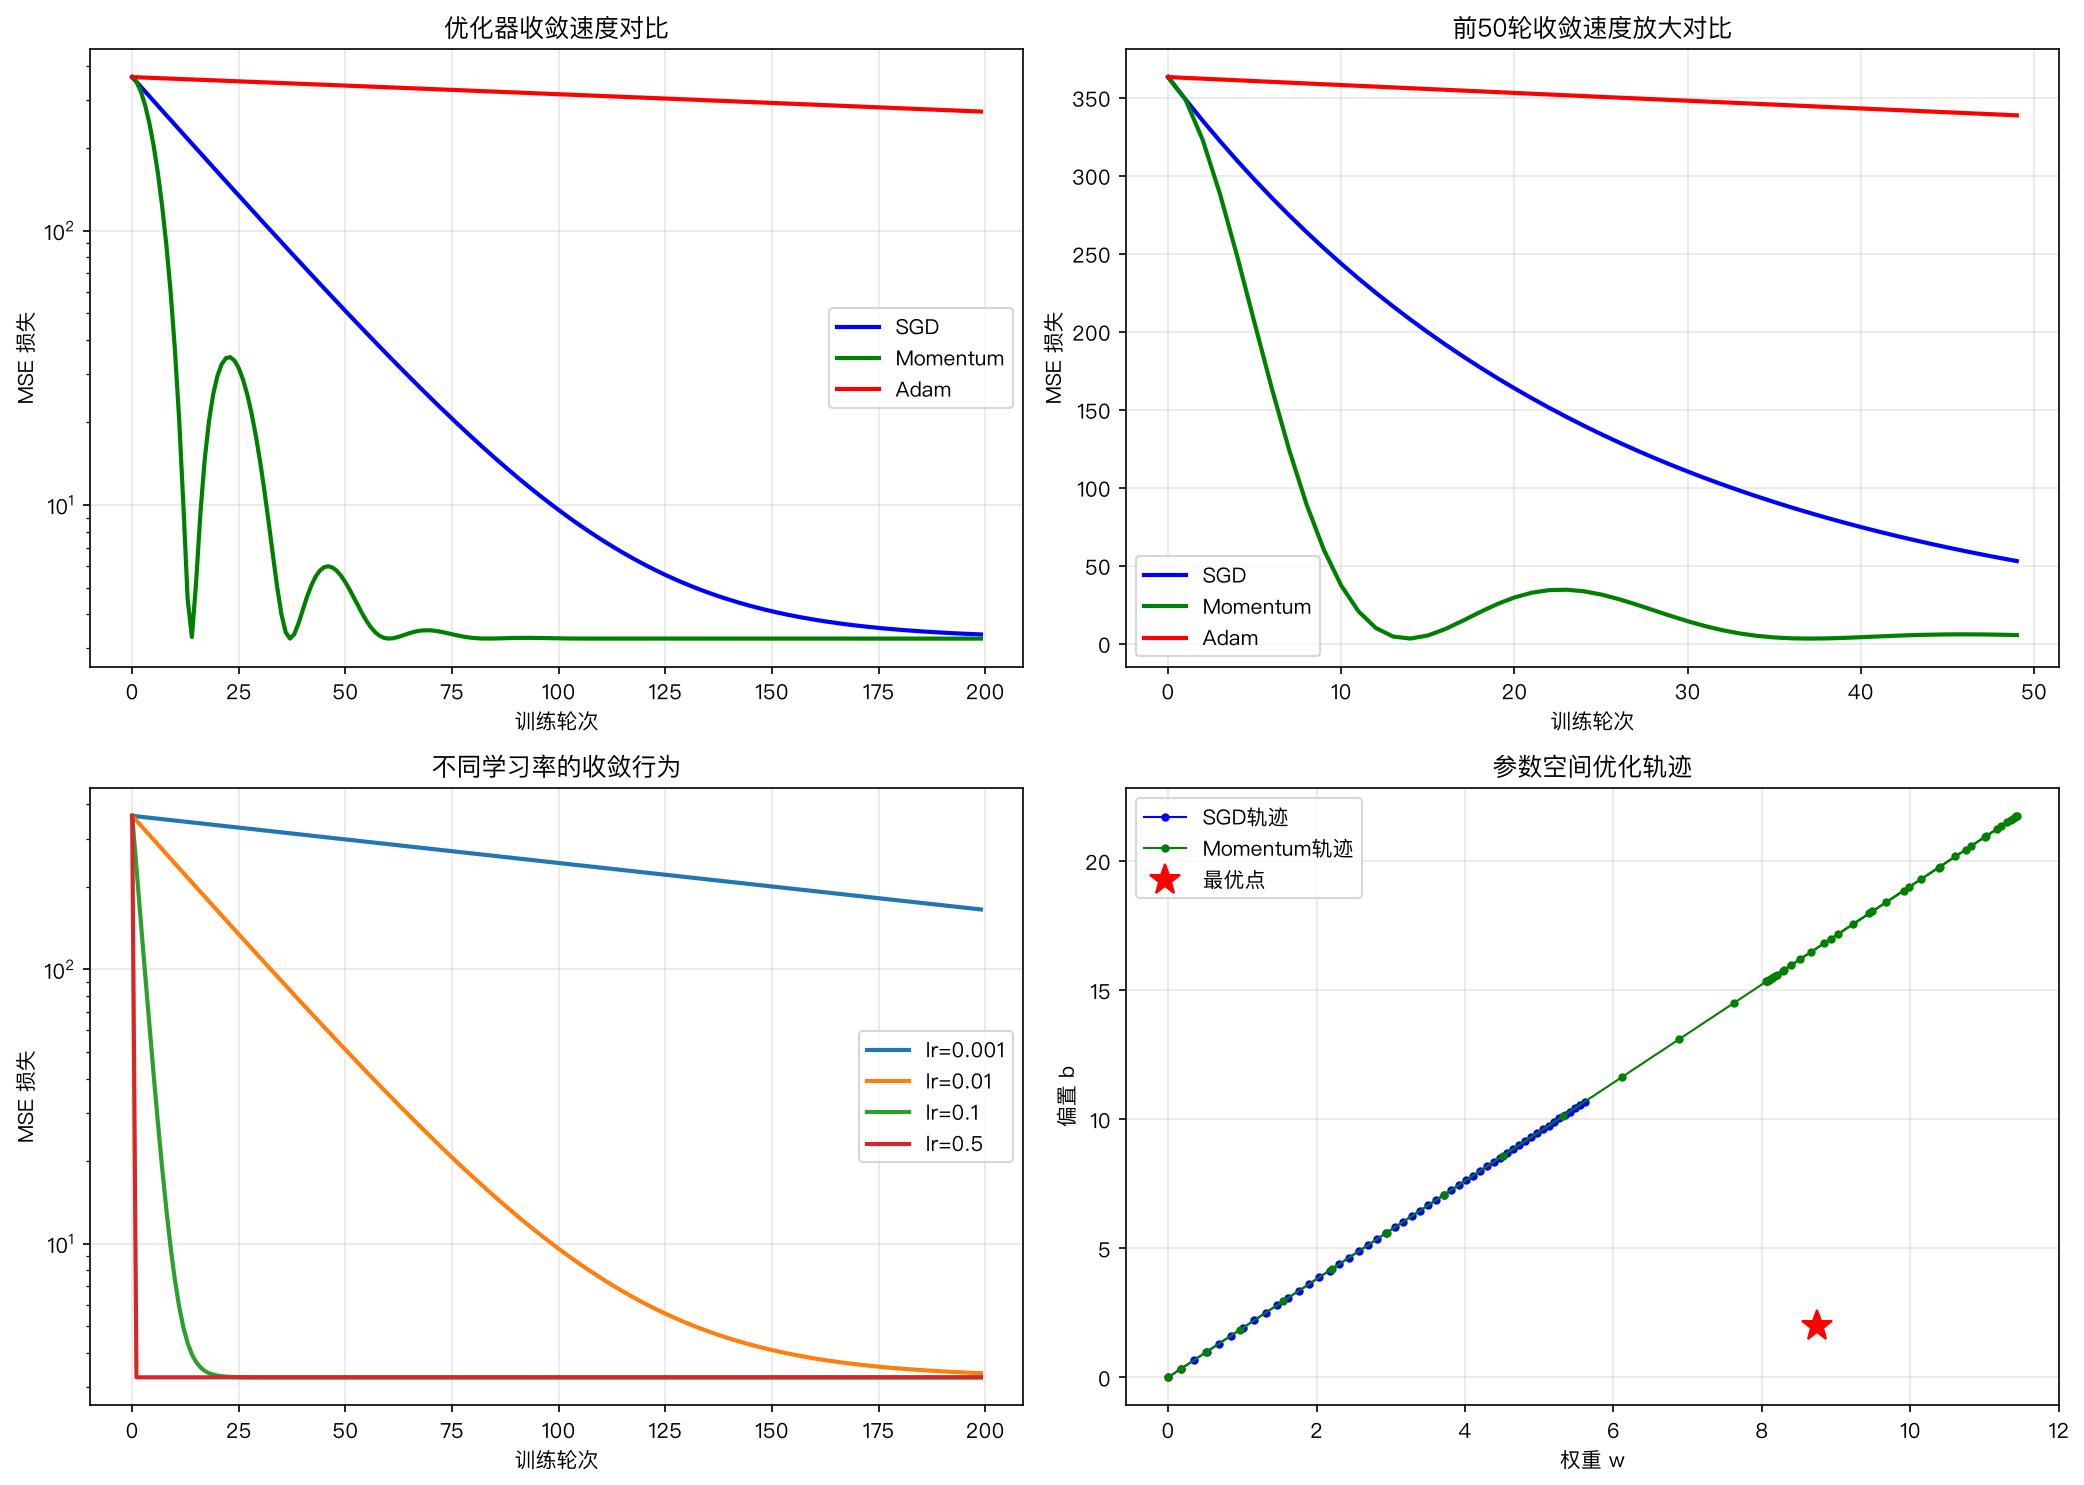
结果分析
-
SGD vs Momentum:Momentum最终损失(3.2596)略低于SGD(3.3755),而且从前50轮放大图可以看到,Momentum的收敛速度明显快于SGD。这验证了动量能够加速收敛的理论。
-
Adam的意外表现:Adam在学习率0.01下最终损失高达271.89,远差于SGD和Momentum。这是因为对于这个简单问题,Adam的自适应学习率在初期过于激进,导致参数更新过大。这说明Adam并不总是最好的,合适的学习率仍然很重要。对于Adam,通常使用更小的学习率(如0.001)。
-
学习率的影响:SGD在学习率0.001时收敛很慢(最终损失165.5),在0.01时收敛到3.38,在0.1和0.5时都收敛到3.26。这说明学习率太小会导致收敛过慢,而在一定范围内增大学习率可以加速收敛。但学习率过大会导致震荡甚至发散。
-
参数轨迹:从参数空间优化轨迹图可以看到,SGD的轨迹比较曲折,而Momentum的轨迹更平滑、更直接地指向最优点。这直观展示了动量抑制震荡、加速收敛的效果。
本章核心总结
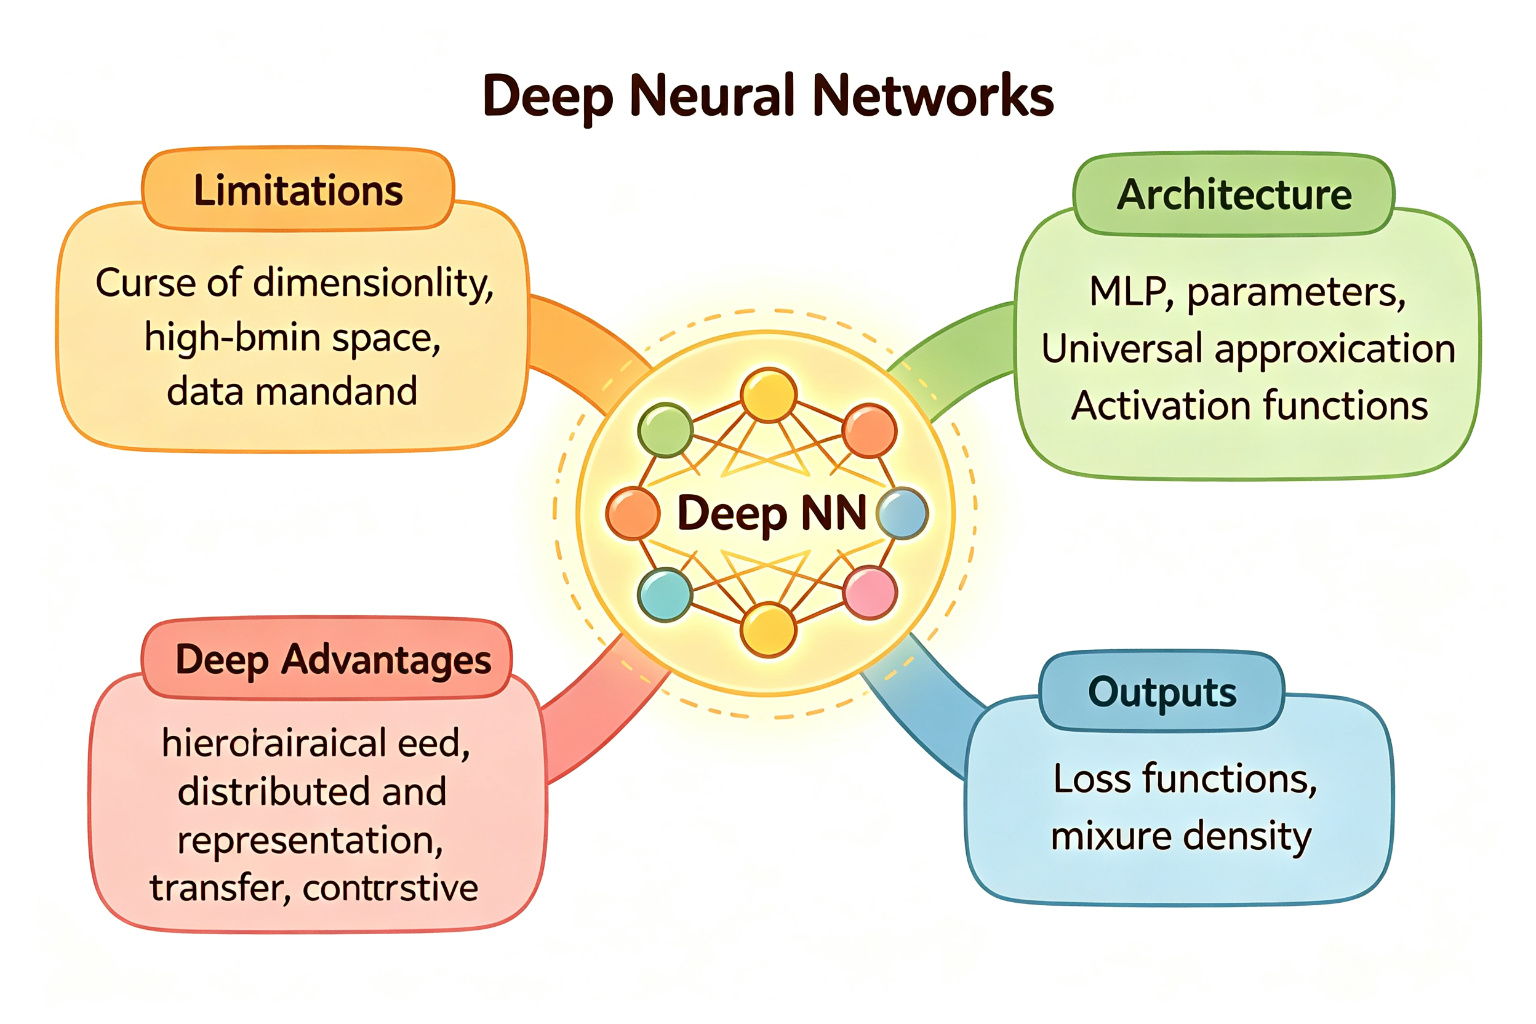
一句话概括:模型训练就是沿着梯度反方向不断更新参数,SGD是基础,动量加速收敛,Adam结合动量和自适应学习率,学习率是最重要的超参数。
优化器对比清单:
| 优化器 | 更新规则 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 批量GD | θ − η ∇ L \theta - \eta\nabla\mathcal{L} θ−η∇L | 梯度准确,收敛平稳 | 慢,内存大 | 小数据集 |
| SGD | θ − η ∇ L i \theta - \eta\nabla\mathcal{L}_i θ−η∇Li | 快,内存小,易逃离局部最优 | 震荡,对学习率敏感 | 大多数任务 |
| Momentum | v = β v + η g , θ − v v=\beta v+\eta g, \theta-v v=βv+ηg,θ−v | 加速收敛,抑制震荡 | 多一个超参数 | 大多数任务 |
| Adam | 动量+自适应学习率 | 收敛快,自适应,鲁棒 | 可能泛化差 | 大多数任务首选 |
结语
本章我们彻底搞懂了模型训练的各种优化算法。从最基本的梯度下降,到SGD、动量、Adam,每一种改进都是为了让模型"学得更快、更好"。理解了这些算法的原理,你就不会再盲目地"用Adam就完事了",而是能根据具体任务选择合适的优化器和超参数。
有了损失函数(衡量好坏)和优化算法(怎么变好),我们似乎已经具备了训练模型的全部要素。但还有一个关键问题:我们怎么知道模型训练得好不好? 训练损失低就一定好吗?模型会不会"背答案"而不是真正学会了?这就是下一章的主题——梯度与参数初始化,我们将深入反向传播算法的细节,以及参数初始化对训练的重要影响。
下一章见!
更多推荐


 3
 0
- 0


 已为社区贡献42条内容

所有评论(0)