- @weixin_38171602


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
下棋、打游戏、机器人控制,这些需要连续决策不断试错的任务靠的是强化学习。它模仿了人和动物最本能的学习方式,做对了给奖励、做错了给惩罚,在反复试错中学会最优策略。这篇用大白话讲透智能体环境奖励这套框架、AlphaGo怎么靠它称霸围棋,尤其讲清RLHF如何用它教会ChatGPT好好说话,配可跑代码。
下棋、打游戏、机器人控制,这些需要连续决策不断试错的任务靠的是强化学习。它模仿了人和动物最本能的学习方式,做对了给奖励、做错了给惩罚,在反复试错中学会最优策略。这篇用大白话讲透智能体环境奖励这套框架、AlphaGo怎么靠它称霸围棋,尤其讲清RLHF如何用它教会ChatGPT好好说话,配可跑代码。
从这篇起进入生成式AI。GAN有个绝妙的设计,让两个网络互相较劲,一个拼命造假、一个拼命鉴假,在这场猫鼠游戏里双方越来越强,最终造假的能生成以假乱真的图片。这篇用大白话讲透造假者和鉴别者的博弈、为什么这个对抗能让模型学会创造、输入输出,配可跑代码,并聊它的贡献和难训练的坑。
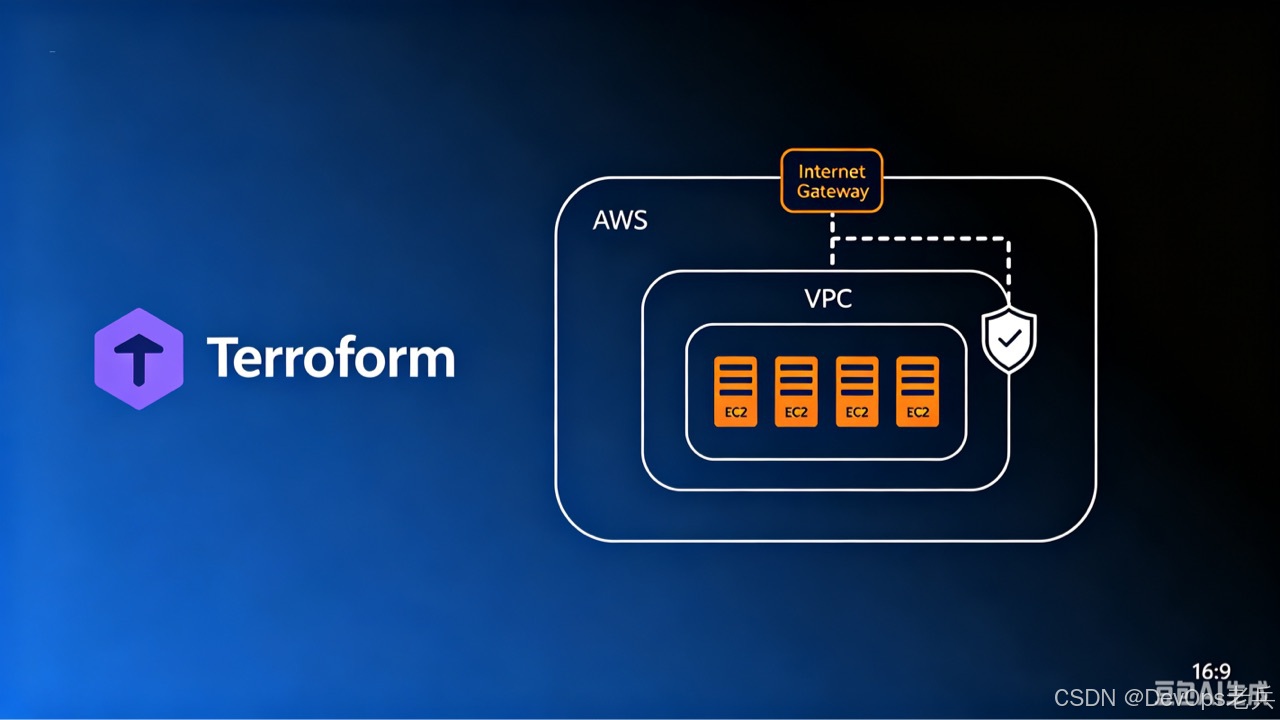
从零开始动手实操Terraform,在真实AWS环境中创建VPC、子网、Internet Gateway、安全组和EC2实例。详解资源间的依赖关系、Terraform核心命令(init/plan/apply/destroy),以及AWS网络架构中各组件如何串联。附完整代码和关键字段说明。
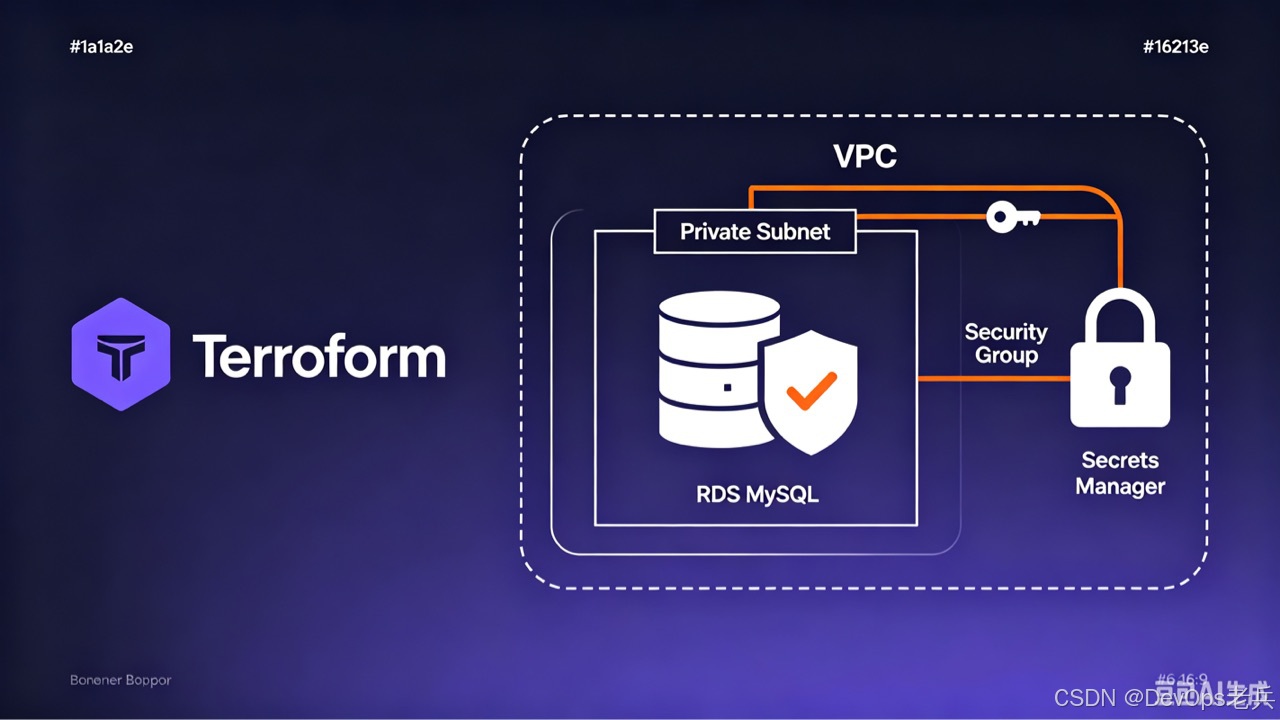
用Terraform创建RDS MySQL数据库,配合random_password生成强密码,通过Secrets Manager安全存储数据库凭证。详解数据库子网组、存储加密、安全组限制、生产环境安全最佳实践对照表。
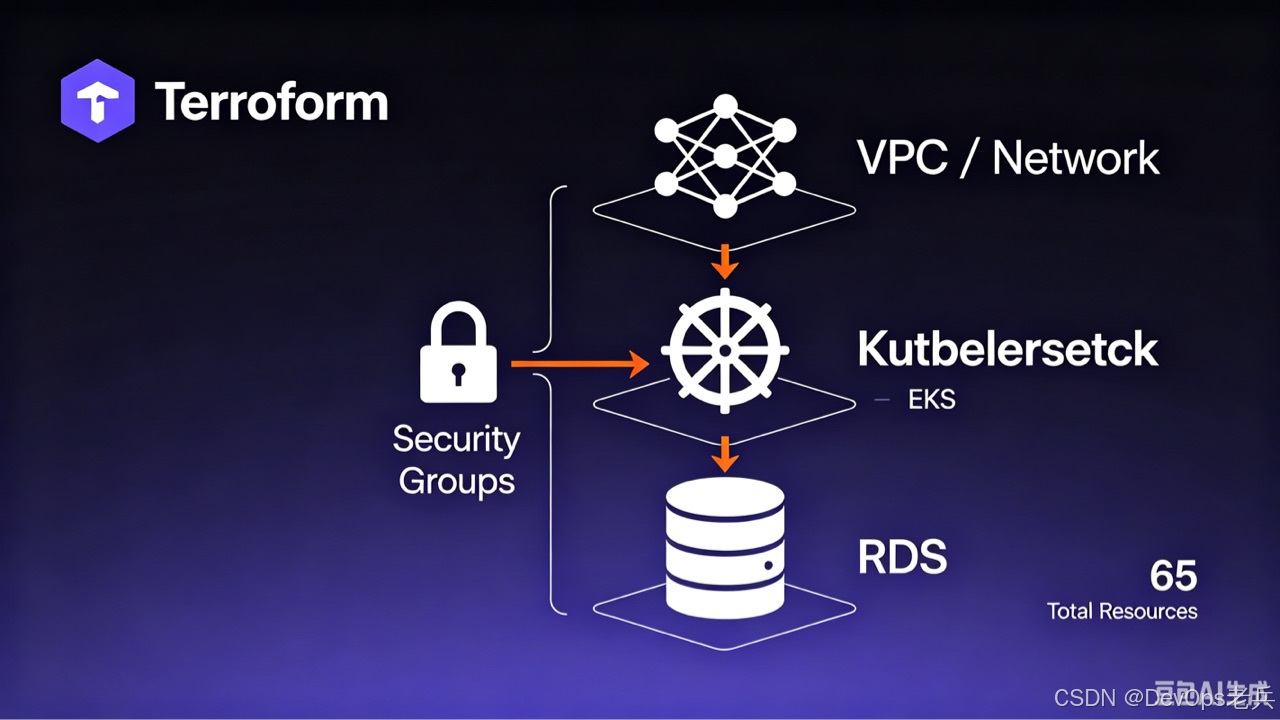
将前面所有知识串联,用一套Terraform代码构建完整的生产级三层架构:网络层(VPC+6子网+NAT)、计算层(EKS集群)、数据层(RDS+Secrets Manager),共65个资源。重点讲解安全组链式设计实现层与层之间的精确访问控制。
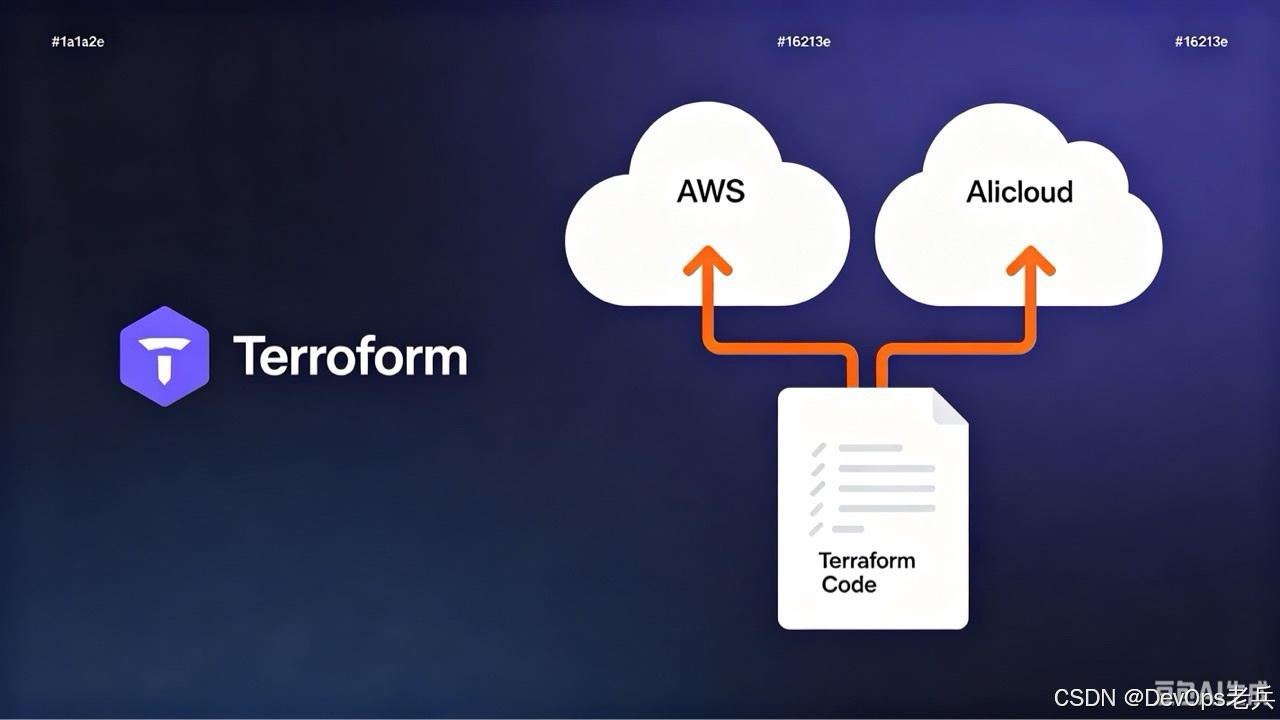
演示用Terraform同时管理AWS和阿里云,配置多Provider和alias实现多云多区域管理。详解AWS与阿里云资源对照表、sensitive变量、多云项目结构设计,直接对应三云DevOps的实际工作场景。
用最通俗的方式解释大模型的工作原理:它不是"查答案"而是"造句",逐字预测生成回答。详解Token计费、训练vs推理的区别、模型大小与GPU显存的关系、Prompt的三种角色,帮助运维工程师建立对大模型的正确认知。

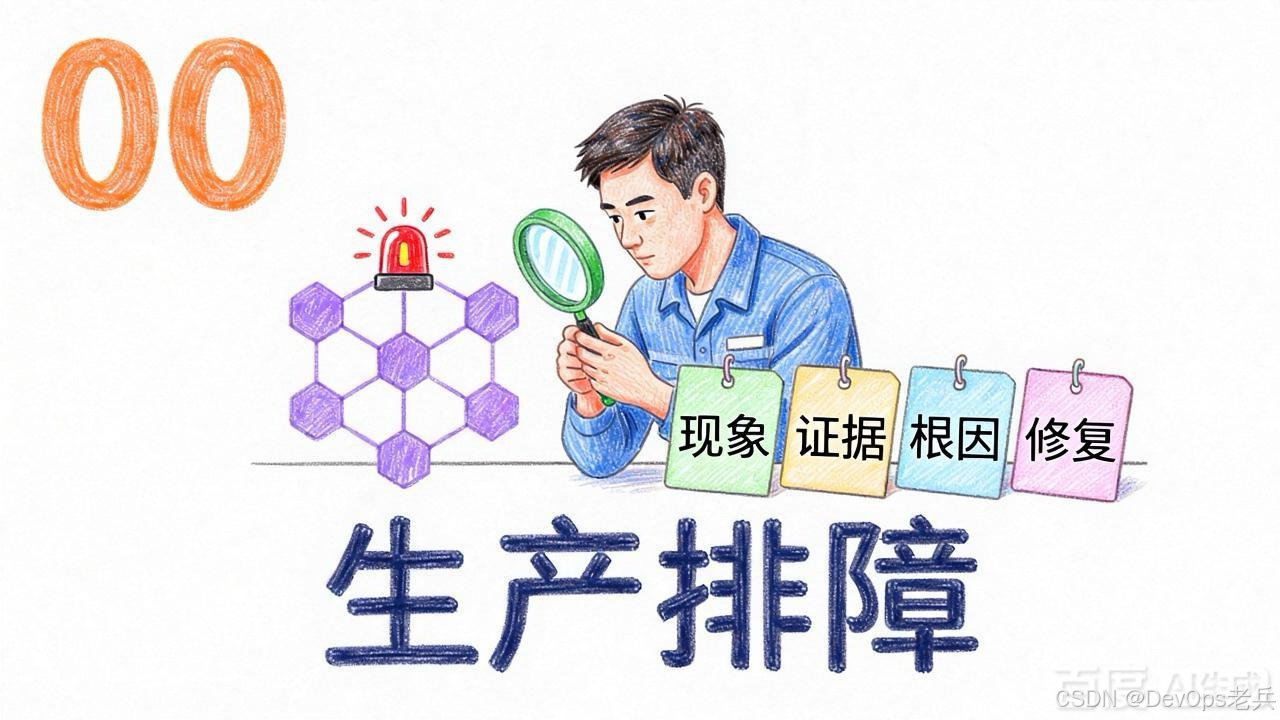
会创建Deployment、Service和Ingress,只能说明会使用Kubernetes。生产运维真正考验的是面对模糊故障时,能否根据影响等级决定先止损还是先定位,再用时间线和分层证据不断缩小范围,最终形成修复、监控与复盘闭环。本文给出整套专栏路线和通用排障框架。
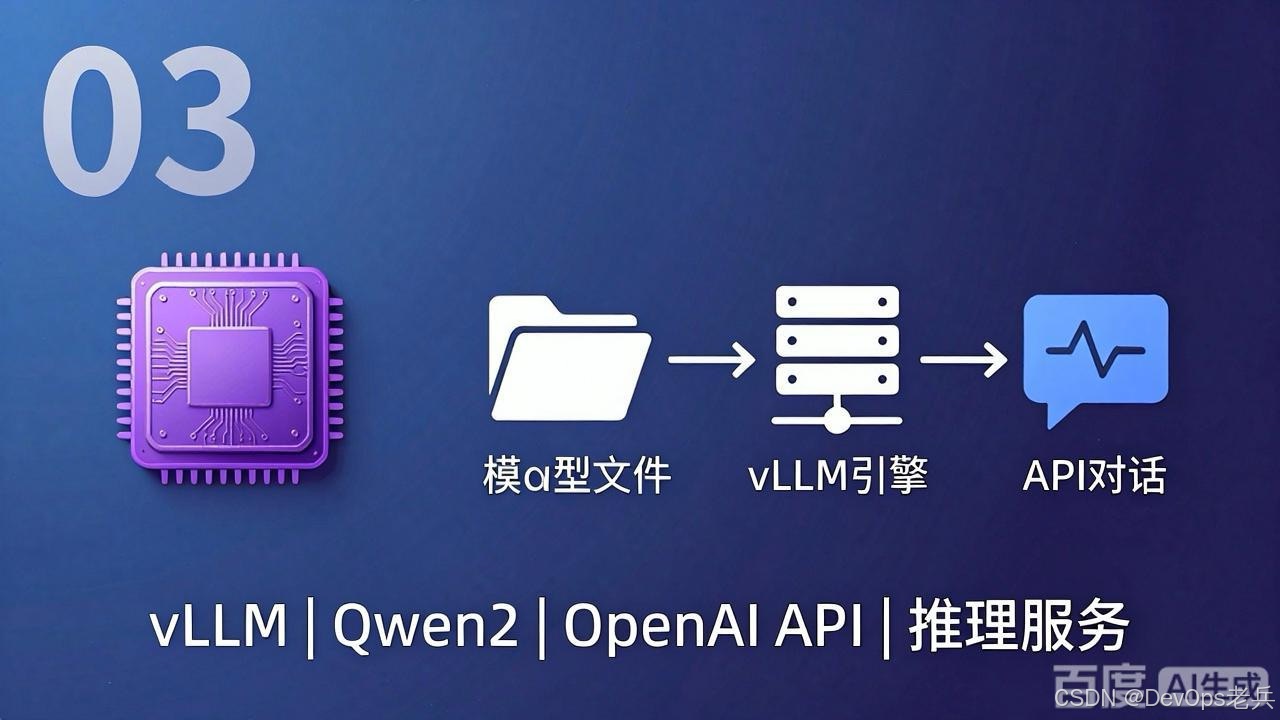
在AutoDL T4 GPU上部署vLLM推理服务,使用Qwen2-1.5B模型实现OpenAI兼容API。详解模型下载、服务启动、多种API调用方式(对话/流式/角色设定),附T4环境踩坑记录(HuggingFace镜像、flash-attn兼容)。