- @qq_52213943


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这些题目覆盖了多种编程概念,包括循环、条件语句、函数、递归、列表处理、字符串操作、算法思想等。通过实践这些练习,不仅会加深对Python语法的理解,还会学会如何结构化地思考和解决问题。

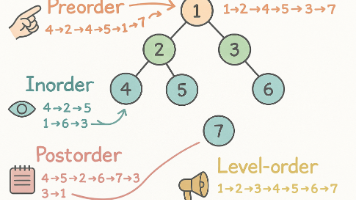
在学习和使用数据结构时,二叉树是最基础、也最容易考察的结构之一。而遍历方式,则是二叉树应用的入口。所谓「遍历」,是指按照某种规则,依次访问树中的每一个节点。而在众多遍历方式中,前序、中序、后序遍历是最经典、最基础、也最常用的三种。
回溯算法(Backtracking)是一种通过逐步尝试构建解,并在发现当前路径无法满足条件时回溯以重新尝试的算法思想。它是一种系统的搜索方法,特别适用于解决组合、排列、分割和图遍历等问题。本文将结合回溯算法的核心思想,通过典型案例及Python实现详细解析其应用场景。
贪心算法(Greedy Algorithm)是一种通过选择当前最优解以期望达到全局最优解的算法思想。它在每一步选择时只考虑当前状态下的局部最优,而不关心全局问题的复杂性。这种算法简单高效,适用于某些特定问题,尤其是存在贪心选择性质和最优子结构的问题。本文将从贪心算法的基础思想出发,结合Python代码,详细解析其应用与实现。
逐步深入介绍Python正则表达式,从最基础的概念到更高级的应用。每个部分都建议包含实际的代码示例和解释,以帮助大家更好地理解和掌握。
本篇主要介绍算法相关理论,包括算法的定义、特性;时间、空间复杂度计算等,本篇少量代码。
本文围绕开发中常见的 HTTP 状态码问题,讲解 200、301、302、400、401、403、404、500、502、503、504 等状态码的含义、使用场景和排查思路。文章结合接口调试、登录鉴权、页面跳转、资源访问、服务端异常等实际场景,帮助开发者快速判断问题方向,并提升前后端联调和线上故障排查效率。
在现代互联网环境下,爬虫不仅是数据获取的利器,也成为应对网站反爬机制的技术博弈。而在这场博弈中,"代理 IP" 是核心武器之一。本文将以高匿名的代理ip为核心,结合 Python 实战、代理策略设计、高匿技巧与反封锁优化,全面拆解代理 IP 技术的实际应用路径,并通过完整案例实现一个稳定、高效、抗封锁的爬虫系统。
导语:在我们使用爬虫时,有些网站会限制每个 IP 的访问速度或访问次数,超出了它的限制IP 就会被封掉,对于访问次数限制的突破,就需要使用代理 IP了,使用多个代理 IP 伪装成不同的用户轮换着去访问目标网址可以有效地解决问题。
当我们回望这场大模型浪潮,会发现它既是一场技术革命,也是一场认知误导。我们看到了语言的奇迹,却忽略了理解的幻觉;我们沉醉于AI的流畅表达,却忘记它仍是一台概率机器。真正的危险,不在于AI有多聪明,而在于我们有多愿意相信它聪明。