登录社区云,与社区用户共同成长
邀请您加入社区
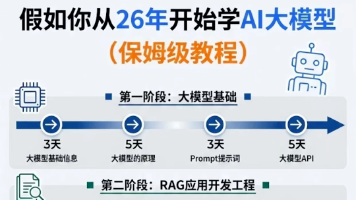
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!😝有需要的小伙伴,可以保存图片到。
本文系统梳理了从零开始成为AI大模型应用开发工程师的学习路径,涵盖数学编程基础、机器学习、深度学习及大模型实战应用。强调通过理论学习与项目实践结合,掌握Transformer架构、RAG、Agent开发与模型微调等核心技术。虽提及“3个月速成”捷径,但核心仍倡导扎实积累与持续学习,助力从业者高效入行,把握高薪就业机遇。
2026年9月11日,工信部信息技术发展司正式对外发布《"人工智能+软件"专项行动实施方案》(工信部信发〔2026〕209号,文号日期2026-09-02)。这不是一个孤立政策,它与"十五五"规划中"软件和信息服务为扩能提质重点领域"的定位一脉相承。"AI+软件"正在从技术探索期进入政策驱动期。
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应
为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选很简单,这些岗位缺人且高薪智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。AI产业的快速扩张,也让人才供需矛盾愈发突出。
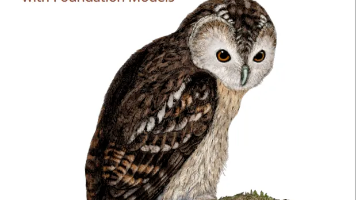
本文推荐一本关于 AI 工程的书籍《AI Engineering: Building Applications with Foundation Models》
谢飞机,你的基础不错,但AI和微服务高级内容还需加强。我们会尽快通知你。
本次面试设定在一家大型互联网公司,主攻方向为内容社区与UGC场景下的AI智能推荐系统。求职者谢飞机是一位自称水货的程序员,面对技术问题时表现出不同程度的掌握。
随着DeepSeek的爆火,AI大模型工程化开发需求旺盛。很多后端工程师对于如何转行到AI大模型工程化工程师有很多迷茫。
本文概述文章目标、核心观点和实践价值。[摘要]从传统数仓和离线/实时计算转向大模型工程,很多人以为只要学几个 Prompt 框架就能无缝衔接。实际踩坑后发现,大模型应用 80% 的瓶颈不在算法,而在数据治理、检索管道设计和团队协作规范。本文不聊概念,直接拆解数据工程师在 RAG 架构中的真实工作流,重点讲清楚指标取舍、日志埋点策略和可维护性设计,附带一段生产级管道代码,给想拿面试证据的人一套可复用
这篇面向想从爬虫和自动化采集转向 AI 数据工程的开发者,但不会把“爬虫转大模型:代码实践里的关键取舍”写成概念清单。我会按实战导向的转型指南的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“爬虫转大模型:代码实践里的关键取舍”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里
本文概述文章目标、核心观点和实践价值。摘要:从数据采集工程师转型为大模型数据工程师,最大的误区不是学不会向量数据库,而是忽视了生产环境下的稳定性与合规性。本文基于一次真实的项目重构经历,重点复盘如何将传统的“爬取-清洗”流程转化为具备高可用性的 RAG 语料生产线。文章不谈空泛的理论,而是聚焦于线上故障排查中的风险控制、监控体系搭建以及回滚机制的设计。对于希望提升 AI 工程化能力的爬虫开发者来说
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。最近业务方提了个需求:把内部知识库问答接口接进现有的 CRM 系统。说实话,听到“知识库”三个字我头皮就麻了一下。之前的 Demo 阶段,我们用 LangChain 搭了个 RAG(检索增强生成)原型,准确率看着还行,回复速度也凑合。但当真的要把这个“玩具”塞进生产环境,面对并发、权限控制、敏感数据过滤以及漫长的用户
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。很多做传统后端开发的兄弟,最近都在焦虑:手里那点 CRUD 和微服务经验,在大模型面前是不是瞬间过时了?我也经历过这种阶段。年初接了几个外包,帮客户做内部知识库问答,当时觉得只要把 LangChain 或者 LlamaIndex 跑通,把 RAG 检索准确率提上去,就是大功告成。结果呢?代码在本地跑得飞起,一上生产环
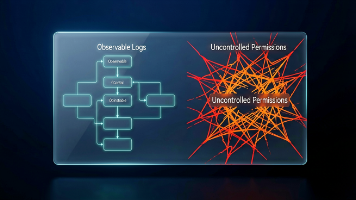
先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要:很多前端同学觉得转做大模型应用就是调个 API,写好 Prompt 就行。但在实际项目复盘里我发现,Demo 跑得飞起,一上线就崩盘的核心原因往往不是模型不够聪明,而是缺乏生产环境必备的权限控制和可观测性。本文不谈虚的,直接从工程化视角拆解如何构建稳健的 AI 产品后端。前端转大模型,最大的陷阱就是“技术视角的
过去两年,AI Coding 的新词来得很密:Prompt Engineering、Context Engineering、Harness Engineering、Loop Engineering。
很多大数据工程师转大模型,第一反应是学LangChain、调Prompt、搭Agent。但我踩过坑之后发现,真正决定项目能不能上线的,不是模型能力,而是权限管理、调用日志和可观测性。这篇文章复盘我从大数据到AI工程化的真实转型路径,重点讲数据治理经验如何迁移、向量数据库怎么选型、RAG管道怎么设计,以及小团队如何避免过度设计。---回头看,我从大数据转大模型,最值钱的经验不是学了几门新工具,而是工