登录社区云,与社区用户共同成长
邀请您加入社区
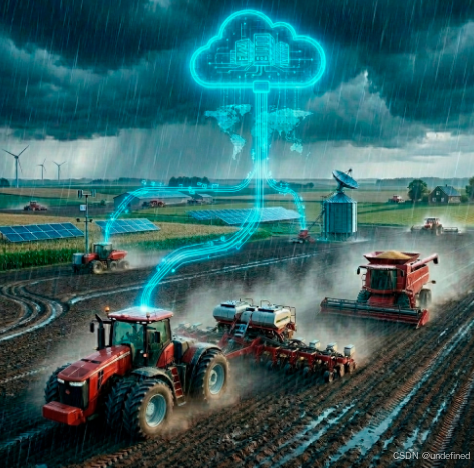
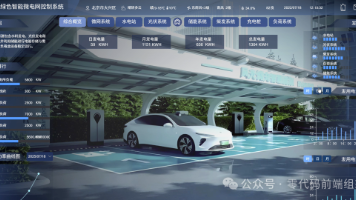
2026年9月展现出的产业图景向我们证明:人工智能真正的生命力不在于象牙塔里的指标竞赛,而在于走进工厂车间、走入田间地头、深入能源网格。通过构建严谨的“端边云”架构,将算法与物理规律相结合,人工智能正在深刻地重塑着实体经济的竞争格局。对于所有从业者而言,保持对物理世界与工业规律的敬畏,扎扎实实推进数据治理与架构升级,才是拥抱智能化时代的最优路径。
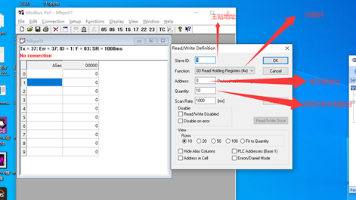
Modbus 是工业自动化、物联网网关里出现频率极高的一种通信协议,PLC、变送器、传感器、电表、温控仪表几乎都支持它。本文从"主站/从站"讲起,系统梳理 Modbus 的三种传输模式、四大数据区、8 个常用功能码,并结合真实报文逐字节拆解读线圈(01H)和读保持寄存器(03H)的完整问答过程,最后讲清初学者最容易懵的"寄存器地址与偏移量"以及 CRC 校验。零基础可读,也适合作为工作中的查询手册
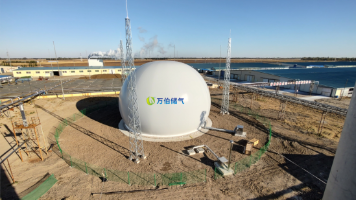
通辽大型牧场面临沼气产用不平衡、高寒环境设备失效、运维困难及安全风险等挑战。项目采用万伯3000m³双膜气柜,集成高寒定制传感器、电磁主动泄压、高精度阀门、物联网远程监控与主动服务机制,实现产气缓冲调峰、智能调控与远程运维。系统具备千分之一级气密性、抗硫化氢腐蚀、防冻抗寒能力,保障全年稳定运行,显著提升沼气利用率,降低碳排放,助力草原畜牧业绿色循环发展。
传感器感知数据、设备采集信息、系统智能分析、平台联动执行。从智慧停车场、智能道路的交通优化,到无人超市的无感结算,再到EPC体系的万物唯一标识,所有智能场景都不是单一设备的作用,而是多硬件、多系统、多技术的协同联动。简单总结核心区别:EAS只防盗、条码只分类、RFID做识别、EPC做唯一溯源、ONS做地址解析、EPCIS做数据存储,各司其职,构成了我们如今便捷的智能生活。
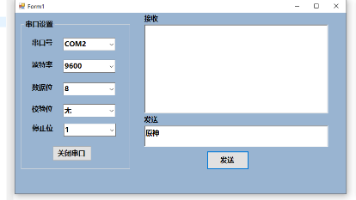
使用 C# WinForms 和 System.IO.Ports.SerialPort 实现一个简易串口通信小工具:支持串口号、波特率、数据位、校验位、停止位配置,完成双窗口中文消息收发,并在接收端通过字典匹配关键词自动展开回复内容。代码简洁、思路清晰,适合上位机 / 物联网初学者入门参考。
移动机械物联网的接入选型本质上是场景需求与产品能力的精准匹配,不存在通用的“最优解”。如果你的部署场景是高粉尘、高颠簸、宽温运行的户外移动作业场景,以owa5x为代表的IP67加固型一体化智能车载网关方案是更可靠的选择,能够为设备长期稳定运行提供扎实的硬件支撑,帮助企业大幅简化移动机械物联网系统的搭建流程,降低全生命周期的综合投入,为移动机械的数字化运维升级提供坚实的技术底座。
边缘计算是一种分布式IT架构,它将计算资源从云和数据中心移动到尽可能靠近原始数据生成源的位置,在数据产生的本地节点直接完成分析、处理动作,无需将全量数据远距离传输到云端集中运算。通俗来说,边缘计算就像是部署在车辆本地的“小型运算大脑”,车辆运行产生的总线数据、状态参数不需要全部传到千里之外的云服务器,在车载网关端就能完成初步过滤、异常识别、规则判断等操作,仅把有价值的特征数据上传到云端做深度分析。
华为官方标准定义:云计算是一种按需获取、弹性伸缩、可计量付费的分布式计算资源交付模式,通过网络将计算、存储、网络、软件等资源虚拟化、池化,以服务的形式按需交付给用户。弹性云服务器(Elastic Cloud Server,ECS)是基于华为云虚拟化技术,可随时弹性伸缩、自主管理的虚拟计算服务,提供稳定、安全、高性能的计算能力,支撑网站搭建、项目部署、数据分析、测试环境等全场景业务。极速部署:分钟级
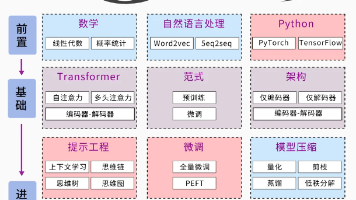
聚焦大模型应用开发,普通人也能抓住AI时代红利。该领域门槛低、需求旺、落地强,零基础者可通过系统规划入行。关键路径包括:掌握Python、学习实战课程、调用开源模型、深耕垂直场景、积累作品集,并借助社区与政策资源。避免唯算法论和数据迷信,坚持长期学习,即可实现逆袭。
通过以上七个阶段的学习,您将能够建立起对大规模预训练模型的深刻理解,并掌握其在实际应用中的技巧。记得在学习过程中保持好奇心和探索精神,积极尝试新技术并参与社区讨论。希望这份学习路线图能帮助您成功踏上大规模模型的学习之旅!如果您对某个特定阶段或主题有更详细的问题,欢迎随时提问!
作者:卢敏 汉江师范学院大二 数据科学与大数据技术专业我现在是一名大二学生,我的专业是数据科学与大数据技术,听我专业的名字便也知道肯定和数据存在着很大的关联,在2025的暑假期间,我们老师在群聊里面发布了关于CDA一级考试的通知,并且鼓励我们好好利用假期时间学习并参加一级考试,学习的过程也是提升自己专业能力的过程,于是,我便开始了跟着教学视频学习CDA的旅程。
作者:熊紫燕 汉江师范学院数据科学与大数据技术专业大二学生作为一名大二数据科学与大数据技术专业的学生,数据处理与分析一直是计算机类的重点方向。去年寒假和今年暑假,系里导师分享了CDA数据分析师认证的相关信息,强调其在行业内的认可度和对求职的助力,建议我们尽早通过一级考试夯实基础。由于寒假错过了一次机会,抱着提升实操能力、为职业发展铺路的想法,我开启了为期两个月的暑假CDA备考之旅。
4. 命令别名配置:通过系统别名命令,为常用 docker 命令设置自定义别名,简化输入。◦ 编写 Dockerfile,使用 docker build 命令将其构建成本地镜像。1. docker ps:查看容器运行状态,默认显示正在运行的容器。◦ docker load:将保存的镜像压缩文件加载回本地镜像库。1. docker stop:停止容器内的进程,容器本身仍然保留。2. 镜像删除:doc
官方文档:控制器也是管理pod的一种手段Pod控制器是管理pod的中间层,使用Pod控制器之后,只需要告诉Pod控制器,想要多少个什么样的Pod就可以了,它会创建出满足条件的Pod并确保每一个Pod资源处于用户期望的目标状态。如果Pod资源在运行中出现故障,它会基于指定策略重新编排Pod当建立控制器后,会把期望值写入etcd,k8s中的apiserver检索etcd中我们保存的期望状态,并对比po
本文系统阐述了问答Agent效果评估的方法论,从检索、生成、呈现三个环节构建量化指标体系。在检索环节采用Recall@K等指标评估召回质量;生成环节关注忠实度、相关性等维度;交互环节评估任务完成率等指标。针对主观评价,引入Rubric评分体系和LLM-as-Judge自动化评估方法,并建立标准测试集。最后强调将技术指标与用户满意度、人工介入率等业务指标关联,形成完整评估闭环。这种分层量化、主客观结
该平台通过打造支持多云环境的一体化研运流水线,实现了从“代码→构建→测试→部署”的全链自动化。这不仅极大地支撑了业务的敏捷交付需求,确保新品与活动能够快速上线响应市场,更从根本上打破了研发与运维之间的壁垒,为亿滋建立了一套高效、协同、可靠的现代化软件生产与管理体系。在中国信息通信研究院(CAICT)公布的2025年“铸基计划”典型案例入围名单中,联蔚盘云与亿滋食品企业管理(上海)有限公司联合打造的
本文介绍了C++中stack(栈)和queue(队列)两种适配器容器的核心特性与使用方法。栈遵循后进先出规则,适用于函数调用栈等场景;队列采用先进先出原则,常用于任务调度等场景。文章详细讲解了两者的头文件、定义方式、常用接口(如push/pop/top等),并提供了代码示例。最后通过4道经典算法题(最小栈、栈序列判断、逆波兰表达式求值、二叉树层序遍历)进行实战演练,帮助读者掌握这两种容器的实际应用
标题:基于python大数据技术的职位推荐平台内容:1.摘要本研究旨在构建一个基于Python大数据技术的职位推荐平台,以解决求职者与招聘岗位之间信息匹配效率低下的问题。通过爬取主流招聘网站的公开数据,利用Python中的Pandas、NumPy等工具对超过50万条职位信息进行清洗与结构化处理,并采用TF-IDF与余弦相似度算法实现求职者简历文本与岗位要求的语义匹配。同时,引入协同过滤算法优化推荐
【摘要】大模型在前端开发中存在明显短板,尤其在工业场景下暴露四大痛点:1.组态联动仅能输出静态图形,无法实现设备逻辑绑定;2.复杂交互只能处理基础点击事件,难以支撑多元素实时联动;3.工业绘图精度不足,图层管理和矢量支持薄弱;4.MQTT通信与图形引擎割裂,数据驱动能力缺失。UIOTOS通过工业级图形引擎和嵌套技术,实现拖拽配置组态逻辑、内置矢量绘图工具、自动处理数据图形联动,为物联网应用提供零代
本文介绍使用TM1中的Bedrock工具快速清理Cube数据的方法。Bedrock是开源免费的TI进程库,可避免手动操作风险,精准清除指定范围数据。工具提供详细参数说明,帮助用户高效完成数据清理任务。
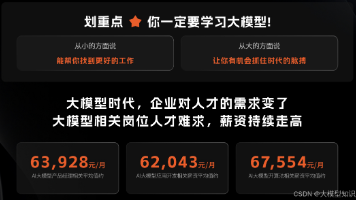
人工智能行业正迎来爆发式增长,本文为普通人和程序员提供转型AI的实用指南。文章解析了三大AI岗位类型:技术类(需编程)、产品运营类(转行首选)和行业融合类(跨界应用),并给出四步入门路径:基础学习、方向专攻、项目实践和求职准备。特别推荐MiniMax、智谱华章等AI公司,强调即使不会编程也能通过产品运营岗进入AI领域。文章还指出2025年大模型人才缺口将达400万,并提供了包含学习路线、实战项目和
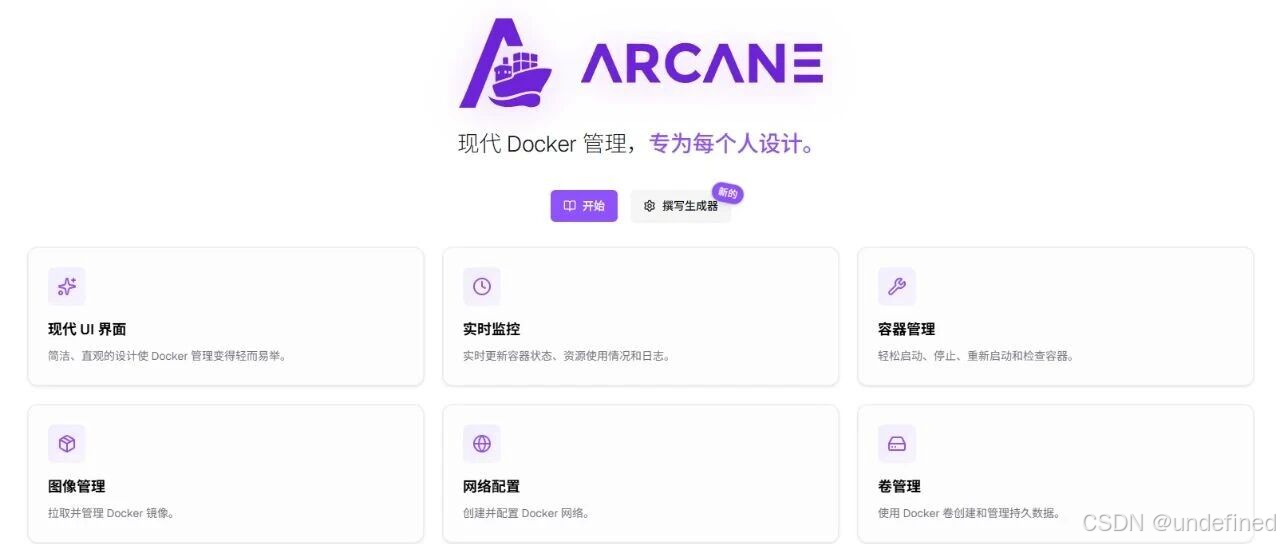
最适合国人的Docker管理,简洁直观!
2. 计算当前水量:容器水量由“短板高度”和“两板距离”决定,即 min(height[left], height[right]) * (right - left),并更新 maxArea。1. 初始化指针:左指针 left 指向数组起始(0),右指针 right 指向数组末尾(height.length - 1),maxArea 记录最大水量(初始为0)。3. 移动短板指针:为了寻找更大水量,需
深度学习中的前处理与后处理入门指南 前处理是为模型准备数据的步骤,主要包括:1)数据清洗,去除异常或错误样本;2)数据标准化/归一化,统一数据范围;3)数据增强,通过变换扩充数据集。后处理则是对模型输出进行优化,包括:1)结果过滤,去除低置信度预测;2)结果修正,调整输出使其更准确自然。前处理是基础,后处理是锦上添花,两者配合能显著提升模型效果。实际应用中应选择适合任务需求的简单方法,而非追求复杂
上线后,监控和预警仍然是不可或缺的。需要监控单服务的可用性(如CPU、内存、数据库、响应时间等),当服务调用失败和业务出现异常的时候也需要预警并让相关人员及时处理。特别是作为公共服务的微服务,更需要出现异常时第一时间跟进解决。测试同学可以帮忙梳理监控点和指标,以及当项目未实现线上监控时监督开发增加监控预警功能。
标题:基于python大数据的城市扬尘数字化监控系统的设计与开发内容:1.摘要本研究旨在设计与开发一套基于Python的大数据城市扬尘数字化监控系统,以提升城市环境治理的智能化水平。随着城镇化进程加快,建筑施工、道路运输等活动导致扬尘污染日益严重,占城市颗粒物(PM10)来源的30%以上。为实现对扬尘污染的实时监测与精准管控,系统采用Python作为核心开发语言,结合物联网传感器网络采集施工现场、
标题:基于python大数据的省级城市政企客户业务分析系统内容:1.摘要本研究旨在构建一个基于Python的大数据省级城市政企客户业务分析系统,以提升政府与企业间业务数据的处理效率与决策支持能力。针对传统数据分析系统在处理海量、多源异构数据时存在的响应慢、集成度低等问题,系统采用Python语言结合Pandas、NumPy进行数据清洗与预处理,利用Spark Python API(PySpark)
在数据科学的发展历程中,统计学与机器学习代表了两种截然不同的思维范式:一个以假设与参数估计为核心,强调模型的可解释性与理论严谨;另一个以模式识别与预测准确率为导向,依靠算法从数据中自动学习规律。本文系统梳理了从统计学“参数化范式”到机器学习“模式识别范式”的方法论转变,分析了两者在理论假设、数据依赖、模型结构、目标导向等维度的根本差异。通过结合生物医学、金融风险建模等领域的实际案例,文章展示了在不
Helm在第三方Chart管理和模板化方面更具优势配置管理:Kubernetes原生配置方案比Nacos更符合云原生标准流量管理:Traefik 2提供了更灵活的Ingress路由能力。
标题:基于python大数据的井盖监控系统的设计与开发内容:1.摘要针对城市井盖安全问题频发、传统人工巡检效率低下的现状,本文设计并开发了一套基于Python的大数据井盖监控系统。该系统融合物联网传感器、GPS定位与无线通信技术,实时采集井盖状态(如倾斜、位移、震动)数据,并通过MQTT协议传输至后端服务器。基于Python构建的后端采用Flask框架处理数据,结合MySQL与Redis实现数据存
基于Python Web的大数据系统监控平台的设计与实现内容:1.摘要随着大数据技术的快速发展,海量数据处理系统的复杂性日益增加,对系统运行状态的实时监控提出了更高要求。本文设计并实现了一个基于Python Web的大数据系统监控平台,旨在提升系统可观测性与运维效率。平台采用Flask作为Web框架,结合InfluxDB时序数据库和Grafana可视化工具,实现了对Hadoop、Spark等大数据