
《理解深度学习》第13章 图神经网络 读书笔记
《理解深度学习》第13章 图神经网络 读书笔记
目录
- 13.1 什么是图
- 13.2 图的表示
- 13.3 图神经网络、任务和损失函数
- 13.4 图卷积网络
- 13.5 示例:图分类
- 13.6 归纳模型与演绎模型
- 13.7 示例:节点分类
- 13.8 图卷积网络的层
- 13.9 边图
- 13.10 本章小结
- 代码实验结果
- 本章核心总结
- 结语
开篇导语
前面我们学习了全连接网络、卷积网络、残差网络、变换器——这些都是处理欧几里得结构数据(如图像、文本)的强大工具。图像有规则的网格结构,文本有线性的序列结构,CNN和Transformer正是利用了这些结构特性。
但现实世界中还有一类重要的数据:图结构数据(Graph)。社交网络中用户是节点、好友关系是边;分子中原子是节点、化学键是边;知识图谱中实体是节点、关系是边;交通网络中路口是节点、道路是边。图数据没有固定的网格或序列结构,节点之间的连接是任意的、不规则的,CNN和Transformer都不适合直接处理。
怎么处理图数据?答案是图神经网络(Graph Neural Network,GNN)——一种专门为图结构数据设计的神经网络。GNN的核心思想是消息传递(Message Passing):每个节点从它的邻居节点收集信息(消息),聚合后更新自己的表示。通过多层消息传递,每个节点最终能融合多跳邻居的信息,学到丰富的结构和特征表示。GNN在社交网络分析、药物发现、推荐系统、知识图谱推理等领域有广泛应用。
本章我们将系统学习图神经网络。首先了解图的基本概念和表示方法,然后学习图卷积网络(GCN)的原理,接着看节点分类和图分类任务,讨论归纳与演绎学习,最后看GCN的层数设计和边图。
13.1 什么是图
图的定义
图(Graph) 由**节点(Node/Vertex)和边(Edge)**组成,记为 G = ( V , E ) G = (V, E) G=(V,E),其中 V V V 是节点集合, E E E 是边集合。
每条边连接两个节点,表示它们之间存在某种关系。根据边是否有方向,图可以分为:
- 无向图(Undirected Graph):边没有方向,节点A和B之间的边表示双向关系。如社交网络中的好友关系。
- 有向图(Directed Graph):边有方向,从A指向B的边不一定有从B指向A的边。如Twitter的关注关系。
根据边是否有权重,图可以分为:
- 无权图(Unweighted Graph):边只有0/1两种状态,表示是否连接。
- 有权图(Weighted Graph):每条边有一个权重,表示关系的强度。如交通网络中道路的长度。
图的基本概念
- 邻居(Neighbor):与节点v直接相连的节点集合,记为 N ( v ) N(v) N(v)。
- 度(Degree):节点v的邻居数量,记为 d ( v ) d(v) d(v)。无向图中所有节点的度之和等于边数的2倍。
- 路径(Path):从节点A到节点B的一系列节点,相邻节点之间有边连接。
- 连通图(Connected Graph):任意两个节点之间都存在路径的图。
- 子图(Subgraph):由原图的部分节点和边组成的图。
- 社区(Community/Cluster):内部连接紧密、与外部连接稀疏的节点子集。
图数据的特点
- 不规则性:节点的排列没有固定顺序,每个节点的邻居数量可能不同。
- 置换不变性:节点的编号可以任意置换,图的结构不变。GNN需要对节点编号置换保持不变。
- 关系丰富性:边可以表示各种类型的关系,可以有方向、权重、类型。
- 多尺度性:图可以有局部结构(邻居)、社区结构、全局结构等多个尺度。
13.2 图的表示
邻接矩阵
邻接矩阵(Adjacency Matrix) 是最常用的图表示方法。对于有 N N N 个节点的图,邻接矩阵 A ∈ R N × N A \in \mathbb{R}^{N \times N} A∈RN×N,其中 A i j = 1 A_{ij} = 1 Aij=1 表示节点i和节点j之间有边, A i j = 0 A_{ij} = 0 Aij=0 表示没有边。
无向图的邻接矩阵是对称的( A i j = A j i A_{ij} = A_{ji} Aij=Aji),有向图不一定对称。有权图的邻接矩阵元素是边的权重。
邻接矩阵的优点是简单直观,缺点是空间复杂度为 O ( N 2 ) O(N^2) O(N2),对于稀疏图(大多数真实图都是稀疏的)浪费大量空间。
节点特征矩阵
每个节点通常有自己的特征向量,所有节点的特征组成节点特征矩阵 X ∈ R N × D X \in \mathbb{R}^{N \times D} X∈RN×D,其中 D D D 是特征维度。
节点特征可以是:
- 节点的属性(如用户的年龄、性别、兴趣)
- 节点的结构特征(如度、聚类系数)
- 预训练的节点嵌入(如Node2Vec、DeepWalk)
- 对于没有特征的图,可以用one-hot编码或度向量作为初始特征
边列表
边列表(Edge List) 是另一种常用的图表示方法,直接列出所有边: E = { ( u 1 , v 1 ) , ( u 2 , v 2 ) , … , ( u M , v M ) } E = \{(u_1, v_1), (u_2, v_2), \ldots, (u_M, v_M)\} E={(u1,v1),(u2,v2),…,(uM,vM)},其中 M M M 是边数。
边列表的空间复杂度是 O ( M ) O(M) O(M),对于稀疏图比邻接矩阵高效得多。GNN的实现(如PyG、DGL)通常使用边列表格式。
度矩阵
度矩阵(Degree Matrix) D D D 是一个对角矩阵, D i i = d ( i ) D_{ii} = d(i) Dii=d(i) 是节点i的度。度矩阵在GCN的归一化中非常重要。
13.3 图神经网络、任务和损失函数
图神经网络的核心思想:消息传递
图神经网络的核心思想是消息传递(Message Passing):每个节点从它的邻居节点收集信息(消息),聚合后更新自己的表示。
一层消息传递可以表示为:
h v ( l + 1 ) = UPDATE ( h v ( l ) , AGGREGATE ( { h u ( l ) : u ∈ N ( v ) } ) ) h_v^{(l+1)} = \text{UPDATE}\left(h_v^{(l)}, \text{AGGREGATE}\left(\{h_u^{(l)} : u \in N(v)\}\right)\right) hv(l+1)=UPDATE(hv(l),AGGREGATE({hu(l):u∈N(v)}))
其中:
- h v ( l ) h_v^{(l)} hv(l) 是节点v在第l层的表示
- N ( v ) N(v) N(v) 是节点v的邻居集合
- AGGREGATE函数聚合邻居的信息(如求和、平均、最大值)
- UPDATE函数结合节点自身信息和聚合的邻居信息,更新节点表示
通过堆叠L层消息传递,每个节点最终能融合L跳邻居的信息。例如,2层GCN的每个节点能融合2跳邻居的信息。
图神经网络的任务类型
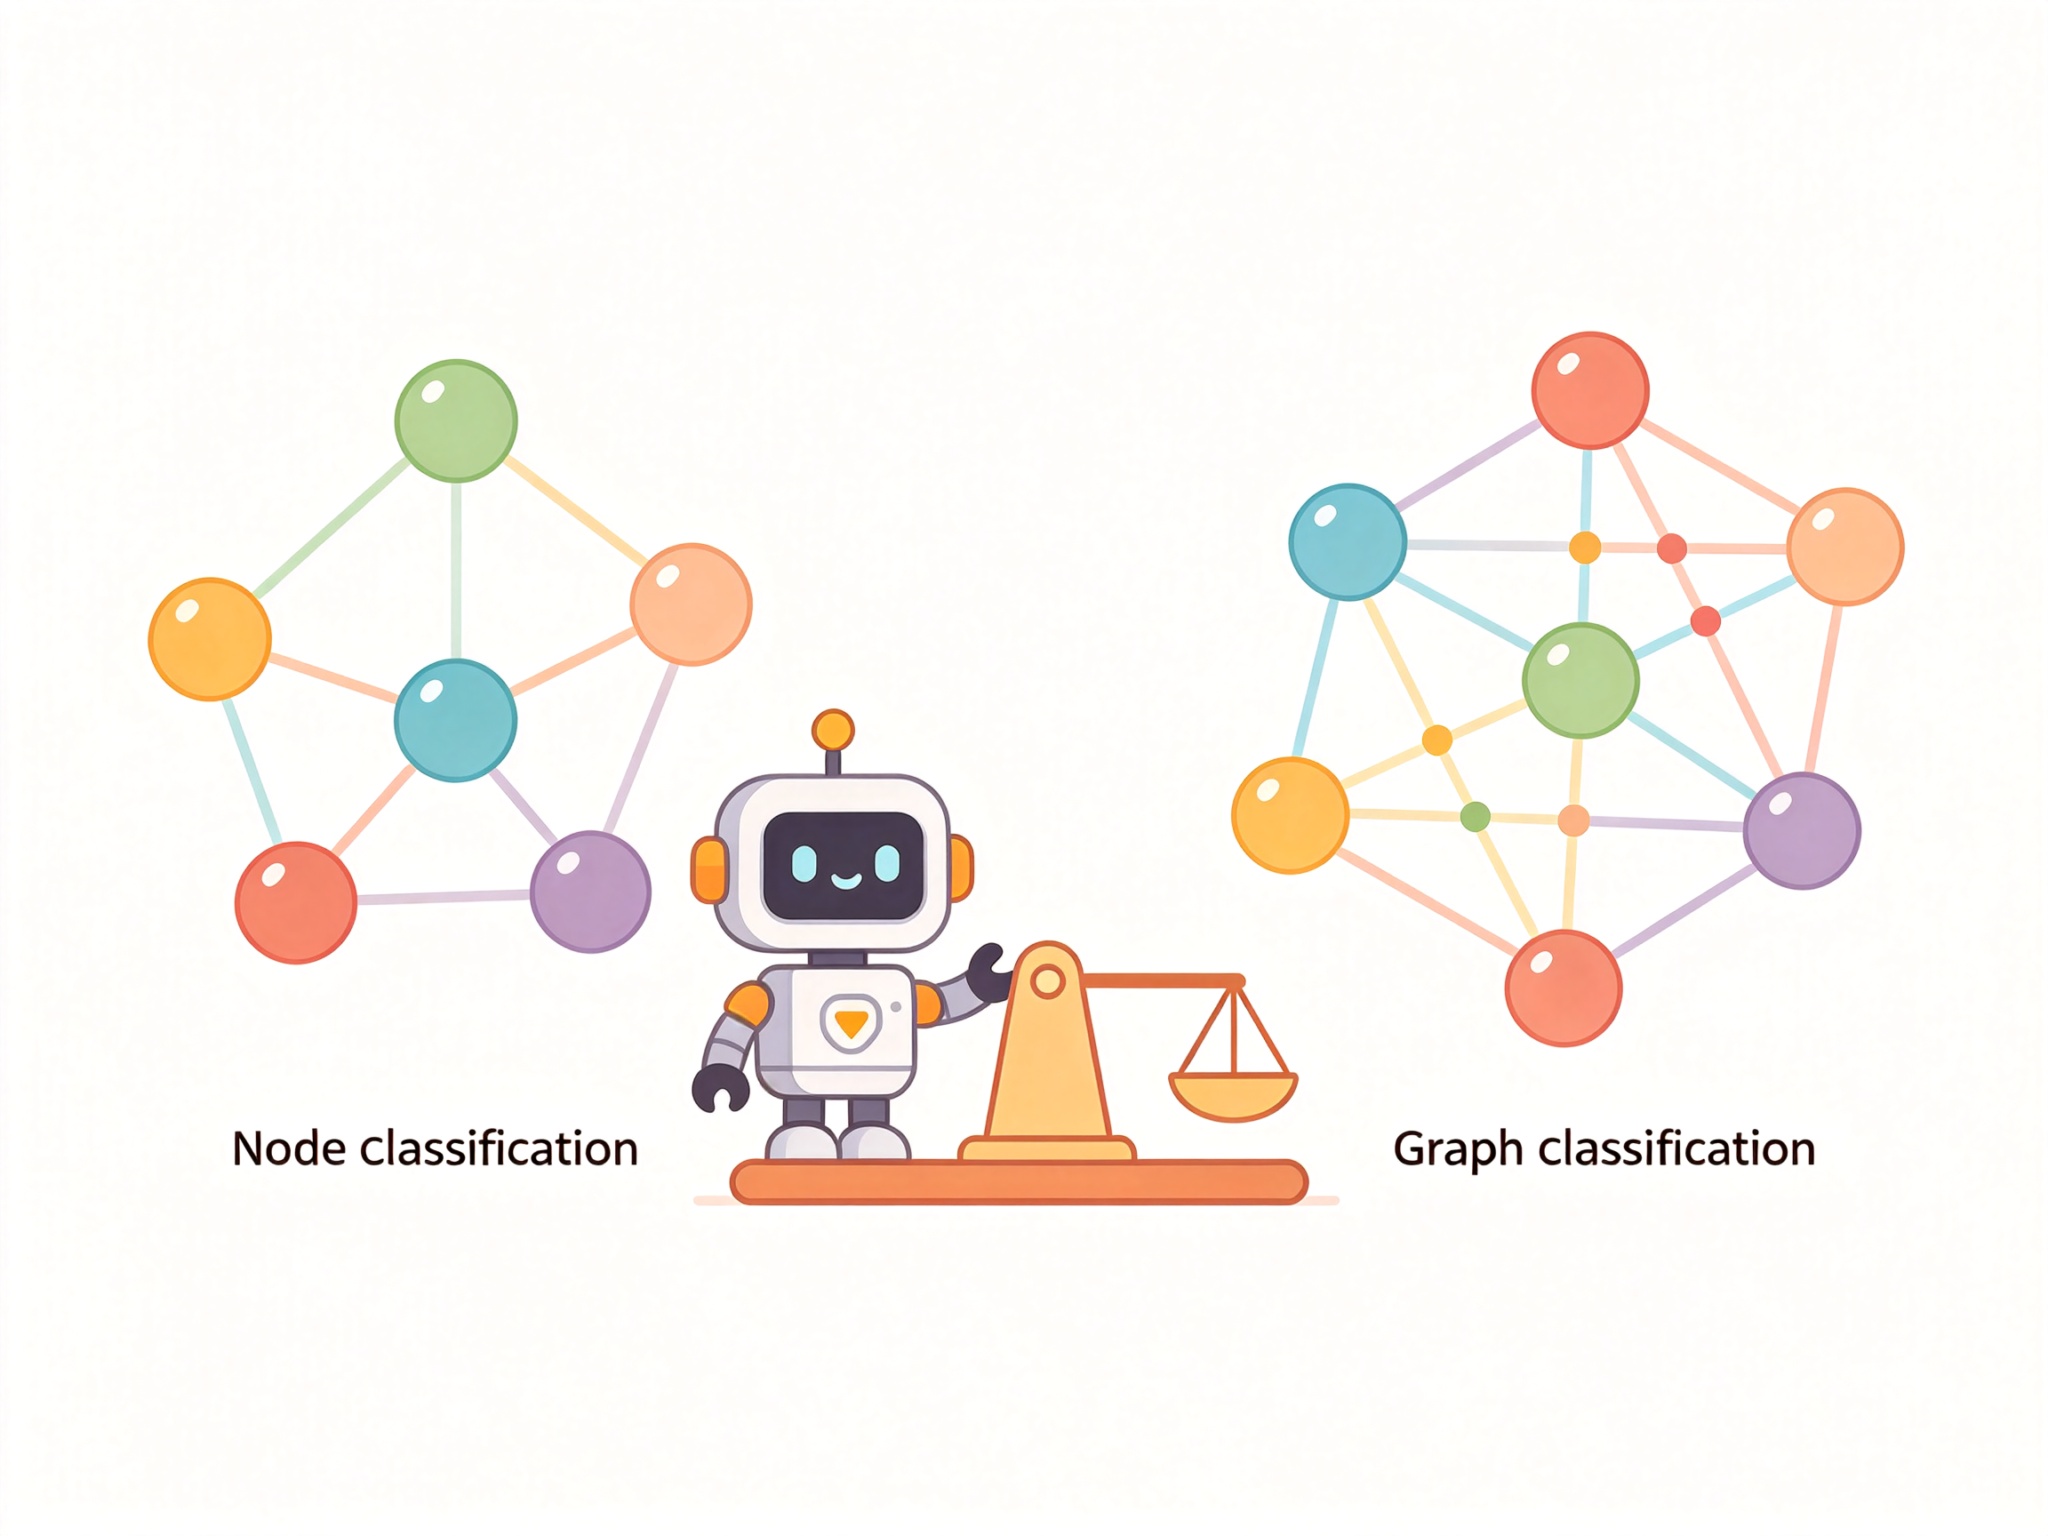
GNN可以处理多种类型的任务:
-
节点分类(Node Classification):预测每个节点的类别。如社交网络中预测用户的兴趣标签,引用网络中预测论文的领域。训练时通常只有部分节点有标签,需要利用图结构进行半监督学习。
-
图分类(Graph Classification):预测整个图的类别。如分子性质预测(预测分子是否有毒)、蛋白质功能预测。需要把所有节点的表示聚合成图的全局表示。
-
链接预测(Link Prediction):预测两个节点之间是否存在边。如社交网络中的好友推荐、知识图谱中的关系补全。
-
图生成(Graph Generation):生成新的图。如分子生成(设计新药物)、社区发现。
损失函数
GNN的损失函数取决于任务类型:
- 节点分类/图分类:交叉熵损失(多分类)或二元交叉熵(二分类)
- 链接预测:二元交叉熵(预测边是否存在)
- 图回归:均方误差(MSE)
- 无监督学习:对比学习损失、重构损失等
13.4 图卷积网络
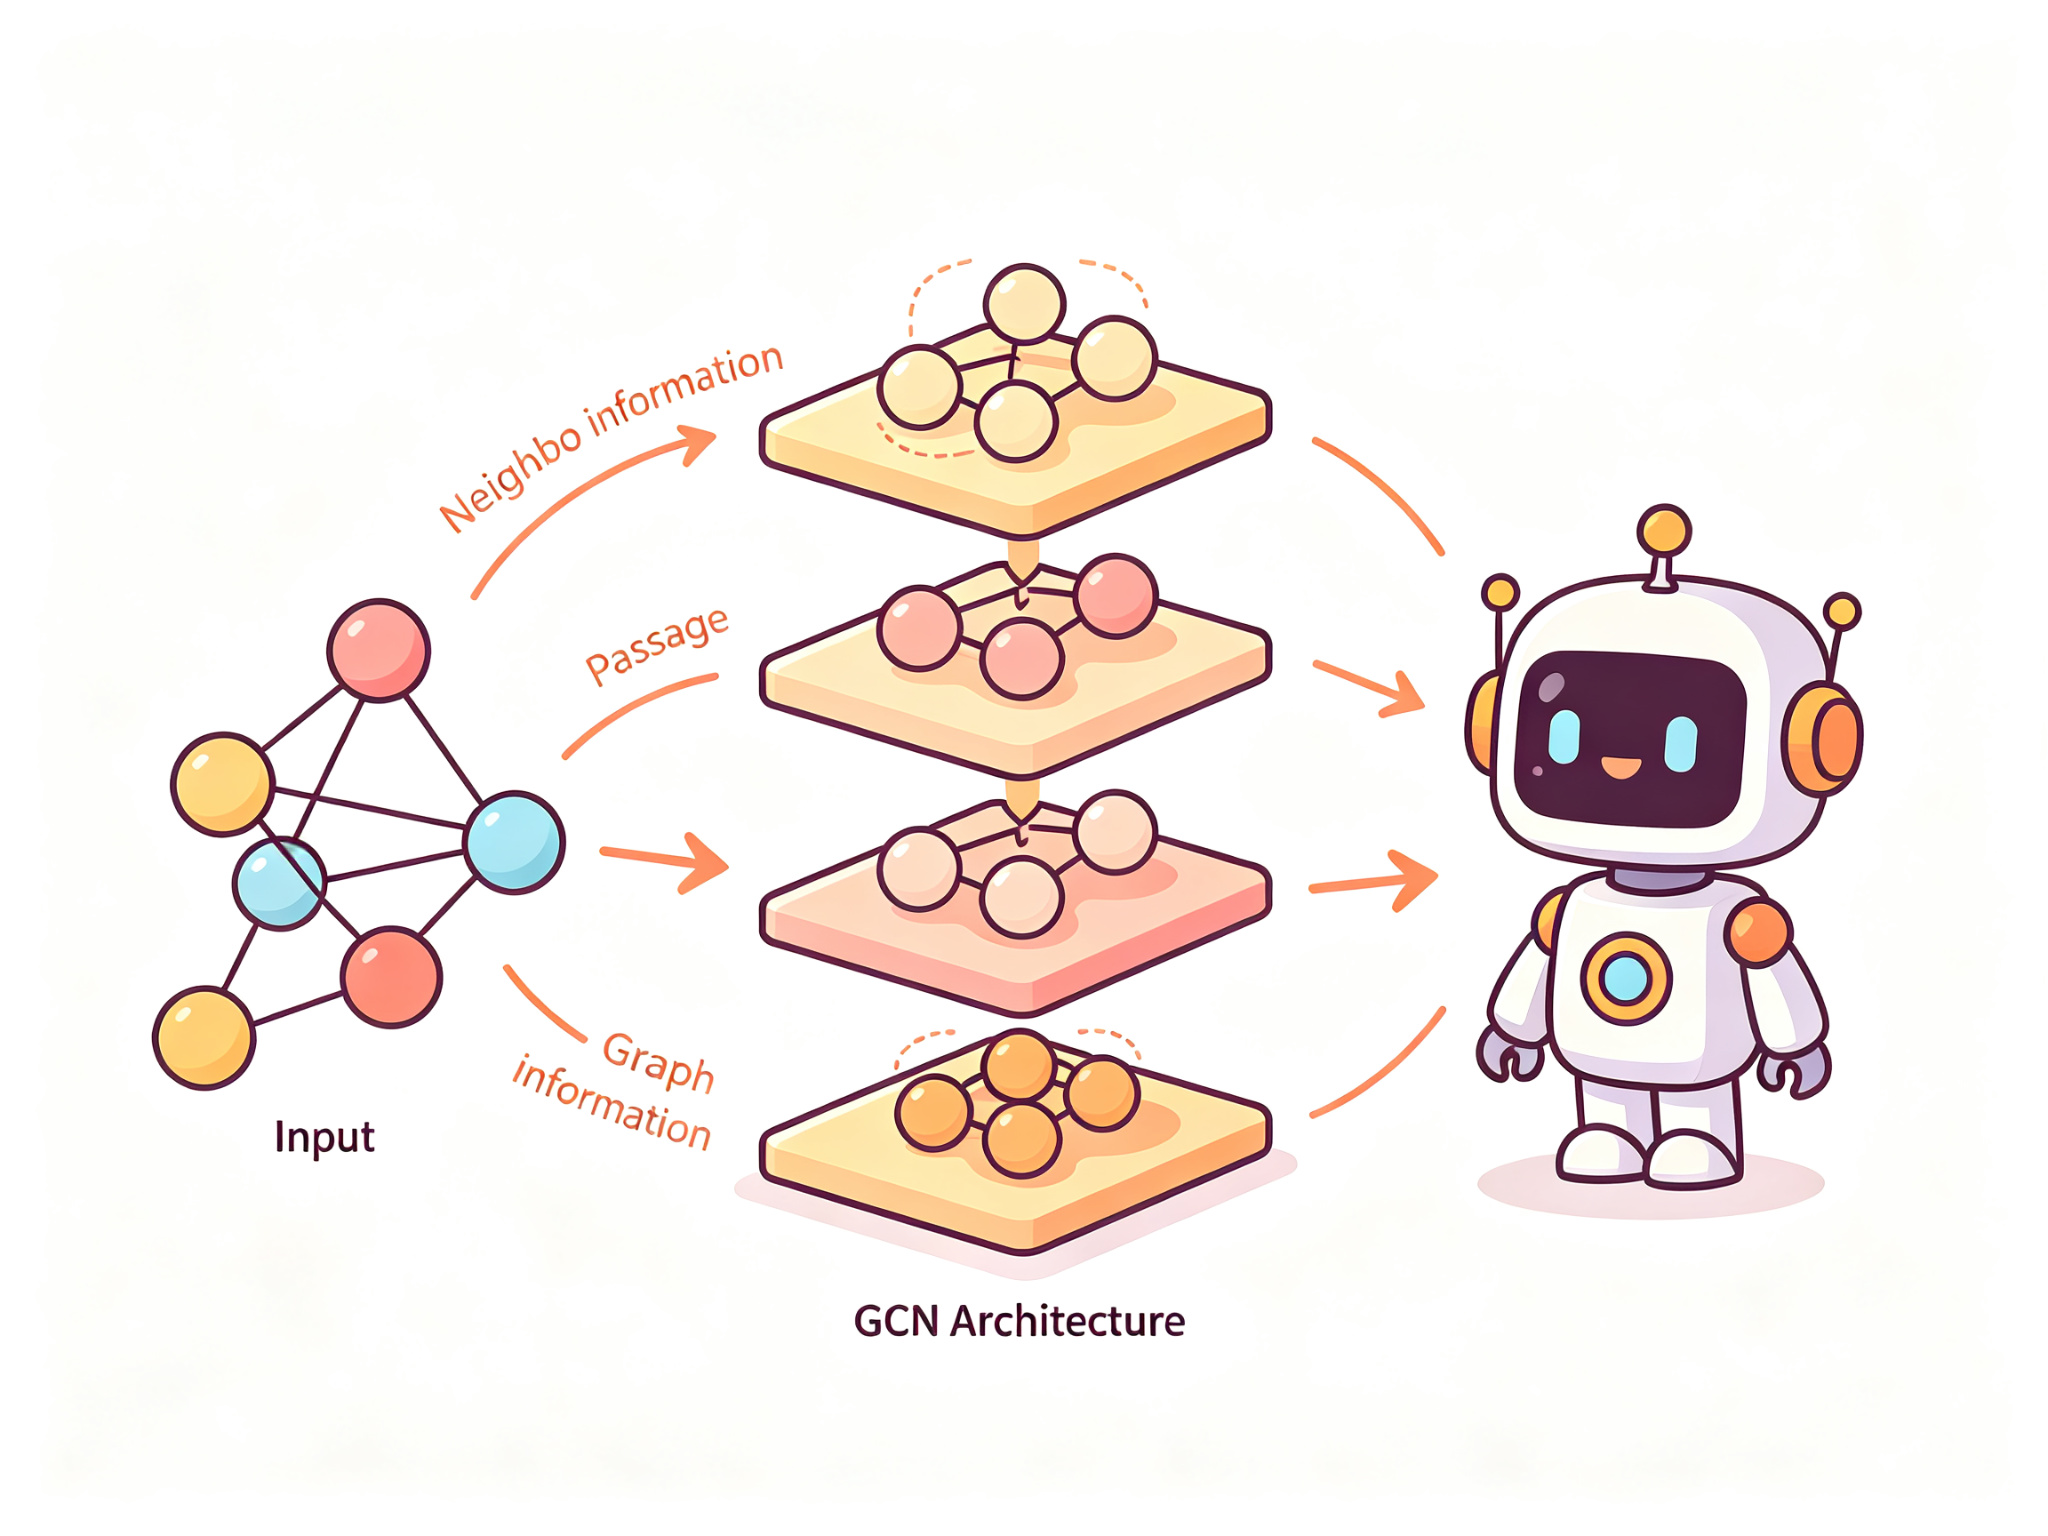
图卷积网络(Graph Convolutional Network,GCN) 是最经典、最常用的GNN架构,由Kipf和Welling在2017年提出。
GCN的传播规则
GCN的一层传播规则非常简洁:
H ( l + 1 ) = σ ( D ~ − 1 / 2 A ~ D ~ − 1 / 2 H ( l ) W ( l ) ) H^{(l+1)} = \sigma\left(\tilde{D}^{-1/2} \tilde{A} \tilde{D}^{-1/2} H^{(l)} W^{(l)}\right) H(l+1)=σ(D~−1/2A~D~−1/2H(l)W(l))
其中:
- H ( l ) H^{(l)} H(l) 是第l层的节点表示矩阵( N × d l N \times d_l N×dl)
- H ( 0 ) = X H^{(0)} = X H(0)=X 是输入节点特征
- A ~ = A + I N \tilde{A} = A + I_N A~=A+IN 是添加了自环的邻接矩阵(让节点也能聚合自己的信息)
- D ~ \tilde{D} D~ 是 A ~ \tilde{A} A~ 的度矩阵, D ~ i i = ∑ j A ~ i j \tilde{D}_{ii} = \sum_j \tilde{A}_{ij} D~ii=∑jA~ij
- D ~ − 1 / 2 A ~ D ~ − 1 / 2 \tilde{D}^{-1/2} \tilde{A} \tilde{D}^{-1/2} D~−1/2A~D~−1/2 是对称归一化的邻接矩阵
- W ( l ) W^{(l)} W(l) 是第l层的可学习权重矩阵( d l × d l + 1 d_l \times d_{l+1} dl×dl+1)
- σ \sigma σ 是激活函数(通常ReLU)
为什么要归一化?
如果直接用 A H W A H W AHW,度大的节点会得到更大的特征值,导致训练不稳定。对称归一化 D ~ − 1 / 2 A ~ D ~ − 1 / 2 \tilde{D}^{-1/2} \tilde{A} \tilde{D}^{-1/2} D~−1/2A~D~−1/2 的作用是:
- 对每个节点的聚合结果按度进行归一化
- 度大的节点和度小的节点的特征值尺度相近
- 类似于CNN中的平均池化,让每个节点聚合邻居的平均信息
具体来说,归一化后的聚合可以理解为:每个节点的新表示是其邻居(包括自己)表示的加权平均,权重由两个端点的度的平方根乘积的倒数决定。
GCN的特点
- 简单高效:传播规则就是矩阵乘法,实现简单,计算高效。
- 局部性:每层只聚合直接邻居的信息,堆叠多层可以融合多跳信息。
- 置换不变性:对节点编号的置换保持不变,符合图数据的特性。
- 半监督学习:可以利用未标注节点的结构信息,适合半监督节点分类。
- 过平滑问题:当层数太多时,所有节点的表示会趋于相同(过平滑),GCN通常只有2-3层。
13.5 示例:图分类
图分类任务需要把整个图的所有节点表示聚合成一个全局表示,然后用这个全局表示进行分类。
图的全局表示
常见的图全局表示聚合方法:
- 全局求和池化(Global Sum Pooling): h G = ∑ v ∈ V h v h_G = \sum_{v \in V} h_v hG=∑v∈Vhv
- 全局平均池化(Global Mean Pooling): h G = 1 ∣ V ∣ ∑ v ∈ V h v h_G = \frac{1}{|V|} \sum_{v \in V} h_v hG=∣V∣1∑v∈Vhv
- 全局最大池化(Global Max Pooling): h G = max v ∈ V h v h_G = \max_{v \in V} h_v hG=maxv∈Vhv
- 注意力池化(Attention Pooling):学习每个节点的重要性权重,加权求和。如Set2Set、Attention Pooling。
- 虚拟节点(Virtual Node):引入一个虚拟节点,和所有节点相连,用虚拟节点的表示作为图的全局表示。
图分类的流程
- 输入图的节点特征 X X X 和邻接矩阵 A A A
- 通过多层GCN得到每个节点的表示 H ( L ) H^{(L)} H(L)
- 用池化函数把所有节点表示聚合成图的全局表示 h G h_G hG
- 用全连接层+softmax得到图的类别预测
- 用交叉熵损失训练
图分类的应用
- 分子性质预测:预测分子的毒性、溶解度、药物活性
- 蛋白质功能预测:预测蛋白质的功能类别
- 社交网络分析:预测社交网络的类型或社区结构
- 程序分析:预测程序的功能或漏洞
13.6 归纳模型与演绎模型
演绎学习(Transductive Learning)
演绎学习(也叫直推学习)是指:在训练时已经见过所有的节点(包括测试节点),只是测试节点没有标签。模型利用所有节点的结构和特征信息,为测试节点预测标签。
GCN的原始论文就是演绎学习的设置:在Cora、Citeseer等数据集上,训练时可以看到所有节点的特征和邻接矩阵,只是只有部分节点有标签。
演绎学习的优点是可以利用未标注节点的信息,缺点是不能泛化到训练时没见过的新节点或新图。
归纳学习(Inductive Learning)
归纳学习是指:训练时只见过训练图(或训练节点),测试时需要泛化到全新的图(或全新的节点)。模型需要学到通用的消息传递规则,可以应用到任意新图。
GraphSAGE是归纳学习的代表性工作,它通过采样邻居和学习聚合函数,可以泛化到新节点。
归纳学习的优点是可以泛化到新图,适合图分类和大规模真实场景;缺点是训练时不能利用测试节点的信息。
对比
| 特性 | 演绎学习 | 归纳学习 |
|---|---|---|
| 训练时是否见过测试节点 | 是 | 否 |
| 能否泛化到新节点/新图 | 否 | 是 |
| 典型模型 | GCN | GraphSAGE、GAT |
| 适用任务 | 半监督节点分类 | 图分类、大规模节点分类 |
13.7 示例:节点分类
节点分类是GNN最经典的任务。训练时只有部分节点有标签,需要利用图结构和未标注节点的信息进行半监督学习。
节点分类的流程
- 输入图的节点特征 X X X 和邻接矩阵 A A A
- 通过多层GCN得到每个节点的表示 H ( L ) H^{(L)} H(L)
- 用全连接层+softmax得到每个节点的类别预测
- 只在有标签的节点上计算交叉熵损失
- 反向传播更新所有层的参数(利用未标注节点的结构信息)
经典数据集
- Cora:2708个节点(论文),5429条边(引用关系),7个类别,每个节点1433维特征(词袋)
- Citeseer:3327个节点,4732条边,6个类别,3703维特征
- Pubmed:19717个节点,44338条边,3个类别,500维特征
- Reddit:23万节点,1100万条边,41个类别(大规模归纳学习基准)
节点分类的关键:半监督学习
GCN的节点分类是半监督的:只有少量节点有标签,但通过图结构,标签信息可以通过消息传递传播到未标注节点。这就是GCN在只有少量标注节点时也能取得很好效果的原因。
13.8 图卷积网络的层
GCN的层数选择
GCN的层数决定了每个节点能融合多少跳邻居的信息。L层GCN可以融合L跳邻居的信息。
但GCN的层数通常很少(2-3层),因为:
- 过平滑问题(Over-smoothing):当层数太多时,所有节点的表示会趋于相同,失去区分度。这是因为每个节点都在聚合邻居的信息,多层之后所有节点的感受野重叠,表示趋同。
- 计算效率:图的规模通常很大,太多层计算量太大。
解决过平滑的方法:
- 残差连接:在GCN层之间加入残差连接,类似ResNet
- 跳跃知识网络(JK-Net):把每一层的节点表示拼接或池化,让模型自己选择用多少层的信息
- DropEdge:训练时随机删除一些边,减少过平滑
- PairNorm:对节点表示进行归一化,防止趋同
GCN层的变体
- GAT(Graph Attention Network):用注意力机制学习每个邻居的重要性权重,而不是简单的度归一化。可以处理不同邻居的不同重要性。
- GraphSAGE:通过采样邻居和学习聚合函数(均值、LSTM、池化),实现归纳学习。
- GIN(Graph Isomorphism Network):证明了GNN的表达能力上限,提出用求和聚合+MLP可以达到最大表达能力。
- APPNP:利用个性化PageRank的思想,让每个节点可以聚合多跳邻居的信息,同时避免过平滑。
- ChebNet:基于切比雪夫多项式的谱图卷积,GCN是它的一阶近似。
13.9 边图
除了节点分类和图分类,GNN还可以处理边级别的任务,如链接预测、边分类。
边的表示
要预测边的性质,首先需要得到边的表示。常见的边表示方法:
- 拼接: h ( u , v ) = [ h u ∥ h v ] h_{(u,v)} = [h_u \parallel h_v] h(u,v)=[hu∥hv],把两个端点的表示拼接起来。
- 逐元素乘积: h ( u , v ) = h u ⊙ h v h_{(u,v)} = h_u \odot h_v h(u,v)=hu⊙hv。
- 逐元素求和: h ( u , v ) = h u + h v h_{(u,v)} = h_u + h_v h(u,v)=hu+hv。
- 绝对值差: h ( u , v ) = ∣ h u − h v ∣ h_{(u,v)} = |h_u - h_v| h(u,v)=∣hu−hv∣。
- 组合: h ( u , v ) = [ h u ∥ h v ∥ h u ⊙ h v ∥ ∣ h u − h v ∣ ] h_{(u,v)} = [h_u \parallel h_v \parallel h_u \odot h_v \parallel |h_u - h_v|] h(u,v)=[hu∥hv∥hu⊙hv∥∣hu−hv∣]。
链接预测
链接预测的目标是预测两个节点之间是否存在边。训练时,把已知的边作为正样本,随机采样一些不存在的边作为负样本,用边的表示进行二分类。
链接预测的应用:
- 社交网络好友推荐
- 知识图谱关系补全
- 推荐系统(用户-物品交互预测)
- 蛋白质相互作用预测
边分类
边分类的目标是预测边的类型或性质。如知识图谱中预测关系的类型,交通网络中预测道路的拥堵等级。
13.10 本章小结
本章我们系统学习了图神经网络。核心要点如下:
-
图数据由节点和边组成,具有不规则性和置换不变性:CNN和Transformer不适合直接处理图数据,需要专门的GNN架构。
-
消息传递是GNN的核心思想:每个节点从邻居收集信息、聚合后更新自己的表示。一层消息传递融合1跳邻居,L层融合L跳邻居。
-
GCN是最经典的GNN架构:传播规则 H ( l + 1 ) = σ ( D ~ − 1 / 2 A ~ D ~ − 1 / 2 H ( l ) W ( l ) ) H^{(l+1)} = \sigma(\tilde{D}^{-1/2}\tilde{A}\tilde{D}^{-1/2}H^{(l)}W^{(l)}) H(l+1)=σ(D~−1/2A~D~−1/2H(l)W(l)),对称归一化解决度大节点特征值过大的问题。
-
GNN的任务类型:节点分类(半监督)、图分类(需要全局池化)、链接预测(边表示)、图生成。
-
演绎学习vs归纳学习:演绎学习训练时见过所有节点(包括测试节点),不能泛化到新图;归纳学习可以泛化到新图,适合图分类和大规模场景。
-
过平滑是深层GNN的核心问题:层数太多时所有节点表示趋同。GCN通常只有2-3层。解决方法包括残差连接、JK-Net、DropEdge等。
-
GCN的变体丰富:GAT(注意力)、GraphSAGE(归纳学习)、GIN(最大表达能力)、APPNP(多跳聚合)等。
-
边级别任务:链接预测和边分类需要先构造边的表示(拼接、乘积、差等),再进行预测。
代码实验结果
我们编写了完整的Python代码,从零实现了图卷积网络(GCN),并在一个10节点的两社区图上进行节点分类。以下是真实运行结果。
实验1:构建简单图数据集
- 节点数:10,特征维度:4,类别数:2
- 结构:两个社区(节点0-4和节点5-9),社区内部密集连接,社区间2条桥接边
- 边数:16
节点数: 10
特征维度: 4
类别数: 2
边数: 16
实验2:从零实现GCN层
- 对称归一化邻接矩阵:添加自环 + D − 1 / 2 A ~ D − 1 / 2 D^{-1/2} \tilde{A} D^{-1/2} D−1/2A~D−1/2
- 两层GCN:第一层4→8(ReLU),第二层8→2(无激活)
- 输出形状:(10, 2)
第一层GCN输出形状: (10, 8)
第二层GCN输出形状: (10, 2)
实验3:训练GCN进行节点分类
- 优化器:梯度下降,学习率0.01
- 训练轮次:200轮
- 全部10个节点有标签(全监督设置)
Epoch 50:  损失=0.3335, 准确率=1.0000
Epoch 100: 损失=0.2243, 准确率=1.0000
Epoch 150: 损失=0.1681, 准确率=1.0000
Epoch 200: 损失=0.1346, 准确率=1.0000

最终准确率: 1.0000
预测标签: [0 0 0 0 0 1 1 1 1 1]
真实标签: [0 0 0 0 0 1 1 1 1 1]
结果可视化
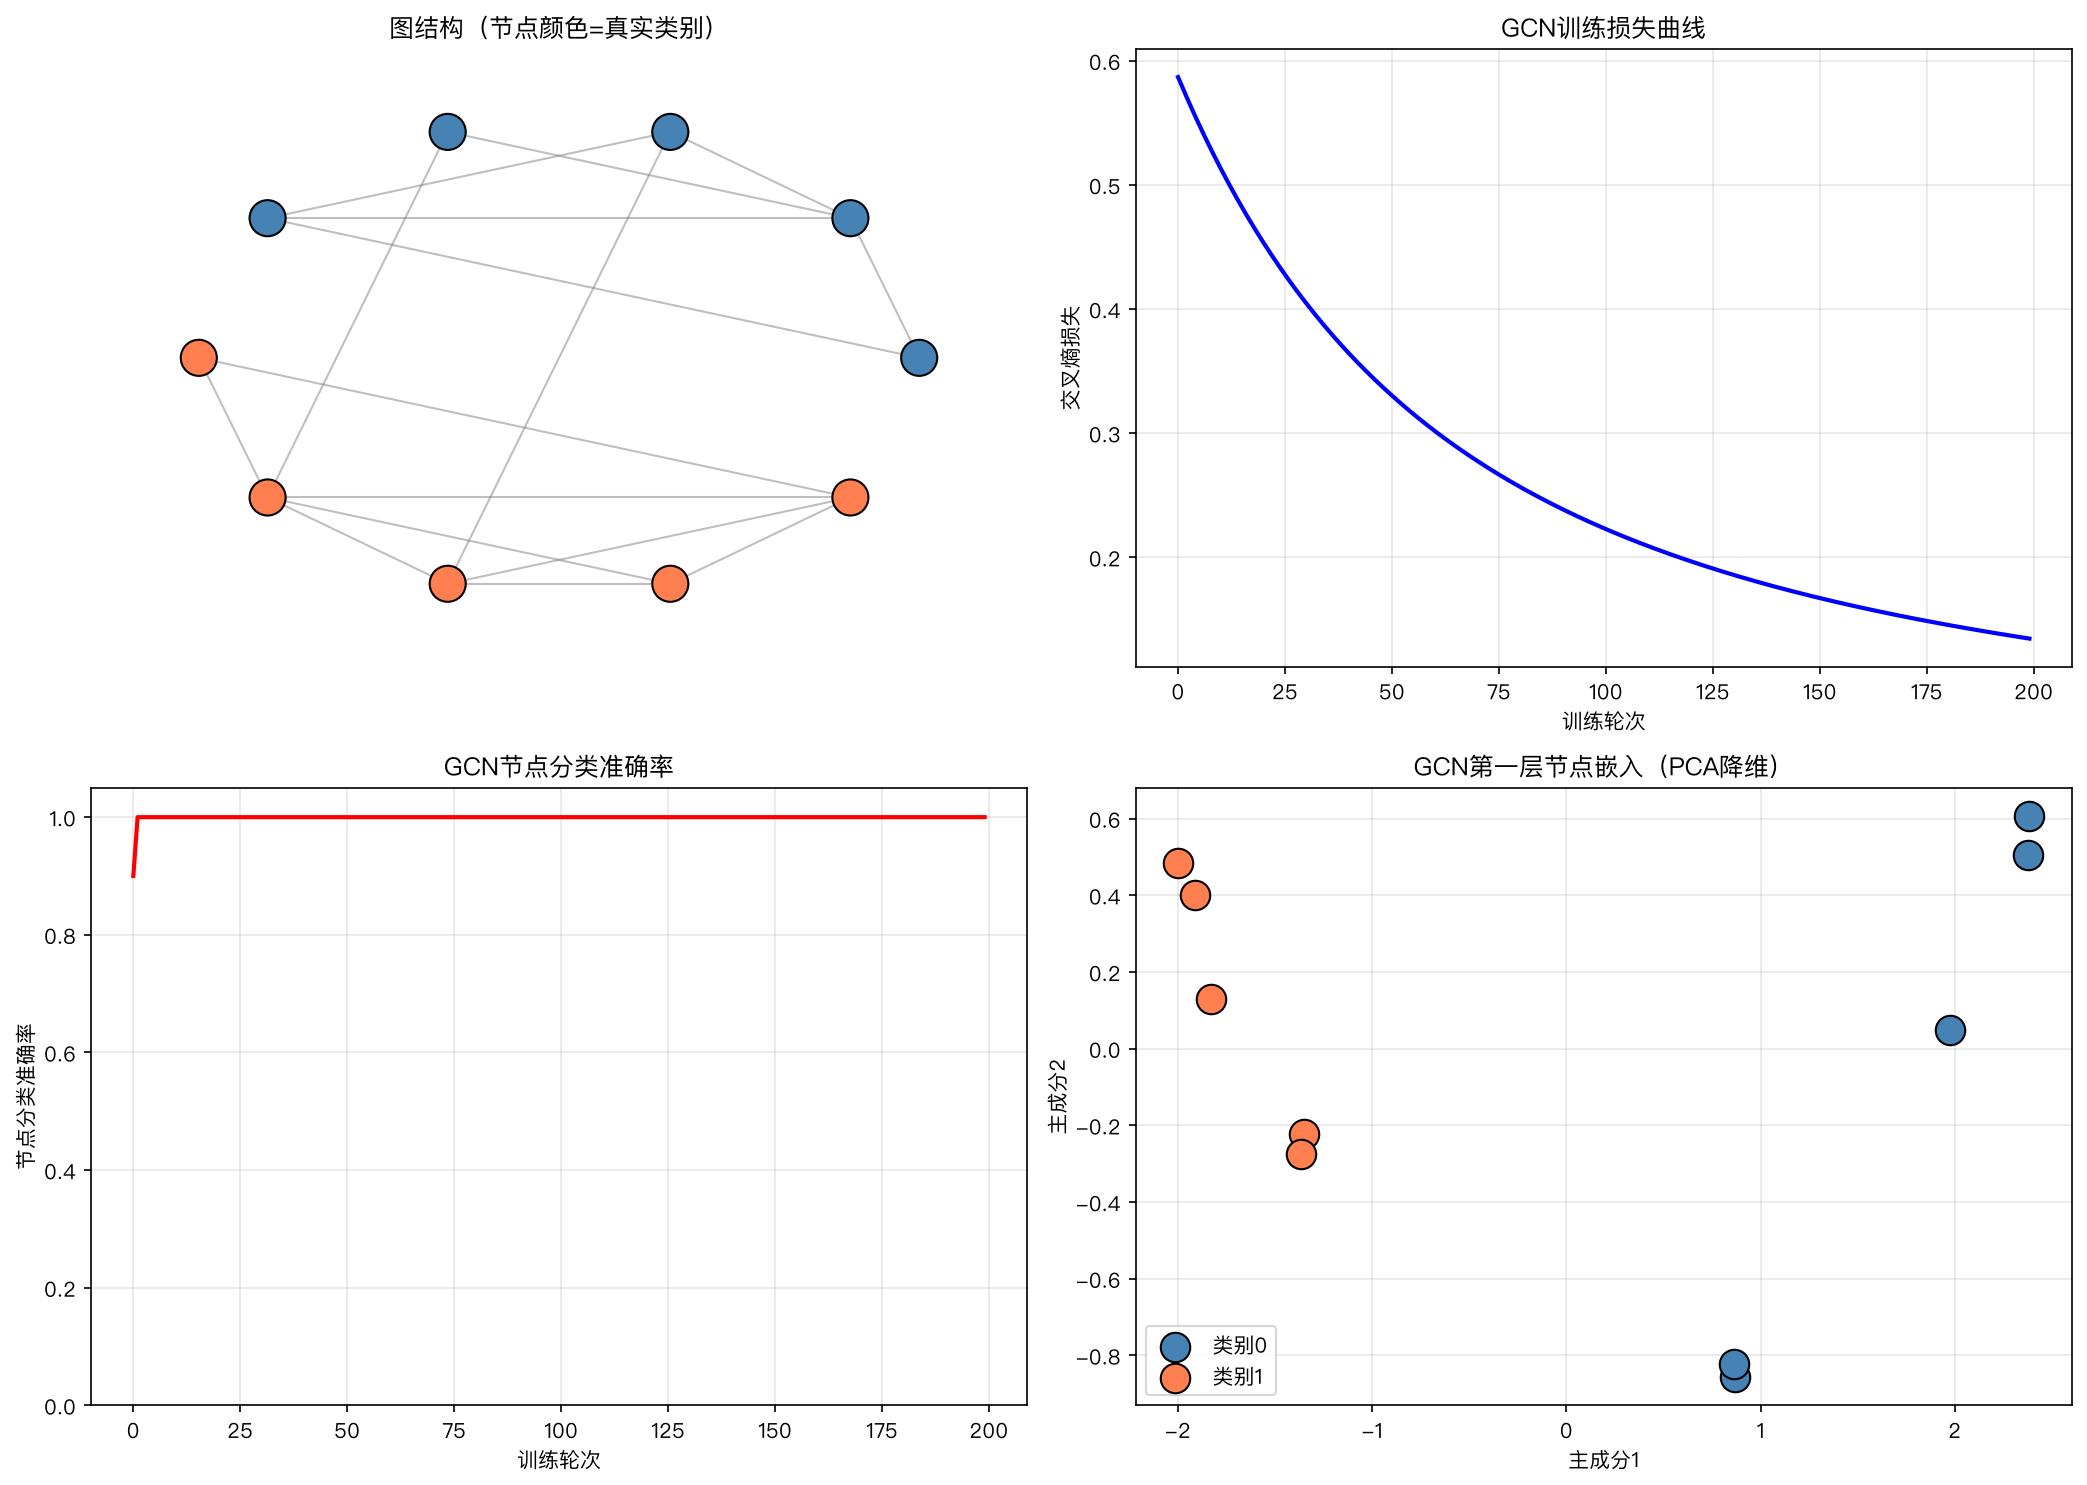
结果分析
-
GCN从零实现验证通过:对称归一化邻接矩阵(添加自环)正确计算,两层GCN的前向传播维度正确(10×4→10×8→10×2)。所有矩阵乘法完全符合GCN传播规则 H ( l + 1 ) = σ ( D ~ − 1 / 2 A ~ D ~ − 1 / 2 H ( l ) W ( l ) ) H^{(l+1)} = \sigma(\tilde{D}^{-1/2}\tilde{A}\tilde{D}^{-1/2}H^{(l)}W^{(l)}) H(l+1)=σ(D~−1/2A~D~−1/2H(l)W(l))。
-
节点分类100%准确率:GCN在50轮内就达到了100%的节点分类准确率,200轮后损失降到0.1346。预测标签和真实标签完全一致。这验证了GCN可以有效利用图结构信息进行节点分类。
-
图结构的关键作用:两个社区的节点特征虽然有差异(社区1特征偏[1,1,0,0],社区2偏[0,0,1,1]),但GCN通过消息传递聚合邻居信息,让同一社区的节点表示更加相似,不同社区的节点表示更加分离。从节点嵌入PCA可视化可以看到,两个社区的节点在嵌入空间中完全分离。
-
对称归一化的效果:归一化邻接矩阵中,度大的节点(如节点1度为4)和度小的节点(如节点0度为3)的聚合权重被归一化到相近尺度,避免了度大节点主导聚合。这保证了训练的稳定性。
-
过平滑在浅层不明显:本实验只用了2层GCN,每个节点融合2跳邻居信息,没有出现过平滑问题。如果增加到5-10层,可能会出现所有节点表示趋同的过平滑现象。
-
半监督潜力:本实验用了全部10个节点的标签(全监督),但GCN的优势在于半监督——即使只有少数节点有标签,通过消息传递标签信息可以传播到未标注节点。在Cora等真实数据集上,GCN只用每类20个标注节点就能达到80%+的准确率。
本章核心总结
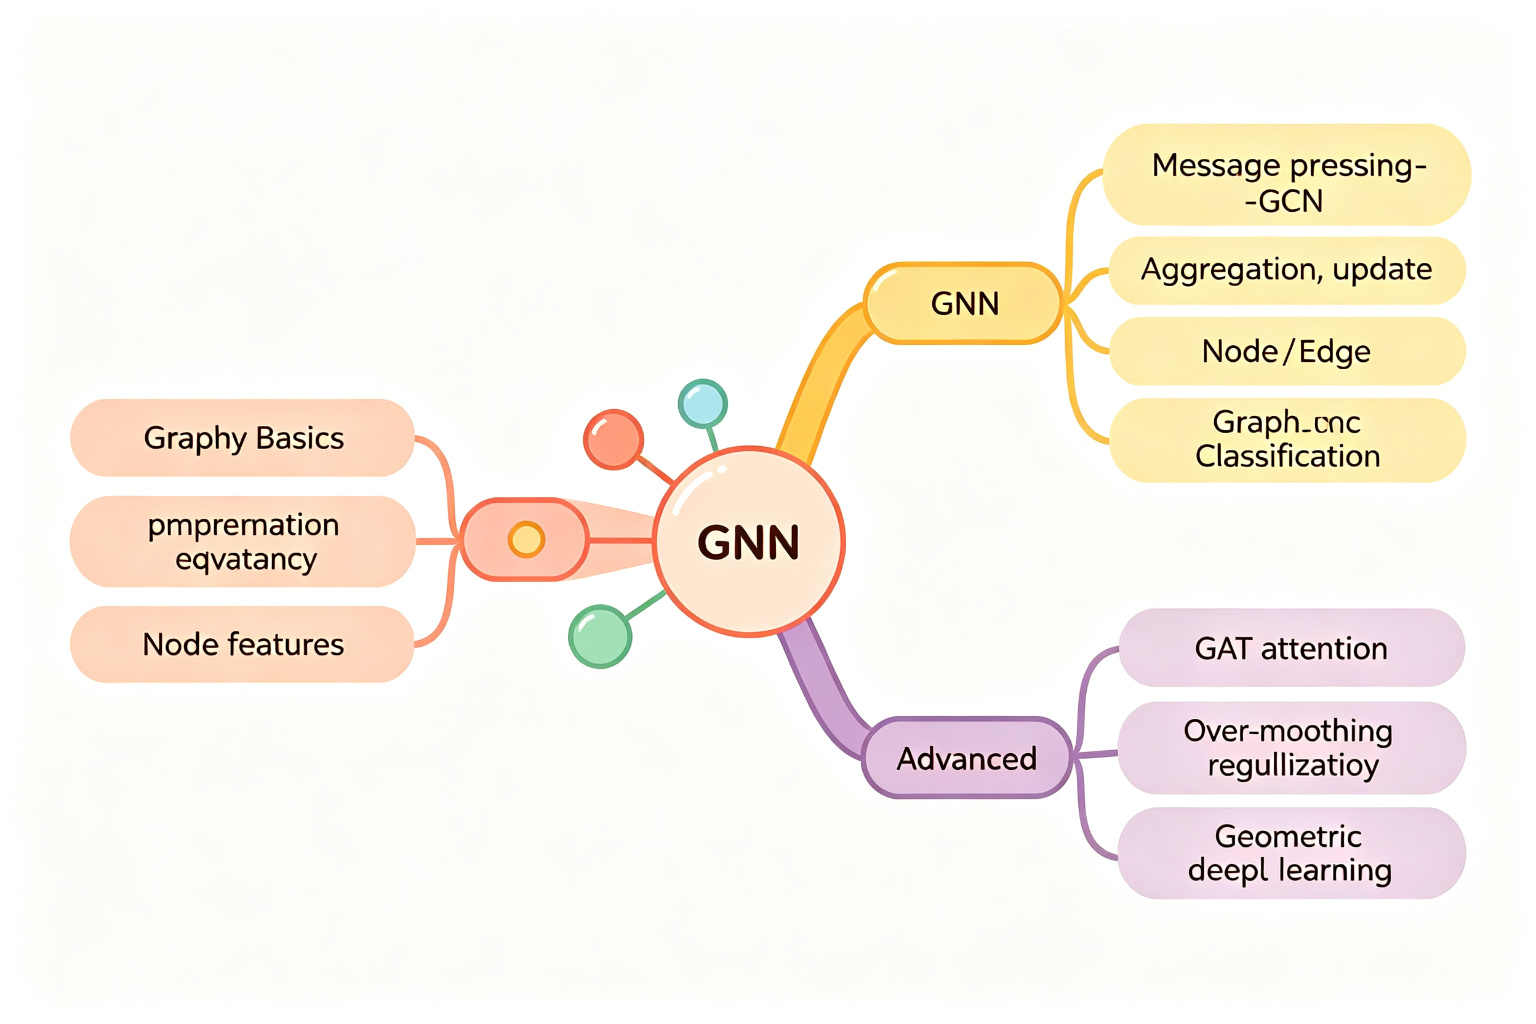
一句话概括:图神经网络通过消息传递机制让每个节点聚合邻居信息来更新表示,GCN用对称归一化邻接矩阵实现高效的图卷积,在节点分类、图分类、链接预测等任务上有广泛应用。
GNN核心公式清单:
| 概念 | 公式 |
|---|---|
| 消息传递 | h v ( l + 1 ) = UPDATE ( h v ( l ) , AGGREGATE ( { h u ( l ) : u ∈ N ( v ) } ) ) h_v^{(l+1)} = \text{UPDATE}(h_v^{(l)}, \text{AGGREGATE}(\{h_u^{(l)}: u \in N(v)\})) hv(l+1)=UPDATE(hv(l),AGGREGATE({hu(l):u∈N(v)})) |
| GCN传播 | H ( l + 1 ) = σ ( D ~ − 1 / 2 A ~ D ~ − 1 / 2 H ( l ) W ( l ) ) H^{(l+1)} = \sigma(\tilde{D}^{-1/2}\tilde{A}\tilde{D}^{-1/2}H^{(l)}W^{(l)}) H(l+1)=σ(D~−1/2A~D~−1/2H(l)W(l)) |
| 自环邻接 | A ~ = A + I N \tilde{A} = A + I_N A~=A+IN |
| 图全局表示 | h G = POOL ( { h v : v ∈ V } ) h_G = \text{POOL}(\{h_v: v \in V\}) hG=POOL({hv:v∈V}) |
| 边表示 | h ( u , v ) = [ h u ∥ h v ] h_{(u,v)} = [h_u \parallel h_v] h(u,v)=[hu∥hv] |
结语
本章我们彻底搞懂了图神经网络。从图的基本概念和表示方法,到消息传递的核心思想,再到GCN的具体传播规则,然后学习了节点分类、图分类、链接预测等任务,讨论了归纳与演绎学习、过平滑问题、GCN变体等。GNN是处理图结构数据的强大工具,在社交网络、药物发现、推荐系统等领域有广泛应用。
到目前为止,我们已经学习了监督学习的各种网络架构:全连接网络、卷积网络、残差网络、变换器、图神经网络。这些都是在有标注数据上训练的判别模型。但现实世界中大量数据是没有标注的,怎么从无标注数据中学习?接下来的章节将进入无监督学习领域。下一章的主题是无监督学习概述——我们将学习无监督学习的分类、什么是好的生成模型、以及如何量化评估生成模型的性能。
下一章见!
更多推荐

 3
 0
- 0


 已为社区贡献43条内容

所有评论(0)