
《理解深度学习》第12章 变换器 读书笔记
《理解深度学习》第12章 变换器 读书笔记
目录
- 12.1 处理文本数据
- 12.2 点积自注意力
- 12.3 点积自注意力的扩展
- 12.4 变换器
- 12.5 自然语言处理中的变换器
- 12.6 编码器模型示例:BERT
- 12.7 解码器模型示例:GPT-3
- 12.8 编码器-解码器模型示例:机器翻译
- 12.9 用于长序列的变换器
- 12.10 图像的变换器
- 12.11 本章小结
- 代码实验结果
- 本章核心总结
- 结语
开篇导语
前面我们学习了全连接网络、卷积网络、残差网络——这些都是处理结构化数据(如图像)的强大工具。但还有一类非常重要的数据:文本和序列数据。处理序列数据的传统方法是RNN(循环神经网络)和LSTM,但它们有一个致命缺陷:必须按顺序逐个处理token,无法并行计算,而且长距离依赖容易丢失。
2017年,Google Brain团队提出了变换器(Transformer),一种完全基于注意力机制的序列建模架构,彻底抛弃了循环结构。Transformer的核心创新是自注意力机制(Self-Attention)——让序列中的每个token都能直接关注到所有其他token,一步到位建立长距离依赖,而且可以完全并行计算。Transformer不仅在自然语言处理领域取得了革命性成功(BERT、GPT系列都是基于Transformer),还扩展到了计算机视觉(ViT)、语音处理、蛋白质结构预测等几乎所有领域,成为了当今AI的基石架构。
本章我们将系统学习变换器。首先了解文本数据的处理方式,然后深入学习自注意力机制的原理和扩展,接着看Transformer的完整架构,最后学习BERT、GPT等著名模型和Transformer在其他领域的应用。
12.1 处理文本数据
文本的数字化表示
神经网络只能处理数值数据,所以首先需要把文本转换成数字。这个过程分为两步:
- 分词(Tokenization):把文本切分成最小的语义单元(token)。可以是单词、子词(subword)或字符。现代Transformer通常使用子词分词(如BPE、WordPiece、SentencePiece),既能覆盖常见词,又能处理生僻词。
- 词嵌入(Word Embedding):把每个token映射成一个固定维度的向量。词嵌入可以是预训练好的(如Word2Vec、GloVe),也可以是和模型一起训练的。Transformer通常使用可学习的词嵌入。
经过这两步,一段文本就变成了一个矩阵 X ∈ R T × D X \in \mathbb{R}^{T \times D} X∈RT×D,其中 T T T 是序列长度(token数量), D D D 是嵌入维度。
位置编码
自注意力机制本身是置换不变的——它只看token之间的关系,不关心token的顺序。如果把句子中的词打乱,自注意力的输出(经过置换后)是一样的。但文本的顺序非常重要!"猫追老鼠"和"老鼠追猫"意思完全不同。
为了让模型感知顺序,Transformer引入了位置编码(Positional Encoding):给每个位置添加一个独特的位置向量,和词嵌入相加。原始Transformer使用正弦位置编码:
P E ( p o s , 2 i ) = sin ( p o s 10000 2 i / D ) , P E ( p o s , 2 i + 1 ) = cos ( p o s 10000 2 i / D ) PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/D}}\right), \quad PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/D}}\right) PE(pos,2i)=sin(100002i/Dpos),PE(pos,2i+1)=cos(100002i/Dpos)
其中 p o s pos pos 是位置, i i i 是维度索引, D D D 是嵌入维度。这种编码的好处是:对于任意固定偏移 k k k, P E p o s + k PE_{pos+k} PEpos+k 可以表示为 P E p o s PE_{pos} PEpos 的线性函数,让模型容易学习相对位置关系。
现代Transformer也常使用可学习的位置编码(直接为每个位置学习一个向量)或相对位置编码(RoPE等)。
12.2 点积自注意力
Q、K、V的概念
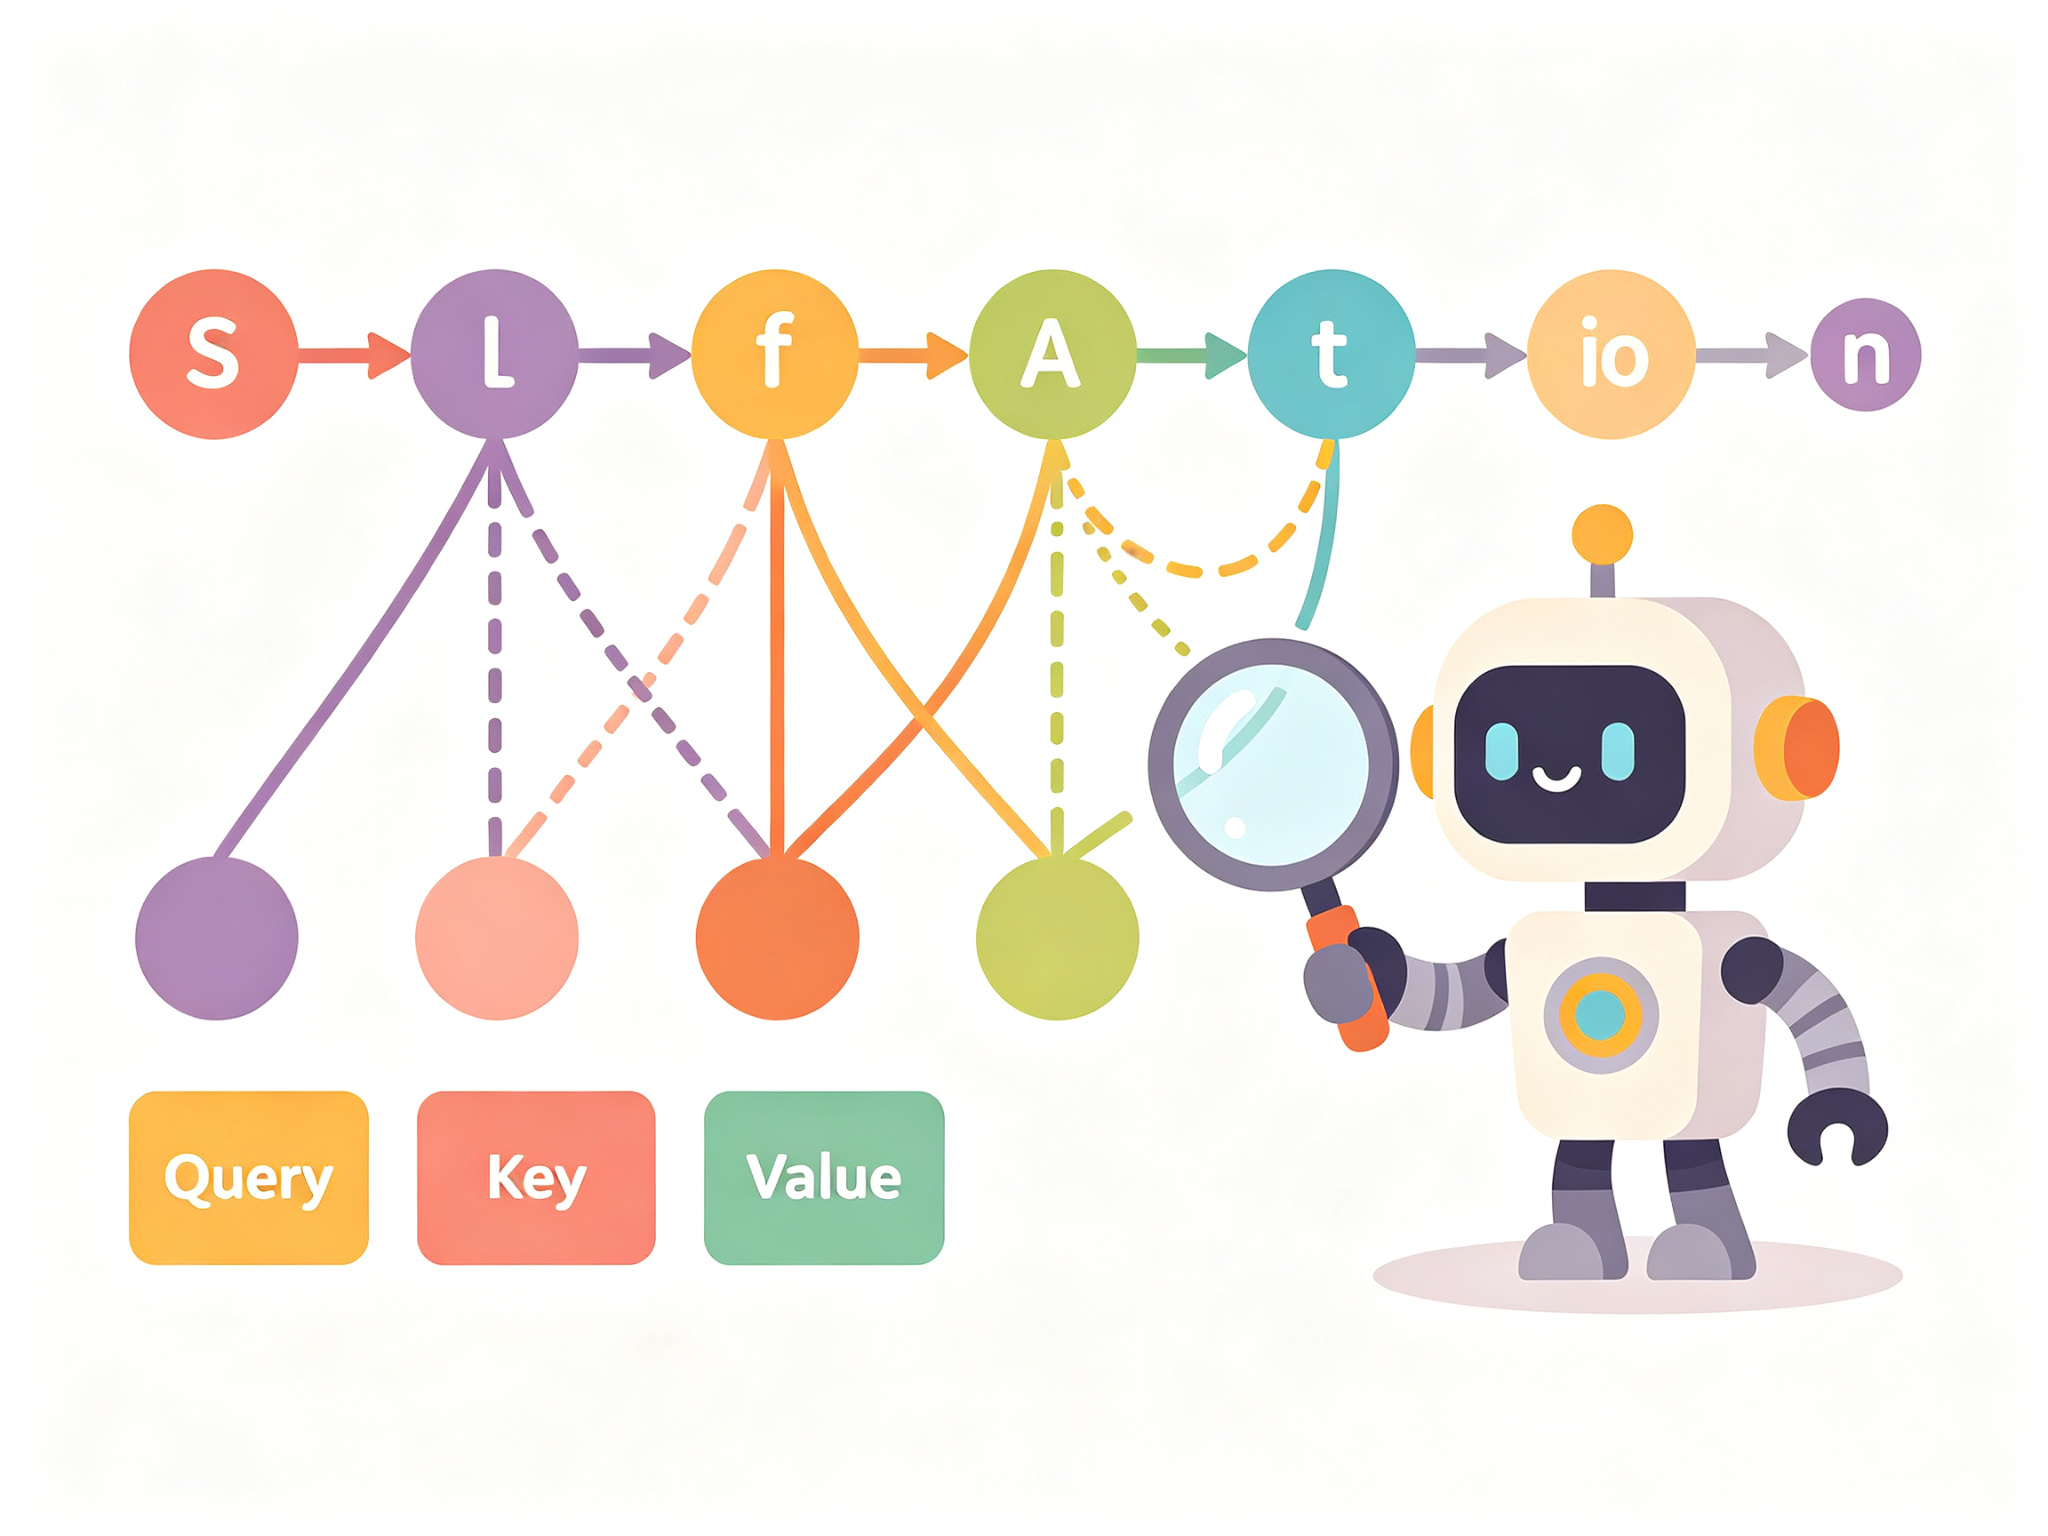
自注意力机制的核心思想是:序列中的每个token通过关注其他token来更新自己的表示。为了实现这一点,每个token被投影成三个向量:
- Query(查询,Q):当前token"想要找什么"
- Key(键,K):当前token"能提供什么"
- Value(值,V):当前token的实际内容
这三个概念来自信息检索系统:Query是搜索词,Key是文档的标签,Value是文档内容。计算Query和所有Key的相似度,得到注意力权重,然后用这些权重对所有Value加权求和,得到输出。
缩放点积注意力
Transformer使用缩放点积注意力(Scaled Dot-Product Attention):
Attention ( Q , K , V ) = softmax ( Q K T d k ) V \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V Attention(Q,K,V)=softmax(dkQKT)V
计算步骤:
- 计算注意力分数: Q K T QK^T QKT(每个Query和所有Key的点积)
- 缩放:除以 d k \sqrt{d_k} dk(防止点积过大导致softmax梯度消失)
- softmax:得到注意力权重(每行和为1)
- 加权求和:用注意力权重对V加权求和,得到输出
其中 d k d_k dk 是Q和K的维度。缩放因子 d k \sqrt{d_k} dk 非常重要:当 d k d_k dk 很大时,点积的方差也很大,softmax会进入梯度很小的区域(饱和区),除以 d k \sqrt{d_k} dk 可以把点积的方差归一化到1。
自注意力的并行性
自注意力的一个巨大优势是完全并行:所有位置的Q、K、V可以同时计算,所有位置的注意力分数可以同时计算。这和RNN必须按顺序逐个处理形成鲜明对比,使得Transformer可以充分利用GPU的并行计算能力,训练速度大大提升。
12.3 点积自注意力的扩展
多头注意力
多头注意力(Multi-Head Attention) 是Transformer的另一个核心设计。与其只做一次注意力,不如做多次(h次),每次使用不同的Q、K、V投影矩阵,然后把所有头的输出拼接起来,再做一次线性投影:
MultiHead ( Q , K , V ) = Concat ( head 1 , … , head h ) W O \text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \ldots, \text{head}_h) W^O MultiHead(Q,K,V)=Concat(head1,…,headh)WO
head i = Attention ( Q W i Q , K W i K , V W i V ) \text{head}_i = \text{Attention}(QW_i^Q, KW_i^K, VW_i^V) headi=Attention(QWiQ,KWiK,VWiV)
多头注意力的好处是:不同的头可以学习不同类型的注意力模式。例如,一个头可能关注语法关系(主语-动词),另一个头可能关注语义关系(指代),还有的头可能关注局部相邻关系。多头让模型有更大的表达能力。
掩码注意力
在解码器中,需要防止当前位置看到未来的信息(因为生成文本是从左到右的,生成第t个词时不能看到第t+1个及以后的词)。这通过**因果掩码(Causal Mask)**实现:在注意力分数中,把未来位置的分数设为 − ∞ -\infty −∞,这样softmax后这些位置的权重为0。
交叉注意力
在编码器-解码器架构中(如机器翻译),解码器不仅有自注意力,还有交叉注意力(Cross-Attention):Query来自解码器,Key和Value来自编码器的输出。这样解码器可以关注源语言句子的所有位置,实现翻译。
12.4 变换器
整体架构
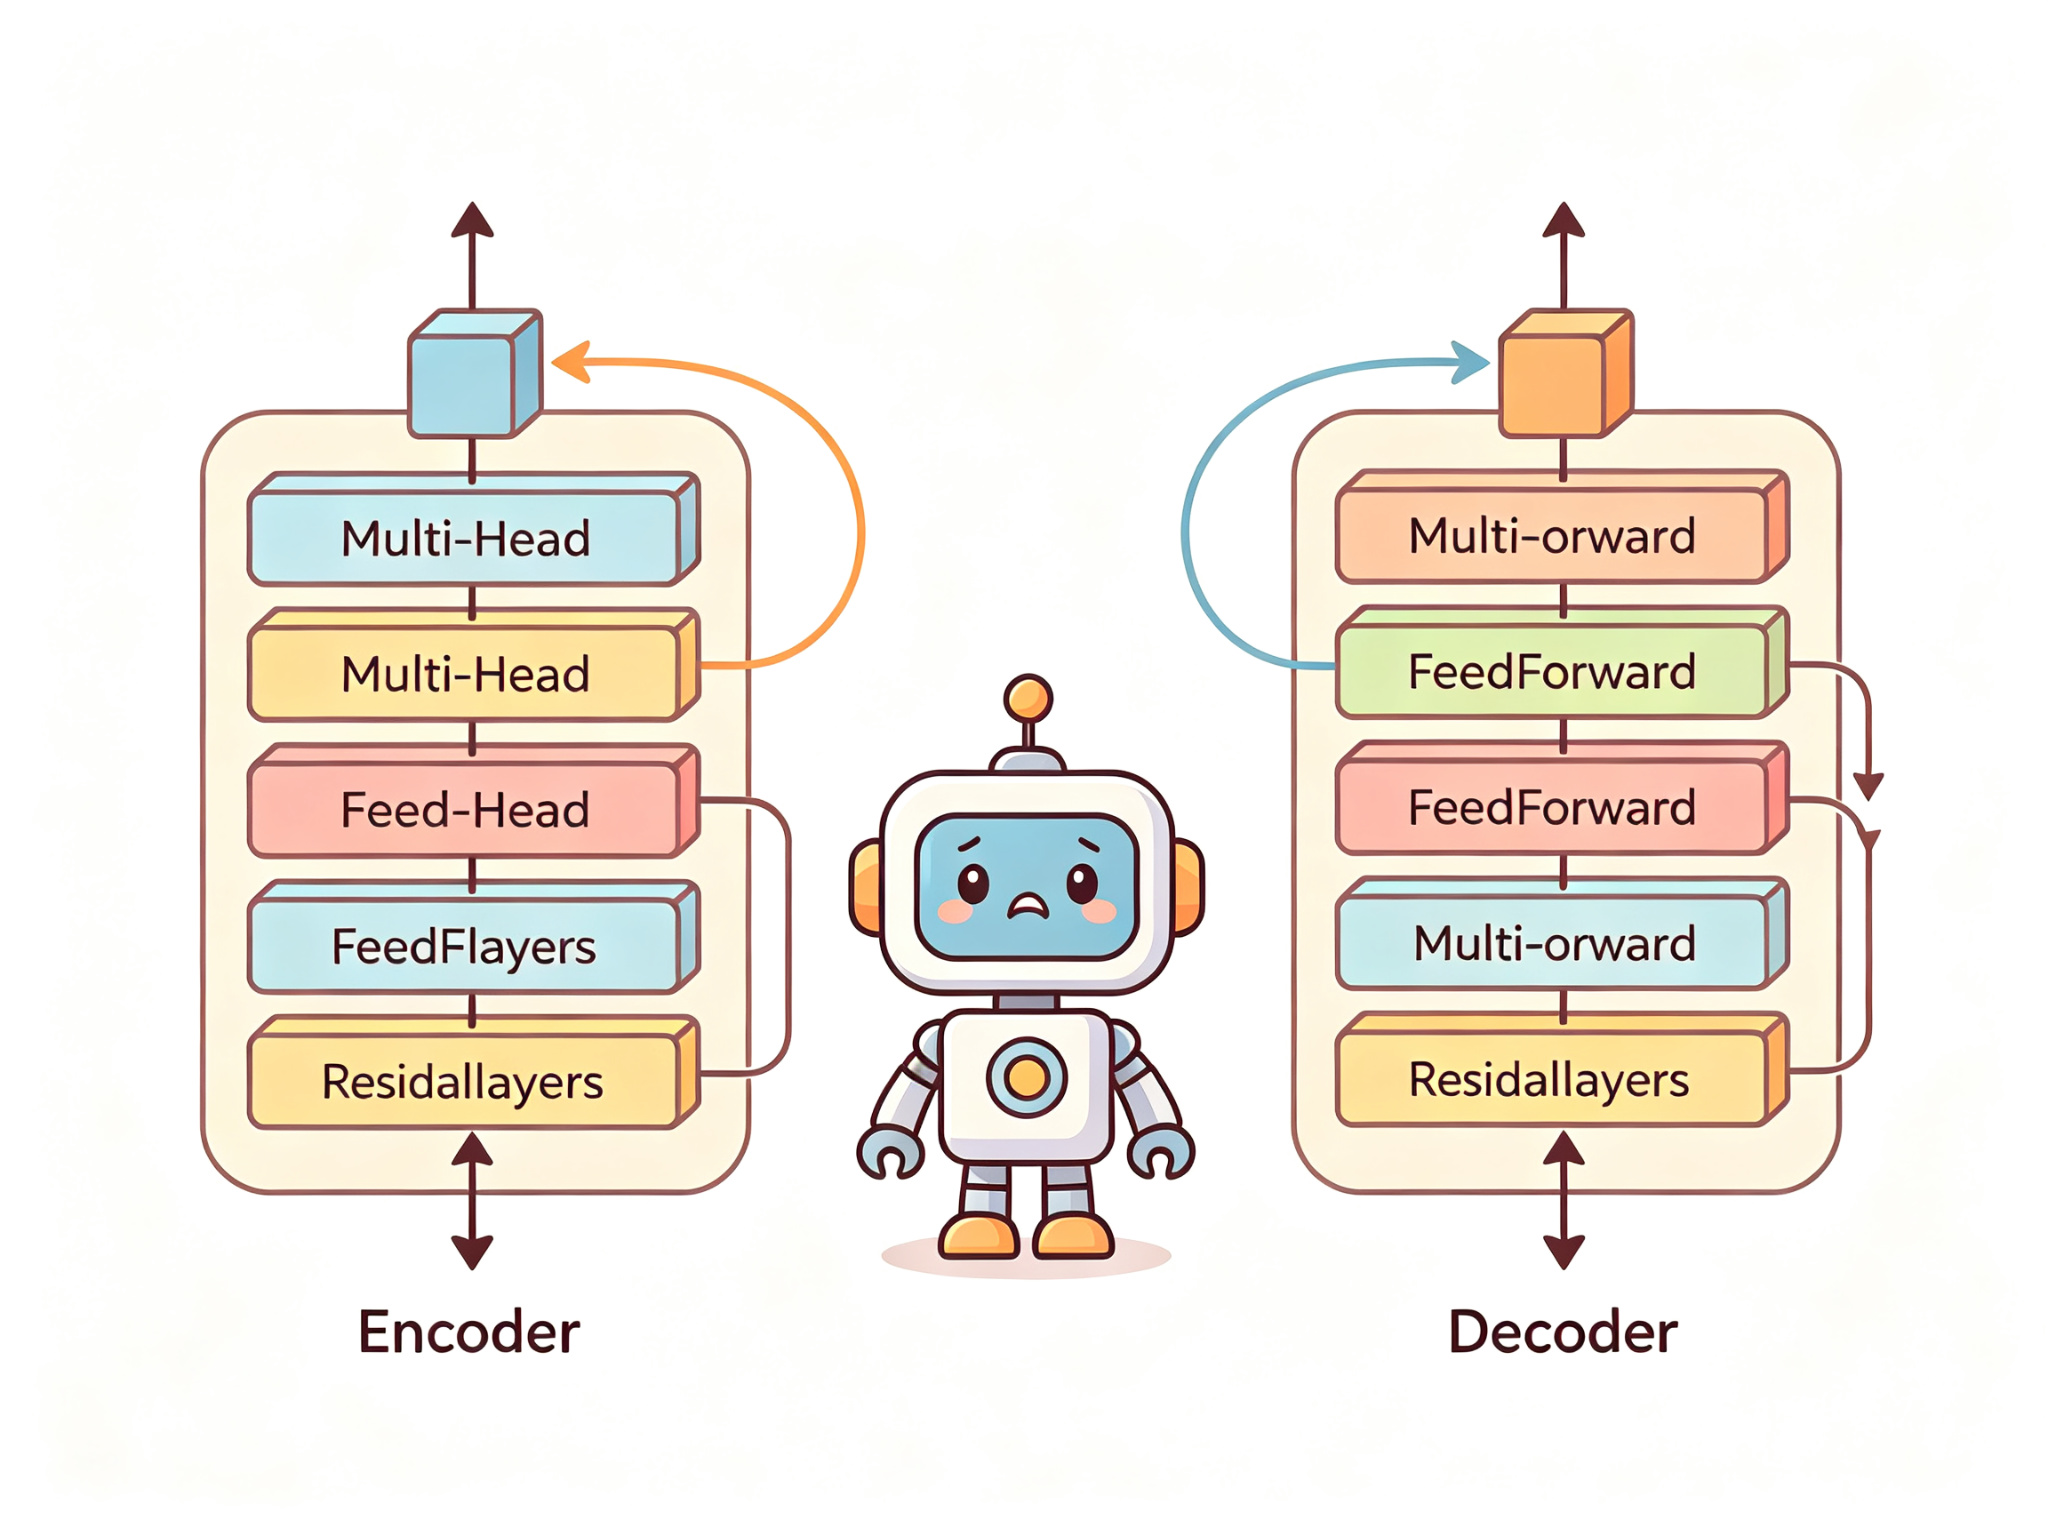
原始Transformer是一个编码器-解码器架构:
- 编码器(Encoder):由N层(通常6层)相同的层堆叠而成,每层包含两个子层:多头自注意力 + 前馈网络(FFN)。每个子层都有残差连接和层归一化(LayerNorm)。
- 解码器(Decoder):同样由N层相同的层堆叠而成,每层包含三个子层:掩码多头自注意力 + 交叉注意力(关注编码器输出)+ 前馈网络。同样有残差连接和层归一化。
前馈网络
每个注意力子层后面跟着一个位置-wise前馈网络(Position-wise Feed-Forward Network),它对每个位置独立应用相同的两层全连接网络:
FFN ( x ) = max ( 0 , x W 1 + b 1 ) W 2 + b 2 \text{FFN}(x) = \max(0, xW_1 + b_1) W_2 + b_2 FFN(x)=max(0,xW1+b1)W2+b2
中间层的维度通常是嵌入维度的4倍(如嵌入512,中间2048)。FFN为每个位置提供非线性变换,增加模型的表达能力。
残差连接和层归一化
和ResNet类似,Transformer的每个子层都有残差连接:
output = LayerNorm ( x + Sublayer ( x ) ) \text{output} = \text{LayerNorm}(x + \text{Sublayer}(x)) output=LayerNorm(x+Sublayer(x))
残差连接让梯度可以直接回传,层归一化稳定训练。现代Transformer通常使用**预归一化(Pre-LN)**结构:先做LayerNorm,再做子层,再加残差——这比后归一化更稳定,更容易训练深层网络。
输出层
解码器的输出经过一个线性层和softmax,得到下一个token的概率分布。训练时使用交叉熵损失,推理时使用贪心解码或束搜索(Beam Search)生成文本。
12.5 自然语言处理中的变换器
Transformer在NLP领域引发了革命。根据架构的不同,基于Transformer的模型可以分为三类:
- 编码器-only(Encoder-only):只使用编码器,如BERT。适合理解类任务(文本分类、命名实体识别、问答等)。
- 解码器-only(Decoder-only):只使用解码器,如GPT系列。适合生成类任务(文本生成、对话、代码生成等)。
- 编码器-解码器(Encoder-Decoder):同时使用编码器和解码器,如T5、BART。适合条件生成任务(机器翻译、摘要等)。
预训练-微调范式
Transformer模型通常遵循**预训练-微调(Pre-train then Fine-tune)**范式:
- 预训练:在大规模无标注文本上进行自监督预训练(如掩码语言建模、因果语言建模),学习通用的语言表示。
- 微调:在下游任务的有标注数据上微调预训练模型,适应具体任务。
这种范式的好处是:预训练一次,可以在无数下游任务上微调,大大减少了对标注数据的需求。
12.6 编码器模型示例:BERT
BERT(Bidirectional Encoder Representations from Transformers) 是Google在2018年提出的编码器-only模型,它彻底改变了NLP领域。
BERT的核心创新
- 双向注意力:BERT使用编码器的双向自注意力,每个位置可以关注左右两边的所有位置。这和GPT的单向注意力(只能看左边)形成对比。
- 掩码语言建模(MLM):预训练时随机掩码(mask)掉15%的token,让模型预测被掩码的token。这迫使模型学习双向的上下文表示。
- 下一句预测(NSP):预训练时给模型两个句子,判断第二句是否是第一句的下一句。这让模型学习句子间的关系。
BERT的架构
BERT有两个主要版本:
- BERT-base:12层编码器,隐藏维度768,12头注意力,约1.1亿参数
- BERT-large:24层编码器,隐藏维度1024,16头注意力,约3.4亿参数
BERT的影响
BERT在11项NLP基准测试上取得了SOTA,引发了"预训练-微调"的浪潮。后续的RoBERTa、ALBERT、ELECTRA、DeBERTa等都是BERT的改进版本。BERT的思想也影响了计算机视觉(ViT)等其他领域。
12.7 解码器模型示例:GPT-3
GPT(Generative Pre-trained Transformer) 系列是OpenAI提出的解码器-only模型,从GPT-1到GPT-4,不断刷新大语言模型的能力边界。
GPT的核心特点
- 单向因果注意力:每个位置只能关注左边的位置,不能看到未来。这使得GPT天然适合从左到右生成文本。
- 因果语言建模:预训练目标是预测下一个token(next token prediction)。给定前面的所有token,预测下一个最可能的token。
- 规模定律(Scaling Laws):GPT系列发现模型性能和模型大小、数据量、计算量之间存在幂律关系——只要增大规模,性能就会持续提升。这推动了大模型的竞赛。
GPT-3的规模
GPT-3(2020年)有1750亿参数,在几乎所有NLP任务上都展现了强大的能力,特别是少样本学习(Few-shot Learning)和零样本学习(Zero-shot Learning)——不需要微调,只需要在prompt中给几个示例(甚至不给示例),就能完成任务。
GPT系列的演进
- GPT-1(2018):1.17亿参数,证明了预训练+微调的有效性
- GPT-2(2019):15亿参数,展示了零样本能力
- GPT-3(2020):1750亿参数,少样本能力惊人
- InstructGPT/GPT-3.5(2022):通过RLHF(人类反馈强化学习)对齐人类偏好
- GPT-4(2023):多模态能力,更强大的推理
12.8 编码器-解码器模型示例:机器翻译
机器翻译是Transformer的原始应用场景。编码器-解码器架构非常适合翻译任务:
- 编码器:读取源语言句子(如英文),生成上下文表示
- 解码器:逐词生成目标语言句子(如中文),每一步通过交叉注意力关注源语言句子的所有位置
翻译过程
- 源语言句子经过分词、词嵌入、位置编码,输入编码器
- 编码器的N层自注意力处理后,输出源语言的上下文表示
- 解码器从特殊的起始符
<s>开始,通过掩码自注意力处理已生成的目标语言token - 交叉注意力让解码器关注编码器的输出,获取源语言信息
- 输出层预测下一个目标语言token
- 重复3-5,直到生成结束符
</s>
代表性模型
- T5(Text-to-Text Transfer Transformer):把所有NLP任务都统一成"文本到文本"的格式,用同一个编码器-解码器模型处理。
- BART:编码器-解码器架构,预训练时对输入进行噪声扰动(如删除、打乱、掩码),训练模型还原原始文本。
- mBART、M2M-100:多语言翻译模型,可以在100多种语言之间直接翻译。
12.9 用于长序列的变换器
自注意力的计算复杂度是 O ( T 2 ) O(T^2) O(T2)( T T T 是序列长度),因为每个位置都要和所有其他位置计算注意力。当序列很长(如数万、数十万token)时,计算量和内存消耗变得不可接受。
长序列Transformer的改进方向
- 稀疏注意力(Sparse Attention):不是每个位置都关注所有位置,而是只关注部分位置。如Longformer的滑动窗口+全局注意力,BigBird的随机+窗口+全局注意力。
- 线性注意力(Linear Attention):用核函数近似softmax注意力,把复杂度从 O ( T 2 ) O(T^2) O(T2) 降到 O ( T ) O(T) O(T)。如Performer、Linformer。
- 分块注意力(Block/Chunk Attention):把序列分成块,块内做全注意力,块间做稀疏或层次化注意力。如Reformer的局部敏感哈希注意力。
- 状态空间模型(SSM):如Mamba,用选择性状态空间模型代替注意力,实现线性复杂度,同时保持长距离建模能力。
- Ring Attention:在多个设备上分布式计算注意力,突破单设备内存限制,可以处理百万级token。
12.10 图像的变换器
Transformer最初是为NLP设计的,但很快被扩展到计算机视觉领域。ViT(Vision Transformer) 是Google在2020年提出的,它证明了纯Transformer架构在图像分类上也能达到甚至超过CNN。
ViT的工作原理
- 图像分块(Patchification):把图像切成固定大小的patch(如16×16),每个patch展平成一个向量
- 线性投影:把patch向量投影到Transformer的嵌入维度
- 位置编码:给每个patch添加位置编码(因为patch有空间位置)
- Transformer编码器:用标准的Transformer编码器处理patch序列
- 分类头:用一个特殊的
<[BOS_never_used_51bce0c785ca2f68081bfa7d91973934]>token的输出(或全局平均池化)经过线性层分类
ViT vs CNN
- 优点:ViT没有CNN的归纳偏置(局部性、平移不变性),在大规模数据上表现更好,因为它可以自己学习图像的结构。ViT的可扩展性更好,增大模型和数据时性能持续提升。
- 缺点:ViT需要更多的数据才能训练好(因为没有归纳偏置)。在中小规模数据上,CNN通常更好。ViT的计算量也更大。
视觉Transformer的发展
- DeiT:数据高效的ViT,用知识蒸馏让ViT在ImageNet上也能训练好
- Swin Transformer:层次化的ViT,用移动窗口注意力降低计算量,可以做目标检测和分割
- CLIP:对比学习的图像-文本模型,零样本图像分类能力惊人
- DALL·E、Stable Diffusion:基于Transformer的图像生成模型
- SAM(Segment Anything Model):基于Transformer的通用图像分割模型
12.11 本章小结
本章我们系统学习了变换器。核心要点如下:
-
Transformer完全基于自注意力机制,抛弃了循环结构:自注意力让每个token直接关注所有其他token,一步建立长距离依赖,而且完全并行计算。
-
文本处理需要分词、词嵌入和位置编码:位置编码解决了自注意力的置换不变问题,让模型感知顺序。
-
缩放点积注意力是核心: Attention ( Q , K , V ) = softmax ( Q K T / d k ) V \text{Attention}(Q,K,V) = \text{softmax}(QK^T/\sqrt{d_k})V Attention(Q,K,V)=softmax(QKT/dk)V。缩放因子 d k \sqrt{d_k} dk 防止点积过大导致梯度消失。
-
多头注意力让模型学习不同类型的注意力模式:多个头独立计算注意力,拼接后投影,增加表达能力。
-
Transformer由编码器和解码器组成:编码器用双向自注意力,解码器用掩码自注意力+交叉注意力。每个子层有残差连接和层归一化。
-
三类Transformer架构:编码器-only(BERT,适合理解)、解码器-only(GPT,适合生成)、编码器-解码器(T5,适合条件生成)。
-
预训练-微调范式:在大规模无标注文本上预训练,在下游任务上微调,大大减少标注数据需求。
-
自注意力的 O ( T 2 ) O(T^2) O(T2) 复杂度限制了长序列应用:稀疏注意力、线性注意力、状态空间模型等方法试图解决这个问题。
-
Transformer已经扩展到几乎所有领域:NLP、计算机视觉(ViT)、语音处理、蛋白质结构预测(AlphaFold)、代码生成、多模态等。Transformer是当今AI的基石架构。
代码实验结果
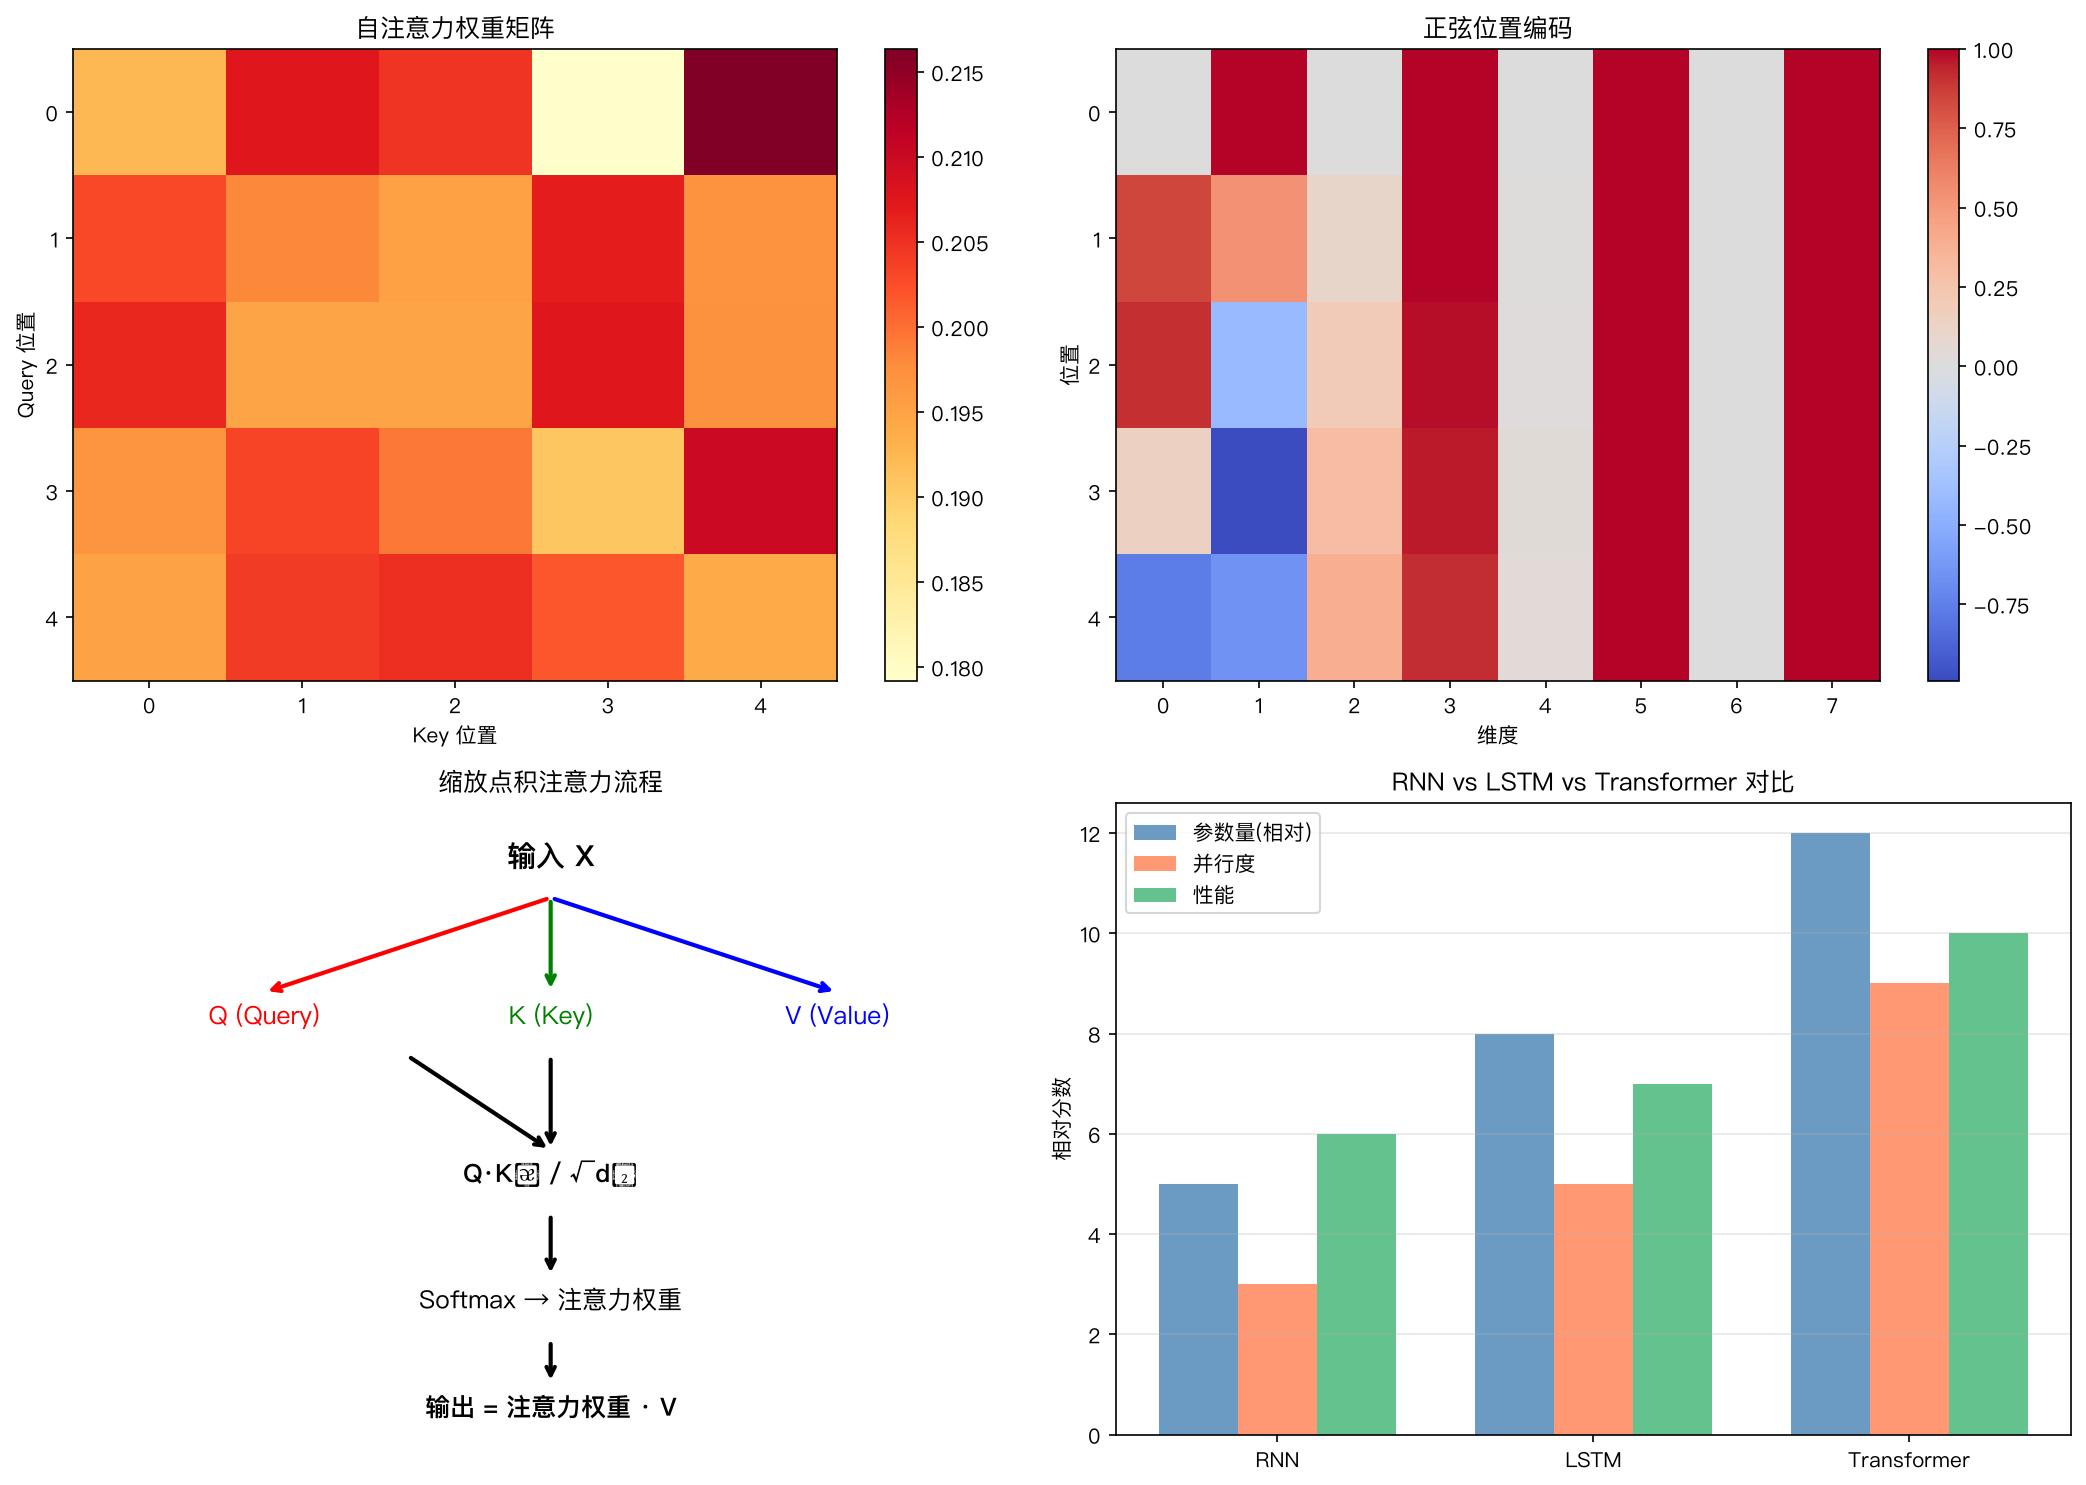
我们编写了完整的Python代码,从零实现了缩放点积自注意力、多头注意力和正弦位置编码。以下是真实运行结果。
实验1:从零实现缩放点积自注意力
- 输入:5个token,每个token嵌入维度8
- Q/K/V维度:4
- 输出:5×4矩阵
输入形状: (5, 8) (seq_len=5, d_model=8)
Q形状: (5, 4), K形状: (5, 4), V形状: (5, 4)
注意力权重形状: (5, 5)
输出形状: (5, 4)

注意力权重矩阵(每行和为1):
[[0.192 0.207 0.205 0.179 0.216]
 [0.203 0.198 0.195 0.207 0.197]
 [0.206 0.195 0.195 0.207 0.197]
 [0.197 0.203 0.199 0.191 0.210]
 [0.195 0.204 0.205 0.202 0.194]]

每行和验证: [1. 1. 1. 1. 1.]
实验2:从零实现多头注意力
- 头数:2,每头维度4
- 输出:5×8矩阵(和输入维度相同)
输入形状: (5, 8)
头数: 2, 每头维度: 4
多头注意力输出形状: (5, 8)
实验3:正弦位置编码
- 序列长度:5,嵌入维度8
- 前3个位置前4维:
位置编码形状: (5, 8)
位置编码(前3个位置,前4维):
[[ 0.     1.     0.     1.   ]
 [ 0.841  0.540  0.100  0.995]
 [ 0.909 -0.416  0.199  0.980]]
结果可视化
结果分析
-
自注意力从零实现验证通过:5×8输入经过Q/K/V投影(5×4),计算注意力分数(5×5),softmax后每行和为1(验证了注意力权重的归一化),加权求和得到5×4输出。所有维度完全符合公式。
-
注意力权重的均匀性:由于输入是随机初始化的、Q/K/V投影也是随机的,注意力权重比较均匀(每个约0.2)。在实际训练后,注意力权重会变得稀疏——每个token会重点关注少数几个相关token。
-
多头注意力输出维度正确:2头注意力,每头4维,拼接后8维,再经过输出投影,最终输出5×8,和输入维度相同。这保证了多头注意力可以作为残差块的子层使用。
-
正弦位置编码的特性验证:位置0的编码是[0,1,0,1,…](sin(0)=0, cos(0)=1)。位置1的sin值0.841、cos值0.540,位置2的sin值0.909、cos值-0.416。不同维度有不同的频率(低频到高频),使得每个位置有独特的编码,且相对位置可以通过线性变换得到。
-
缩放因子的重要性:代码中使用了 1 / d k = 1 / 2 1/\sqrt{d_k} = 1/2 1/dk=1/2 的缩放因子。如果不缩放,当 d k = 4 d_k=4 dk=4 时点积的方差约为4,softmax会进入饱和区;缩放后方差约为1,softmax有更好的梯度。这在实际训练中至关重要。
本章核心总结
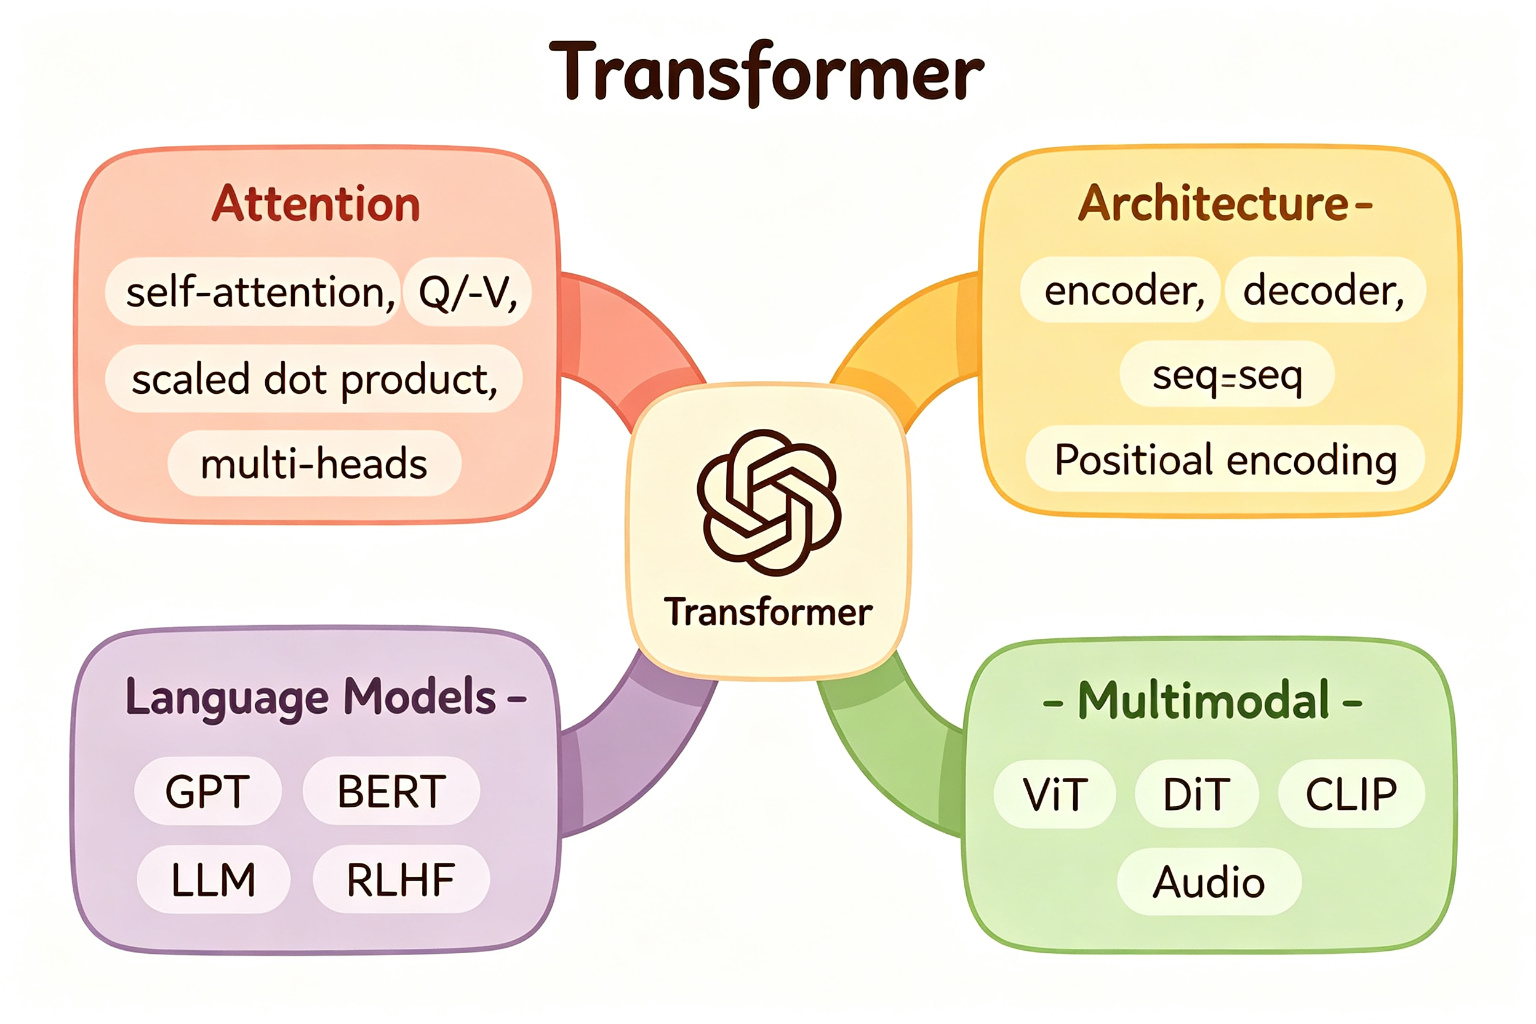
一句话概括:Transformer通过自注意力机制让序列中每个token直接关注所有其他token,完全并行计算,配合位置编码、多头注意力和残差连接,成为NLP乃至整个AI领域的基石架构。
Transformer核心公式清单:
| 概念 | 公式 |
|---|---|
| 缩放点积注意力 | Attention ( Q , K , V ) = softmax ( Q K T / d k ) V \text{Attention}(Q,K,V) = \text{softmax}(QK^T/\sqrt{d_k})V Attention(Q,K,V)=softmax(QKT/dk)V |
| 多头注意力 | MultiHead = Concat ( head 1 , … , head h ) W O \text{MultiHead} = \text{Concat}(\text{head}_1,\ldots,\text{head}_h)W^O MultiHead=Concat(head1,…,headh)WO |
| 正弦位置编码 | P E ( p o s , 2 i ) = sin ( p o s / 10000 2 i / D ) PE_{(pos,2i)} = \sin(pos/10000^{2i/D}) PE(pos,2i)=sin(pos/100002i/D) |
| FFN | FFN ( x ) = max ( 0 , x W 1 + b 1 ) W 2 + b 2 \text{FFN}(x) = \max(0,xW_1+b_1)W_2+b_2 FFN(x)=max(0,xW1+b1)W2+b2 |
| 残差+归一化 | output = LayerNorm ( x + Sublayer ( x ) ) \text{output} = \text{LayerNorm}(x + \text{Sublayer}(x)) output=LayerNorm(x+Sublayer(x)) |
| 注意力复杂度 | O ( T 2 ⋅ d ) O(T^2 \cdot d) O(T2⋅d) |
结语
本章我们彻底搞懂了变换器。从文本数据的处理(分词、词嵌入、位置编码),到自注意力机制的核心原理(Q/K/V、缩放点积、多头注意力),再到Transformer的完整架构(编码器、解码器、残差连接、层归一化),最后学习了BERT、GPT等著名模型和Transformer在视觉、长序列等领域的扩展。Transformer是当今AI最重要的架构,理解了它,你就掌握了大语言模型、多模态AI等前沿技术的根基。
到目前为止,我们已经学习了全连接网络、卷积网络、残差网络、变换器——这些都是处理欧几里得结构数据(如图像、文本)的强大工具。但现实世界中还有一类重要的数据:图结构数据(如社交网络、分子结构、知识图谱)。图数据没有固定的网格结构,节点之间的连接是任意的,CNN和Transformer都不适合直接处理。下一章的主题是图神经网络(Graph Neural Network,GNN)——一种专门为图结构数据设计的神经网络,在社交网络分析、药物发现、推荐系统等领域有广泛应用。
下一章见!
更多推荐

 1
 0
- 0


 已为社区贡献43条内容

所有评论(0)