


- @luohaitao


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
当API请求前缀与历史请求完全一致时,大模型可复用缓存的KVCache,跳过重复预填充计算,提升效率并降低成本。缓存需从首个Token起完全匹配,微小改动即失效。仅输入Token可缓存,输出不可缓存。命中缓存后,对应token按原价1%~20%计费,且缓存有TTL(如DeepSeek 5分钟,OpenAI 5-10分钟)。通过usage字段中cache_read_input_tokens判断是否命

Docker Desktop的“Build”功能用于根据Dockerfile构建镜像。它读取Dockerfile指令,准备构建上下文,分层执行命令(如安装依赖、复制文件),最终生成可运行的镜像。构建过程在界面中可视化,支持查看日志、管理镜像,成功后可在镜像列表中使用或推送至仓库。

摘要:本文介绍了在Windows系统中打开.img文件的三种方法。最推荐使用系统自带的"装载"功能,通过右键菜单将.img文件挂载为虚拟光驱;也可使用7-Zip或WinRAR等解压软件直接查看内容;若遇到问题,可修改文件关联或使用WinCDEmu等第三方虚拟光驱工具。每种方法都提供了详细的操作步骤和注意事项。

VSCode安装后的默认界面是只有英文的,如果想用中文界面,那么就需要安装对应的插件,vscode插件可以从扩展中心去搜索并安装。点击图标右侧的Install即可,安装完成后等待右下角的restart按钮重启vscode。在搜索框中输入chinese,弹出chinese(Simplif...简体中文。安装vscode后打开vscode,点击左侧的扩展按钮。重启之后即可看到中文界面的vscode了。

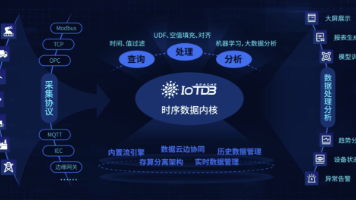
时序数据库是专为时间序列数据优化的数据库,擅长高效存储和查询带时间戳的数据流(如传感器监测、金融行情)。相比通用数据库,它具有超高速写入(百万条/秒)、极高压缩比(10-100倍)和快速时间范围查询等特性,广泛应用于物联网、IT运维、金融分析等领域,代表产品包括InfluxDB、Prometheus等。
Celery、scikit-learn与PyTorch是现代机器学习与工程系统中的核心工具:Celery实现异步任务调度,剥离耗时操作(如发邮件、模型推理);sklearn提供统一接口的传统机器学习算法,适用于中小规模数据建模;PyTorch则聚焦深度学习,支持动态计算图与自动求导,广泛用于图像、NLP及大模型训练。三者常协同使用——通过Celery异步调度sklearn或PyTorch的推理任务
也就是说不仅会包含你曾经安装的程序,而且会包含大量库文件和间接安装的软件包。还有通过目录/usr/share/applications列出所有安装的包,比如刚才我们安装的goldendict和网易云音乐,途中两个是desktop就是在上上图中出现的程序。由于列出出来的已安装的软件包太多,用 grep 过滤特定的软件包是一个比较好的办法。这里以goldendict为例。正好也验证一下前一篇文章里面的

今天更新到Ubuntu20.04后,语言设置里面添加了zh中文后,发现没有输入法,然后按照下面的设置成功添加,本文讲述如何设置中文输入法。

前面讲了在WSL2里面的Ubuntu和windows间传递文件的第一种方式,非常简单和实用,如果就是在windows下操作wsl里面的linux完全够用了。但是,如果单独的主机部署了Ubuntu或者其他linux等,该怎么访问和传递数据呢?今天再说一种mnt的方式。

wsl装ubuntu的home目录在哪,如何更改home
