
《理解深度学习》第7章 梯度与参数初始化 读书笔记
《理解深度学习》第7章 梯度与参数初始化 读书笔记
目录
开篇导语
上一章我们学习了梯度下降和各种优化算法,知道了要沿着梯度反方向更新参数。但有一个关键问题还没解决:深度神经网络的梯度怎么算? 一个几十层的网络,参数成千上万,手动求导根本不可能。
这就是反向传播算法(Backpropagation)的用武之地。它利用微积分中的链式法则(Chain Rule),从输出层开始,一层一层地往回计算每个参数的梯度,效率极高。可以说,没有反向传播,就没有今天的深度学习。
除了梯度计算,本章还会讨论另一个同样重要的问题:参数初始化。你可能会想,参数初始值随便设不就行了?大错特错!不好的初始化会导致梯度消失或梯度爆炸,让网络根本无法训练。好的初始化(如Xavier、He初始化)则能让梯度在各层之间保持稳定,大大加速收敛。
本章我们将从链式法则出发,一步步推导反向传播算法,然后用代码从零实现一个2层神经网络的反向传播,最后对比各种初始化方法的效果。
7.1 问题定义
我们的目标是计算损失函数 L \mathcal{L} L 关于网络中每个参数 θ \theta θ 的梯度 ∂ L ∂ θ \frac{\partial \mathcal{L}}{\partial \theta} ∂θ∂L。有了梯度,就可以用梯度下降更新参数了。
对于一个简单的函数,比如 f ( x ) = x 2 f(x) = x^2 f(x)=x2,求导很简单: f ′ ( x ) = 2 x f'(x) = 2x f′(x)=2x。但对于深度神经网络,情况要复杂得多:
- 网络是复合函数:输出 = 第L层(第L-1层(…第1层(输入)…)),层层嵌套。
- 参数数量巨大:一个普通的网络可能有几百万甚至几十亿个参数。
- 需要高效计算:手动求导不现实,数值微分(用有限差分近似)又太慢。
反向传播算法就是为了解决这个问题而生的。它的核心思想是:利用链式法则,从输出层开始,逐层往回计算梯度,每个参数的梯度只需要计算一次。
7.2 计算导数
链式法则
反向传播的数学基础是微积分中的链式法则(Chain Rule)。对于复合函数 y = f ( g ( x ) ) y = f(g(x)) y=f(g(x)),导数为:
d y d x = d y d g ⋅ d g d x \frac{dy}{dx} = \frac{dy}{dg} \cdot \frac{dg}{dx} dxdy=dgdy⋅dxdg
也就是说,外层函数的导数乘以内层函数的导数。对于多层嵌套 y = f 1 ( f 2 ( . . . f n ( x ) . . . ) ) y = f_1(f_2(...f_n(x)...)) y=f1(f2(...fn(x)...)),链式法则可以推广为:
d y d x = d y d f 1 ⋅ d f 1 d f 2 ⋅ … ⋅ d f n d x \frac{dy}{dx} = \frac{dy}{df_1} \cdot \frac{df_1}{df_2} \cdot \ldots \cdot \frac{df_n}{dx} dxdy=df1dy⋅df2df1⋅…⋅dxdfn
这正是反向传播的核心:梯度像水流一样,从输出层一层一层地"流"回输入层,每经过一层就乘以该层的导数。
计算图视角
理解反向传播的另一个视角是计算图(Computational Graph)。把神经网络的计算过程画成一个有向无环图:
- 节点:变量(输入、权重、激活值、损失)
- 边:运算(加法、乘法、激活函数等)
前向传播:从输入节点开始,沿着边的方向计算每个节点的值,直到得到损失。
反向传播:从损失节点开始,逆着边的方向计算每个节点的梯度(即损失对该节点的偏导数),直到得到所有参数的梯度。
计算图视角让反向传播变得非常直观:每个节点只需要知道自己的局部导数,然后把上游传来的梯度乘以局部导数,再传给下游节点。
7.3 简单示例
让我们用一个简单的例子来理解反向传播。考虑函数:
f ( x , y , z ) = ( x + y ) ⋅ z f(x, y, z) = (x + y) \cdot z f(x,y,z)=(x+y)⋅z
假设 x = 2 , y = 3 , z = − 4 x=2, y=3, z=-4 x=2,y=3,z=−4,我们想求 ∂ f ∂ x , ∂ f ∂ y , ∂ f ∂ z \frac{\partial f}{\partial x}, \frac{\partial f}{\partial y}, \frac{\partial f}{\partial z} ∂x∂f,∂y∂f,∂z∂f。
前向传播
先计算中间变量和最终输出:
- q = x + y = 2 + 3 = 5 q = x + y = 2 + 3 = 5 q=x+y=2+3=5
- f = q ⋅ z = 5 × ( − 4 ) = − 20 f = q \cdot z = 5 \times (-4) = -20 f=q⋅z=5×(−4)=−20
反向传播
从输出开始,往回计算梯度:
-
输出层: ∂ f ∂ f = 1 \frac{\partial f}{\partial f} = 1 ∂f∂f=1(梯度的起点)
-
乘法节点 f = q ⋅ z f = q \cdot z f=q⋅z:
- ∂ f ∂ q = z = − 4 \frac{\partial f}{\partial q} = z = -4 ∂q∂f=z=−4
- ∂ f ∂ z = q = 5 \frac{\partial f}{\partial z} = q = 5 ∂z∂f=q=5
- 传给 q q q 的梯度: ∂ f ∂ q = − 4 \frac{\partial f}{\partial q} = -4 ∂q∂f=−4
- 传给 z z z 的梯度: ∂ f ∂ z = 5 \frac{\partial f}{\partial z} = 5 ∂z∂f=5
-
加法节点 q = x + y q = x + y q=x+y:
- ∂ q ∂ x = 1 \frac{\partial q}{\partial x} = 1 ∂x∂q=1
- ∂ q ∂ y = 1 \frac{\partial q}{\partial y} = 1 ∂y∂q=1
- 传给 x x x 的梯度: ∂ f ∂ x = ∂ f ∂ q ⋅ ∂ q ∂ x = − 4 × 1 = − 4 \frac{\partial f}{\partial x} = \frac{\partial f}{\partial q} \cdot \frac{\partial q}{\partial x} = -4 \times 1 = -4 ∂x∂f=∂q∂f⋅∂x∂q=−4×1=−4
- 传给 y y y 的梯度: ∂ f ∂ y = ∂ f ∂ q ⋅ ∂ q ∂ y = − 4 × 1 = − 4 \frac{\partial f}{\partial y} = \frac{\partial f}{\partial q} \cdot \frac{\partial q}{\partial y} = -4 \times 1 = -4 ∂y∂f=∂q∂f⋅∂y∂q=−4×1=−4
最终结果: ∂ f ∂ x = − 4 , ∂ f ∂ y = − 4 , ∂ f ∂ z = 5 \frac{\partial f}{\partial x} = -4, \frac{\partial f}{\partial y} = -4, \frac{\partial f}{\partial z} = 5 ∂x∂f=−4,∂y∂f=−4,∂z∂f=5。
可以验证一下:如果 x x x 增加一点点(比如0.01), f f f 大约减少0.04(因为梯度是-4),即 f ≈ − 20.04 f \approx -20.04 f≈−20.04。直接计算: ( 2.01 + 3 ) × ( − 4 ) = 5.01 × ( − 4 ) = − 20.04 (2.01+3)\times(-4) = 5.01\times(-4) = -20.04 (2.01+3)×(−4)=5.01×(−4)=−20.04,完全一致!
这个简单例子展示了反向传播的核心思想:从输出开始,利用链式法则,逐层往回传梯度。神经网络的反向传播本质上就是这个过程的推广,只是节点更多、运算更复杂而已。
7.4 反向传播算法
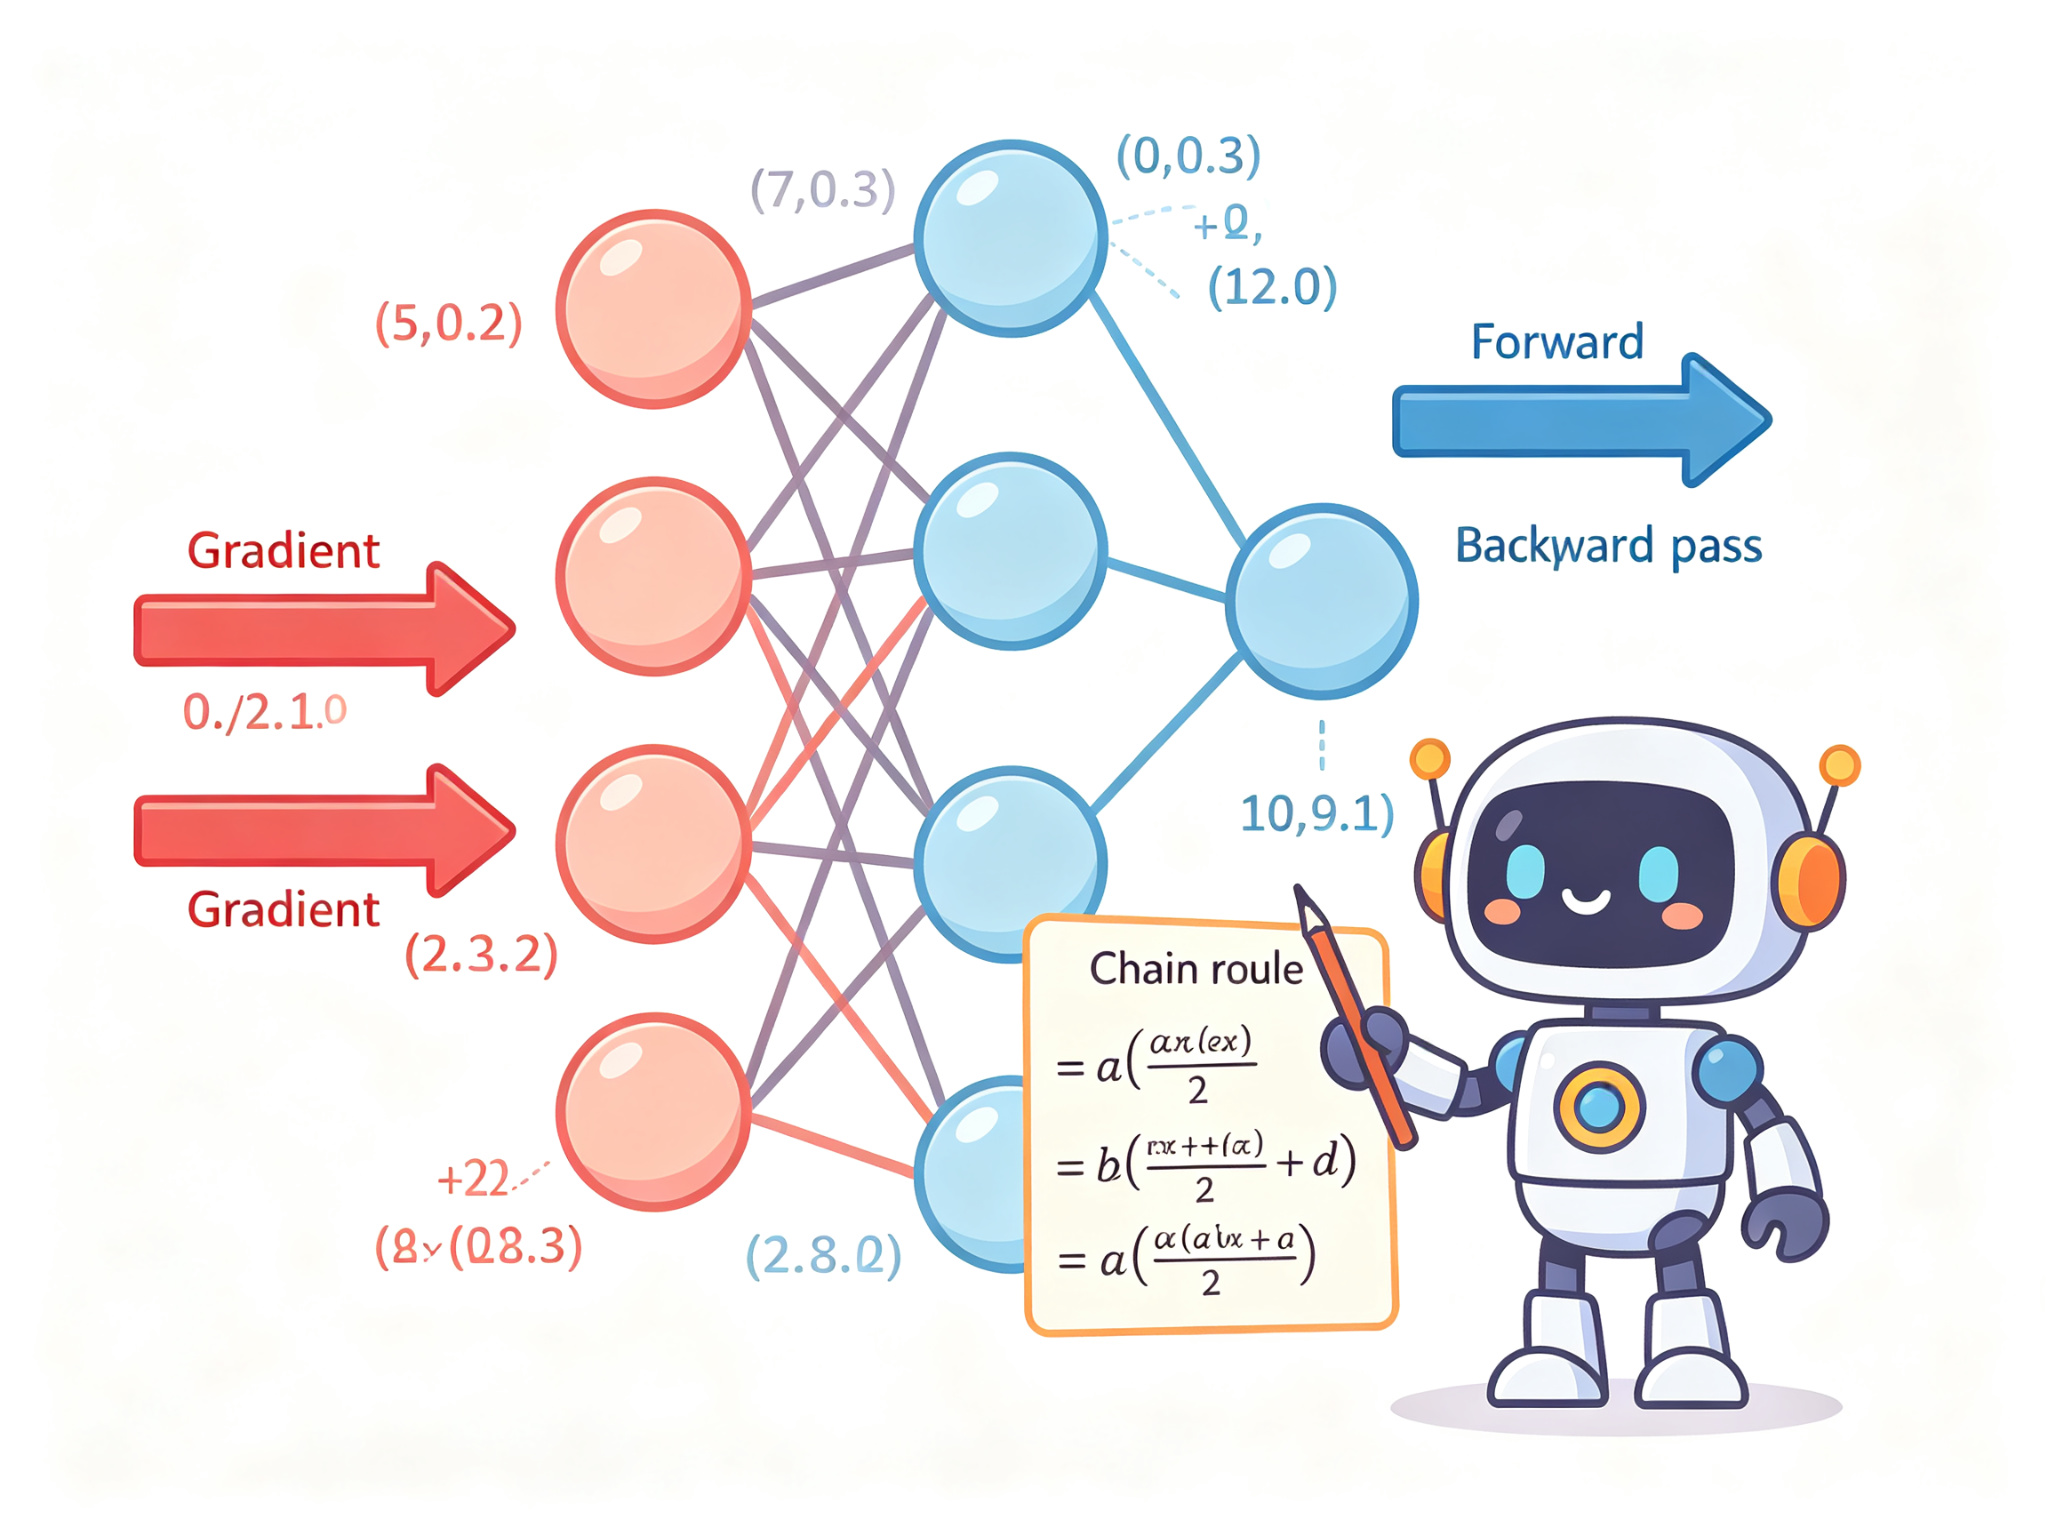
现在我们来正式推导神经网络的反向传播算法。考虑一个 L L L 层的全连接网络:
z
(
l
)
=
W
(
l
)
a
(
l
−
1
)
+
b
(
l
)
z^{(l)} = W^{(l)} a^{(l-1)} + b^{(l)}
z(l)=W(l)a(l−1)+b(l)
a
(
l
)
=
σ
(
z
(
l
)
)
a^{(l)} = \sigma(z^{(l)})
a(l)=σ(z(l))
其中 a ( 0 ) = x a^{(0)} = x a(0)=x 是输入, a ( L ) a^{(L)} a(L) 是输出, σ \sigma σ 是激活函数。损失函数为 L \mathcal{L} L。
输出层梯度
定义第 l l l 层的误差项(delta)为损失对该层线性组合 z ( l ) z^{(l)} z(l) 的偏导:
δ ( l ) = ∂ L ∂ z ( l ) \delta^{(l)} = \frac{\partial \mathcal{L}}{\partial z^{(l)}} δ(l)=∂z(l)∂L
对于输出层 l = L l=L l=L:
δ ( L ) = ∂ L ∂ a ( L ) ⊙ σ ′ ( z ( L ) ) \delta^{(L)} = \frac{\partial \mathcal{L}}{\partial a^{(L)}} \odot \sigma'(z^{(L)}) δ(L)=∂a(L)∂L⊙σ′(z(L))
其中 ⊙ \odot ⊙ 表示逐元素乘法, σ ′ \sigma' σ′ 是激活函数的导数。这个公式的含义是:输出层的误差 = 损失对输出的偏导 × 激活函数的导数。
误差反向传播
对于隐藏层 l < L l < L l<L,误差从后一层传过来:
δ ( l ) = ( ( W ( l + 1 ) ) T δ ( l + 1 ) ) ⊙ σ ′ ( z ( l ) ) \delta^{(l)} = \left( (W^{(l+1)})^T \delta^{(l+1)} \right) \odot \sigma'(z^{(l)}) δ(l)=((W(l+1))Tδ(l+1))⊙σ′(z(l))
这个公式是反向传播的核心:当前层的误差 = 后一层权重的转置乘以后一层的误差,再乘以当前层激活函数的导数。
直观理解:后一层的误差通过权重矩阵"反传"到当前层,然后乘以激活函数的导数,得到当前层的误差。这个过程一层一层地进行,直到输入层。
参数梯度
有了误差项 δ ( l ) \delta^{(l)} δ(l),参数的梯度就很容易计算了:
∂
L
∂
W
(
l
)
=
δ
(
l
)
(
a
(
l
−
1
)
)
T
\frac{\partial \mathcal{L}}{\partial W^{(l)}} = \delta^{(l)} (a^{(l-1)})^T
∂W(l)∂L=δ(l)(a(l−1))T
∂
L
∂
b
(
l
)
=
δ
(
l
)
\frac{\partial \mathcal{L}}{\partial b^{(l)}} = \delta^{(l)}
∂b(l)∂L=δ(l)
权重的梯度 = 误差 × 前一层激活的转置;偏置的梯度 = 误差本身(通常对batch取平均)。
反向传播算法步骤
- 前向传播:计算每一层的 z ( l ) z^{(l)} z(l) 和 a ( l ) a^{(l)} a(l),直到得到输出和损失。
- 输出层误差:计算 δ ( L ) \delta^{(L)} δ(L)。
- 误差反传:从 l = L − 1 l=L-1 l=L−1 到 l = 1 l=1 l=1,逐层计算 δ ( l ) \delta^{(l)} δ(l)。
- 计算梯度:对每一层计算 ∂ L ∂ W ( l ) \frac{\partial \mathcal{L}}{\partial W^{(l)}} ∂W(l)∂L 和 ∂ L ∂ b ( l ) \frac{\partial \mathcal{L}}{\partial b^{(l)}} ∂b(l)∂L。
- 更新参数:用梯度下降更新 W ( l ) W^{(l)} W(l) 和 b ( l ) b^{(l)} b(l)。
反向传播的时间复杂度和前向传播是同一个量级的(大约是前向传播的2-3倍),非常高效。这就是为什么深度学习能训练大规模网络的关键原因。
7.5 参数初始化
参数初始化是训练神经网络时经常被忽视但极其重要的一环。好的初始化能让梯度在各层之间保持稳定,加速收敛;不好的初始化则可能导致梯度消失或梯度爆炸,让网络根本无法训练。
全零初始化的问题
一个常见的误区是把所有权重初始化为0。这会导致一个严重的问题:对称性(Symmetry)。
如果同一层的所有神经元权重都相同(都是0),那么它们在前向传播时输出相同,在反向传播时梯度也相同,更新后仍然相同。这意味着同一层的所有神经元永远在做同样的事情,网络失去了表达能力。
因此,权重必须随机初始化,打破对称性。偏置可以初始化为0,因为权重的随机性已经打破了对称性。
梯度消失与梯度爆炸
在深度网络中,梯度在反向传播时会经过很多层。如果每一层的梯度都小于1,那么经过多层连乘后,梯度会趋近于0——这就是梯度消失(Vanishing Gradient)。反之,如果每一层的梯度都大于1,经过多层连乘后梯度会趋向无穷大——这就是梯度爆炸(Exploding Gradient)。
梯度消失导致前面的层几乎学不到东西,网络训练缓慢;梯度爆炸导致参数更新过大,训练不稳定甚至发散。
好的初始化方法的目标就是:让每一层的激活值和梯度的方差保持稳定,既不消失也不爆炸。
Xavier初始化
Xavier初始化(Glorot初始化) 由Xavier Glorot在2010年提出,适用于sigmoid、tanh等激活函数。它的思想是让每一层输入和输出的方差保持一致。
Xavier初始化从均匀分布或正态分布中采样权重:
W ∼ U ( − 6 n i n + n o u t , 6 n i n + n o u t ) W \sim \mathcal{U}\left(-\sqrt{\frac{6}{n_{in} + n_{out}}}, \sqrt{\frac{6}{n_{in} + n_{out}}}\right) W∼U(−nin+nout6,nin+nout6)
或正态分布版本:
W ∼ N ( 0 , 2 n i n + n o u t ) W \sim \mathcal{N}\left(0, \sqrt{\frac{2}{n_{in} + n_{out}}}\right) W∼N(0,nin+nout2)
其中 n i n n_{in} nin 是输入神经元数, n o u t n_{out} nout 是输出神经元数。
He初始化
He初始化(Kaiming初始化) 由何恺明在2015年提出,专门针对ReLU激活函数。由于ReLU会把一半的输入置为0,Xavier初始化的假设不再成立,需要更大的方差。
He初始化从正态分布中采样:
W ∼ N ( 0 , 2 n i n ) W \sim \mathcal{N}\left(0, \sqrt{\frac{2}{n_{in}}}\right) W∼N(0,nin2)
He初始化在使用ReLU的网络中通常比Xavier初始化效果更好,是目前最常用的初始化方法之一。
初始化方法对比
| 初始化方法 | 公式 | 适用激活函数 | 特点 |
|---|---|---|---|
| 全零 | W = 0 W=0 W=0 | 无 | 对称性问题,无法学习 |
| 随机小值 | W ∼ N ( 0 , 0.01 ) W \sim \mathcal{N}(0, 0.01) W∼N(0,0.01) | 浅层网络 | 简单但深层网络梯度消失 |
| Xavier | W ∼ N ( 0 , 2 / ( n i n + n o u t ) ) W \sim \mathcal{N}(0, \sqrt{2/(n_{in}+n_{out})}) W∼N(0,2/(nin+nout)) | sigmoid, tanh | 保持输入输出方差一致 |
| He | W ∼ N ( 0 , 2 / n i n ) W \sim \mathcal{N}(0, \sqrt{2/n_{in}}) W∼N(0,2/nin) | ReLU, Leaky ReLU | 针对ReLU设计,最常用 |
7.6 本章小结
本章我们深入学习了反向传播算法和参数初始化。核心要点如下:
-
反向传播的核心是链式法则:复合函数的导数等于各层导数的连乘。反向传播从输出层开始,利用链式法则逐层往回计算梯度,每个参数的梯度只算一次,效率极高。
-
计算图视角:把神经网络的计算画成有向无环图,前向传播计算节点值,反向传播计算节点梯度。每个节点只需知道自己的局部导数,然后把上游梯度乘以局部导数传给下游。
-
误差项delta是关键:定义 δ ( l ) = ∂ L / ∂ z ( l ) \delta^{(l)} = \partial\mathcal{L}/\partial z^{(l)} δ(l)=∂L/∂z(l),输出层delta由损失和激活导数决定,隐藏层delta由后一层delta通过权重矩阵反传得到。有了delta,参数梯度就是delta乘以前一层激活。
-
全零初始化导致对称性问题:同一层所有神经元权重相同,永远在做同样的事,网络失去表达能力。权重必须随机初始化打破对称性。
-
梯度消失与爆炸:深度网络中梯度经过多层连乘,可能消失(每层<1)或爆炸(每层>1)。好的初始化让各层梯度方差保持稳定。
-
Xavier vs He初始化:Xavier适用于sigmoid/tanh,保持输入输出方差一致;He适用于ReLU,方差更大。He初始化是目前最常用的方法。
代码实验结果
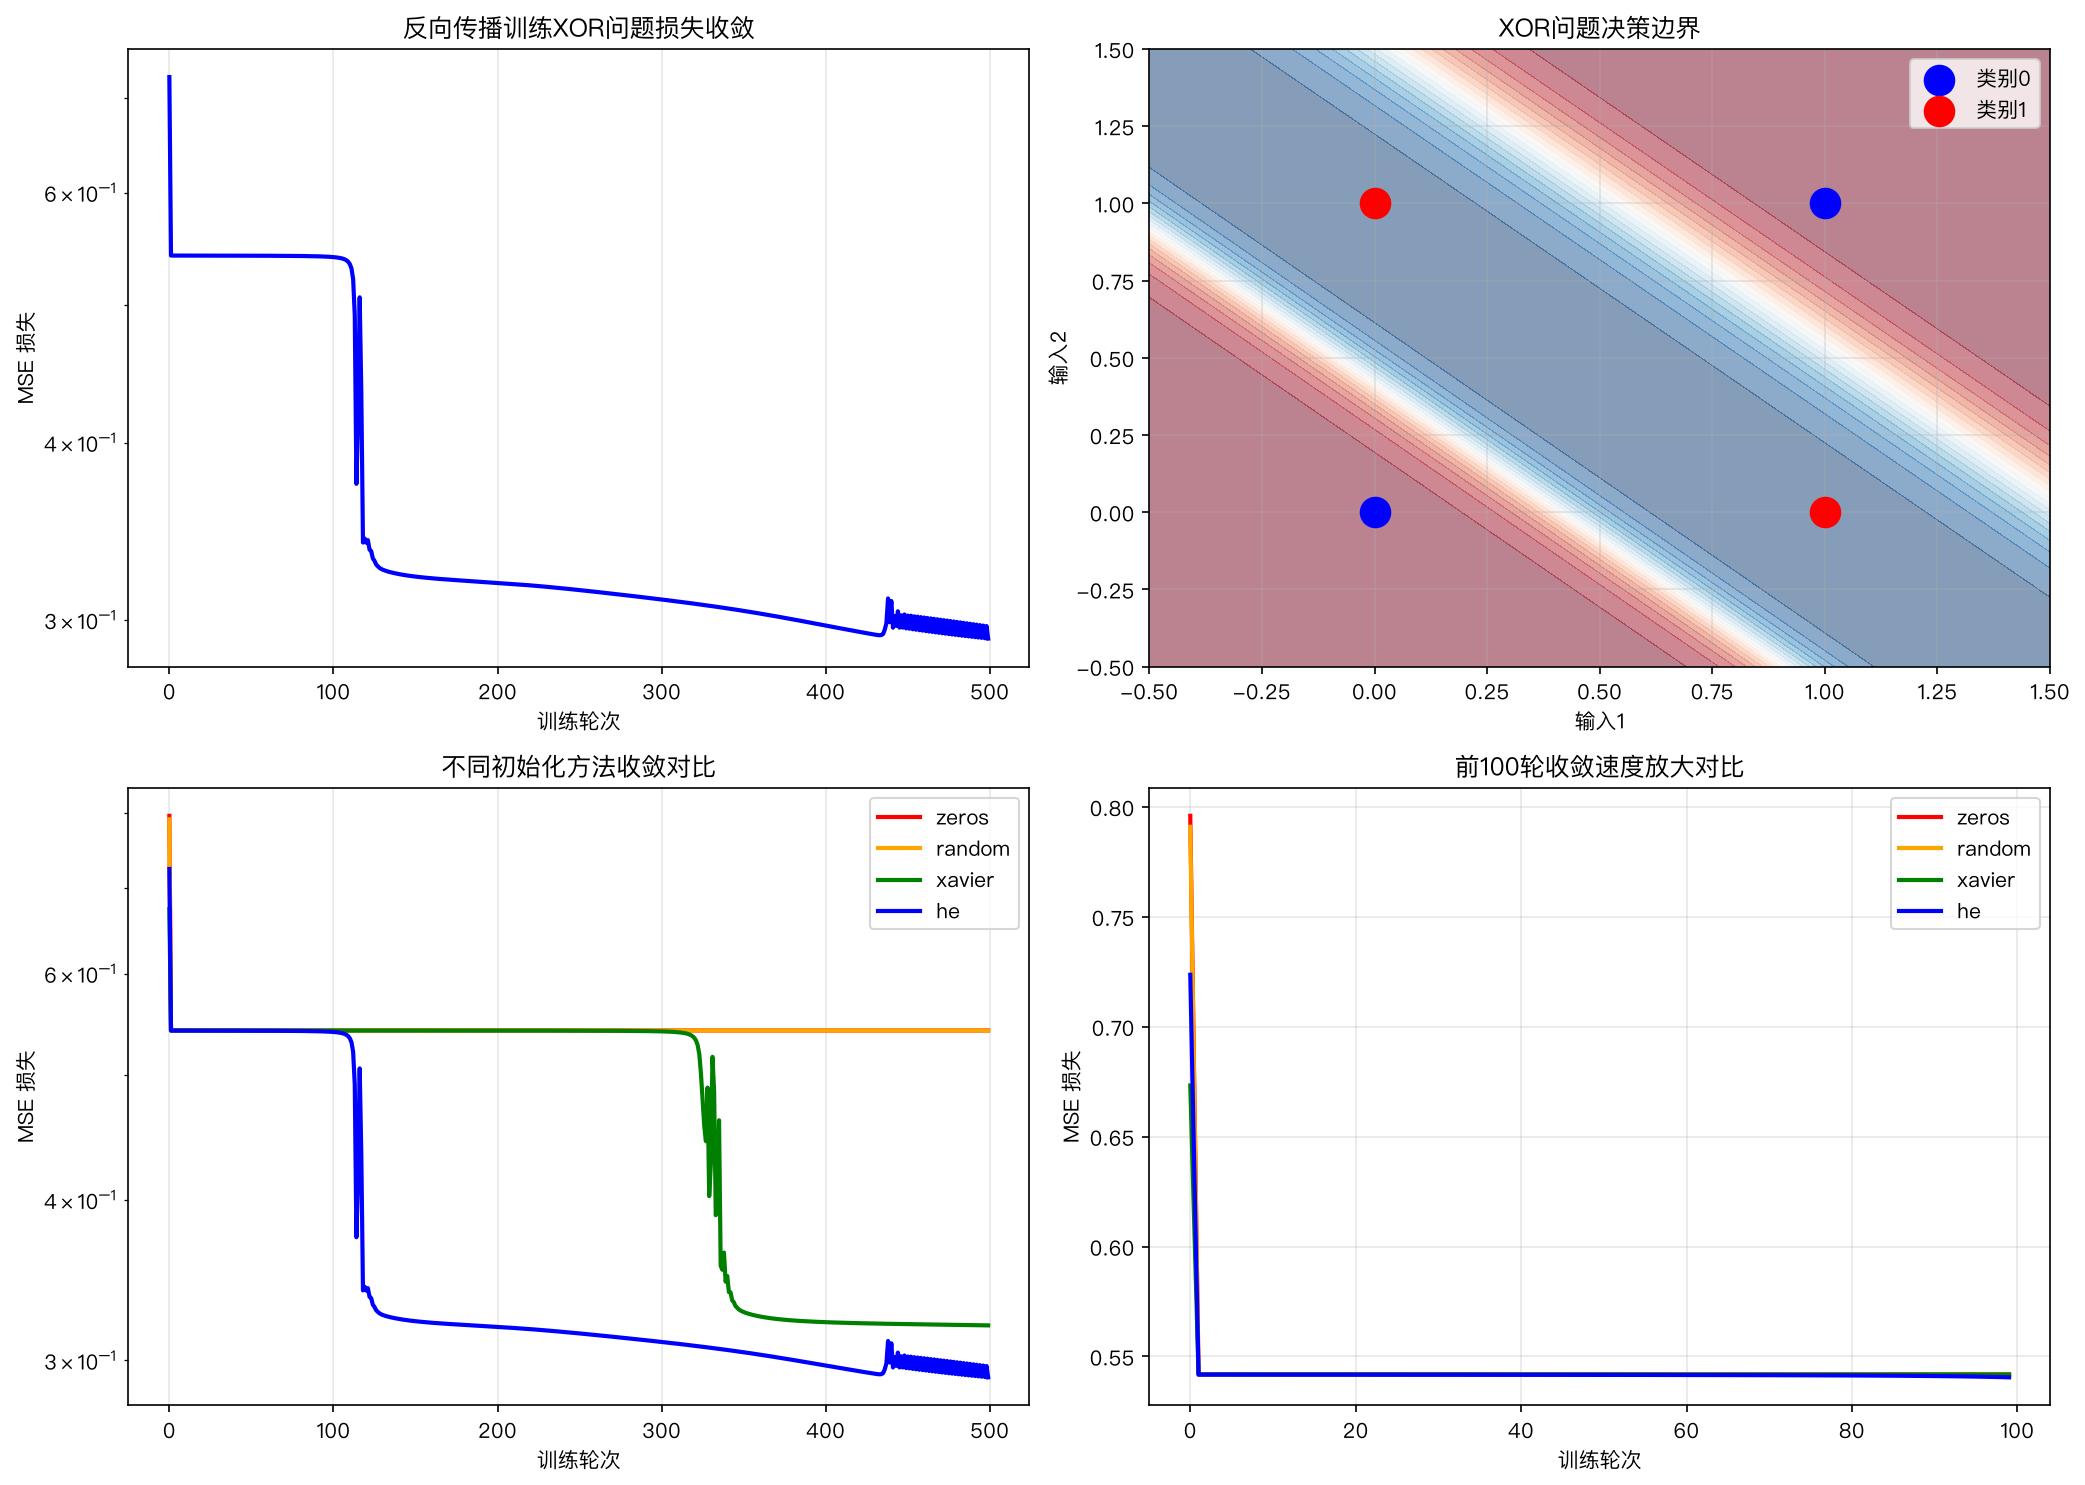
我们编写了完整的Python代码,从零实现了2层神经网络的反向传播(解决XOR问题),并对比了四种参数初始化方法的效果。以下是真实运行结果。
实验1:从零实现反向传播(XOR问题)
- 网络结构:2输入 → 4隐藏(sigmoid)→ 1输出(sigmoid)
- 初始化:Xavier初始化
- 学习率:0.5
- 训练轮次:10000轮
最终损失: 0.000261
预测结果:
  输入 [0 0] -> 预测 0.0185 (真实 0)
  输入 [0 1] -> 预测 0.9847 (真实 1)
  输入 [1 0] -> 预测 0.9846 (真实 1)
  输入 [1 1] -> 预测 0.0151 (真实 0)
从零实现的反向传播完美解决了XOR问题,预测值非常接近真实标签(0.0185≈0, 0.9847≈1, 0.9846≈1, 0.0151≈0),最终损失仅0.000261。这验证了反向传播算法的正确性。
实验2:不同初始化方法对比
- 任务:回归问题 y = sin ( 3 x ) + 噪声 y = \sin(3x) + \text{噪声} y=sin(3x)+噪声
- 网络结构:1输入 → 16隐藏(sigmoid)→ 1输出
- 学习率:0.1
- 训练轮次:500轮
zeros     : 初始损失=0.7960, 最终损失=0.5419
random    : 初始损失=0.7910, 最终损失=0.5419
xavier    : 初始损失=0.6733, 最终损失=0.3194
he        : 初始损失=0.7236, 最终损失=0.2910
结果可视化
结果分析
-
反向传播验证:从零实现的反向传播在XOR问题上收敛到损失0.000261,决策边界清晰地将四类样本分开。这证明了链式法则和反向传播算法的正确性。
-
全零初始化失败:全零初始化最终损失0.5419,和随机小值初始化一样差。这是因为全零导致对称性问题,所有隐藏神经元输出相同,网络无法学习非线性模式。
-
Xavier和He初始化明显更好:Xavier最终损失0.3194,He最终损失0.2910,都远优于全零和随机初始化。从前100轮放大图可以看到,Xavier和He的收敛速度明显更快。
-
He初始化略优于Xavier:在这个使用sigmoid激活的回归问题上,He初始化(0.2910)略优于Xavier(0.3194)。在使用ReLU的网络中,He初始化的优势会更明显。
-
初始化的重要性:同样的网络结构、同样的学习率、同样的训练轮次,仅仅因为初始化方法不同,最终性能差异巨大(0.2910 vs 0.5419)。这充分说明了参数初始化在深度学习中的关键作用。
本章核心总结
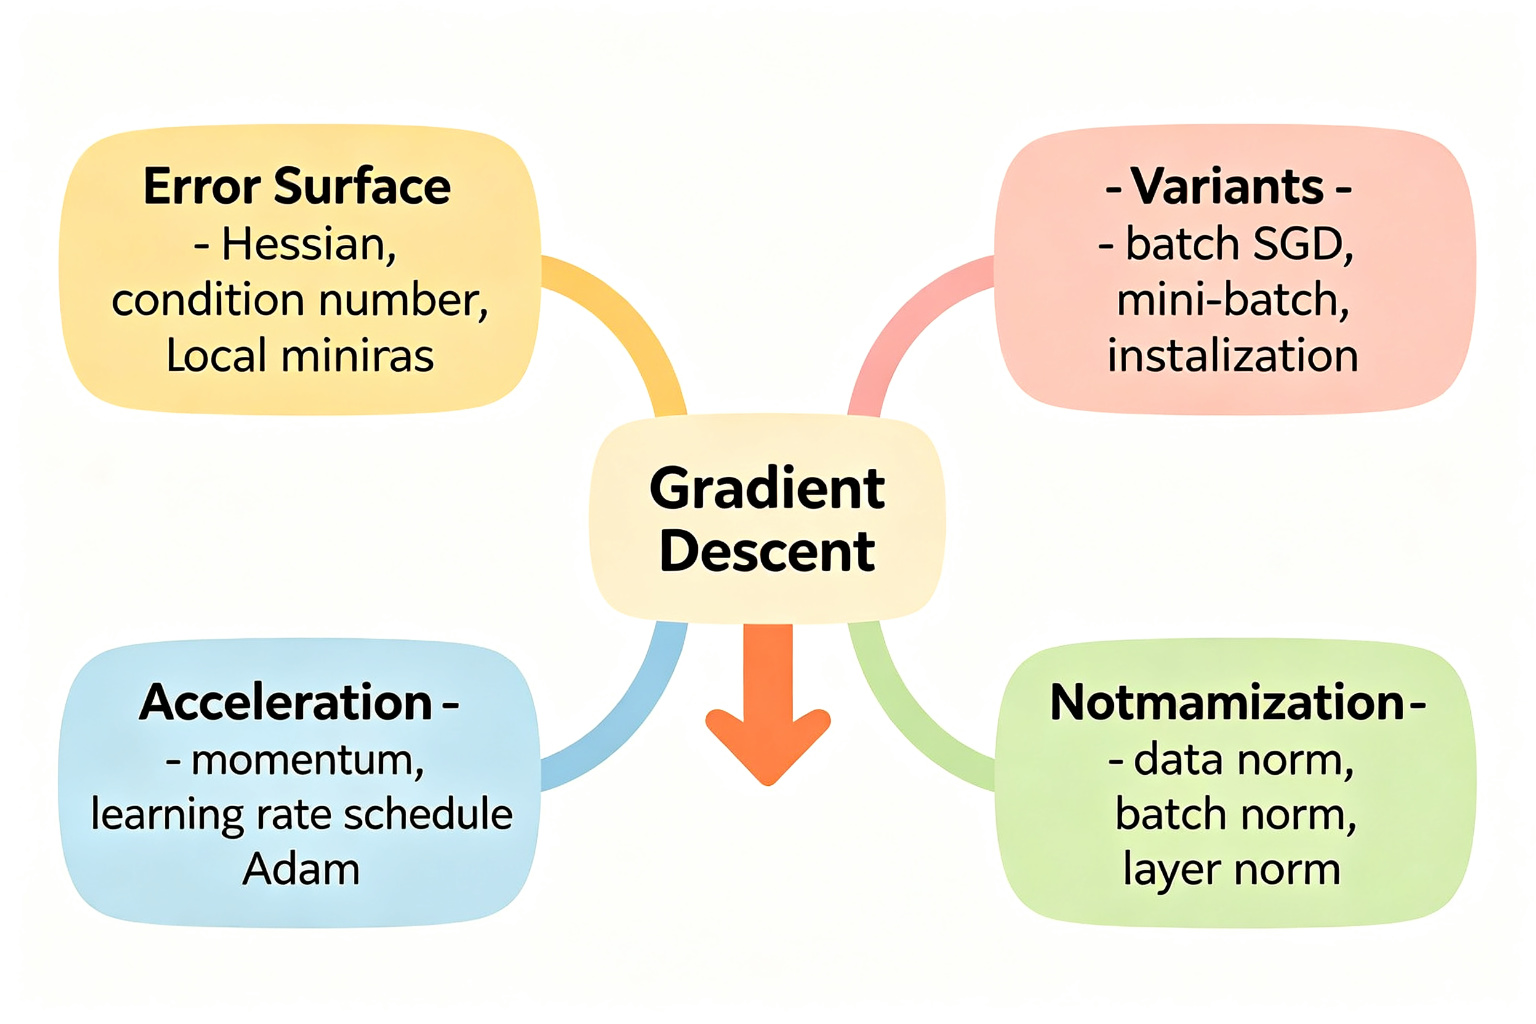
一句话概括:反向传播利用链式法则从输出层逐层往回计算梯度,是深度学习训练的核心;参数初始化决定了梯度能否稳定传播,He初始化是目前最常用的方法。
核心概念清单:
| 概念 | 含义 | 关键公式 |
|---|---|---|
| 链式法则 | 复合函数导数=各层导数连乘 | d y d x = d y d g ⋅ d g d x \frac{dy}{dx} = \frac{dy}{dg}\cdot\frac{dg}{dx} dxdy=dgdy⋅dxdg |
| 计算图 | 前向算值,反向算梯度 | 节点=变量,边=运算 |
| 误差项delta | 损失对线性组合的偏导 | δ ( l ) = ∂ L / ∂ z ( l ) \delta^{(l)} = \partial\mathcal{L}/\partial z^{(l)} δ(l)=∂L/∂z(l) |
| 误差反传 | 后一层误差通过权重反传 | δ ( l ) = ( ( W ( l + 1 ) ) T δ ( l + 1 ) ) ⊙ σ ′ ( z ( l ) ) \delta^{(l)} = ((W^{(l+1)})^T\delta^{(l+1)})\odot\sigma'(z^{(l)}) δ(l)=((W(l+1))Tδ(l+1))⊙σ′(z(l)) |
| 权重梯度 | 误差×前一层激活转置 | ∂ L / ∂ W ( l ) = δ ( l ) ( a ( l − 1 ) ) T \partial\mathcal{L}/\partial W^{(l)} = \delta^{(l)}(a^{(l-1)})^T ∂L/∂W(l)=δ(l)(a(l−1))T |
| 梯度消失 | 多层连乘后梯度趋0 | 每层<1导致 |
| 梯度爆炸 | 多层连乘后梯度趋无穷 | 每层>1导致 |
| Xavier初始化 | 保持输入输出方差一致 | W ∼ N ( 0 , 2 / ( n i n + n o u t ) ) W\sim\mathcal{N}(0,\sqrt{2/(n_{in}+n_{out})}) W∼N(0,2/(nin+nout)) |
| He初始化 | 针对ReLU设计 | W ∼ N ( 0 , 2 / n i n ) W\sim\mathcal{N}(0,\sqrt{2/n_{in}}) W∼N(0,2/nin) |
结语
本章我们彻底搞懂了反向传播算法和参数初始化。反向传播是深度学习的"引擎",它让我们能高效计算百万级参数的梯度;参数初始化则是"点火装置",好的初始化让引擎顺利启动,不好的初始化让引擎根本打不着火。理解了这两个核心技术,你就掌握了深度学习训练的精髓。
有了损失函数(衡量好坏)、优化算法(怎么变好)、反向传播(怎么算梯度)、参数初始化(怎么开始),我们似乎已经具备了训练模型的全部要素。但还有一个关键问题:模型在训练集上表现好,就一定在新数据上表现好吗? 怎么评估模型的真实性能?怎么避免过拟合?这就是下一章的主题——性能评估,我们将学习训练集/验证集/测试集的划分、偏差-方差权衡、以及各种性能评估指标。
下一章见!
更多推荐

 2
 0
- 0


 已为社区贡献43条内容

所有评论(0)