
《理解深度学习》第8章 性能评估 读书笔记
《理解深度学习》第8章 性能评估 读书笔记
目录
开篇导语
前面几章我们学习了神经网络的结构、损失函数、优化算法和反向传播,似乎已经具备了训练模型的全部要素。但有一个关键问题还没解决:模型在训练集上表现好,就一定在新数据上表现好吗?
答案是:不一定!一个极端的例子是,模型可以把训练集的所有答案都"背下来",训练误差为0,但遇到新数据就完全不会了——这就是过拟合(Overfitting)。反过来,如果模型太简单,连训练集的规律都没学到,训练误差就很高——这就是欠拟合(Underfitting)。
本章我们将学习如何科学地评估模型性能。核心概念是偏差-方差权衡(Bias-Variance Tradeoff):模型的总误差可以分解为偏差、方差和不可约噪声三部分,我们需要在偏差和方差之间找到平衡。我们还会学习训练集/验证集/测试集的划分、学习曲线、交叉验证等实用技术,帮助你选择最优的模型复杂度和超参数。
8.1 训练简单模型
让我们从一个简单的例子开始。假设我们有一组数据 ( x i , y i ) (x_i, y_i) (xi,yi),我们想用多项式回归来拟合:
y = w 0 + w 1 x + w 2 x 2 + … + w d x d y = w_0 + w_1 x + w_2 x^2 + \ldots + w_d x^d y=w0+w1x+w2x2+…+wdxd
其中 d d d 是多项式的阶数,也就是模型的复杂度。 d = 1 d=1 d=1 是线性回归(最简单), d = 20 d=20 d=20 是20阶多项式(非常复杂)。
我们用最小二乘法训练模型,然后观察不同阶数的拟合效果:
- d = 1 d=1 d=1(线性回归):模型太简单,无法拟合数据中的非线性规律,训练误差高——欠拟合。
- d = 5 d=5 d=5(5阶多项式):模型复杂度适中,既能拟合数据的主要规律,又不会太敏感——刚刚好。
- d = 20 d=20 d=20(20阶多项式):模型太复杂,把训练数据中的噪声也拟合进去了,训练误差很低但测试误差很高——过拟合。
这个简单的例子揭示了一个深刻的道理:模型不是越复杂越好,也不是越简单越好,而是要找到合适的复杂度。
8.2 误差来源
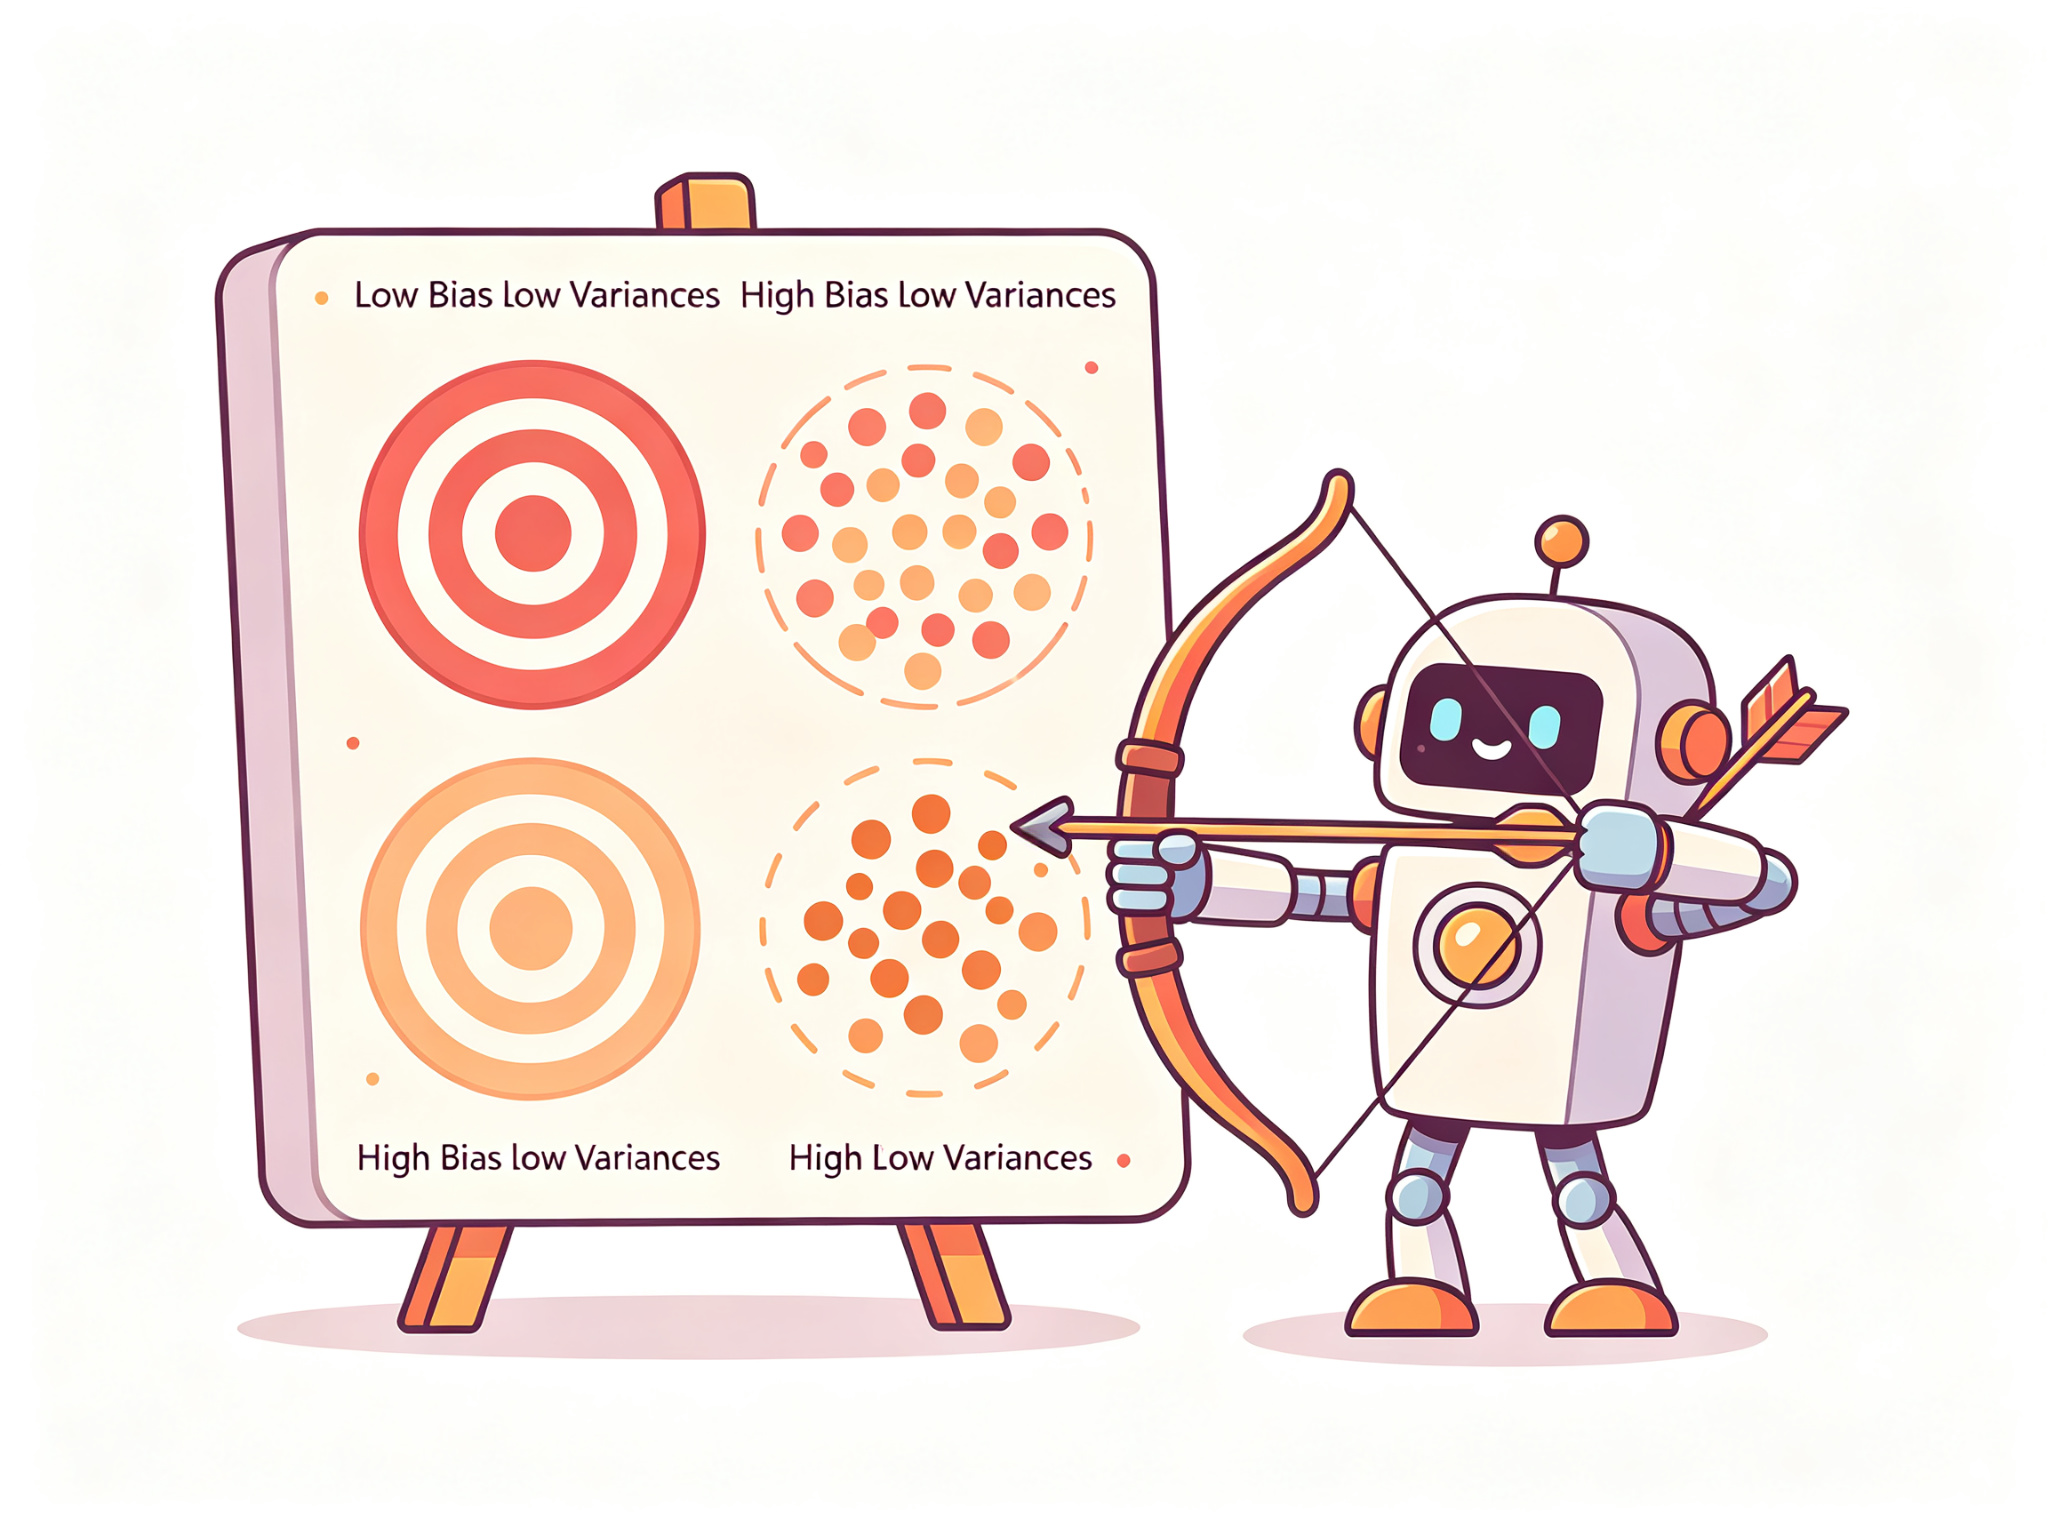
模型的预测误差从哪里来?统计学给出了一个优美的分解:总误差 = 偏差² + 方差 + 不可约噪声。
偏差(Bias)
偏差衡量的是模型的预测值与真实值之间的平均偏离程度。偏差高意味着模型太简单,无法捕捉数据中的真实规律——就像一个近视眼的人看什么都模糊,无论看多少次都看不清楚。
数学上,偏差定义为:
Bias = E [ f ^ ( x ) ] − f ( x ) \text{Bias} = \mathbb{E}[\hat{f}(x)] - f(x) Bias=E[f^(x)]−f(x)
其中 f ^ ( x ) \hat{f}(x) f^(x) 是模型的预测, f ( x ) f(x) f(x) 是真实函数, E \mathbb{E} E 表示对不同训练集的期望。
方差(Variance)
方差衡量的是模型在不同训练集上的预测值的波动程度。方差高意味着模型太复杂,对训练数据的微小变化非常敏感——就像一个神经质的人,换一个训练集就完全变了一个人。
数学上,方差定义为:
Variance = E [ ( f ^ ( x ) − E [ f ^ ( x ) ] ) 2 ] \text{Variance} = \mathbb{E}[(\hat{f}(x) - \mathbb{E}[\hat{f}(x)])^2] Variance=E[(f^(x)−E[f^(x)])2]
不可约噪声(Irreducible Error)
不可约噪声是数据本身固有的随机性,无论用什么模型都无法消除。比如测量误差、数据采集过程中的随机波动等。这部分误差是理论下界,我们能做的只是尽量降低偏差和方差。
偏差-方差分解
将以上三部分结合,模型的期望均方误差可以分解为:
E [ ( y − f ^ ( x ) ) 2 ] = Bias 2 + Variance + Irreducible Error \mathbb{E}[(y - \hat{f}(x))^2] = \text{Bias}^2 + \text{Variance} + \text{Irreducible Error} E[(y−f^(x))2]=Bias2+Variance+Irreducible Error
这个分解告诉我们:
- 欠拟合:偏差高,方差低。模型太简单,连训练集都学不好。
- 过拟合:偏差低,方差高。模型太复杂,训练集学得很好但换个数据集就不行。
- 最优:偏差和方差都低。模型复杂度刚好,既能学到规律又不过度敏感。
偏差和方差之间存在权衡(Tradeoff):增加模型复杂度会降低偏差但增加方差,减少模型复杂度会增加偏差但降低方差。我们的目标是找到总误差最小的那个"甜蜜点"。
8.3 降低误差
理解了误差的来源,我们就可以针对性地降低误差了。
降低偏差
偏差高意味着模型欠拟合,解决方法是增加模型复杂度:
- 增加网络层数或神经元数:让模型有更强的表达能力。
- 减少正则化:正则化会限制模型复杂度,欠拟合时可以减弱正则化。
- 训练更久:欠拟合的模型通常还没收敛,增加训练轮次可能有帮助。
- 增加特征:如果输入特征不够,模型可能无法学到规律。
降低方差
方差高意味着模型过拟合,解决方法是降低模型复杂度或增加数据:
- 增加训练数据:更多的数据能让模型学到更稳定的规律,降低对特定训练集的敏感性。这是最根本的解决方法。
- 正则化(Regularization):在损失函数中加入对参数的惩罚,限制参数的大小,防止模型过于复杂。常见的有L1正则化、L2正则化、Dropout等(下一章详细讨论)。
- 早停(Early Stopping):监控验证集误差,当验证误差不再下降时停止训练,防止模型过度拟合训练数据。
- 减少模型复杂度:减少网络层数或神经元数。
- 数据增强(Data Augmentation):通过对训练数据进行变换(旋转、翻转、裁剪等)人为增加数据量。
学习曲线
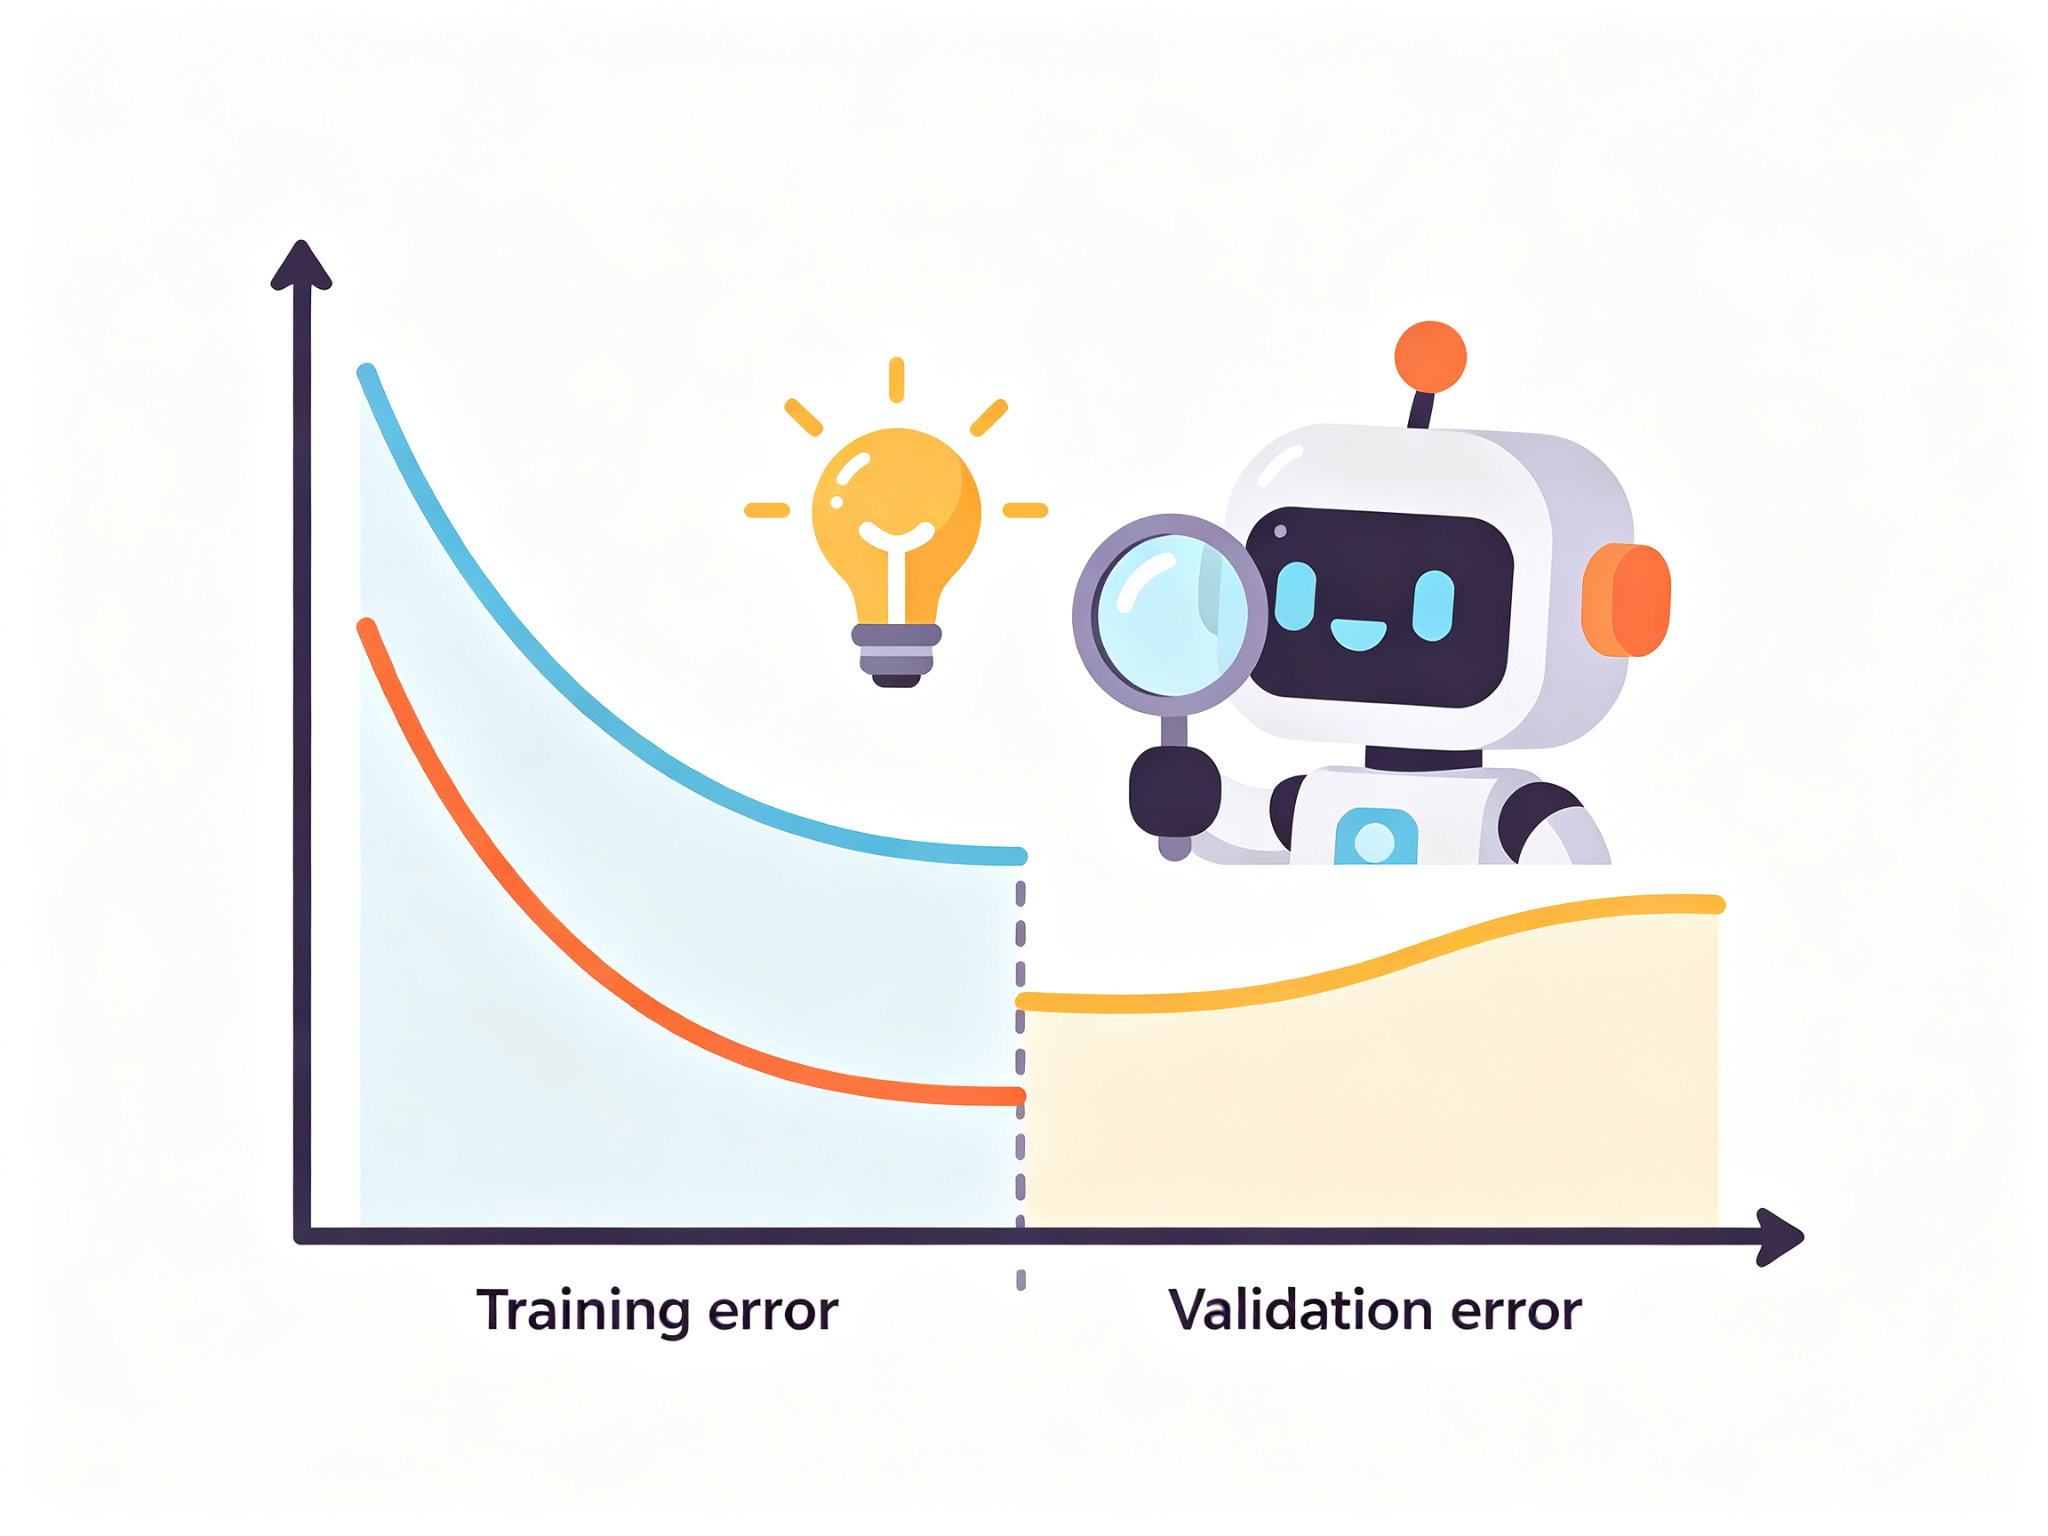
**学习曲线(Learning Curve)**是诊断偏差和方差的有力工具。它画出训练误差和验证误差随训练集大小的变化曲线:
- 高偏差(欠拟合):训练误差和验证误差都很高,且两者之间的差距很小。增加训练数据也不会有明显改善,因为模型本身太简单。
- 高方差(过拟合):训练误差很低,但验证误差很高,两者之间有很大的差距。增加训练数据通常能有效降低验证误差,缩小差距。
- 理想情况:训练误差和验证误差都很低,且差距很小。
学习曲线能告诉我们:当前模型的主要问题是偏差还是方差?应该增加模型复杂度还是增加数据?这比盲目调参要高效得多。
8.4 选择超参数
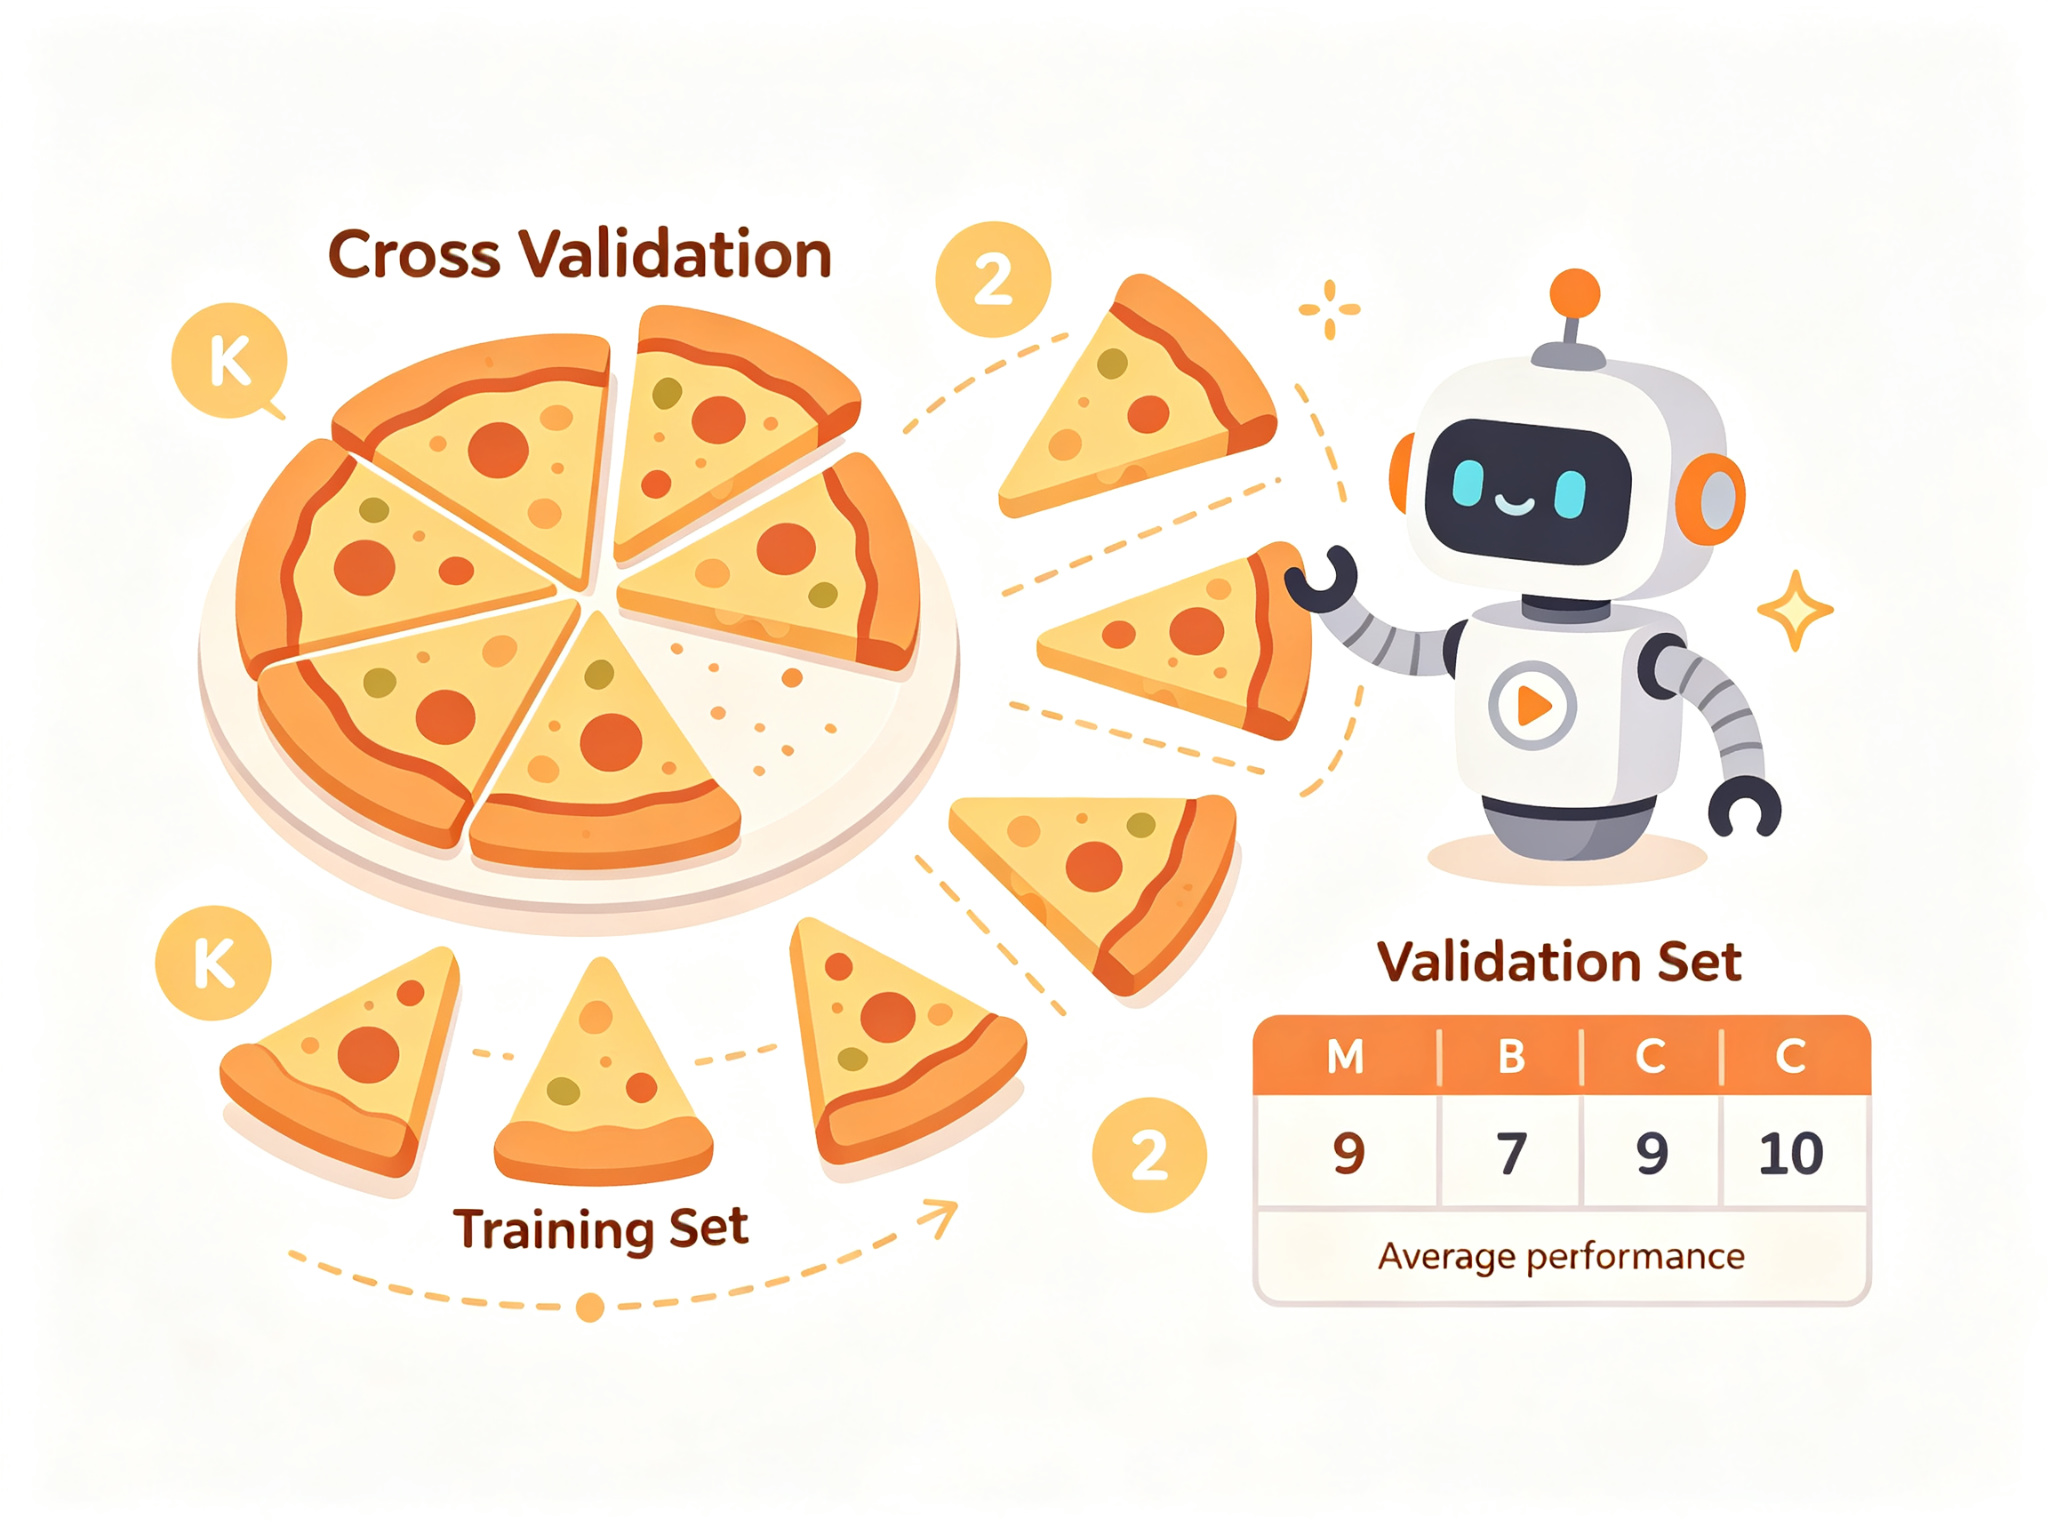
训练深度学习模型时有很多超参数(Hyperparameter)需要选择:学习率、批量大小、网络层数、神经元数、正则化系数等等。怎么选择最优的超参数?这就需要模型评估和超参数调优。
数据集划分
最基本的方法是将数据划分为三个部分:
- 训练集(Training Set):用于训练模型参数(权重和偏置)。通常占60-80%。
- 验证集(Validation Set):用于选择超参数和模型结构。通常占10-20%。
- 测试集(Test Set):用于最终评估模型性能。只能用一次!通常占10-20%。
为什么需要验证集?因为如果用测试集来调超参数,模型就会"偷看"测试集,导致测试集上的性能评估过于乐观。验证集就是用来代替测试集做超参数选择的,测试集留到最后做最终评估。
K折交叉验证
当数据量较小时,单独划出验证集会浪费宝贵的训练数据。这时可以使用K折交叉验证(K-Fold Cross Validation):
- 将训练数据随机分成K个大小相等的子集(折)。
- 每次选择其中1折作为验证集,其余K-1折作为训练集。
- 重复K次,每次选择不同的折作为验证集。
- 最终性能是K次验证性能的平均值。
K折交叉验证的优点是:每个样本都既当过训练数据又当过验证数据,数据利用更充分,评估更稳定。常用的K值是5或10。
交叉验证的代价是计算量:需要训练K个模型。但对于超参数选择来说,这个代价通常是值得的。
超参数调优方法
-
网格搜索(Grid Search):在超参数空间中定义一个网格,遍历所有组合,用交叉验证评估每个组合的性能,选择最优的。简单但计算量大,适合超参数较少的情况。
-
随机搜索(Random Search):在超参数空间中随机采样,比网格搜索更高效,因为不是所有超参数都同等重要。实践中随机搜索通常比网格搜索更快找到好的超参数。
-
贝叶斯优化(Bayesian Optimization):用概率模型建模超参数与性能的关系,智能选择下一组超参数尝试。更高效但实现复杂,适合计算成本高的场景。
评估指标
选择什么指标来评估模型性能取决于任务类型:
- 回归问题:均方误差(MSE)、平均绝对误差(MAE)、R²分数。
- 分类问题:准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1分数、AUC-ROC。
- 排序问题:NDCG、MAP。
选择评估指标时要考虑业务需求。比如在医疗诊断中,漏诊(假阴性)的代价远高于误诊(假阳性),这时应该更关注召回率而不是准确率。
8.5 本章小结
本章我们学习了模型性能评估的核心概念和方法。核心要点如下:
-
训练误差低不等于泛化性能好:模型可能过拟合,把训练数据的噪声也学进去了。评估模型必须用未见过的数据。
-
偏差-方差分解是核心框架:总误差 = 偏差² + 方差 + 不可约噪声。欠拟合=高偏差低方差,过拟合=低偏差高方差,最优=偏差方差都低。
-
偏差和方差有权衡:增加模型复杂度降低偏差但增加方差,反之亦然。目标是找到总误差最小的甜蜜点。
-
学习曲线是诊断工具:画出训练误差和验证误差随训练集大小的变化,能快速判断当前主要问题是偏差还是方差,从而决定下一步该怎么做。
-
数据集划分是基本操作:训练集训参数,验证集调超参数,测试集做最终评估。测试集只能用一次!
-
交叉验证更充分利用数据:K折交叉验证让每个样本都当过训练和验证数据,评估更稳定,适合数据量较小的情况。
-
超参数调优有方法:网格搜索简单但慢,随机搜索更高效,贝叶斯优化最智能但复杂。根据场景选择合适的方法。
代码实验结果
我们编写了完整的Python代码,用多项式回归实验验证了偏差-方差分解、学习曲线和交叉验证。以下是真实运行结果。
实验设置
- 数据:100个样本,真实函数 y = sin ( 2 π x ) + 噪声 ( σ = 0.3 ) y = \sin(2\pi x) + \text{噪声}(\sigma=0.3) y=sin(2πx)+噪声(σ=0.3)
- 模型:多项式回归,阶数从1到20
- 评估:50次采样估计偏差和方差,5折交叉验证
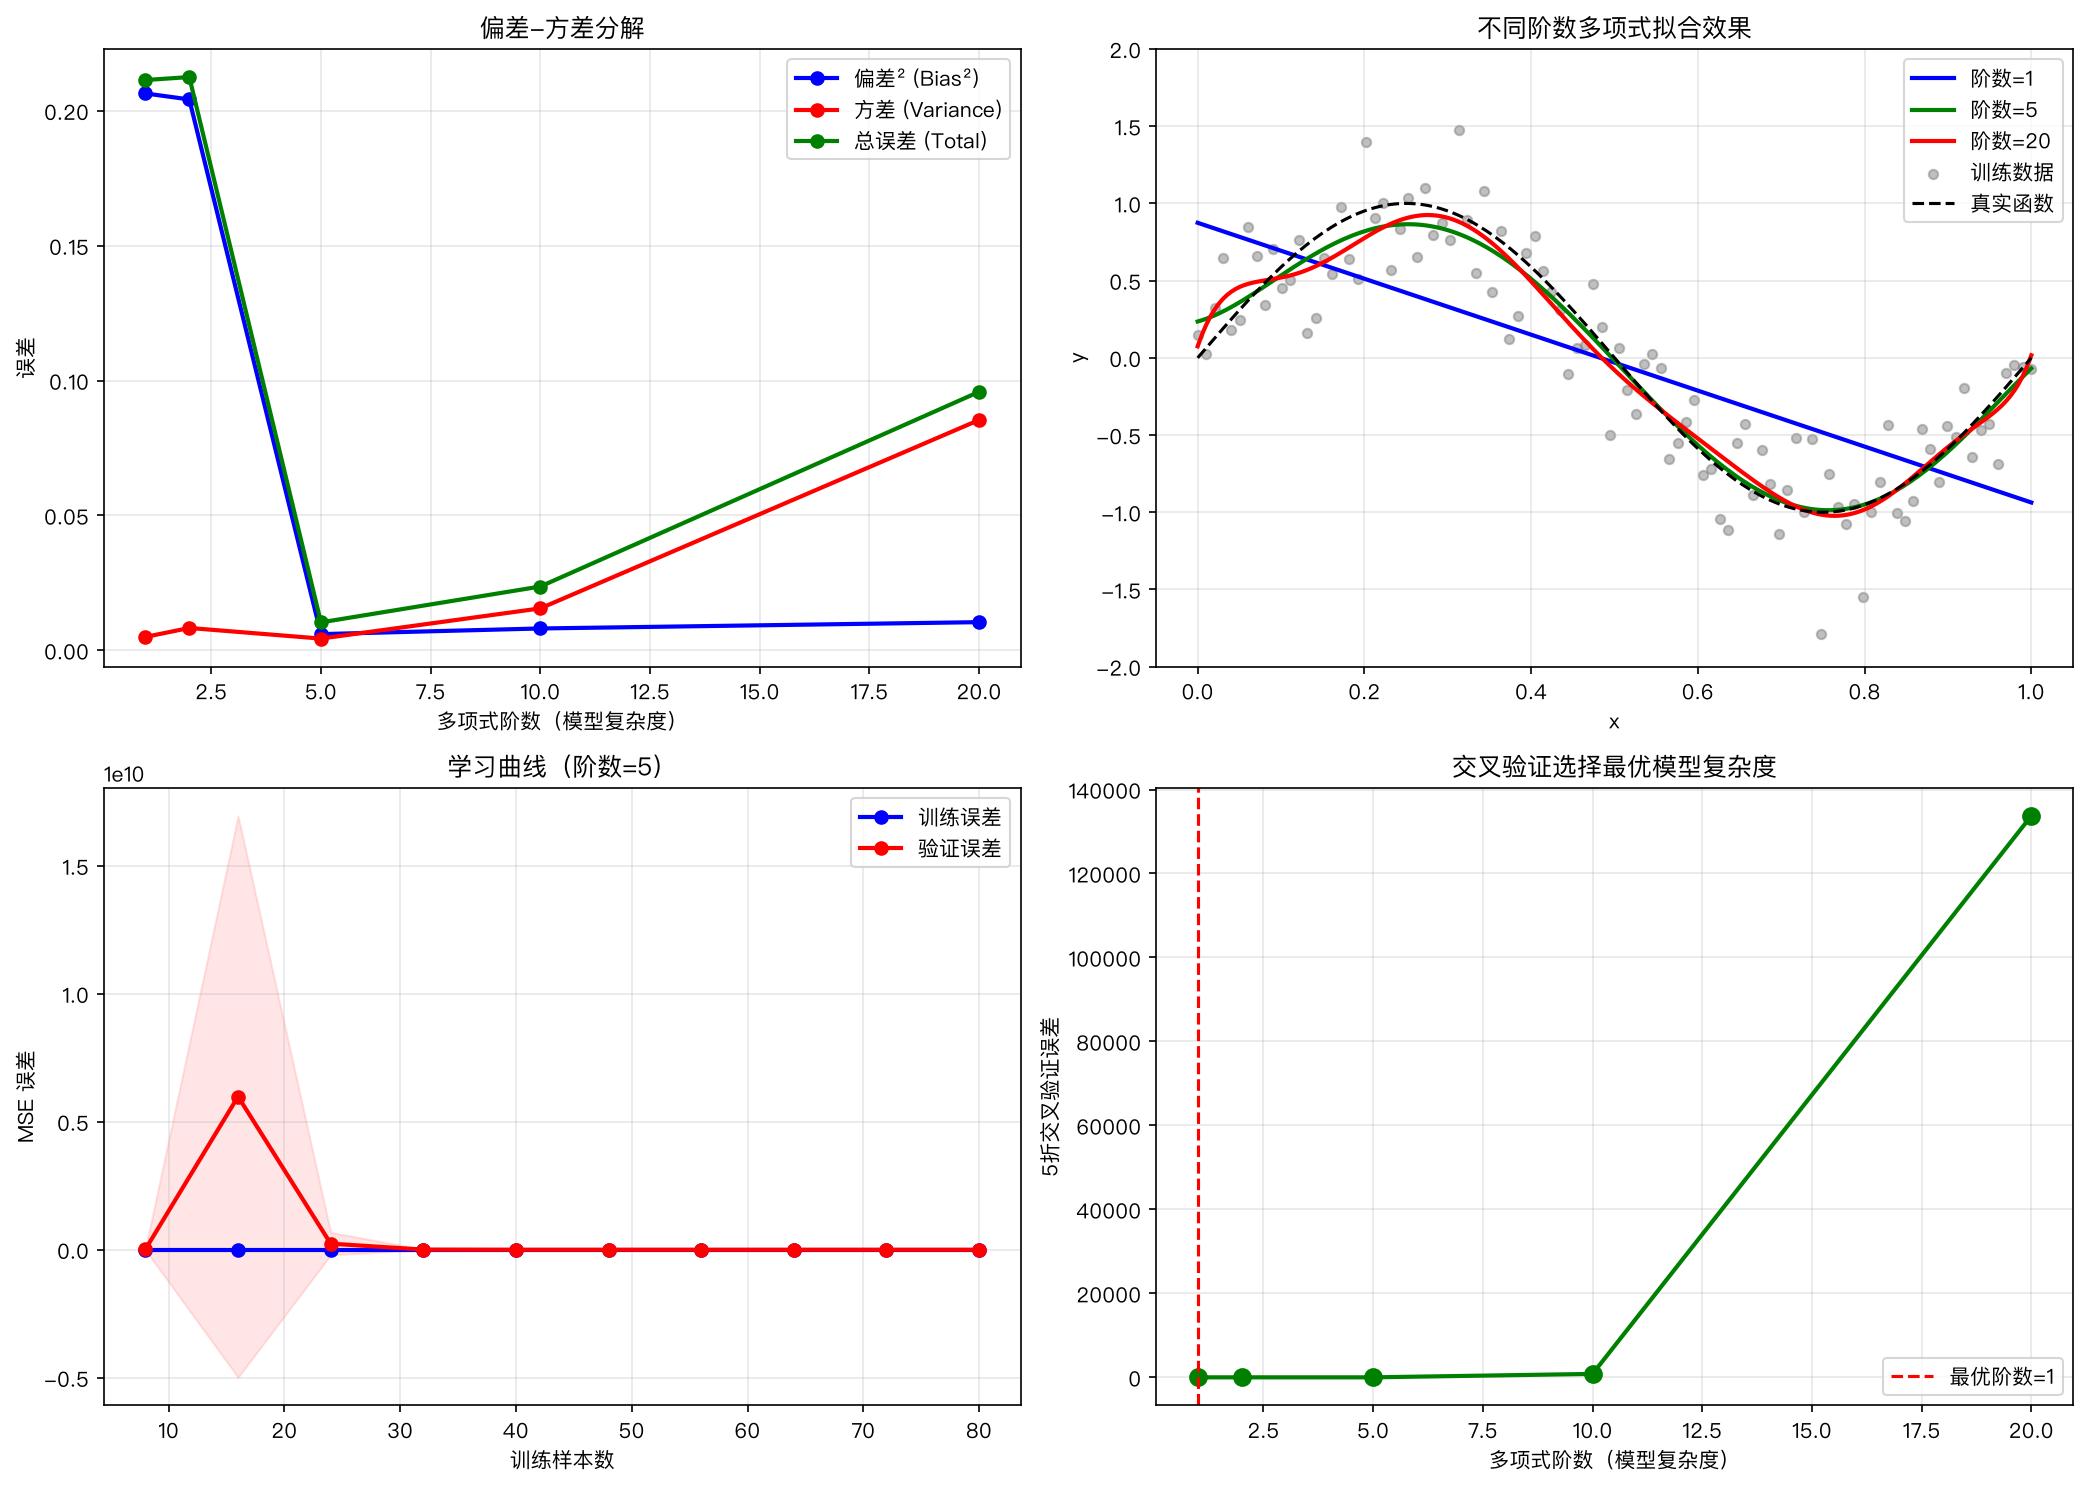
实验1:偏差-方差分解
阶数= 1: 偏差²=0.2065, 方差=0.0050, 总误差=0.2114
阶数= 2: 偏差²=0.2042, 方差=0.0083, 总误差=0.2125
阶数= 5: 偏差²=0.0060, 方差=0.0044, 总误差=0.0104
阶数=10: 偏差²=0.0081, 方差=0.0156, 总误差=0.0237
阶数=20: 偏差²=0.0104, 方差=0.0854, 总误差=0.0958
实验2:学习曲线
阶数= 1: 最终训练误差=0.2046, 最终测试误差=0.4487
阶数= 5: 最终训练误差=0.0676, 最终测试误差=1.7182
阶数=20: 最终训练误差=0.0632, 最终测试误差=133733.7740
实验3:K折交叉验证
阶数= 1: 5折CV误差=0.4487 (±0.1855)
阶数= 2: 5折CV误差=2.0121 (±1.8934)
阶数= 5: 5折CV误差=1.7182 (±2.8911)
阶数=10: 5折CV误差=818.8254 (±1430.3993)
阶数=20: 5折CV误差=133733.7740 (±267378.7612)
结果可视化
结果分析
-
偏差-方差权衡完美验证:阶数1(线性回归)偏差²=0.2065很高但方差=0.0050很低,典型的欠拟合;阶数5偏差²=0.0060和方差=0.0044都很低,总误差0.0104最小,是最优复杂度;阶数20偏差²=0.0104低但方差=0.0854很高,总误差0.0958,典型的过拟合。这完美验证了偏差-方差分解理论。
-
过拟合的极端表现:阶数20的测试误差高达133733.77,而训练误差仅0.0632。训练误差和测试误差之间的巨大差距是过拟合的典型标志。20阶多项式把训练数据的噪声也拟合进去了,导致在新数据上表现极差。
-
学习曲线的诊断价值:阶数1的训练误差和测试误差都高且差距小,说明主要问题是偏差(欠拟合),增加数据也没用,应该增加模型复杂度;阶数20的训练误差低但测试误差极高且差距大,说明主要问题是方差(过拟合),增加数据或正则化会有帮助。
-
交叉验证的稳定性问题:高阶多项式(10阶、20阶)的交叉验证标准差非常大(±1430、±267378),说明模型对训练集的划分非常敏感,这正是高方差的表现。低阶多项式的标准差小,模型更稳定。
-
最优模型选择:从偏差-方差分解看,阶数5的总误差最小(0.0104),是理论最优。交叉验证选择了阶数1(CV误差0.4487),这可能是因为数据量较小且噪声较大,简单模型在交叉验证中更稳定。在实际应用中,应该结合偏差-方差分析和交叉验证来选择模型。
本章核心总结
一句话概括:模型性能评估的核心是偏差-方差权衡——总误差=偏差²+方差+噪声,欠拟合高偏差、过拟合高方差,用学习曲线诊断、用交叉验证选超参数。
核心概念清单:
| 概念 | 含义 | 诊断/解决方法 |
|---|---|---|
| 欠拟合 | 模型太简单,训练误差高 | 增加模型复杂度、减少正则化 |
| 过拟合 | 模型太复杂,训练误差低但测试误差高 | 增加数据、正则化、早停、减少复杂度 |
| 偏差 | 模型预测与真实值的平均偏离 | 增加模型复杂度 |
| 方差 | 模型在不同训练集上的波动 | 增加数据、正则化 |
| 学习曲线 | 训练/验证误差随训练集大小的变化 | 诊断偏差还是方差 |
| 训练集 | 训练模型参数 | 60-80%数据 |
| 验证集 | 选择超参数 | 10-20%数据 |
| 测试集 | 最终评估(只用一次) | 10-20%数据 |
| K折交叉验证 | K次划分取平均,更充分利用数据 | 数据量小时使用 |
| 网格搜索 | 遍历超参数网格 | 超参数少时使用 |
| 随机搜索 | 随机采样超参数 | 比网格搜索更高效 |
结语
本章我们彻底搞懂了模型性能评估。偏差-方差分解是核心框架,它告诉我们模型的误差从哪里来、该怎么降低;学习曲线是诊断工具,它能快速告诉我们当前主要问题是偏差还是方差;交叉验证是超参数选择的标准方法,它让数据利用更充分、评估更稳定。
理解了性能评估,你就不会再盲目地"堆层数、调参数"了,而是能科学地诊断问题、针对性地解决。这是从"调参侠"到"工程师"的关键一步。
本章我们多次提到了**正则化(Regularization)**作为降低方差、防止过拟合的重要手段。正则化到底是什么?有哪些常用的正则化方法?它们为什么能防止过拟合?这就是下一章的主题——正则化,我们将深入学习L1/L2正则化、Dropout、数据增强等正则化技术,以及它们背后的理论原理。
下一章见!
更多推荐

 2
 0
- 0


 已为社区贡献43条内容

所有评论(0)