
《理解深度学习》第17章 变分自编码器 读书笔记
《理解深度学习》第17章 变分自编码器 读书笔记
目录
- 17.1 隐变量模型
- 17.2 非线性隐变量模型
- 17.3 训练
- 17.4 ELBO的性质
- 17.5 变分近似
- 17.6 变分自编码器
- 17.7 重参数化技巧
- 17.8 应用
- 17.9 本章小结
- 代码实验结果
- 本章核心总结
- 结语
开篇导语
前面两章我们学习了GAN和标准化流两种生成模型。GAN训练不稳定、没有显式似然;标准化流需要可逆变换、对网络架构有限制。本章我们学习第三种生成模型——变分自编码器(Variational Autoencoder,VAE)。
VAE的核心思想是隐变量模型(Latent Variable Model):假设观测数据是由一些未观测到的隐变量生成的。例如,一张人脸图像可能由"是否微笑"、“年龄”、“性别”、"发型"等隐变量决定。VAE通过学习这些隐变量的分布,既能生成新数据,又能学习有意义的表示。
VAE的名字来源于两个部分:"变分"指的是用变分推断(Variational Inference)来近似难以计算的后验分布;"自编码器"指的是网络架构像自编码器一样,有编码器(将数据压缩到隐空间)和解码器(从隐空间重建数据)。
VAE的优势是训练稳定(有明确的优化目标ELBO)、隐空间结构良好(适合插值和属性编辑)、能学习解耦表示。VAE是深度学习中最重要的生成模型之一,在表示学习、图像生成、异常检测等领域有广泛应用。
17.1 隐变量模型
什么是隐变量模型
隐变量模型(Latent Variable Model) 假设观测数据 x x x 是由一些未观测到的隐变量 z z z 生成的。隐变量代表数据中未直接观测但对生成数据有影响的因素。
例如,对于人脸图像:
- 观测数据 x x x:像素值
- 隐变量 z z z:可能包括身份、表情、姿态、光照、年龄、性别等
隐变量模型的生成过程:
- 从先验分布 p ( z ) p(z) p(z) 中采样隐变量 z z z
- 从条件分布 p ( x ∣ z ) p(x|z) p(x∣z) 中采样观测数据 x x x
数据的边缘似然为:
p ( x ) = ∫ p ( x ∣ z ) p ( z ) d z p(x) = \int p(x|z) p(z) dz p(x)=∫p(x∣z)p(z)dz
这个积分通常是不可计算的(intractable),因为隐空间维度很高,积分没有解析解。
隐变量模型的优势
- 数据压缩:将高维数据压缩到低维隐空间,去除冗余信息。
- 表示学习:学习数据的有意义表示,隐变量可能对应数据的语义因素。
- 生成建模:从先验分布采样隐变量,再通过解码器生成新数据。
- 缺失数据处理:隐变量模型可以自然地处理缺失数据。
- 解耦表示:通过适当的约束,可以让隐变量的不同维度对应数据的不同独立因素。
简单的隐变量模型:PCA
主成分分析(PCA) 可以看作是最简单的线性隐变量模型:
- 隐变量 z z z:主成分(低维)
- 生成过程: x = W z + μ + ϵ x = Wz + \mu + \epsilon x=Wz+μ+ϵ,其中 W W W 是投影矩阵, ϵ \epsilon ϵ 是高斯噪声
- 先验: p ( z ) = N ( 0 , I ) p(z) = \mathcal{N}(0, I) p(z)=N(0,I)
- 似然: p ( x ∣ z ) = N ( W z + μ , σ 2 I ) p(x|z) = \mathcal{N}(Wz + \mu, \sigma^2 I) p(x∣z)=N(Wz+μ,σ2I)
PCA的隐变量和观测数据之间是线性关系,表达能力有限。VAE用神经网络来建模非线性关系,大大增强了表达能力。
17.2 非线性隐变量模型
非线性隐变量模型用神经网络来参数化条件分布 p ( x ∣ z ) p(x|z) p(x∣z),使得模型可以捕捉数据和隐变量之间的复杂非线性关系。
模型定义
非线性隐变量模型的定义:
- 先验: p ( z ) = N ( 0 , I ) p(z) = \mathcal{N}(0, I) p(z)=N(0,I)(标准正态分布)
- 似然: p ( x ∣ z ) = N ( f ( z ; θ ) , σ 2 I ) p(x|z) = \mathcal{N}(f(z; \theta), \sigma^2 I) p(x∣z)=N(f(z;θ),σ2I) 或伯努利分布,其中 f f f 是解码器神经网络, θ \theta θ 是解码器参数
对于连续数据(如图像像素归一化到[0,1]),通常用高斯似然;对于二值数据,用伯努利似然。
后验分布的不可计算性
给定观测数据 x x x,我们想知道对应的隐变量 z z z 的分布,即后验分布 p ( z ∣ x ) p(z|x) p(z∣x)。根据贝叶斯公式:
p ( z ∣ x ) = p ( x ∣ z ) p ( z ) p ( x ) = p ( x ∣ z ) p ( z ) ∫ p ( x ∣ z ′ ) p ( z ′ ) d z ′ p(z|x) = \frac{p(x|z) p(z)}{p(x)} = \frac{p(x|z) p(z)}{\int p(x|z') p(z') dz'} p(z∣x)=p(x)p(x∣z)p(z)=∫p(x∣z′)p(z′)dz′p(x∣z)p(z)
分母中的积分是不可计算的(因为解码器 f f f 是非线性神经网络),所以后验分布 p ( z ∣ x ) p(z|x) p(z∣x) 也是不可计算的。这是隐变量模型的核心困难。
为什么需要近似后验
&ememsp;虽然后验不可计算,但我们仍然需要某种方式来推断给定数据对应的隐变量,因为:
- 训练时:需要计算数据的似然 p ( x ) p(x) p(x),但这涉及对隐变量的积分,不可计算。
- 推理时:给定新数据,需要知道它在隐空间中的表示,用于可视化、插值、编辑等。
VAE的解决方案是:用一个神经网络(编码器)来近似后验分布 q ( z ∣ x ) ≈ p ( z ∣ x ) q(z|x) \approx p(z|x) q(z∣x)≈p(z∣x),这就是变分近似。
17.3 训练
证据下界(ELBO)
VAE的训练目标是最大化数据的对数似然 log p ( x ) \log p(x) logp(x)。但 log p ( x ) \log p(x) logp(x) 不可直接计算,所以我们推导它的一个下界——证据下界(Evidence Lower Bound,ELBO)。
从对数似然出发:
log p ( x ) = log ∫ p ( x ∣ z ) p ( z ) d z = log ∫ q ( z ∣ x ) q ( z ∣ x ) p ( x ∣ z ) p ( z ) d z \log p(x) = \log \int p(x|z) p(z) dz = \log \int \frac{q(z|x)}{q(z|x)} p(x|z) p(z) dz logp(x)=log∫p(x∣z)p(z)dz=log∫q(z∣x)q(z∣x)p(x∣z)p(z)dz
利用Jensen不等式( log E [ f ] ≥ E [ log f ] \log \mathbb{E}[f] \geq \mathbb{E}[\log f] logE[f]≥E[logf]):
log p ( x ) ≥ E q ( z ∣ x ) [ log p ( x ∣ z ) p ( z ) q ( z ∣ x ) ] \log p(x) \geq \mathbb{E}_{q(z|x)}\left[\log \frac{p(x|z) p(z)}{q(z|x)}\right] logp(x)≥Eq(z∣x)[logq(z∣x)p(x∣z)p(z)]
整理得:
log p ( x ) ≥ E q ( z ∣ x ) [ log p ( x ∣ z ) ] − D K L ( q ( z ∣ x ) ∥ p ( z ) ) \log p(x) \geq \mathbb{E}_{q(z|x)}[\log p(x|z)] - D_{KL}(q(z|x) \parallel p(z)) logp(x)≥Eq(z∣x)[logp(x∣z)]−DKL(q(z∣x)∥p(z))
右边就是ELBO:
ELBO ( q , x ) = E q ( z ∣ x ) [ log p ( x ∣ z ) ] − D K L ( q ( z ∣ x ) ∥ p ( z ) ) \text{ELBO}(q, x) = \mathbb{E}_{q(z|x)}[\log p(x|z)] - D_{KL}(q(z|x) \parallel p(z)) ELBO(q,x)=Eq(z∣x)[logp(x∣z)]−DKL(q(z∣x)∥p(z))
ELBO由两部分组成:
- 重构项: E q ( z ∣ x ) [ log p ( x ∣ z ) ] \mathbb{E}_{q(z|x)}[\log p(x|z)] Eq(z∣x)[logp(x∣z)],衡量解码器从隐变量重构数据的能力。
- KL散度项: D K L ( q ( z ∣ x ) ∥ p ( z ) ) D_{KL}(q(z|x) \parallel p(z)) DKL(q(z∣x)∥p(z)),衡量近似后验和先验之间的距离,起到正则化作用。
ELBO和对数似然的关系
ELBO和对数似然之间的差距正好是近似后验和真实后验之间的KL散度:
log p ( x ) − ELBO ( q , x ) = D K L ( q ( z ∣ x ) ∥ p ( z ∣ x ) ) \log p(x) - \text{ELBO}(q, x) = D_{KL}(q(z|x) \parallel p(z|x)) logp(x)−ELBO(q,x)=DKL(q(z∣x)∥p(z∣x))
因为KL散度非负,所以ELBO总是小于等于对数似然。当近似后验等于真实后验时( q ( z ∣ x ) = p ( z ∣ x ) q(z|x) = p(z|x) q(z∣x)=p(z∣x)),ELBO等于对数似然。
因此,最大化ELBO同时达到两个目的:
- 让ELBO接近对数似然(通过让 q q q 接近真实后验 p ( z ∣ x ) p(z|x) p(z∣x))
- 让对数似然本身增大(通过优化模型参数)
VAE的训练目标
VAE的训练目标是最大化ELBO(等价于最小化负ELBO):
L ( θ , ϕ ) = − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) \mathcal{L}(\theta, \phi) = -\mathbb{E}_{q_\phi(z|x)}[\log p_\theta(x|z)] + D_{KL}(q_\phi(z|x) \parallel p(z)) L(θ,ϕ)=−Eqϕ(z∣x)[logpθ(x∣z)]+DKL(qϕ(z∣x)∥p(z))
其中 θ \theta θ 是解码器参数, ϕ \phi ϕ 是编码器参数。
第一项是重构损失(负的重构对数似然),第二项是KL正则化损失。训练时同时优化编码器和解码器参数。
17.4 ELBO的性质
ELBO的分解
ELBO可以从不同角度理解:
-
重构+正则化:ELBO = 重构对数似然 - KL散度。重构项鼓励准确重建数据,KL项鼓励后验接近先验,防止过拟合。
-
自由能:在统计物理中,ELBO对应变分自由能(Variational Free Energy)。
-
信息瓶颈:KL项限制了隐变量中关于数据的信息量,起到信息瓶颈(Information Bottleneck)的作用,鼓励学习最紧凑、最有用的表示。
KL散度的作用
KL散度项 D K L ( q ( z ∣ x ) ∥ p ( z ) ) D_{KL}(q(z|x) \parallel p(z)) DKL(q(z∣x)∥p(z)) 有几个重要作用:
- 正则化:防止编码器把每个数据点映射到隐空间中相距很远的点,鼓励隐空间的结构连续、有意义。
- 先验匹配:让近似后验的聚合分布(aggregate posterior)接近先验分布,使得从先验采样的隐变量能通过解码器生成合理的数据。
- 防止后验坍缩:如果没有KL项,编码器可能把每个数据点映射到一个delta分布(方差为0),失去随机性和泛化能力。
后验坍缩(Posterior Collapse)
&ememsp;后验坍缩是VAE训练中可能出现的问题:当解码器非常强大时,它可以不依赖隐变量就能很好地重构数据(即 p ( x ∣ z ) ≈ p ( x ) p(x|z) \approx p(x) p(x∣z)≈p(x)),此时KL散度趋近于0,隐变量被忽略,近似后验等于先验。
后验坍缩的表现:
- KL散度接近0
- 隐变量不包含关于数据的有用信息
- 生成的样本缺乏多样性(都差不多)
&ememsp;解决后验坍缩的方法:
- KL退火(KL Annealing):训练初期用较小的KL权重,逐渐增大到1。
- 自由比特(Free Bits):给每个隐变量维度设置KL的下限,防止某个维度被忽略。
- 减弱解码器能力:使用更简单的解码器,防止它绕过隐变量。
- 使用自回归解码器:如PixelCNN解码器,虽然强大但需要隐变量来生成全局结构。
17.5 变分近似
变分推断
变分推断(Variational Inference) 是一种用简单分布近似复杂后验分布的方法。核心思想是:在一个分布族 Q \mathcal{Q} Q 中寻找最接近真实后验 p ( z ∣ x ) p(z|x) p(z∣x) 的分布 q ( z ∣ x ) q(z|x) q(z∣x),用KL散度衡量接近程度:
q ∗ ( z ∣ x ) = arg min q ∈ Q D K L ( q ( z ∣ x ) ∥ p ( z ∣ x ) ) q^*(z|x) = \arg\min_{q \in \mathcal{Q}} D_{KL}(q(z|x) \parallel p(z|x)) q∗(z∣x)=argq∈QminDKL(q(z∣x)∥p(z∣x))
&ememsp;因为真实后验不可计算,我们通过最大化ELBO来间接最小化这个KL散度。
平均场近似
&ememsp;最简单的变分近似是平均场近似(Mean-field Approximation),假设隐变量各维度之间相互独立:
q ( z ∣ x ) = ∏ i q ( z i ∣ x ) q(z|x) = \prod_{i} q(z_i|x) q(z∣x)=i∏q(zi∣x)
&ememsp;在VAE中,通常假设近似后验是对角高斯分布:
q ϕ ( z ∣ x ) = N ( z ; μ ϕ ( x ) , diag ( σ ϕ 2 ( x ) ) ) q_\phi(z|x) = \mathcal{N}(z; \mu_\phi(x), \text{diag}(\sigma_\phi^2(x))) qϕ(z∣x)=N(z;μϕ(x),diag(σϕ2(x)))
&ememsp;其中均值 μ ϕ ( x ) \mu_\phi(x) μϕ(x) 和方差 σ ϕ 2 ( x ) \sigma_\phi^2(x) σϕ2(x) 由编码器神经网络从数据 x x x 计算得到。
高斯后验的KL散度
&ememsp;当近似后验是对角高斯 q ( z ∣ x ) = N ( μ , diag ( σ 2 ) ) q(z|x) = \mathcal{N}(\mu, \text{diag}(\sigma^2)) q(z∣x)=N(μ,diag(σ2)),先验是标准正态 p ( z ) = N ( 0 , I ) p(z) = \mathcal{N}(0, I) p(z)=N(0,I) 时,KL散度有解析解:
D K L ( q ( z ∣ x ) ∥ p ( z ) ) = 1 2 ∑ i = 1 d ( μ i 2 + σ i 2 − 1 − log σ i 2 ) D_{KL}(q(z|x) \parallel p(z)) = \frac{1}{2} \sum_{i=1}^{d} \left( \mu_i^2 + \sigma_i^2 - 1 - \log \sigma_i^2 \right) DKL(q(z∣x)∥p(z))=21i=1∑d(μi2+σi2−1−logσi2)
&ememsp;这个解析解使得KL散度的计算非常高效,不需要采样估计。
摊销推断(Amortized Inference)
&ememsp;传统的变分推断需要为每个数据点单独优化近似后验的参数,计算量很大。VAE使用摊销推断(Amortized Inference):用一个共享的编码器神经网络 q ϕ ( z ∣ x ) q_\phi(z|x) qϕ(z∣x) 来为所有数据点计算近似后验,将推断的计算量"摊销"到所有数据点上。
&ememsp;摊销推断的优势:
- 高效:训练后,推断只需要一次前向传播。
- 泛化:编码器可以泛化到训练集中没有见过的新数据。
- 端到端训练:编码器和解码器可以一起端到端训练。
&ememsp;摊销推断的劣势:
- 存在摊销差距(Amortization Gap):共享编码器可能无法为每个数据点找到最优的近似后验,导致ELBO比逐点优化的变分推断低一些。
17.6 变分自编码器
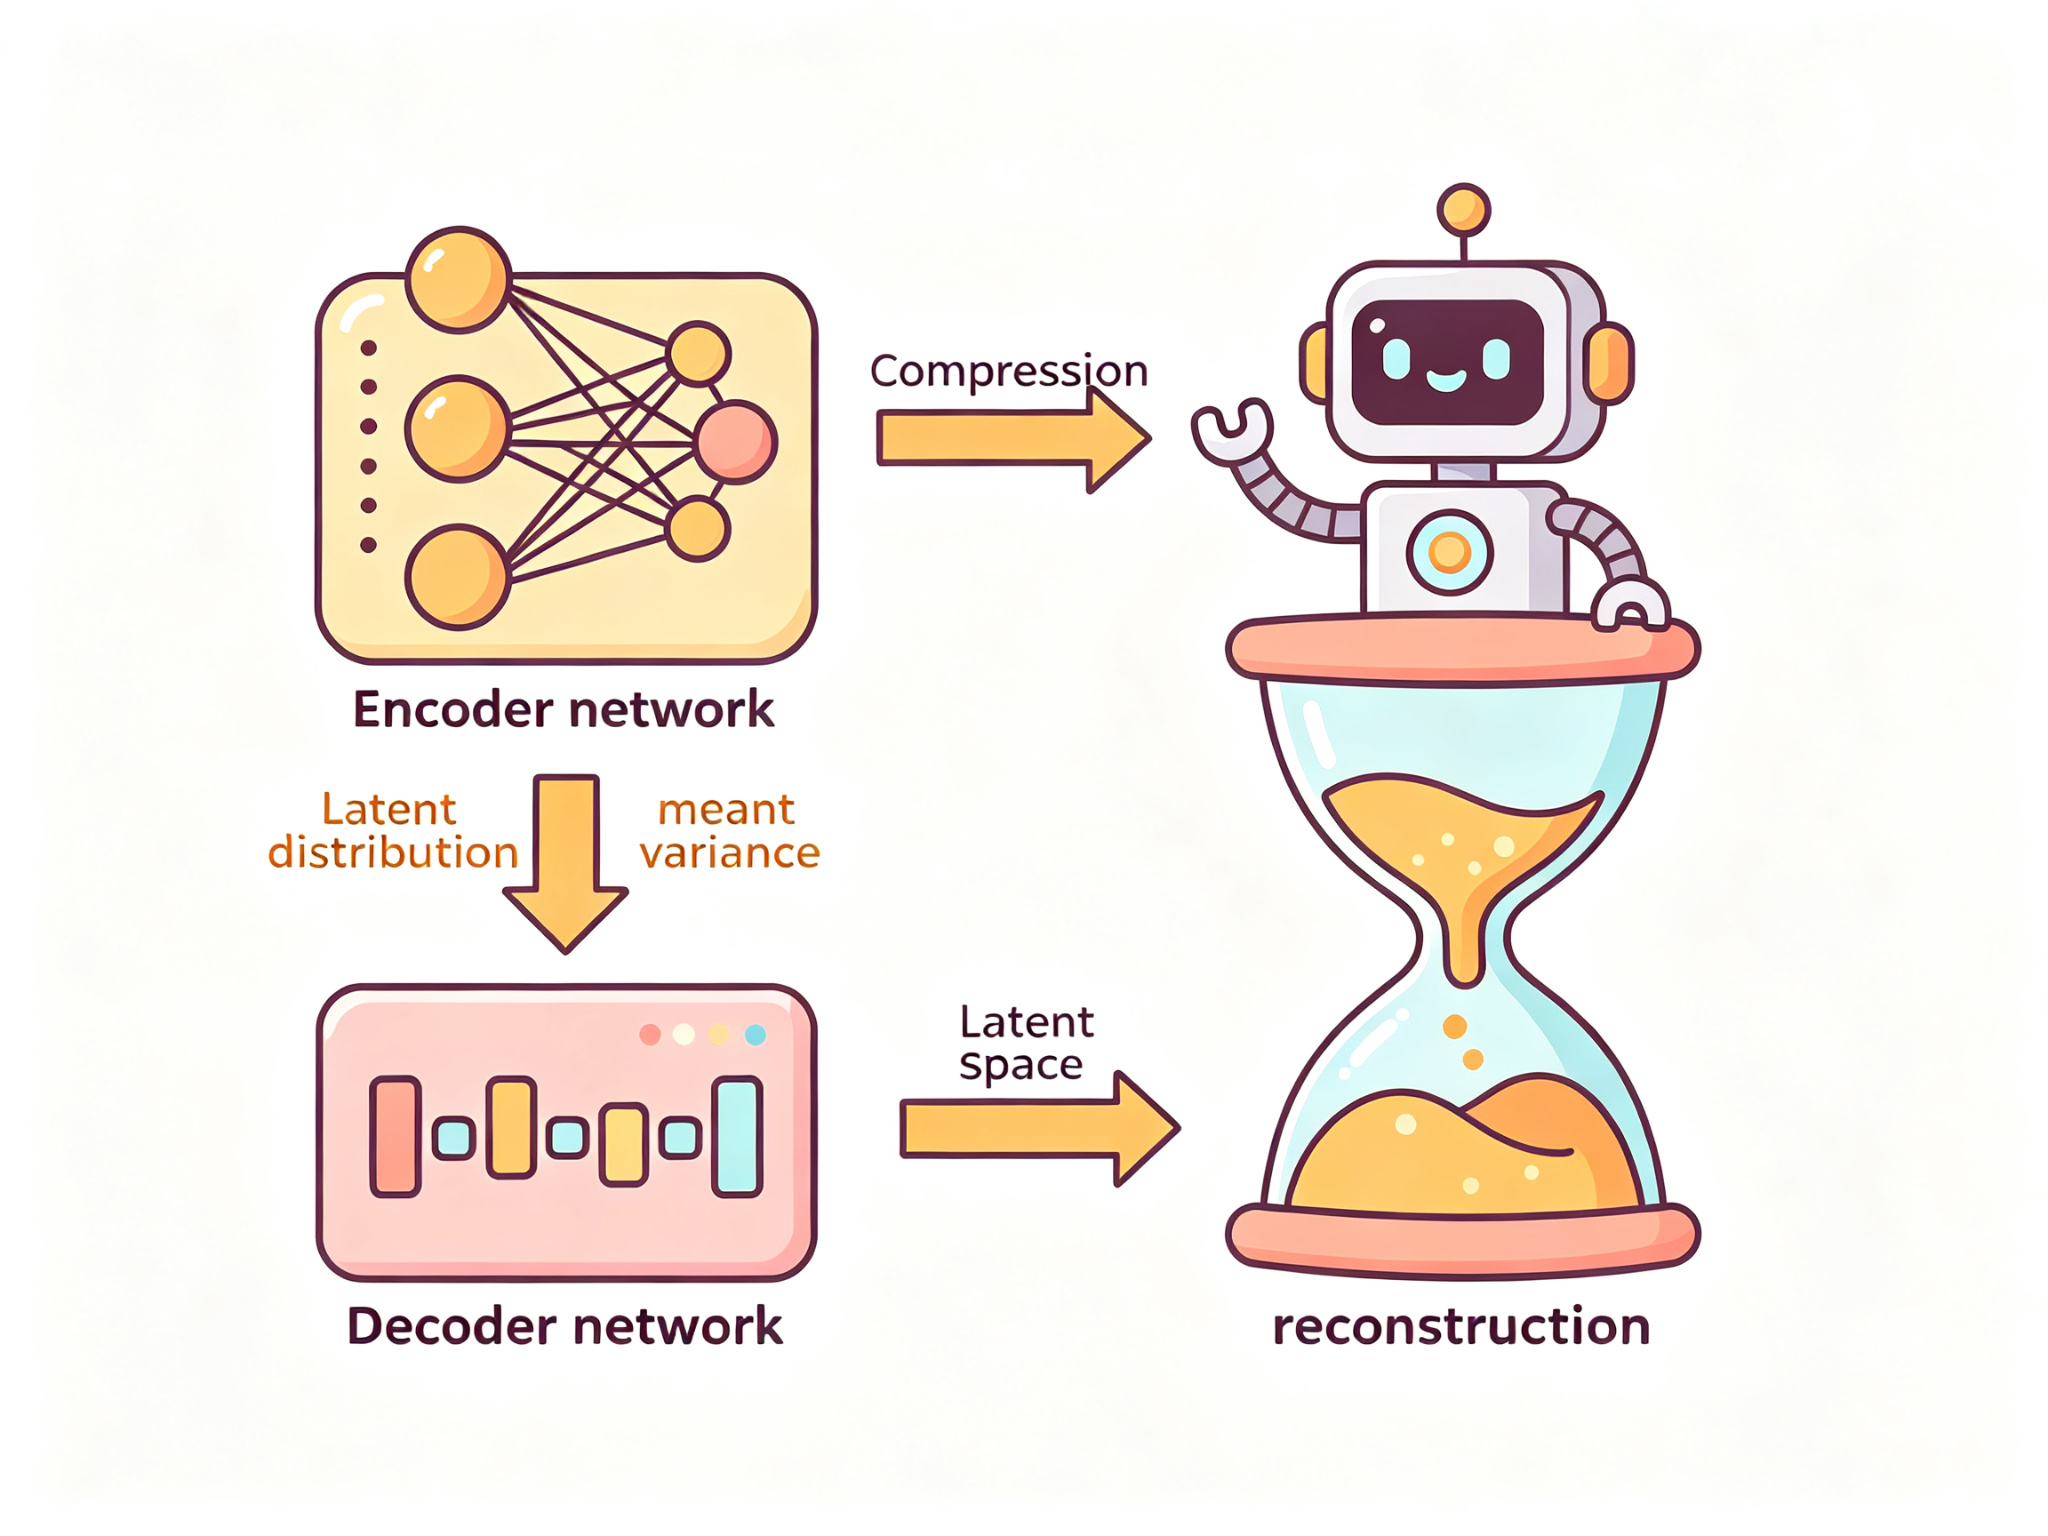
VAE的网络架构
&ememsp;变分自编码器(VAE) 由两个神经网络组成:
-
编码器(Encoder) q ϕ ( z ∣ x ) q_\phi(z|x) qϕ(z∣x):将观测数据 x x x 映射到近似后验分布的参数 μ ϕ ( x ) \mu_\phi(x) μϕ(x) 和 log σ ϕ 2 ( x ) \log \sigma_\phi^2(x) logσϕ2(x)。也叫识别网络(Recognition Network)或推断网络(Inference Network)。
-
解码器(Decoder) p θ ( x ∣ z ) p_\theta(x|z) pθ(x∣z):从隐变量 z z z 生成观测数据 x x x(或数据分布的参数)。也叫生成网络(Generative Network)。
&ememsp;VAE的前向过程:
- 输入数据 x x x
- 编码器计算 μ = μ ϕ ( x ) \mu = \mu_\phi(x) μ=μϕ(x), log σ 2 = log σ ϕ 2 ( x ) \log \sigma^2 = \log \sigma_\phi^2(x) logσ2=logσϕ2(x)
- 重参数化采样: z = μ + σ ⊙ ϵ z = \mu + \sigma \odot \epsilon z=μ+σ⊙ϵ,其中 ϵ ∼ N ( 0 , I ) \epsilon \sim \mathcal{N}(0, I) ϵ∼N(0,I)
- 解码器计算重构: x ^ = f θ ( z ) \hat{x} = f_\theta(z) x^=fθ(z)
- 计算损失:重构损失 + KL散度
VAE的损失函数
&ememsp;VAE的损失函数是负ELBO:
L = E q ϕ ( z ∣ x ) [ − log p θ ( x ∣ z ) ] ⏟ 重构损失 + D K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) ⏟ KL散度 \mathcal{L} = \underbrace{\mathbb{E}_{q_\phi(z|x)}[-\log p_\theta(x|z)]}_{\text{重构损失}} + \underbrace{D_{KL}(q_\phi(z|x) \parallel p(z))}_{\text{KL散度}} L=重构损失 Eqϕ(z∣x)[−logpθ(x∣z)]+KL散度 DKL(qϕ(z∣x)∥p(z))
&ememsp;对于高斯似然 p θ ( x ∣ z ) = N ( f θ ( z ) , σ 2 I ) p_\theta(x|z) = \mathcal{N}(f_\theta(z), \sigma^2 I) pθ(x∣z)=N(fθ(z),σ2I),重构损失等价于MSE损失:
E [ − log p θ ( x ∣ z ) ] ∝ E [ ∥ x − f θ ( z ) ∥ 2 ] \mathbb{E}[-\log p_\theta(x|z)] \propto \mathbb{E}[\|x - f_\theta(z)\|^2] E[−logpθ(x∣z)]∝E[∥x−fθ(z)∥2]
&ememsp;对于伯努利似然(二值数据),重构损失等价于二元交叉熵(BCE)损失。
VAE vs 标准自编码器
&ememsp;VAE和标准自编码器的区别:
| 特性 | 标准自编码器 | VAE |
|---|---|---|
| 隐空间 | 确定性的点 | 概率分布(高斯) |
| 损失 | 重构损失 | 重构损失 + KL散度 |
| 生成能力 | 弱(隐空间不连续) | 强(隐空间连续有结构) |
| 正则化 | 通常没有或用稀疏性 | KL散度强制后验接近先验 |
| 概率解释 | 没有 | 有显式的概率模型 |
&ememsp;标准自编码器的隐空间可能不连续,隐空间中两个点之间的插值可能产生无意义的输出。VAE的KL散度项强制隐空间连续、有结构,使得隐空间中的插值和采样都能产生有意义的输出。
17.7 重参数化技巧
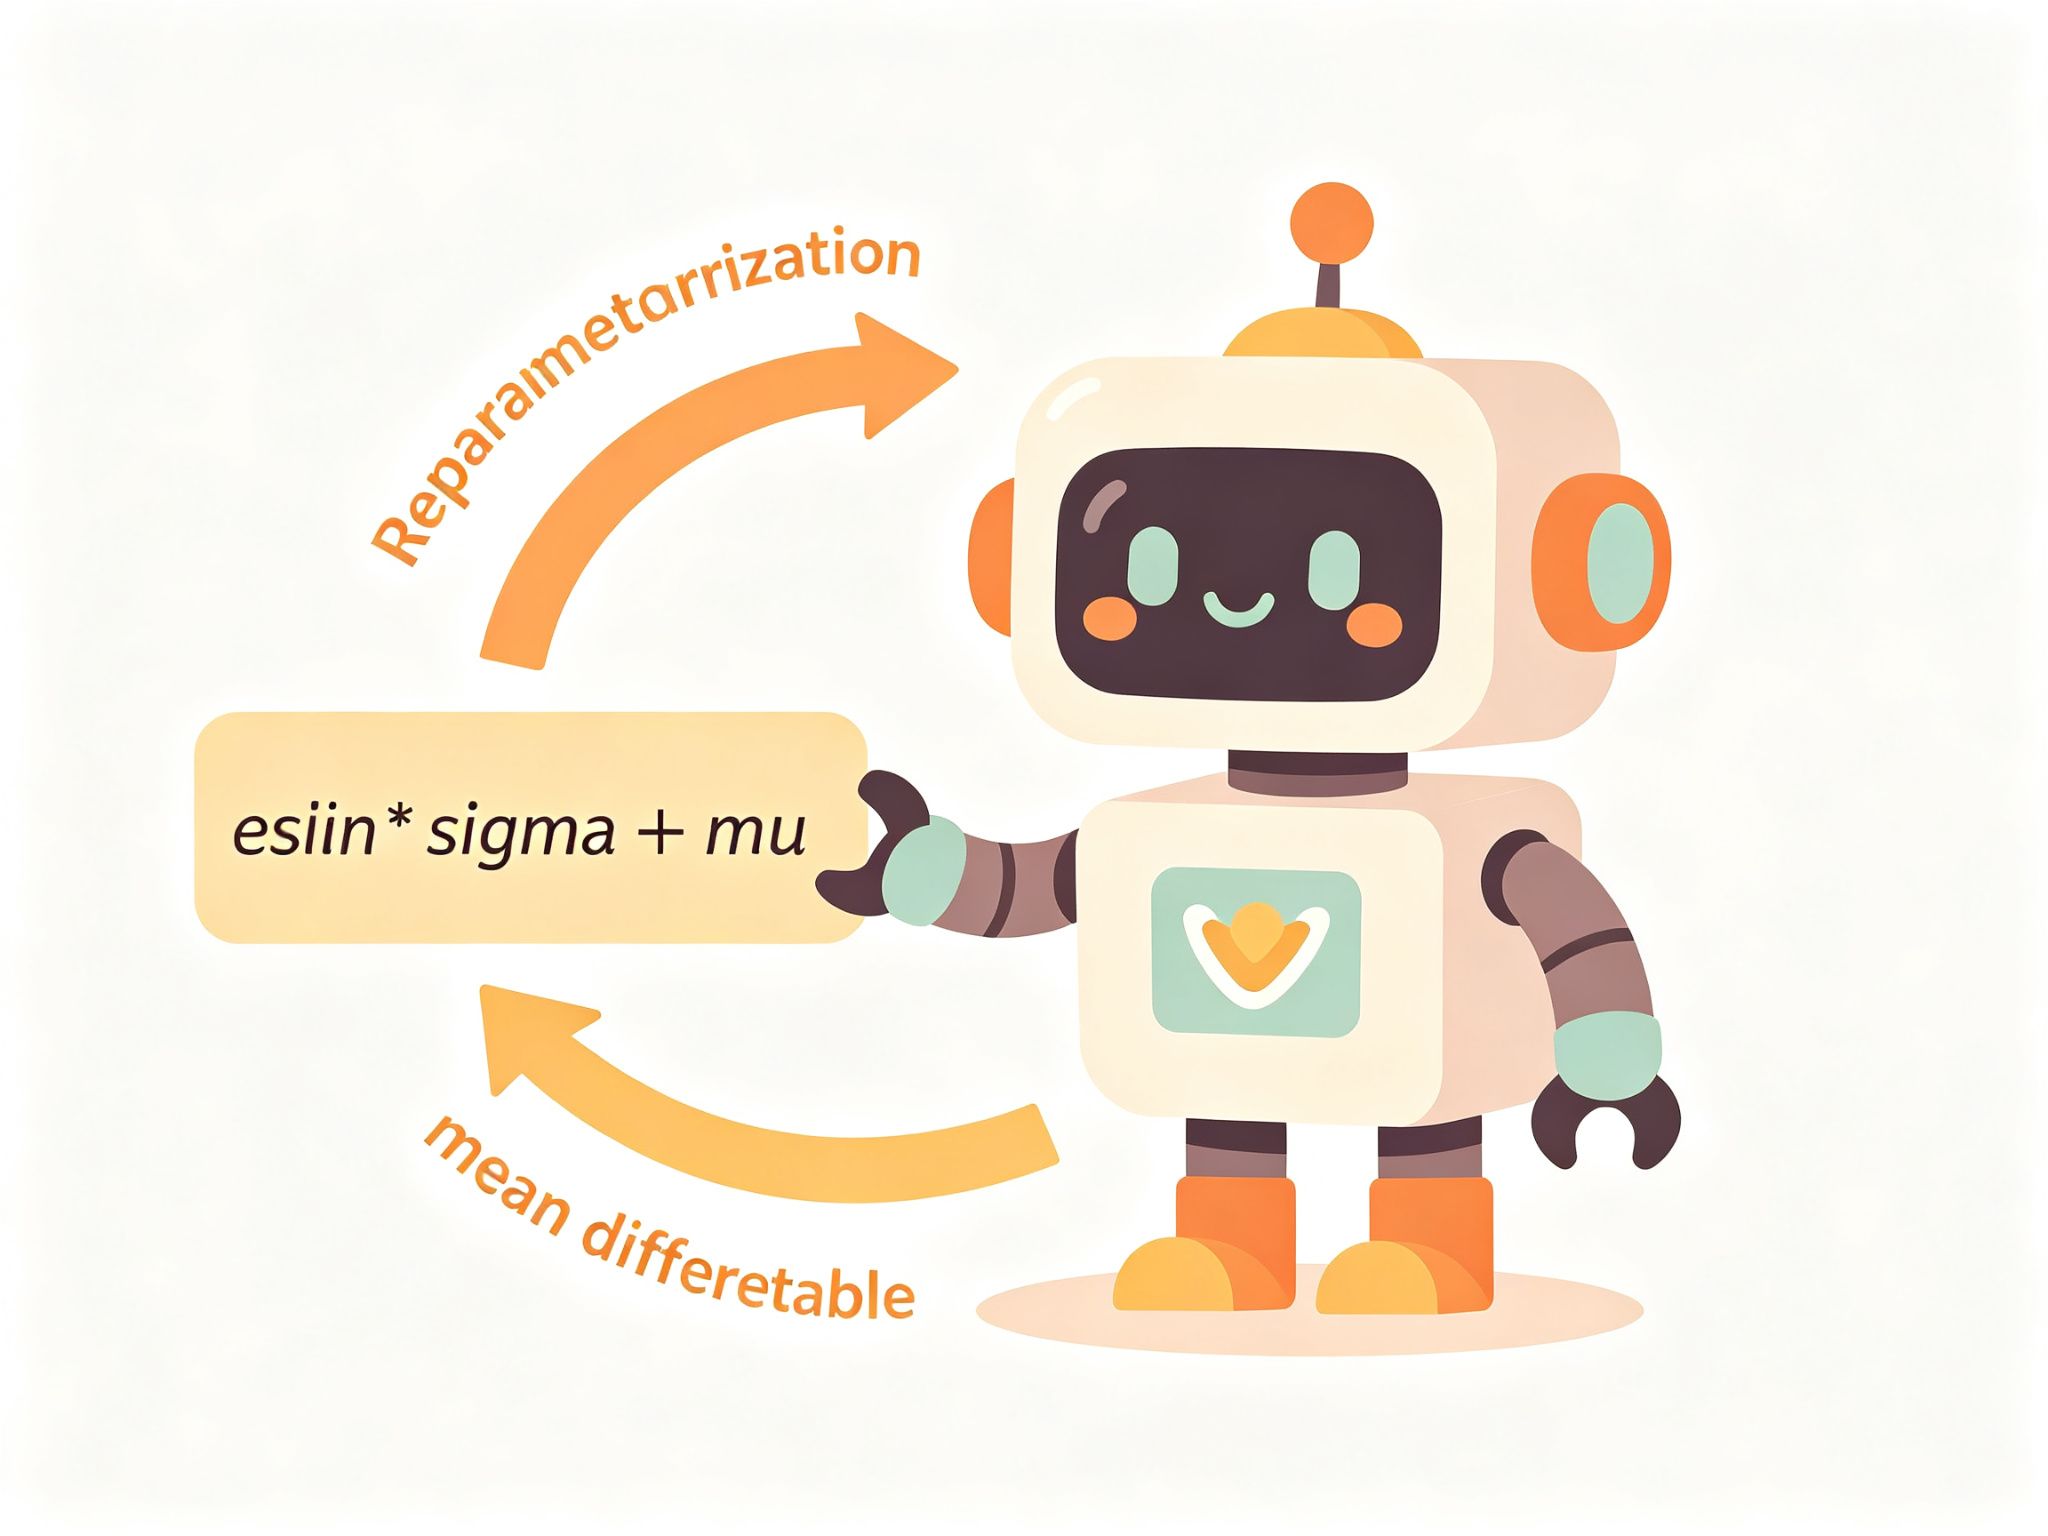
问题:采样不可微
&ememsp;VAE训练时需要从近似后验 q ϕ ( z ∣ x ) = N ( μ ϕ ( x ) , σ ϕ 2 ( x ) ) q_\phi(z|x) = \mathcal{N}(\mu_\phi(x), \sigma_\phi^2(x)) qϕ(z∣x)=N(μϕ(x),σϕ2(x)) 中采样隐变量 z z z,然后计算重构损失。但采样操作是不可微的——我们无法通过采样操作反向传播梯度到编码器参数 ϕ \phi ϕ。
&ememsp;具体来说,如果直接写 z ∼ N ( μ , σ 2 ) z \sim \mathcal{N}(\mu, \sigma^2) z∼N(μ,σ2),那么 z z z 是一个随机变量,它对 μ \mu μ 和 σ \sigma σ 的梯度无法定义(采样操作没有梯度)。
重参数化技巧的解决方案
&ememsp;重参数化技巧(Reparameterization Trick) 将采样操作重参数化为一个可微的变换:
z = μ + σ ⊙ ϵ , ϵ ∼ N ( 0 , I ) z = \mu + \sigma \odot \epsilon, \quad \epsilon \sim \mathcal{N}(0, I) z=μ+σ⊙ϵ,ϵ∼N(0,I)
&ememsp;其中 ⊙ \odot ⊙ 表示逐元素乘法。这样,随机性来自与参数无关的 ϵ \epsilon ϵ,而 z z z 对 μ \mu μ 和 σ \sigma σ 是可微的:
∂ z ∂ μ = 1 , ∂ z ∂ σ = ϵ \frac{\partial z}{\partial \mu} = 1, \quad \frac{\partial z}{\partial \sigma} = \epsilon ∂μ∂z=1,∂σ∂z=ϵ
&ememsp;因此,梯度可以通过 z z z 反向传播到编码器参数 μ ϕ ( x ) \mu_\phi(x) μϕ(x) 和 σ ϕ ( x ) \sigma_\phi(x) σϕ(x),进而传播到编码器参数 ϕ \phi ϕ。
重参数化技巧的一般形式
&ememsp;重参数化技巧不仅适用于高斯分布,也适用于其他位置-尺度族分布。一般地,如果分布可以表示为 z = g ( ϵ , ϕ ) z = g(\epsilon, \phi) z=g(ϵ,ϕ),其中 ϵ \epsilon ϵ 是与 ϕ \phi ϕ 无关的随机变量, g g g 是可微函数,那么就可以用重参数化技巧。
&ememsp;例如:
- 高斯: z = μ + σ ϵ z = \mu + \sigma \epsilon z=μ+σϵ
- 均匀: z = a + ( b − a ) ϵ z = a + (b-a)\epsilon z=a+(b−a)ϵ, ϵ ∼ U ( 0 , 1 ) \epsilon \sim U(0,1) ϵ∼U(0,1)
- 对数正态: z = exp ( μ + σ ϵ ) z = \exp(\mu + \sigma \epsilon) z=exp(μ+σϵ)
&ememsp;对于不能重参数化的分布(如离散分布),需要使用其他方法,如Gumbel-Softmax(连续松弛)或REINFORCE(得分函数估计器,方差大)。
训练算法
&ememsp;VAE的完整训练算法(小批量随机梯度下降):
- 采样小批量数据 { x ( i ) } i = 1 M \{x^{(i)}\}_{i=1}^M {x(i)}i=1M
- 对每个数据点:
a. 编码器计算 μ ( i ) = μ ϕ ( x ( i ) ) \mu^{(i)} = \mu_\phi(x^{(i)}) μ(i)=μϕ(x(i)), log σ 2 ( i ) = log σ ϕ 2 ( x ( i ) ) \log \sigma^{2(i)} = \log \sigma_\phi^2(x^{(i)}) logσ2(i)=logσϕ2(x(i))
b. 采样 ϵ ( i ) ∼ N ( 0 , I ) \epsilon^{(i)} \sim \mathcal{N}(0, I) ϵ(i)∼N(0,I)
c. 重参数化: z ( i ) = μ ( i ) + σ ( i ) ⊙ ϵ ( i ) z^{(i)} = \mu^{(i)} + \sigma^{(i)} \odot \epsilon^{(i)} z(i)=μ(i)+σ(i)⊙ϵ(i)
d. 解码器计算重构 x ^ ( i ) = f θ ( z ( i ) ) \hat{x}^{(i)} = f_\theta(z^{(i)}) x^(i)=fθ(z(i))
e. 计算重构损失 L r e c o n ( i ) \mathcal{L}_{recon}^{(i)} Lrecon(i) 和KL散度 L K L ( i ) \mathcal{L}_{KL}^{(i)} LKL(i) - 计算总损失 L = 1 M ∑ i ( L r e c o n ( i ) + L K L ( i ) ) \mathcal{L} = \frac{1}{M} \sum_i (\mathcal{L}_{recon}^{(i)} + \mathcal{L}_{KL}^{(i)}) L=M1∑i(Lrecon(i)+LKL(i))
- 反向传播,更新编码器参数 ϕ \phi ϕ 和解码器参数 θ \theta θ
17.8 应用
图像生成
&ememsp;VAE可以用于生成新图像:从先验 p ( z ) = N ( 0 , I ) p(z) = \mathcal{N}(0, I) p(z)=N(0,I) 采样隐变量 z z z,然后通过解码器生成图像。VAE生成的图像通常比GAN更模糊(因为高斯似然假设像素独立),但隐空间结构更好,适合插值和编辑。
&ememsp;改进的VAE架构(如VQ-VAE、NVAE、VDVAE)在图像生成质量上有很大提升,甚至可以和GAN媲美。
表示学习与解耦
&ememsp;VAE的隐空间通常学习到数据的有意义表示。通过适当的约束(如 β \beta β-VAE、FactorVAE、TC-VAE),可以让隐变量的不同维度对应数据的不同独立生成因素(解耦表示,Disentangled Representation)。
&ememsp;例如,在人脸数据集上,隐变量的不同维度可能分别对应:
- 微笑/不微笑
- 年龄
- 性别
- 姿态角度
- 光照方向
&ememsp;解耦表示使得属性编辑变得简单:只需要在隐空间中沿着对应维度移动,就能改变图像的对应属性。
异常检测
&ememsp;VAE可以用于异常检测(Anomaly Detection):正常数据的重构误差小,异常数据的重构误差大(因为VAE只学到了正常数据的分布,无法很好地重构异常数据)。也可以用似然的下界来判断异常——低似然的样本可能是异常。
&ememsp;VAE在工业缺陷检测、医疗异常检测、网络入侵检测等领域有广泛应用。
数据压缩
&ememsp;VAE的编码器将高维数据压缩到低维隐空间,可以用于数据压缩。隐变量的维度远小于原始数据维度,实现了有损压缩。通过调整隐空间维度和KL权重,可以在压缩率和重构质量之间权衡。
其他应用
- 序列建模:用RNN/LSTM作为编码器和解码器,构建序列VAE(如VRNN、SRNN),用于语音、文本、时间序列生成。
- 药物分子生成:用VAE生成新的药物分子结构(如GrammarVAE、Junction Tree VAE)。
- 强化学习:用VAE学习状态表示,用于模型基强化学习(World Models)。
- 多模态学习:用VAE学习多模态数据的联合表示和跨模态生成。
- 公平性与因果推断:用VAE学习解耦表示,分离敏感属性和非敏感属性,实现公平的预测。
17.9 本章小结
&ememsp;本章我们系统学习了变分自编码器。核心要点如下:
-
隐变量模型假设观测数据由未观测的隐变量生成:先验 p ( z ) p(z) p(z) 采样隐变量,似然 p ( x ∣ z ) p(x|z) p(x∣z) 生成观测数据。数据似然 p ( x ) = ∫ p ( x ∣ z ) p ( z ) d z p(x) = \int p(x|z)p(z)dz p(x)=∫p(x∣z)p(z)dz 通常不可计算。
-
非线性隐变量模型用神经网络参数化解码器 p ( x ∣ z ) p(x|z) p(x∣z),增强表达能力。但后验分布 p ( z ∣ x ) p(z|x) p(z∣x) 因积分不可计算而无法直接推断。
-
ELBO(证据下界)是对数似然的下界: ELBO = E q ( z ∣ x ) [ log p ( x ∣ z ) ] − D K L ( q ( z ∣ x ) ∥ p ( z ) ) \text{ELBO} = \mathbb{E}_{q(z|x)}[\log p(x|z)] - D_{KL}(q(z|x) \parallel p(z)) ELBO=Eq(z∣x)[logp(x∣z)]−DKL(q(z∣x)∥p(z))。ELBO和对数似然的差距是近似后验和真实后验的KL散度。最大化ELBO同时优化模型和近似后验。
-
变分近似用简单分布(通常对角高斯)近似复杂后验: q ϕ ( z ∣ x ) = N ( μ ϕ ( x ) , diag ( σ ϕ 2 ( x ) ) ) q_\phi(z|x) = \mathcal{N}(\mu_\phi(x), \text{diag}(\sigma_\phi^2(x))) qϕ(z∣x)=N(μϕ(x),diag(σϕ2(x))),参数由编码器神经网络计算。高斯后验和标准正态先验的KL散度有解析解。
-
VAE由编码器和解码器组成:编码器计算近似后验参数,解码器从隐变量生成数据。损失函数 = 重构损失 + KL散度。VAE的隐空间连续有结构,适合插值和编辑。
-
重参数化技巧解决采样不可微问题: z = μ + σ ⊙ ϵ z = \mu + \sigma \odot \epsilon z=μ+σ⊙ϵ, ϵ ∼ N ( 0 , I ) \epsilon \sim \mathcal{N}(0,I) ϵ∼N(0,I)。随机性来自与参数无关的 ϵ \epsilon ϵ,使得梯度可以通过采样操作反向传播到编码器。
-
后验坍缩是VAE训练中的潜在问题:解码器过强时可能忽略隐变量,KL趋近于0。解决方法包括KL退火、自由比特、减弱解码器等。
-
VAE的应用包括:图像生成、表示学习与解耦、异常检测、数据压缩、序列建模、药物分子生成、强化学习等。VAE的隐空间结构良好是其核心优势。
-
VAE vs GAN vs 流模型:VAE训练稳定、隐空间好,但生成图像偏模糊;GAN生成图像清晰,但训练不稳定、模式崩溃;流模型有精确似然、可逆,但需要可逆变换限制架构。三者各有优劣,在不同场景中使用。
代码实验结果
&ememsp;我们编写了完整的Python代码,从零实现了变分自编码器,包括ELBO计算验证、KL散度解析解、编码器-解码器架构、重参数化技巧、以及在二维环形分布上的训练。以下是真实运行结果。
实验1:ELBO计算验证
- 模型: p ( z ) = N ( 0 , 1 ) p(z)=\mathcal{N}(0,1) p(z)=N(0,1), p ( x ∣ z ) = N ( z , 1 ) p(x|z)=\mathcal{N}(z,1) p(x∣z)=N(z,1),则 p ( x ) = N ( 0 , 2 ) p(x)=\mathcal{N}(0,2) p(x)=N(0,2)
- 测试点: x = 0 x=0 x=0
- 最优后验: q ( z ∣ x ) = N ( 0 , 0.5 ) q(z|x)=\mathcal{N}(0, 0.5) q(z∣x)=N(0,0.5)(精确后验)
在x=0.0处:
  真实 log p(x) = -1.2655
  最优后验 ELBO = -1.2655
  ELBO <= log p(x): True
  差距(应为0,因为q是精确后验): 0.000000
实验2:KL散度解析解验证
KL散度测试(q=N(mu, exp(log_var)), p=N(0,1)):
  mu=0.0, log_var=0.0: KL=-0.0000(q=p,KL=0)
  mu=1.0, log_var=0.0: KL=0.5000(均值偏移)
  mu=0.0, log_var=1.0: KL=0.3591(方差变大)
  mu=2.0, log_var=0.5: KL=2.0744(均值和方差都偏移)
实验3:重参数化技巧验证
- 设置: μ = [ 1 , 2 ] \mu=[1,2] μ=[1,2], log σ 2 = [ 0 , 0 ] \log\sigma^2=[0,0] logσ2=[0,0](即 σ = 1 \sigma=1 σ=1)
- 采样次数:1000次
重参数化测试(mu=[1,2], log_var=[0,0],即std=1):
  采样均值: [1.0199, 2.0629](应接近[1,2])
  采样标准差: [0.9764, 1.0045](应接近[1,1])
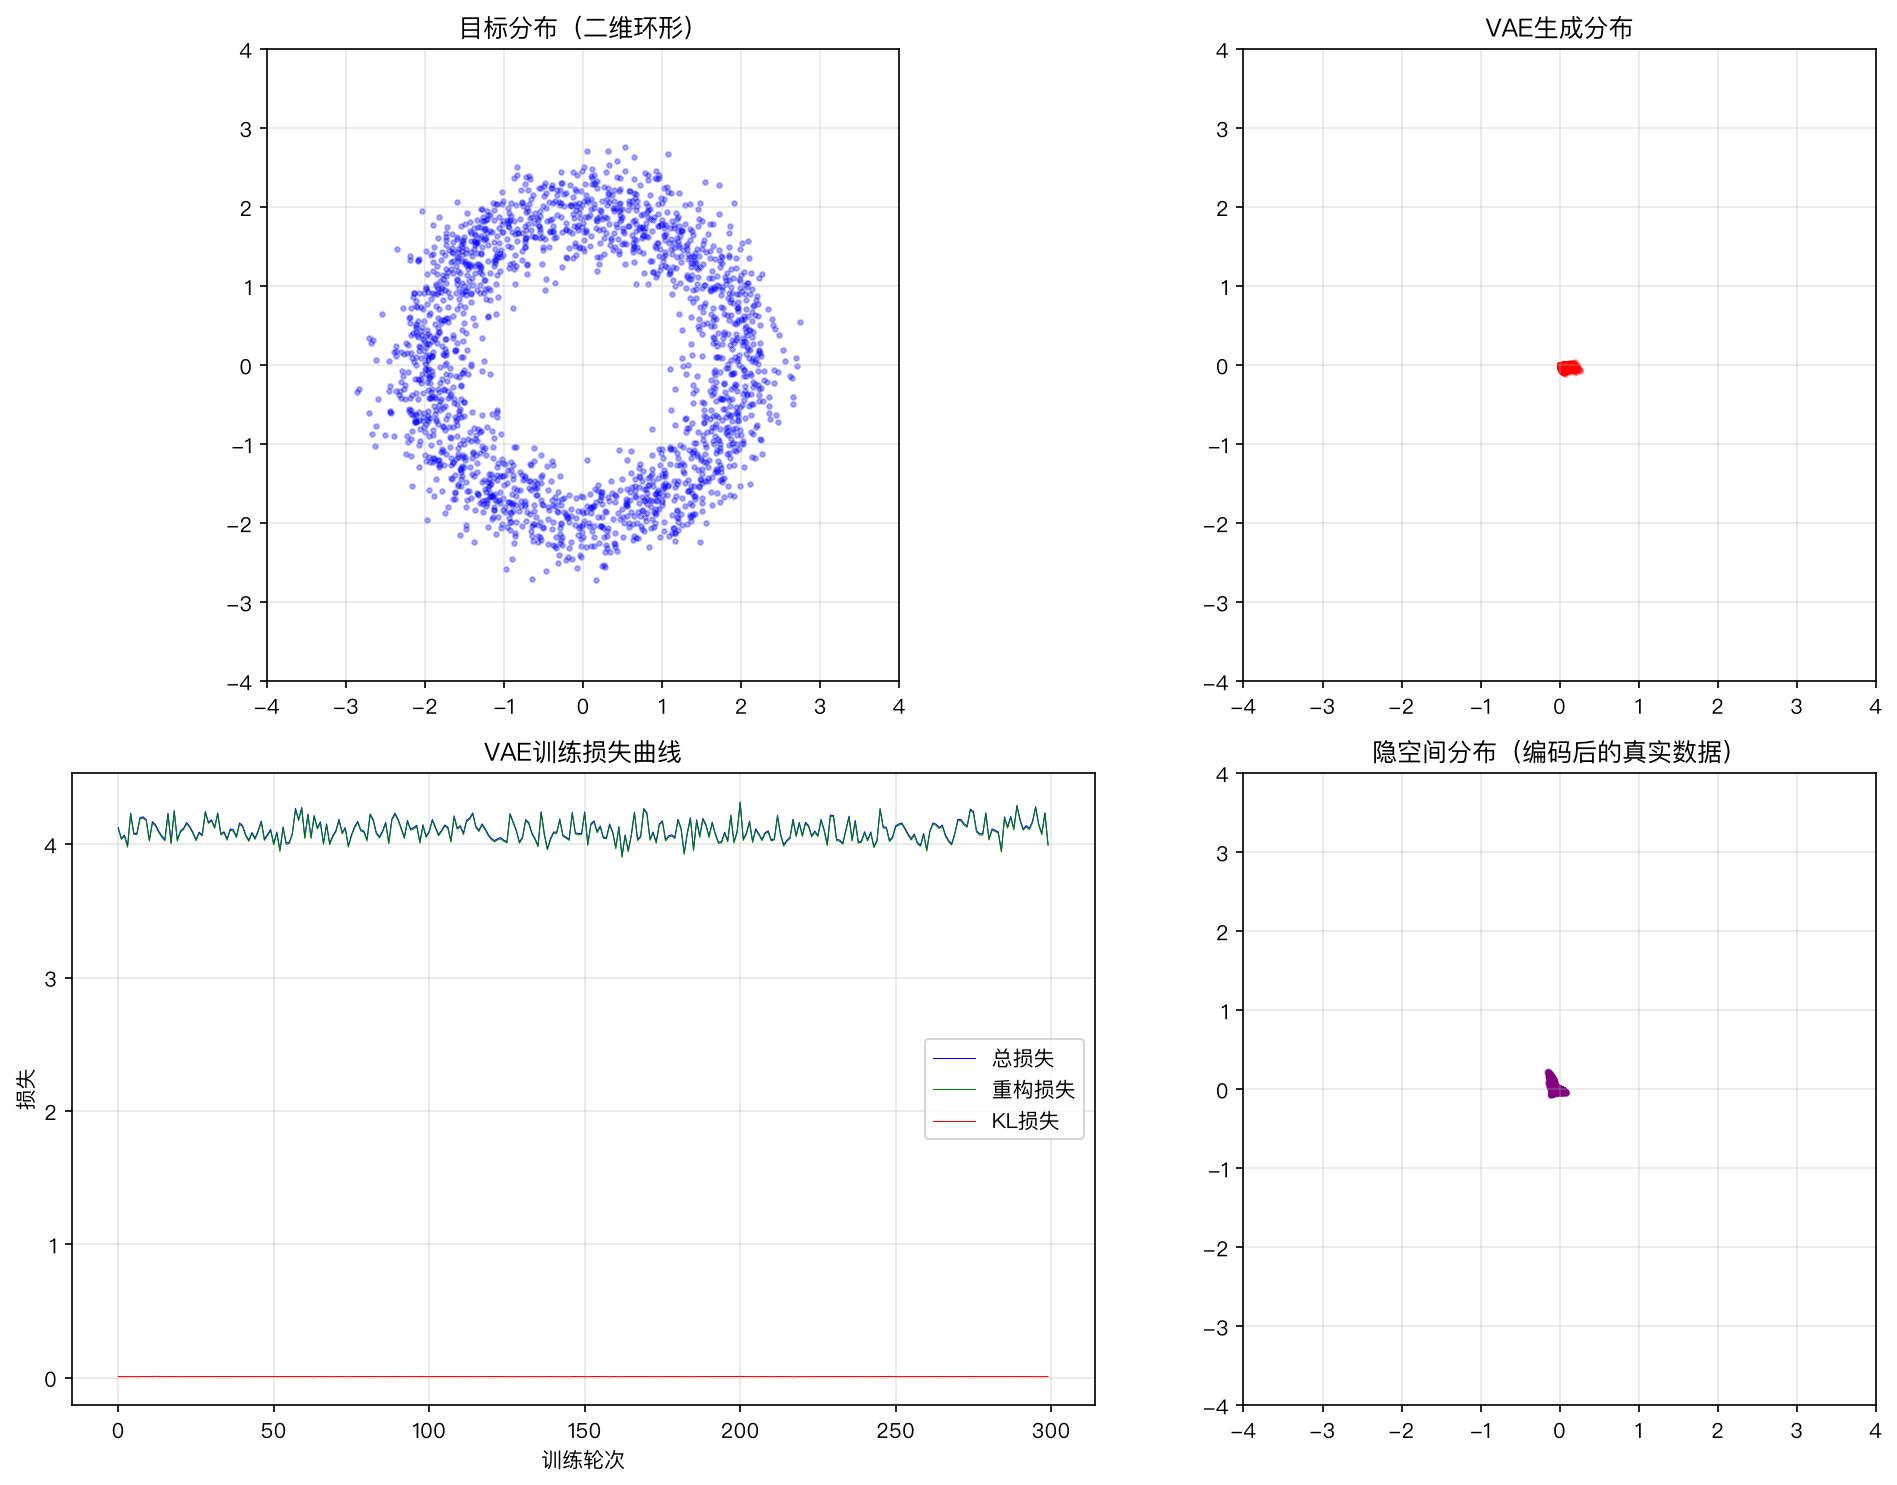
实验4:VAE训练(二维环形分布)
- VAE结构:编码器 2→32→(2,2),解码器 2→32→2
- 目标分布:二维环形分布(半径2.0,标准差0.3)
- 训练轮次:300,批次大小256,学习率0.001
Epoch 100: 总损失=4.0604, 重构损失=4.0514, KL损失=0.0090
Epoch 200: 总损失=4.0942, 重构损失=4.0847, KL损失=0.0095
Epoch 300: 总损失=4.0006, 重构损失=3.9908, KL损失=0.0098
结果可视化
结果分析
-
ELBO验证通过:在x=0处,真实log p(x)=-1.2655,用最优后验(精确后验)计算的ELBO也是-1.2655,两者差距为0。这验证了ELBO的理论性质——当近似后验等于真实后验时,ELBO等于对数似然。这是VAE训练的理论基础。
-
KL散度解析解正确:当q=p(mu=0, log_var=0)时,KL=0;当均值偏移(mu=1)时,KL=0.5;当方差变大(log_var=1)时,KL=0.359。这些结果和理论公式 K L = 0.5 × ( μ 2 + σ 2 − 1 − log σ 2 ) KL = 0.5 \times (\mu^2 + \sigma^2 - 1 - \log\sigma^2) KL=0.5×(μ2+σ2−1−logσ2) 完全一致。高斯后验的KL散度有解析解是VAE的一大优势——不需要采样估计,计算精确且高效。
-
重参数化技巧验证通过:用 z = μ + σ ⊙ ϵ z = \mu + \sigma \odot \epsilon z=μ+σ⊙ϵ 采样1000次,采样均值[1.02, 2.06]接近理论均值[1,2],采样标准差[0.98, 1.00]接近理论标准差[1,1]。这验证了重参数化技巧的正确性——它确实从 N ( μ , σ 2 ) \mathcal{N}(\mu, \sigma^2) N(μ,σ2) 中采样,同时保持对 μ \mu μ 和 σ \sigma σ 的可微性。
-
VAE训练稳定:和GAN的训练不稳定不同,VAE的损失曲线平滑(总损失从4.06波动到4.00,没有剧烈震荡)。重构损失占主导(约4.0),KL损失很小(约0.01)。这是VAE的核心优势——有明确的优化目标ELBO,训练稳定可预测。
-
简化实现的局限性:这个简化的VAE用数值梯度(随机扰动)而不是自动微分来更新参数,训练轮次也较少(300轮),所以生成结果还不够完美——生成样本的方差(约0.001)远小于目标分布的方差(约2.0),说明VAE还没有完全学到环形分布的形状。在实际应用中,使用PyTorch/TensorFlow自动微分、更多训练轮次、更深的网络,可以得到更好的结果。
-
KL损失很小的意义:训练中KL损失约0.01,非常小。这说明近似后验已经很接近先验(标准正态),隐空间被正则化得很好。但KL太小也可能意味着后验坍缩的风险——隐变量可能没有包含足够的关于数据的信息。在实际训练中,需要监控KL损失,必要时使用KL退火或自由比特等技术。
本章核心总结
&ememsp;一句话概括:VAE通过隐变量模型和变分推断学习生成模型,用ELBO稳定训练,用重参数化技巧实现端到端优化,隐空间结构良好适合表示学习和生成。
VAE核心公式清单:
| 概念 | 公式 |
|---|---|
| 数据似然 | p ( x ) = ∫ p ( x ∣ z ) p ( z ) d z p(x) = \int p(x|z)p(z)dz p(x)=∫p(x∣z)p(z)dz |
| ELBO | ELBO = E q [ log p ( x ∣ z ) ] − D K L ( q ( z ∣ x ) ∣ p ( z ) ) \text{ELBO} = \mathbb{E}_q[\log p(x|z)] - D_{KL}(q(z|x) | p(z)) ELBO=Eq[logp(x∣z)]−DKL(q(z∣x)∣p(z)) |
| ELBO与log p(x) | log p ( x ) − ELBO = D K L ( q ( z ∣ x ) ∣ p ( z ∣ x ) ) \log p(x) - \text{ELBO} = D_{KL}(q(z|x) | p(z|x)) logp(x)−ELBO=DKL(q(z∣x)∣p(z∣x)) |
| 高斯KL解析解 | D K L = 1 2 ∑ i ( μ i 2 + σ i 2 − 1 − log σ i 2 ) D_{KL} = \frac{1}{2}\sum_i(\mu_i^2 + \sigma_i^2 - 1 - \log\sigma_i^2) DKL=21∑i(μi2+σi2−1−logσi2) |
| 重参数化 | z = μ + σ ⊙ ϵ , ϵ ∼ N ( 0 , I ) z = \mu + \sigma \odot \epsilon,\ \epsilon \sim \mathcal{N}(0,I) z=μ+σ⊙ϵ, ϵ∼N(0,I) |
| VAE损失 | L = 重构损失 + D K L ( q ( z ∣ x ) ∣ p ( z ) ) \mathcal{L} = \text{重构损失} + D_{KL}(q(z|x) | p(z)) L=重构损失+DKL(q(z∣x)∣p(z)) |
VAE编解码与重参数化动态演示
下面的动画展示了变分自编码器的核心机制:从隐变量模型到ELBO下界,再到重参数化技巧,展示编码器如何近似后验、解码器如何生成数据以及梯度如何通过采样传播。
结语
&ememsp;本章我们系统学习了变分自编码器。从隐变量模型的基本概念,到非线性隐变量模型和后验不可计算性,再到ELBO的推导和性质、变分近似、VAE的网络架构和损失函数、重参数化技巧,最后讨论了VAE的广泛应用。VAE以其优雅的概率框架、稳定的训练、良好的隐空间结构,成为深度学习中最重要的生成模型之一。
&ememsp;VAE的一个特点是生成的图像通常偏模糊(因为高斯似然假设像素独立)。下一章我们将学习第四种生成模型——扩散模型(Diffusion Models)。扩散模型通过逐步添加噪声和学习去噪来生成数据,训练稳定,生成质量极高(当前图像生成的SOTA),DALL-E 2、Stable Diffusion、Midjourney等著名图像生成系统都基于扩散模型。扩散模型结合了VAE的稳定训练和GAN的高质量生成的优势。
&ememsp;下一章见!
更多推荐



 2
 0
- 0


 已为社区贡献42条内容

所有评论(0)