- @wangleigiser


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
想要更全面了解Spark内核和应用实战,可以购买我的新书。《图解Spark 大数据快速分析实战》(王磊))执行vim custom_env.sh ,修改custom_env.sh文件,添加如下内容:基于spark3.3.0编译编译结果2. spark-3.3.0 环境配置下载spark二进制压缩包并解压。spark环境配置:vim /etc/profile将编译好的spark-doris-conn
Apache doris profile文件获取和格式化

1、将本地文件拷贝到docker 镜像内docker cp 本地路径 容器Id或name:容器目录2、将docker内文件拷贝到本地文件夹内docker cp 容器Id或name:镜像路径 本地路径
Apache Doris2.0 基于Apache Doris向量化MPP引擎,增加了倒排索引和半结构化JSON数据支持,更好地满足日志存储、检索、分析需求。说明:建表语句中的 …是特殊语法,用于声明可以自动感知数据结构的变化。可以看下新增的log_type字段已经被自动识别。
Apache Doris2.0 基于Apache Doris向量化MPP引擎,增加了倒排索引和半结构化JSON数据支持,更好地满足日志存储、检索、分析需求。说明:建表语句中的 …是特殊语法,用于声明可以自动感知数据结构的变化。可以看下新增的log_type字段已经被自动识别。
想要更全面了解Spark内核和应用实战,可以购买我的新书。《图解Spark 大数据快速分析实战》(王磊)【摘要 书评 试读】- 京东图书1 什么是数据倾斜数据倾斜是指某些任务对应分区上的数据显著多于其他任务对应分区上的数据,从而导致这部分分区上数据的处理速度成为处理整个数据集的瓶颈。在Spark中,同一Stage内不同的任务可以并行执行,而不同Stage之间的任务可以串行执行。如图所示,假设一个S
在实现最优compaction策略时,我们必须考虑多个因素。一种方法是回收重复记录占用的空间,减少空间开销,但这会产生由不断重写表导致的更高的写放大。替代方案是避免连续重写数据,而这又增加了读放大(在读取期间协调关联到相同键的数据记录的开销)和空间放大(因为冗余记录会被保存更长时间)。读放大:由为了检索数据而需要读取多个表所引起。写放大: 由compaction过程中不断进行的重写所引起。空间放大
【代码】Java Stream Load写入数据到Doris。
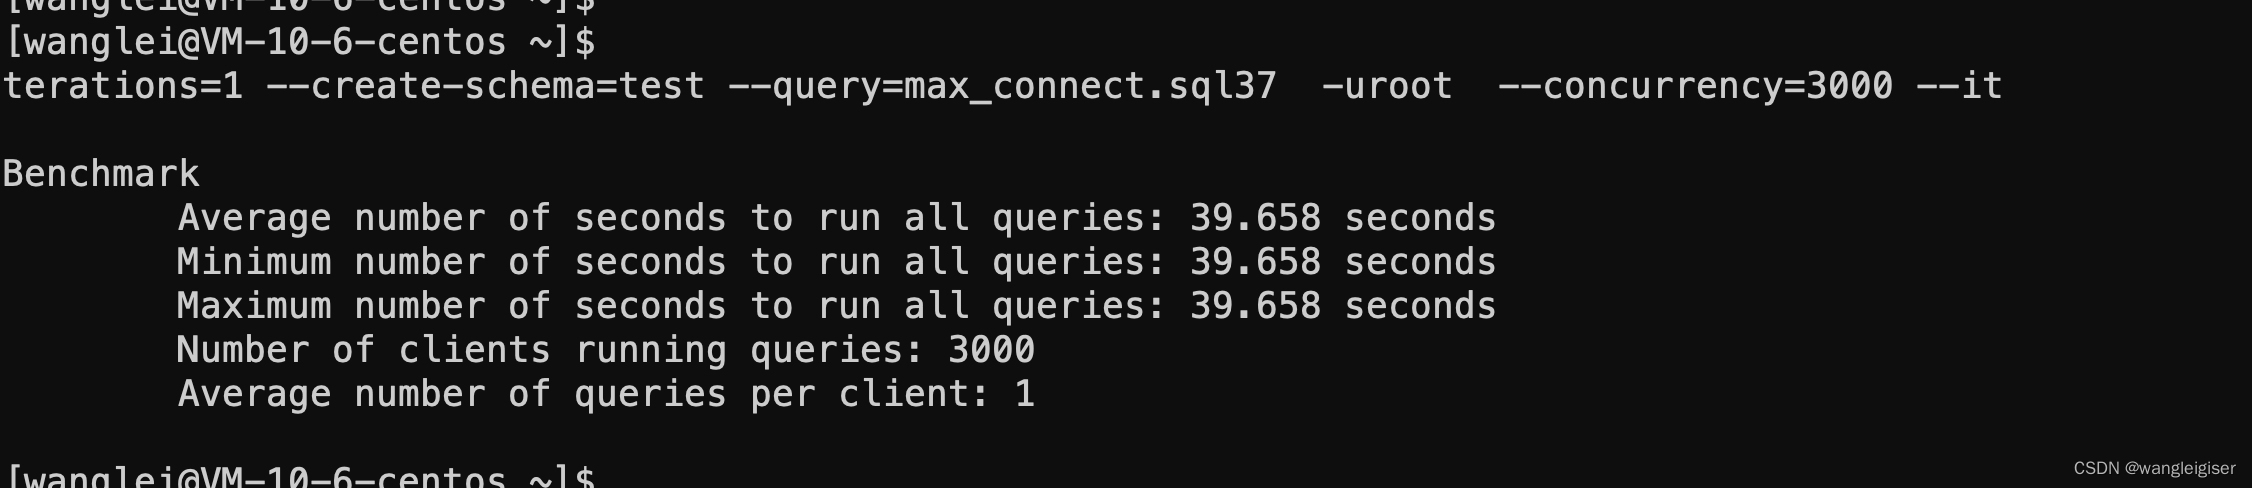
针对这种情况需要调整Doris最大连接数,具体做法如下。用户在使用Doris的时候,当访问用户过多时会报。