


- @m0_74640785


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
SQL优化不是一蹴而就的,需要持续观察、分析和调整。索引是利器,但同时也要用对地方。
本文介绍了在Python中使用Spark进行数据处理的基本操作。主要内容包括:1) 环境变量配置,设置JAVA_HOME、HADOOP_HOME等路径;2) 常见转换算子如map、flatMap、filter的使用方法;3) 触发算子count、foreach、saveAsTextFile的应用;4) 其他重要算子如reduce、join、sortBy等的功能演示;5) 分区操作算子reparti
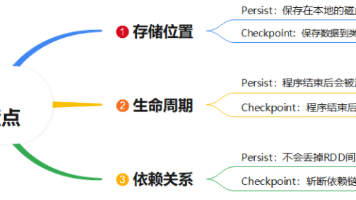
1、各个软件为了防止数据丢失都有哪些解决方案- a. 操作日志:将内存变化操作日志追加记录在一个文件中,下一次读取文件对内存重新操作- NAMENODE:元数据的操作日志记录在edits- MySQL:日志记录binlog ()- b. 副本机制:将数据构建多份冗余副本- HDFS:构建每个数据块的3个副本- c. 依赖关系:每份数据保留与其他数据之间的一个转换关系- RDD:保留RDD与其他RD
Flink 是批流一体实时计算引擎所有程序固定五步:env → Source → Transformation → Sink → execute核心算子:flatMap、map、keyBy、sum、reducekeyBy 是分组,不是排序并行度决定任务执行速度与吞吐量实时流测试推荐:Socket + Kafka离线批处理推荐:FileSource + 集合Lambda 写法必须显式声明返回类型。
CEP = Complex Event Processing 复杂事件处理。专门用来识别数据流中一组有顺序、有时间限制的事件组合,自定义匹配规则,抓取异常、风险、特定业务行为。
三体》,这部获世界科幻文学最高奖项雨果奖的作品以惊艳的"硬科幻"风被大家所熟知,其作者刘慈欣更是被誉为"单枪匹马将中国科幻提高到世界级水平"。作为三体中非常重要的角色,智子(Sophon)是将九维的质子进行二维展开,通过电路蚀刻改造成超级计算机后,再转回到微观的十一维来监控人类的一举一动,并利用量子纠缠实现瞬时通信报告给4光年之外的三体文明。说白了智子是三体文明部署在地球的AI实时远程监控和管理平
经过持续迭代与演进,LangChain 已从一个独立的开发框架,成长为一个覆盖智能体系统全生命周期的技术生态。该生态由四大核心支柱构成:LangChain、LangGraph、Deep Agent 与 LangSmith,它们分别面向开发、编排、自治、监控与评估,共同构建了一个从技术验证到生产部署、从单体智能到复杂协作的项目闭环。langchain 全家桶都有什么?
判断一个数值是否为null,如果为null,给一个默认值。
本文介绍了Hive数据操作实践,主要包括:1.在Linux环境下创建并加载两张测试表(exam_info和exam_record);2.演示UNION和UNION ALL的区别;3.讲解各种表连接方式(内连接、外连接、左半连接等);4.详细说明Hive复杂数据类型(Array、Map、Struct)的使用方法,包括数据加载、查询转换和聚合操作;5.介绍行转列技术及相关函数(explode、late