
Flink入门实战:8个经典案例吃透流处理基础(核心知识点+源码+注释)
🔥 前言:Flink 到底是什么?
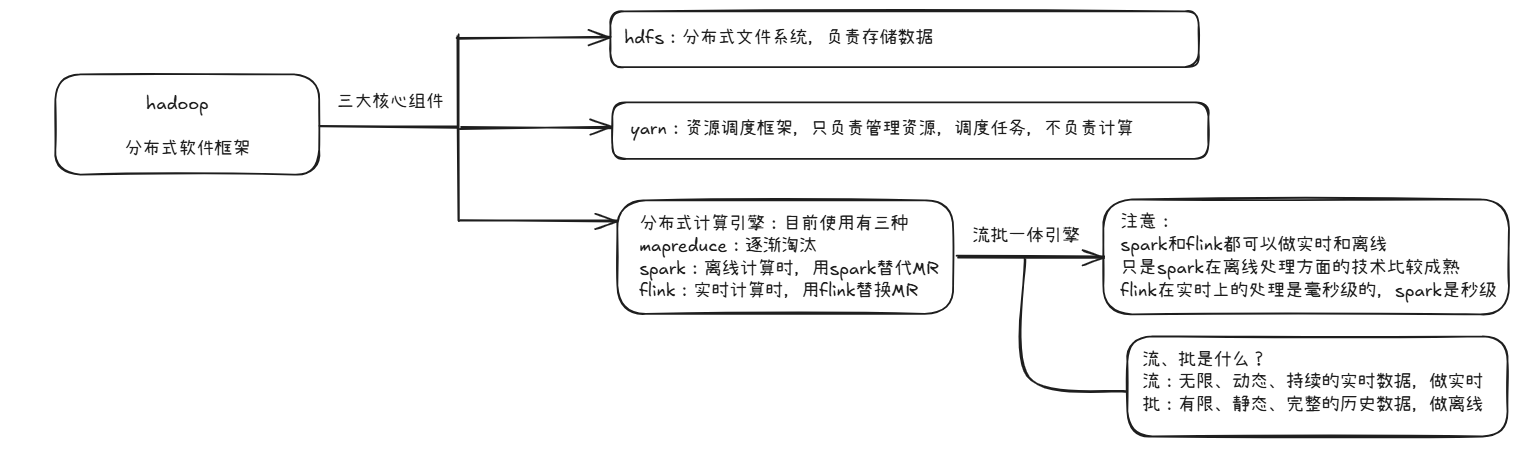
Apache Flink是一款分布式、高性能、高可用、低延迟的批流一体实时计算框架。
简单一句话:
- 既能做**离线批处理**(有界数据)
- 更擅长**实时流处理**(无界数据)
企业主流应用场景:
- 实时数仓、实时大屏、实时报表
- 实时风控、实时推荐、异常检测
- 日志分析、用户行为分析
- 实时ETL、数据同步、数据清洗
一、Flink 核心基础知识点
1. Flink 程序通用五步法:
1. 获取执行环境:`StreamExecutionEnvironment env`
2. 添加数据源:Source(文件、Socket、Kafka、集合、MySQL等)
3. 数据转换:Transformation(flatMap、map、keyBy、window、sum…)
4. 数据输出:Sink(print、文件、MySQL、Kafka、ES、ClickHouse…)
5. 触发执行:`env.execute()`
2. 有界流 vs 无界流
有界流:数据有开始、有结束 → 对应 批处理
无界流:数据源源不断、永不结束 → 对应 实时流处理
Flink 最大优势: 批流一体,一套代码支持两种场景。
3. Flink 三大 API 层级
- SQL / Table API:语法简单、开发速度快,适合实时统计和 ETL 场景。
- DataStream API:功能全面、灵活性高,是企业流式开发的核心 API。
- ProcessFunction API:最底层 API,可以直接操作状态、定时器和水印。
4. 入门必掌握核心算子
flatMap:对数据进行切分、打平,将一行数据转为多行。
map:一对一数据转换,用于格式修改、字段提取、数据加工。
filter:根据条件过滤不需要的数据。
keyBy:按照指定的 key 分组,是分布式聚合计算的基础。
sum /max/min:对数据进行简单聚合统计。
reduce:自定义聚合逻辑,适合复杂统计场景。
5. 并行度 Parallelism
并行度表示 Flink 任务多线程并行执行的能力。
并行度越高,处理速度越快,吞吐量越大。
优先级从高到低:算子设置 > 代码全局配置 > 集群默认配置。
6. 三种执行模式
STREAMING:流处理模式,默认使用,用于实时计算。
BATCH:批处理模式,用于离线批量计算。
AUTOMATIC:自动模式,由 Flink 根据数据源自动判断。
二、Flink 8 大入门实战案例(可直接运行)
Demo01:标准版单词计数(最经典、支持命令行传参)
package com.bigdata.day01;

import org.apache.flink.api.common.RuntimeExecutionMode;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.java.functions.KeySelector;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.api.java.utils.ParameterTool;
import org.apache.flink.connector.file.src.FileSource;
import org.apache.flink.connector.file.src.reader.TextLineInputFormat;
import org.apache.flink.core.fs.Path;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.KeyedStream;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.Collector;

public class Demo01 {
    public static void main(String[] args) throws Exception {
        // 1. 获取执行环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setRuntimeMode(RuntimeExecutionMode.STREAMING);
        env.setParallelism(2);

        DataStreamSource<String> dataStreamSource = null;

        // 2. 读取命令行参数 --input
        if (args.length != 0) {
            ParameterTool parameterTool = ParameterTool.fromArgs(args);
            if (parameterTool.has("input")) {
                String path = parameterTool.get("input");
                // 新版 FileSource
                FileSource<String> fileSource = FileSource
                        .forRecordStreamFormat(new TextLineInputFormat(), new Path(path))
                        .build();
                dataStreamSource = env.fromSource(fileSource, WatermarkStrategy.noWatermarks(), "filesource");
            }
        } else {
            // 无参数使用内置测试数据
            dataStreamSource = env.fromElements(
                    "spark flink kafka",
                    "spark sqoop flink",
                    "kafka hadoop flink"
            );
        }

        // 3. 数据处理:切分 → 键值对 → 分组 → 求和
        SingleOutputStreamOperator<String> flatted = dataStreamSource.flatMap(new FlatMapFunction<String, String>() {
            @Override
            public void flatMap(String line, Collector<String> out) {
                for (String word : line.split(" ")) out.collect(word);
            }
        });

        SingleOutputStreamOperator<Tuple2<String, Integer>> map = flatted.map(new MapFunction<String, Tuple2<String, Integer>>() {
            @Override
            public Tuple2<String, Integer> map(String word) {
                return Tuple2.of(word, 1);
            }
        });

        KeyedStream<Tuple2<String, Integer>, String> keyed = map.keyBy(new KeySelector<Tuple2<String, Integer>, String>() {
            @Override
            public String getKey(Tuple2<String, Integer> value) {
                return value.f0;
            }
        });

        // 4. 输出结果
        keyed.sum(1).print();

        // 5. 执行任务
        env.execute("wordcount");
    }
}
Demo02:Lambda 极简版单词计数(生产最常用)
package com.bigdata.day01;

import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.Collector;

public class Demo02 {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        env.fromElements("spark flink kafka", "spark sqoop flink", "kafka hadoop flink")
                .flatMap((String line, Collector<String> out) -> {
                    for (String w : line.split(" ")) out.collect(w);
                }).returns(Types.STRING)
                .map(w -> Tuple2.of(w, 1)).returns(Types.TUPLE(Types.STRING, Types.INT))
                .keyBy(t -> t.f0)
                .sum(1)
                .print();

        env.execute();
    }
}
✅ 重要注意
Lambda 写法**必须加 `.returns(...)` 声明返回类型**,否则 Flink 无法自动推断。
Demo03:新版 FileSource 读取文件(官方推荐)
package com.bigdata.day01;

import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.connector.file.src.FileSource;
import org.apache.flink.connector.file.src.reader.TextLineInputFormat;
import org.apache.flink.core.fs.Path;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class Demo03 {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        FileSource<String> source = FileSource.forRecordStreamFormat(
                new TextLineInputFormat(),
                new Path("datas/data.txt")
        ).build();

        env.fromSource(source, WatermarkStrategy.noWatermarks(), "file-source")
                .print();

        env.execute();
    }
}
Demo04:旧版 readFile 读取文件(兼容老版本)
package com.bigdata.day01;

import org.apache.flink.api.java.io.TextInputFormat;
import org.apache.flink.core.fs.Path;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class Demo04 {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        String path = "datas/data.txt";

        env.readFile(new TextInputFormat(new Path(path)), path).print();
        env.execute();
    }
}
Demo05:集合数据源(本地测试神器)
package com.bigdata.day01;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import java.util.Arrays;

public class Demo05 {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // 数字序列
        env.fromSequence(1, 10).print();

        // 固定元素
        env.fromElements("spark", "flink", "kafka").print();

        // 集合
        env.fromCollection(Arrays.asList("老王", "老闫", "老张")).print();

        env.execute();
    }
}
Demo06:Socket 实时流(最常用测试源)
先开终端监听端口:nc -lk 8888
package com.bigdata.day01;

import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class Demo06 {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.socketTextStream("localhost", 8888).print();
        env.execute();
    }
}
Demo07:Socket 实时单词计数
package com.bigdata.day01;
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class Demo07 {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        env.socketTextStream("localhost", 8888)
                .flatMap((line, out) -> {
                    for (String w : line.split(" ")) out.collect(w);
                }).returns(Types.STRING)
                .map(w -> Tuple2.of(w, 1))
                .returns(Types.TUPLE(Types.STRING, Types.INT))
                .keyBy(t -> t.f0)
                .sum(1)
                .print();

        env.execute("socket-wordcount");
    }
}
Demo08:命令行参数工具类使用
package com.bigdata.day01;

import org.apache.flink.api.java.utils.ParameterTool;

public class Demo08{
    public static void main(String[] args) {
        ParameterTool tool = ParameterTool.fromArgs(args);
        String input = tool.get("input");
        System.out.println(input);
    }
}
运行时传参:
--input datas/data.txt
三、Flink 入门核心总结
- Flink 是批流一体实时计算引擎
- 所有程序固定五步:env → Source → Transformation → Sink → execute
- 核心算子:flatMap、map、keyBy、sum、reduce
- keyBy 是分组,不是排序
- 并行度决定任务执行速度与吞吐量
- 实时流测试推荐:Socket + Kafka
- 离线批处理推荐:FileSource + 集合
- Lambda 写法必须显式声明返回类型
更多推荐


 7
 0
- 0


 已为社区贡献9条内容

所有评论(0)