
Spark RDD 容错机制深度剖析
1、各个软件为了防止数据丢失都有哪些解决方案
- a. 操作日志:将内存变化操作日志追加记录在一个文件中,下一次读取文件对内存重新操作
- NAMENODE:元数据的操作日志记录在edits
- MySQL:日志记录binlog ()
- b. 副本机制:将数据构建多份冗余副本
- HDFS:构建每个数据块的3个副本
- c. 依赖关系:每份数据保留与其他数据之间的一个转换关系
- RDD:保留RDD与其他RDD之间的依赖关系
2、Spark如何保障数据的安全
每个RDD在构建数据时,会根据自己来源一步步倒 导 到数据来源,然后再一步步开始构建RDD数据。
问题:如果一个RDD被触发多次,这个RDD就会按照依赖关系被构建多次,性能相对较差,怎么解决?
例如:日志分析的时候,三个问题,tupleRdd 之前的所有操作都要执行三次,每次读取100M多的数据,效率非常的低
- 第一次:一定会通过血脉构建这个RDD的数据
- 希望从第二次开始,就不要重复构建,直接使用第一个构建的内容
- 实现:Spark持久化机制:主动将RDD进行保存,供多次使用,避免重复构建
1、RDD容错机制:persist持久化机制
将计算好的中间结果临时存起来,避免重复计算
优先存储到Executor内存,内存不够再溢写到节点本地磁盘
任务运行时,缓存有效,任务结束或崩溃,缓存全部消失
特点:快,临时,依赖链条不切断
使用场景:加速重复使用的 DF、RDD
主要有两种写法:
1)cache算子 转换算子
- 功能:将RDD缓存在内存中
- 语法:cache()
- 本质:底层调用的还是persist(StorageLevel.MEMORY_ONLY),但是只缓存在内存,如果内存不够,缓存会失败
- 场景:资源充足,需要将RDD仅缓存在内存中
2)persist算子
- 功能:将**RDD**【包含这个RDD的依赖关系】进行缓存,可以**自己指定缓存的级别**【和cache区别】
- 语法:`persist(StorageLevel)`
- 级别:StorageLevel决定了缓存位置和缓存几份
场景:根据资源情况,将RDD缓存在不同的地方或者缓存多份
Spark的StorageLevel共有9个缓存级别:
DISK_ONLY:缓存入硬盘。这个级别主要是讲那些庞大的Rdd,之后仍需使用但暂时不用的,放进磁盘,腾出Executor内存。
DISK_ONLY_2:多一个缓存副本。
MEMORY_ONLY:只使用内存进行缓存。这个级别最为常用,对于马上用到的高频rdd,推荐使用。
MEMORY_ONLY_2:多一个缓存副本。
MEMORY_AND_DISK:先使用内存,多出来的溢出到磁盘,对于高频的大rdd可以使用。
MEMORY_AND_DISK_2:多一个缓存副本。
OFF_HEAP:除了内存、磁盘,还可以存储在OFF_HEAP
项目中常用的如下:
MEMORY_AND_DISK_2
MEMORY_AND_DISK_DESER
3)unpersist 算子 --释放缓存
- 功能:将缓存的RDD进行释放
- 语法:`unpersist`
- unpersist(blocking=True):等释放完再继续下一步
- 场景:明确RDD已经不再使用,后续还有很多的代码需要执行,将RDD的数据从缓存中释放,避免占用资源
- 注意:如果不释放,这个Spark程序结束,也会释放这个程序中的所有内存
4)综合案例
"""
------------------------------------------
  SourceFile : Demo01
  Author  : xiaoyang
-------------------------------------------
"""
import os
from time import sleep

from pyspark import SparkContext, SparkConf
from pyspark.storagelevel import StorageLevel

if __name__ == '__main__':
    os.environ['JAVA_HOME'] = r'D:\app\jdk\jdk1.8.0_181'
    os.environ['HADOOP_HOME'] = r'D:\app\hadoop\hadoop3.1.4\hadoop-3.1.4'
    os.environ['PYSPARK_PYTHON'] = r'C:\Users\86184\miniconda3\python.exe'
    os.environ['PYSPARK_DRIVER_PYTHON'] = r'C:\Users\86184\miniconda3\python.exe'
    conf = SparkConf().setMaster("local[*]").setAppName("第一个Spark程序")
    sc = SparkContext(conf=conf)
    rd=sc.textFile("../../datas/sparkdata/person.json")
    # rd.persist(storageLevel=StorageLevel.MEMORY_AND_DISK)
    # 相当于
    rd.cache()
    # cache() = 强制把结果缓存到内存 下次用不再重新重跑一遍  用完一定要释放:
    rd.foreach(lambda x: print(x))
    sleep(10)
    rd.foreach(lambda x: print(x))
    rd.unpersist(blocking=True)  # 清空缓存释放内存
    # blocking=True = 阻塞等待,必须等缓存彻底删完,代码才继续往下走
    sc.stop()
5)结果展示
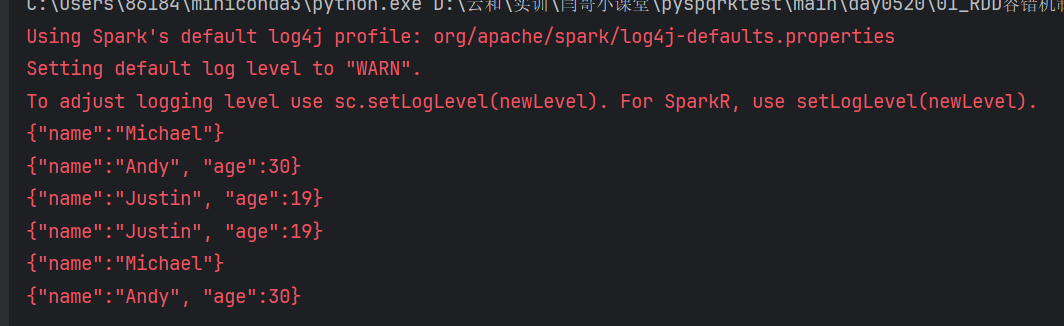
默认情况下,完全没有任何缓存:同一 RDD 每次行动算子,都会重新从头读文件、重算
加了 cache:第一次算完存内存,第二次直接读缓存,不再重读重算
2、RDD容错机制:checkpoint检查点机制
checkpoint(检查点):将数据彻底存储到可靠存储(HDFS、本地),切断依赖链
只要不删除,数据还在就能读取
特点:比cache慢,可靠、容错、数据永久不丢、切断依赖链
1)综合案例
"""
------------------------------------------
  SourceFile : 02_RDD容错机制_checkpoint检查点机制
  Author  : xiaoyang
-------------------------------------------
"""
import os
from pyspark import SparkContext, SparkConf

if __name__ == '__main__':
    os.environ['JAVA_HOME'] = r'D:\app\jdk\jdk1.8.0_181'
    os.environ['HADOOP_HOME'] = r'D:\app\hadoop\hadoop3.1.4\hadoop-3.1.4'
    os.environ['PYSPARK_PYTHON'] = r'C:\Users\86184\miniconda3\python.exe'
    os.environ['PYSPARK_DRIVER_PYTHON'] = r'C:\Users\86184\miniconda3\python.exe'
    conf = SparkConf().setMaster("local[*]").setAppName("第一个Spark程序")
    sc = SparkContext(conf=conf)

    # Persist/Cache:存内存 / 磁盘,任务一停就丢
    # Checkpoint:存 HDFS / 本地磁盘,永久保存,断了也能恢复,只能手动删除
    sc.setCheckpointDir("../../datas/checkpoint/ck01/")
    rd=sc.textFile("../../datas/sparkdata/person.json")
    rd.checkpoint()
    rd.foreach(lambda x: print(x))

    sc.stop()
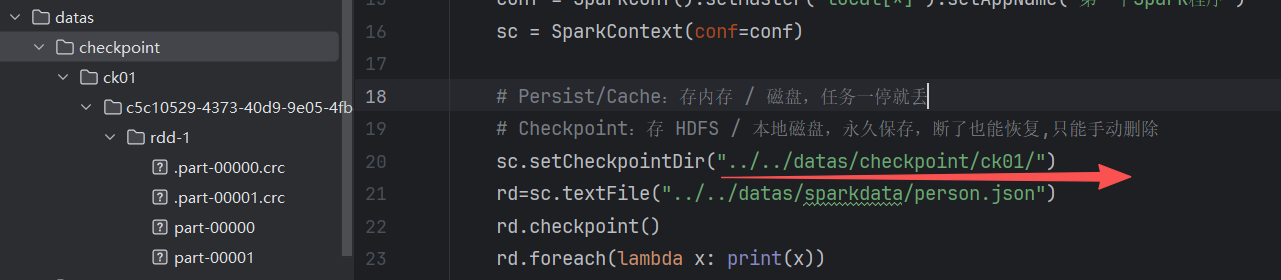
2)结果展示
在指定的位置生成文件
3、区别对比
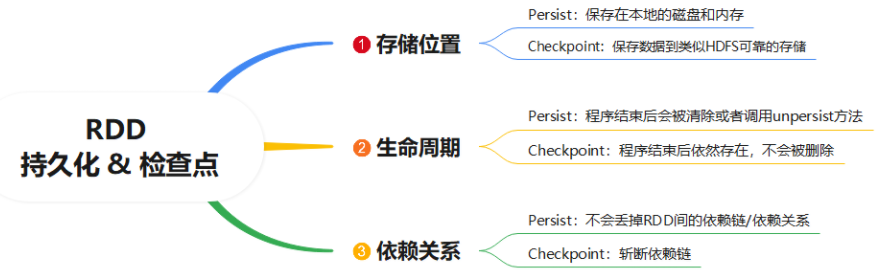
- 存储位置
- persist:将RDD缓存在内存或者磁盘中
- chk:将RDD的数据存储在文件系统磁盘中
- 生命周期
- persist:当代码中遇到了unpersist或者程序结束,缓存就会被自动清理
- chk:检查点的数据是不会被自动清理的,只能手动删除
- 存储内容
- persist:会保留RDD的血脉关系,如果缓存丢失,可以通过血脉进行恢复
- chk:会斩断RDD的血脉关系,不会保留RDD的血脉关系的
更多推荐


 12
 0
- 0


 已为社区贡献9条内容

所有评论(0)