


- @Start_mswin


简介
日常生活 | 软件测试与分享 | 影音娱乐 ❤️分享一切喜欢的东西 首席生活家・数码领域作者・软件领域爱好者
擅长的技术栈
可提供的服务
暂无可提供的服务
还记得我们第一次把2亿条订单数据拆成16个分片段上线的那天,本来信心满满觉得性能肯定能起飞,结果上线刚十分钟告警就炸了:订单列表接口超时率冲到35%,订单count统计接口最长要15秒返回,运营翻列表到第30页直接把ShardingProxy节点干OOM,整个订单链路卡了20多分钟,最后紧急切回单库回滚代码,全组加班排查了一整夜。很多人觉得分库分表是解决大数据量性能问题的银弹,把表一拆就万事大吉,
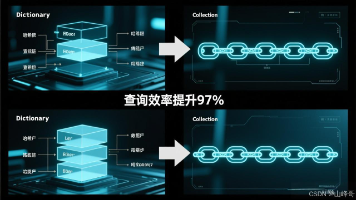
"某银行反洗钱系统凌晨突发故障——因Collection遍历50万条交易记录耗时3分17秒,导致实时监控中断,3笔可疑交易未被拦截,直接被监管罚款280万元!而同一团队改用Dictionary重构后,查询时间骤降至0.8秒,效率提升238倍!为什么95%的VBA开发者还在用‘龟速’的Collection? 数据结构选错,代码性能可能差1000倍!
你是否遇到过这样的场景:业务高峰期系统突然告警,页面加载从平时的1秒变成十几秒,用户投诉量瞬间上涨,运维团队排查半天最后发现只是一条不起眼的SQL语句拖垮了整个数据库。在实际的生产环境里,80%以上的数据库性能问题都不是硬件瓶颈,而是SQL编写不规范、索引设计不合理导致的。很多开发同学写完SQL就直接上线,等到数据量突破百万、千万级别之后,原本运行正常的查询突然变得卡顿,甚至引发连锁反应拖垮整个服

当你在处理TB级日志数据时,是否还在为单节点处理速度发愁?当Hadoop集群资源调度出现瓶颈,是否想过优化MapReduce代码就能提升300%效率?本文将带你深入Java MapReduce编程模型的核心,从源码级解析Mapper/Reducer设计原理,手把手教你写出能处理PB级数据的分布式计算程序。准备好迎接大数据时代的性能飞跃了吗
数据核对还在逐行比对?财务小王用传统方法核对10万行数据耗时3天,出错率高达15%!本文揭秘金融级数据对比方案:通过VBA+SQL双引擎驱动,实现Excel与数据库实时同步对比,自动高亮差异单元格并生成可视化报告,某银行实施后数据核对效率提升92%,错误率归零!
“每天被Tableau中的数据清洗折磨得心力交瘁?数据源里存在数据缺失、数据不一致、数据格式混乱,还有各种关联问题……手动处理繁琐又容易出错,效率低下?今天这篇超实用的干货,将彻底终结你的Tableau数据清洗难题!
如果你也好奇:为什么 AI 能 “看懂” 照片、“听懂” 语言、还能 “创造” 新事物?为什么同样是深度学习,不同网络的擅长领域天差地别?这篇文章就带你剥茧抽丝,用最通俗的逻辑、最贴近生活的案例,彻底搞懂 CNN、RNN、GAN 的核心原理与应用场景,让你从 “只会用 AI” 的普通人,秒变 “懂 AI 底层逻辑” 的入门大师。
站在2026年的门槛回望,后端架构正经历着从“云原生微服务”向“AI原生智能体”的剧烈跨越。本文结合最新的行业数据与CSDN写作规范,深度解析Kubernetes、云原生超融合与AI Agent的工程化落地,并提供一套可直接复制的Spring Boot高规范后端架构实战指南。
做过电商后台开发的人,大概率都遇到过这样的崩溃时刻:大促结束后的第一个工作日,运营同学要拉取上个月的全平台订单数据做复盘,提交查询之后页面转了整整三分钟,最后直接抛出504超时错误。登上数据库后台一看,这条订单统计SQL已经跑了187秒,把从库的CPU直接拉到100%,连带影响了十几个依赖从库的报表接口,整个运营后台直接瘫痪了半小时。团队里的同学轮番上阵,给where条件里的字段挨个加索引,折腾了

去年双11前一周,我们电商平台的订单库突然触发P0级CPU告警,峰值直接冲到98%,后台堆了三千多条慢查询,订单创建接口超时率一度超过15%,运营那边催着说用户付不了钱要投诉。整个技术组熬了一整夜排查,最后只改了3条SQL,加了2个联合索引,就把库的QPS从200拉到了3200,CPU直接降到了20%以下,顺利扛过了双11的流量峰值。很多人觉得SQL优化是DBA的专属工作,和普通业务开发没关系,但
