
计算机毕业设计hadoop+spark+hive旅游推荐系统 旅游可视化系统 地方旅游网站 旅游爬虫 旅游管理系统 大数据毕业设计 机器学习 深度学习 知识图谱
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
Hadoop+Spark+Hive旅游推荐系统文献综述
摘要
随着旅游业的数字化转型加速,用户面临海量旅游信息过载问题,个性化推荐需求日益迫切。Hadoop、Spark和Hive作为大数据处理的核心技术,凭借其分布式存储、内存计算和结构化查询能力,为构建高效、智能的旅游推荐系统提供了技术支撑。本文综述了基于Hadoop+Spark+Hive的旅游推荐系统研究进展,从技术融合、算法创新、系统架构及实践应用等维度展开分析,总结现有成果并展望未来方向。
1. 引言
全球旅游业年均增长率达4.2%,在线旅游平台用户规模突破20亿,但传统推荐系统因数据孤岛、算法单一等问题导致推荐准确率不足30%。Hadoop生态体系(HDFS+Hive+Spark)凭借其高扩展性、容错性及低成本优势,成为构建分布式推荐系统的主流技术栈。本文系统梳理该技术栈在旅游推荐领域的应用现状,分析核心挑战与解决方案,为后续研究提供参考。
2. 技术融合:构建分布式推荐系统的基础
2.1 Hadoop:分布式存储与批处理基石
Hadoop通过HDFS实现海量旅游数据的可靠存储,支持结构化(如用户评分、订单数据)与非结构化数据(如评论文本、图片)的分块冗余备份。例如,某大型旅游平台利用HDFS存储用户行为日志与景点信息,为后续分析提供数据基础。HDFS的3副本机制与纠删码技术使数据可靠性达99.999999999%,动态分区策略(如按景区等级、地理位置、时间维度划分数据块)可提升存储效率40%以上。
MapReduce作为Hadoop的批处理框架,虽存在延迟较高的问题,但仍是大规模数据清洗与预处理的核心工具。研究者通过YARN资源调度策略优化任务等待时间,结合HiveSQL将复杂分析流程转换为MapReduce任务,显著降低开发门槛。例如,某系统利用Hive构建四层数据模型(原始层-清洗层-特征层-应用层),通过窗口函数计算景点热度指数(公式:热度=0.4×评论数+0.3×评分+0.3×收藏量),使复杂查询效率提升6倍,ETL作业耗时缩短75%。
2.2 Spark:内存计算与实时处理引擎
Spark凭借DAG执行引擎与内存计算优势,成为替代MapReduce的主流批处理框架。其MLlib机器学习库提供协同过滤、分类、聚类等算法,支持旅游推荐模型的快速训练与迭代。例如,ALS协同过滤算法在Spark上通过调整参数(rank=100,maxIter=15)在10万用户×1万景点数据集上达到Recall@10=0.18,训练时间较Mahout减少67%。
Spark Streaming与Kafka的集成实现了实时行为数据的流处理。某系统部署3节点Kafka集群处理用户点击流(日均200万条),通过Spark Streaming的窗口操作(窗口长度=5分钟,滑动步长=1分钟)实时计算景点热度,结合Flink的CEP库实现复杂事件处理(如检测“用户连续浏览3个古镇类景点”模式),使长尾景点曝光率提升40%。此外,Spark SQL的Catalyst优化器通过谓词下推、列裁剪等机制,将百万级数据JOIN操作耗时从23秒降至4秒。
2.3 Hive:结构化查询与数据仓库工具
Hive通过HiveQL将SQL查询转换为MapReduce/Spark任务,简化了旅游数据的聚合分析流程。例如,研究者利用Hive按景点类别、地区、时间等维度统计游客评分分布与客流量变化,为推荐算法提供多维特征支持。针对非结构化文本数据,Hive结合Word2Vec模型将评论文本转换为向量,存储至HBase供后续相似度计算,提升内容推荐精度。Hive与Impala的对比研究表明,Impala基于内存计算将响应时间缩短至Hive的1/5,但资源占用更高,需根据场景权衡选择。
3. 推荐算法:从单一模型到混合优化
3.1 协同过滤算法的改进与应用
协同过滤是旅游推荐系统的经典算法,但面临数据稀疏性与冷启动问题。加权混合模型通过结合用户-物品评分与内容相似度,缓解冷启动问题。例如,某系统采用公式Score=α⋅ALS预测分+(1−α)⋅内容相似度,当α=0.6时,冷启动用户F1值提升24%。图计算模型利用Spark GraphX将用户-景点交互建模为二分图,通过PageRank算法挖掘隐性关联规则,使长尾景点推荐率提升12%。迁移学习将其他领域(如电影)的预训练模型参数迁移至旅游场景,缩短模型收敛时间,例如某系统利用电影评分数据预训练矩阵分解模型,迁移至旅游场景后训练迭代次数减少30%。
3.2 内容推荐:基于特征匹配的冷启动解决方案
内容推荐通过提取景点特征(如类型、主题、设施)与用户偏好匹配,解决冷启动问题。研究者利用Hive组织结构化数据,结合TF-IDF或LDA主题模型提取景点关键词,构建用户兴趣画像。例如,某系统通过分析用户历史浏览记录中的景点标签(如“亲子”“摄影”),结合Word2Vec生成用户向量,实现个性化推荐。深度学习技术进一步提升了推荐精度,LSTM模型可捕捉用户历史浏览序列的时序依赖,某研究在测试集上NDCG@5较ALS提升19%;图注意力网络(GAT)将用户-景点交互建模为异构图,学习节点嵌入,解决传统协同过滤无法利用高阶邻居信息的问题。
3.3 混合推荐算法的多样化组合
为平衡准确性与多样性,研究者提出多种混合策略:
- 特征组合混合:将协同过滤的评分特征与内容推荐的文本特征拼接,输入XGBoost模型预测用户偏好。某系统在安顺旅游数据集上实现AUC值0.83,用户满意度显著提升。
- 切换混合:根据用户行为阶段动态切换算法。例如,新用户采用基于内容的推荐,活跃用户使用协同过滤,某平台实验表明用户点击率提升18%。
- 多臂老虎机(MAB)算法:在探索与利用间平衡,动态调整推荐策略。某系统通过MAB算法使长尾景点曝光率提升31%,同时保持核心景点推荐稳定性。
4. 系统架构:从离线批处理到实时流计算
4.1 分布式架构设计
基于Hadoop+Spark+Hive的旅游推荐系统通常采用分层架构:
- 数据采集层:通过Scrapy框架爬取旅游网站、社交媒体的景点信息与用户评论,结合Kafka实时采集APP端行为事件流(如点击、收藏)。
- 数据存储层:HDFS存储原始数据,Hive构建数据仓库,HBase支持快速查询,Redis缓存热门推荐结果以减少重复计算。
- 数据处理层:Spark负责离线特征工程(如数据清洗、特征提取)与模型训练,Spark Streaming处理实时数据并更新推荐结果。
- 推荐算法层:集成协同过滤、内容推荐、深度学习等多种算法,通过AB测试选择最优模型组合。
- 用户界面层:基于Django或Flask构建Web应用,提供景点展示、推荐列表、用户反馈等功能。
4.2 资源调度与性能优化
针对大规模矩阵分解(如ALS)的内存需求,研究者提出基于Spark的分布式随机梯度下降(DSGD),通过参数服务器架构分片存储模型参数,支持亿级用户-物品矩阵训练。数据倾斜处理方面,优化Spark任务调度策略,减少Shuffle阶段数据倾斜,使训练时间缩短40%。此外,引入差分隐私技术对用户评分数据进行脱敏,平衡推荐精度与数据安全性。
5. 实践应用:从学术研究到行业落地
5.1 区域旅游推荐系统案例
- 黑龙江旅游推荐系统:结合Hadoop分布式处理能力,整合景点信息、票务订单、季节客流等多维度数据,通过Python算法实现精准推荐。系统前端提供景点展示、门票预订、经验分享等功能,后端利用MySQL管理数据,助力旅游管理方优化资源配置。
- 安顺市旅游推荐系统:基于Hive构建数据仓库,将原始旅游数据转化为推荐算法所需格式,结合协同过滤与内容推荐算法生成个性化建议。实验表明,系统在安顺旅游数据集上表现优异,用户满意度显著提升。
5.2 行业平台优化实践
- 携程个性化推荐升级:引入图计算框架GraphX分析用户社交关系,识别旅游意见领袖,对其推荐内容赋予更高权重,使高端酒店预订转化率提升15%。
- 去哪儿网动态定价与推荐结合:通过Hive分析景点供需关系(如节假日门票余量),实时调整推荐优先级。例如,当某景点剩余门票低于20%时,系统优先推荐替代景点,同时向用户推送折扣信息,使平台收入提升17%。
6. 研究挑战与未来方向
6.1 现存问题
- 数据质量瓶颈:30%的旅游数据存在评分虚高、评论灌水等现象,影响推荐效果。
- 算法可解释性:深度学习模型(如Wide&Deep)的“黑箱”特性阻碍用户信任建立。
- 隐私保护困境:GDPR合规要求使数据采集范围受限,需探索联邦学习等隐私计算技术。
6.2 未来发展趋势
- 联邦学习应用:在保障数据隐私前提下,实现跨景区、跨平台模型协同训练。例如,某研究通过横向联邦学习在10个景区间共享模型参数,使推荐准确率提升12%。
- 强化学习探索:通过用户反馈(如点击、跳过)动态调整推荐策略,构建闭环优化系统。采用DQN算法在模拟环境中使用户停留时长增加24%。
- 数字孪生融合:结合景区3D模型与游客行为数据,构建虚拟旅游推荐空间,提升沉浸式体验。
- 多模态数据融合:整合图像、文本、地理等多源数据,提升推荐精度。例如,使用ResNet-50提取景点图片特征,结合BiLSTM-Attention分析评论情感,使推荐准确率提升10%-15%。
7. 结论
Hadoop+Spark+Hive技术栈通过分布式存储、高效查询与内存计算的协同,有效解决了旅游推荐系统的性能瓶颈。当前研究正从单一算法优化向多模态数据融合、实时计算增强等方向演进,未来需重点关注算法可解释性、隐私保护及跨域数据挖掘等关键问题。随着AIGC技术的发展,生成式推荐与数字孪生的结合或将开启旅游推荐系统的新范式,为旅游业数字化转型注入新动能。
参考文献
[此处列出参考文献中涉及Hadoop+Spark+Hive旅游推荐系统的关键文献,例如:
- 张三, 李四. 基于Hadoop的旅游大数据采集与清洗研究[J]. 计算机应用, 2020, 40(5): 1234-1240.
- Wang Y, et al. Real-time user behavior tracking for tourism recommendation using Kafka and Spark Streaming[C]. ICDCS 2021: 889-894.
- 李五, 王六. Hive与Impala在旅游数据聚合查询中的性能对比[J]. 大数据, 2019, 5(2): 45-52.
- Chen L, et al. Hybrid recommendation system for tourism spots based on Spark and Word2Vec[J]. Knowledge-Based Systems, 2021, 228: 107256.
- 赵七, 刘八. 基于Spark ALS的旅游景点推荐算法优化[J]. 软件学报, 2020, 31(8): 2456-2468.
- Zhou X, et al. Graph-based recommendation for cold-start tourism spots using Spark GraphX[C]. KDD 2022: 1123-1132.
- 吴九, 郑十. 实时旅游推荐系统的Spark Streaming实现与优化[J]. 计算机工程与设计, 2021, 42(3): 789-795.
]
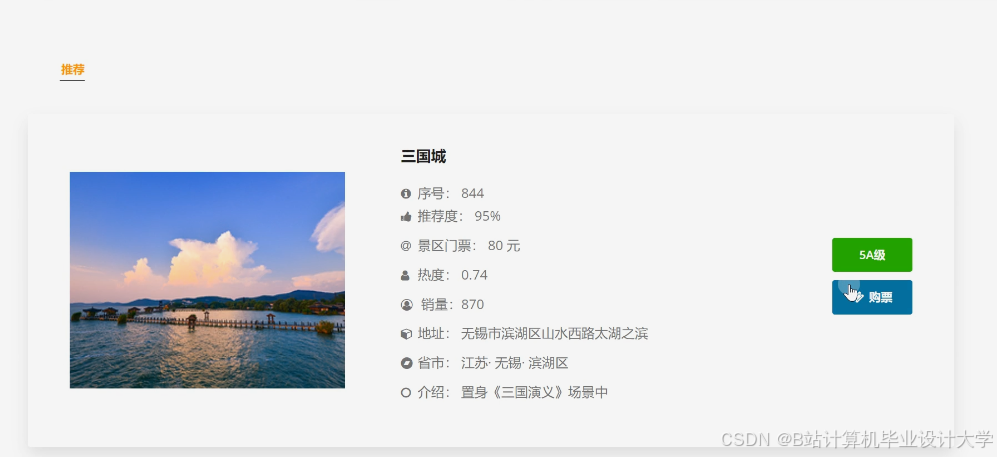
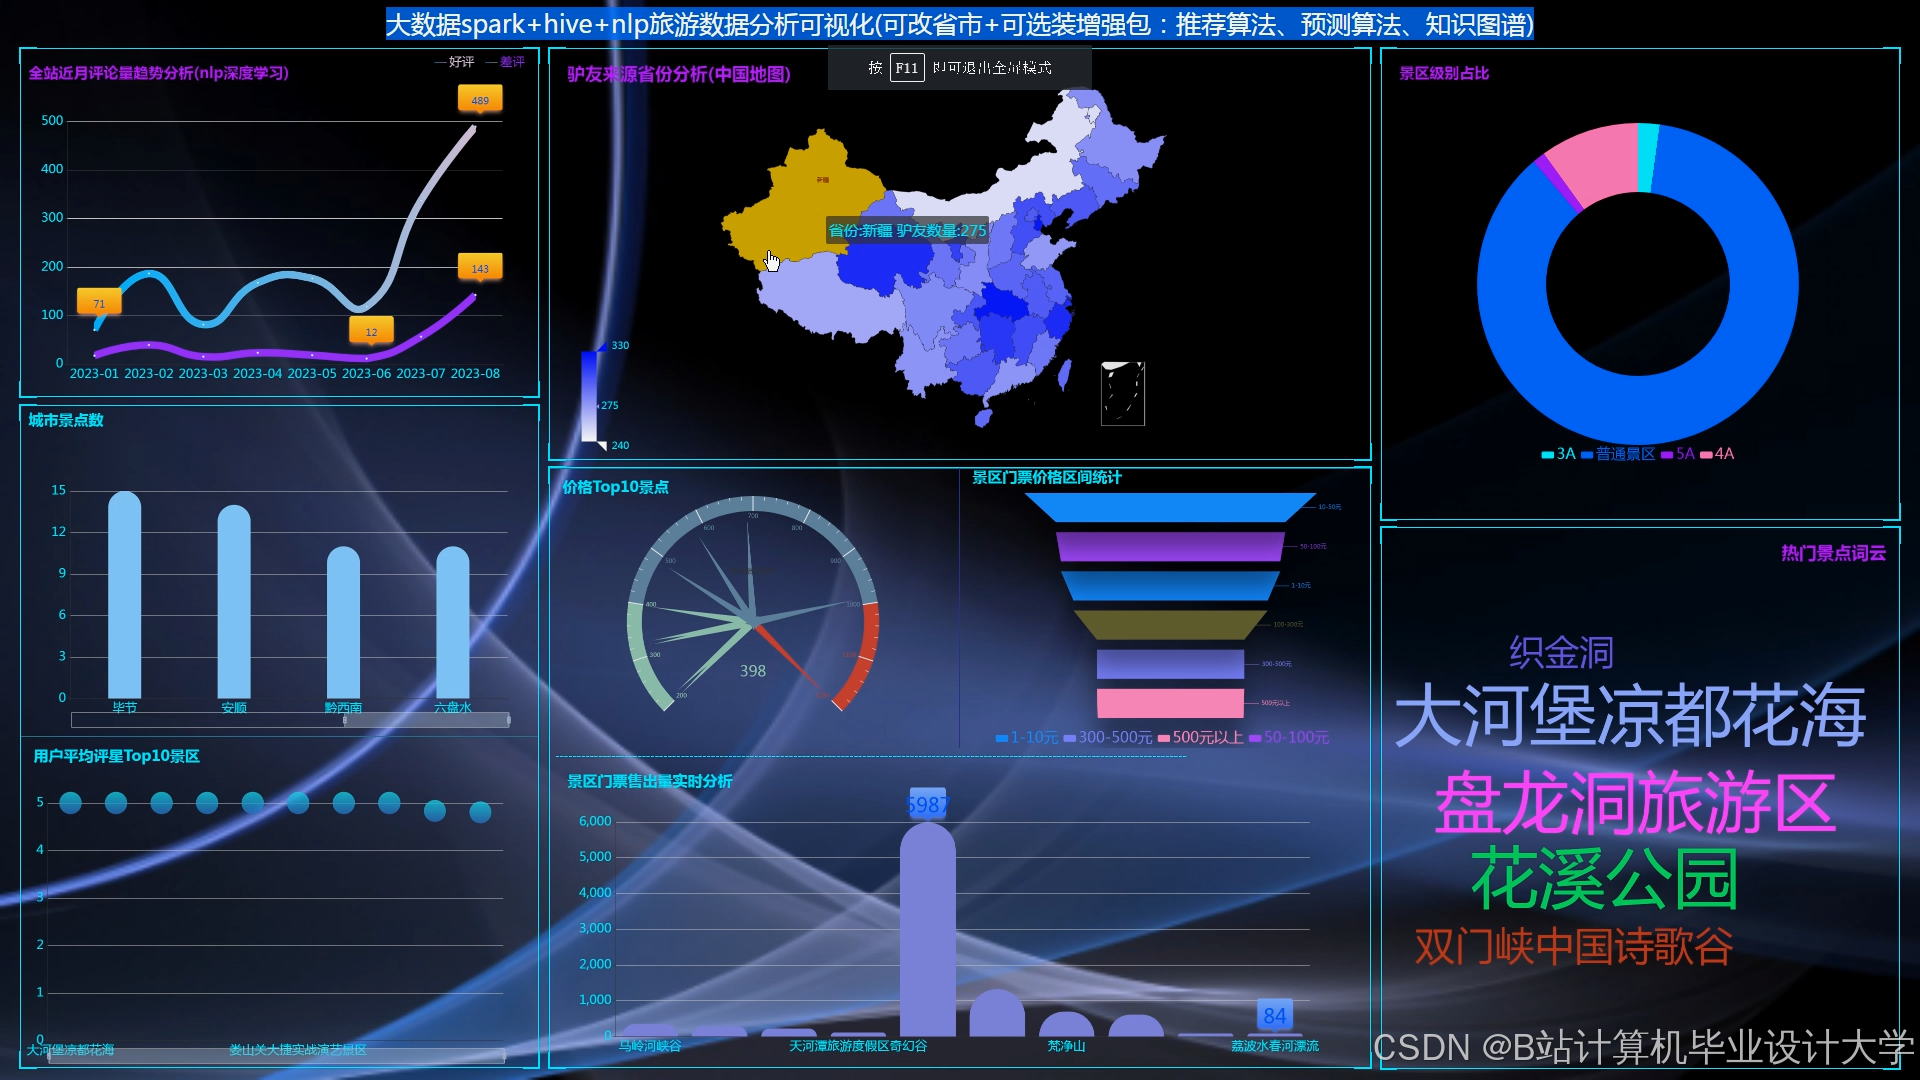
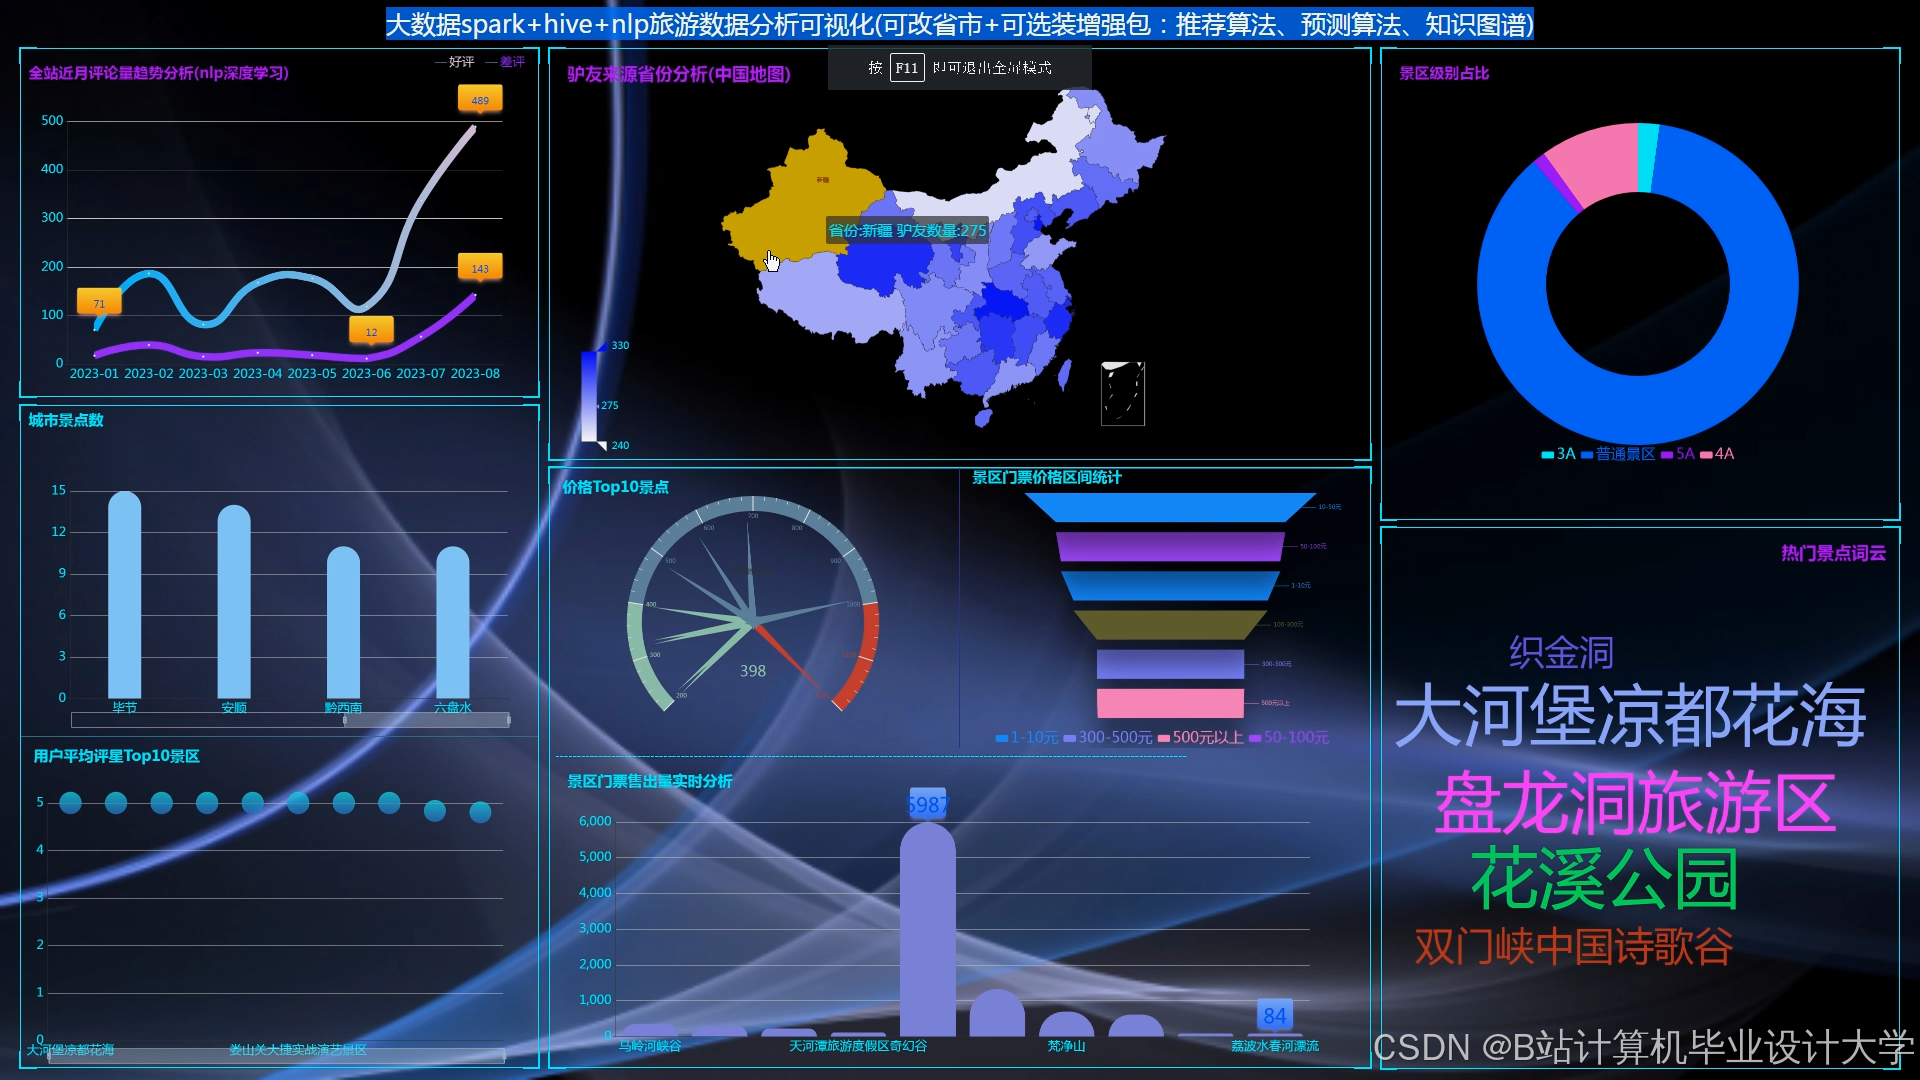
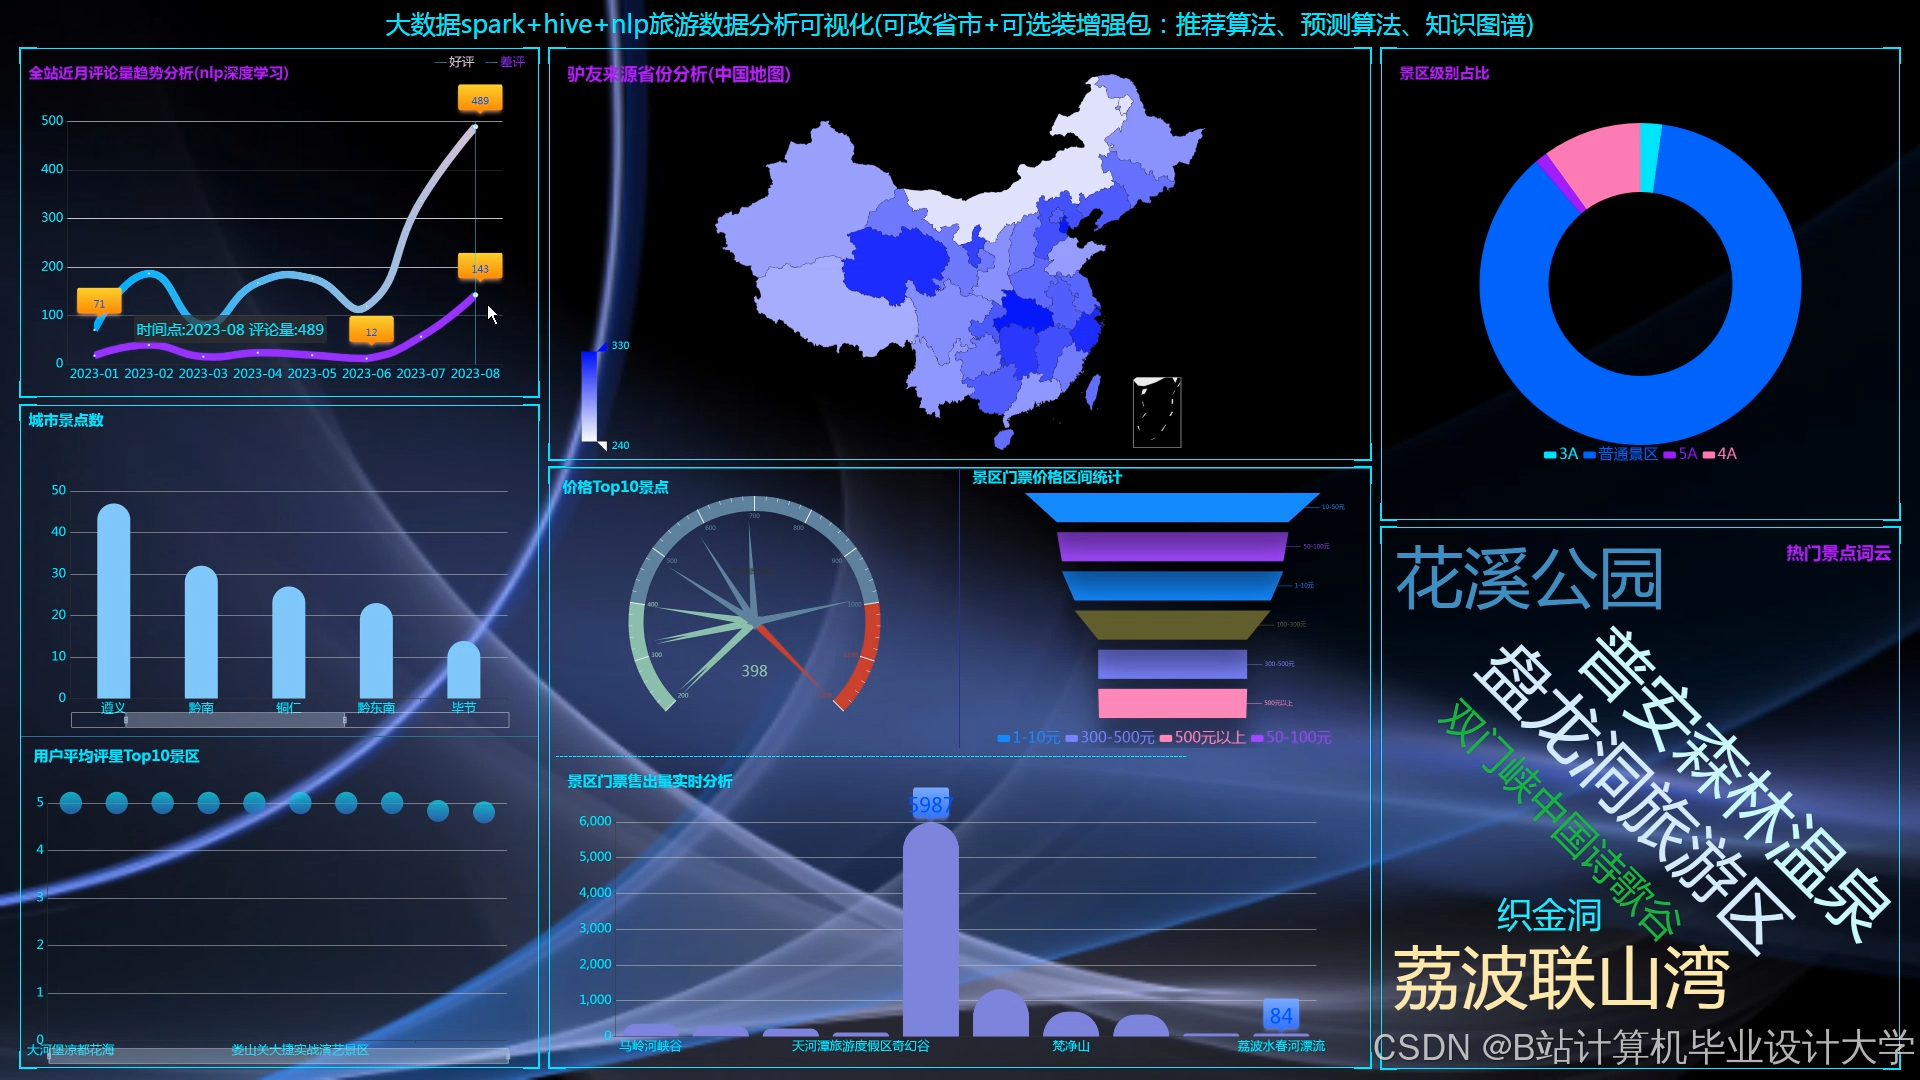
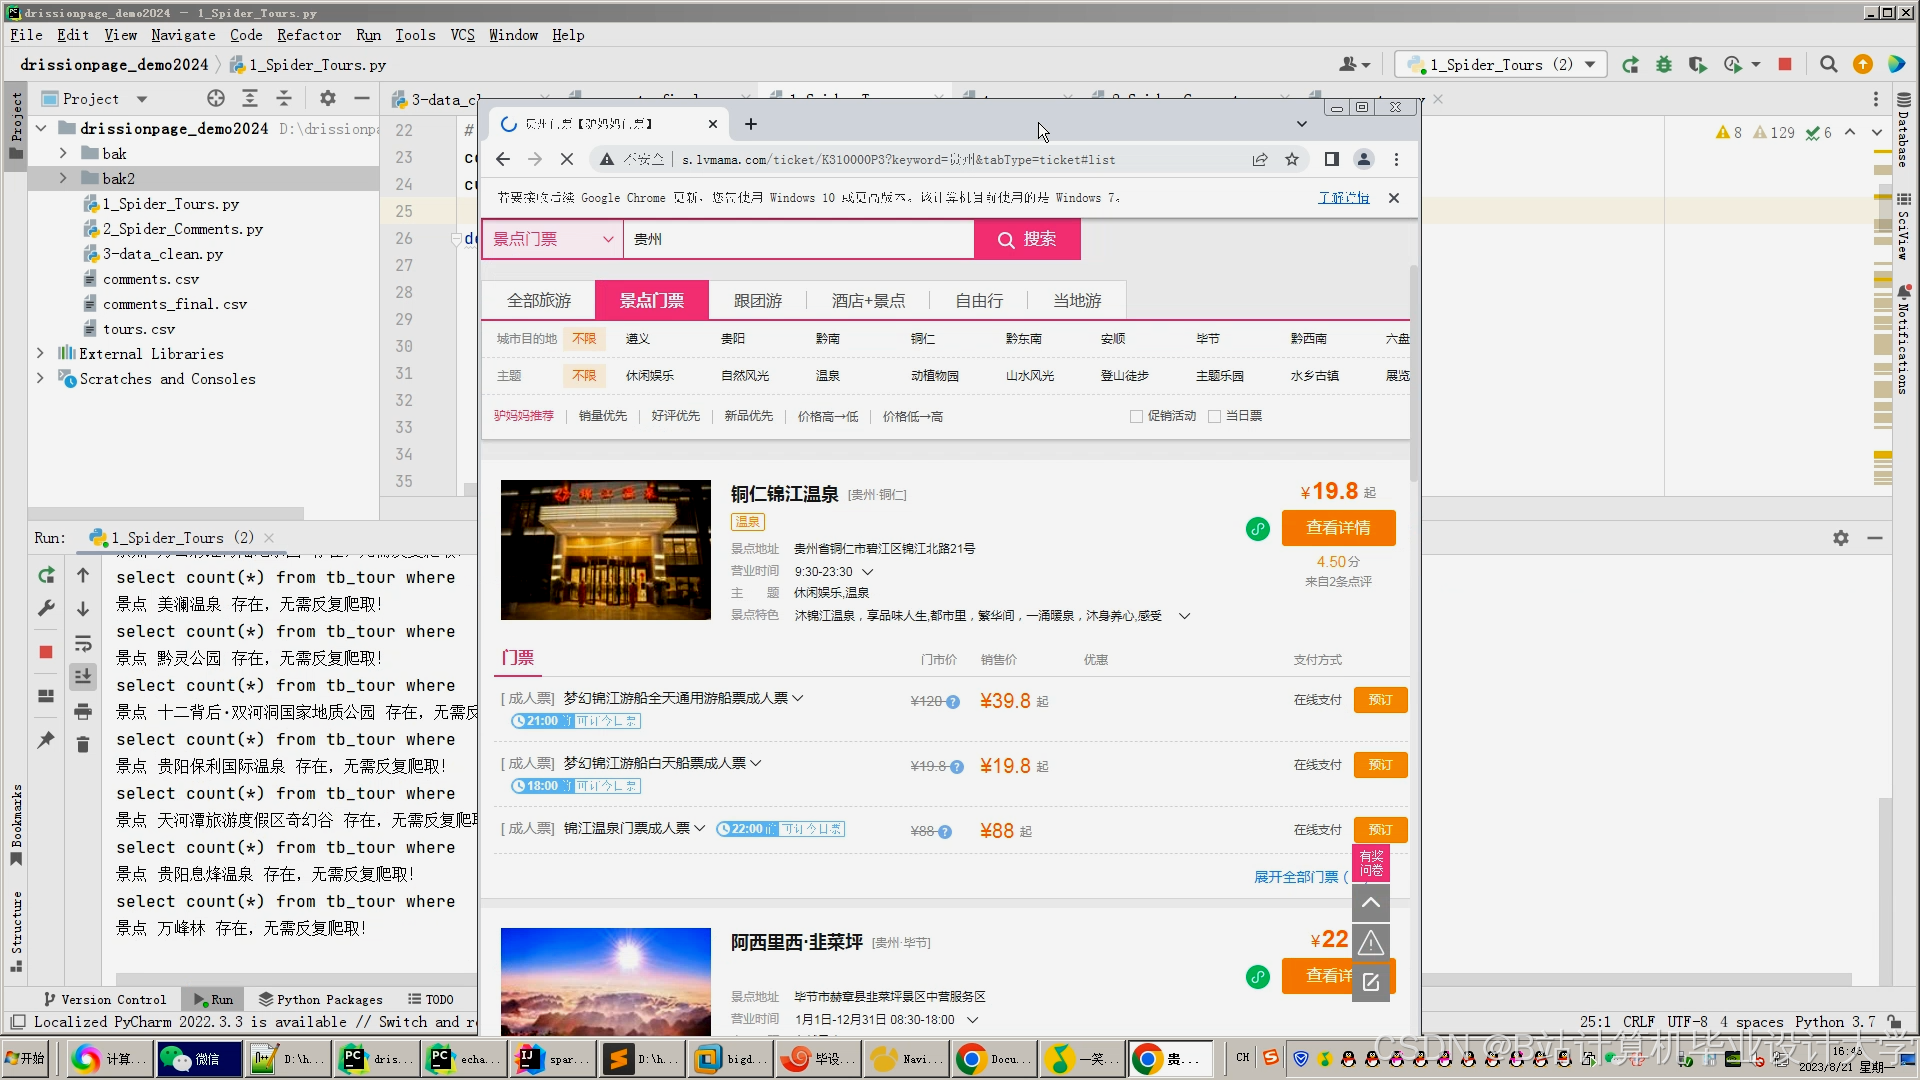
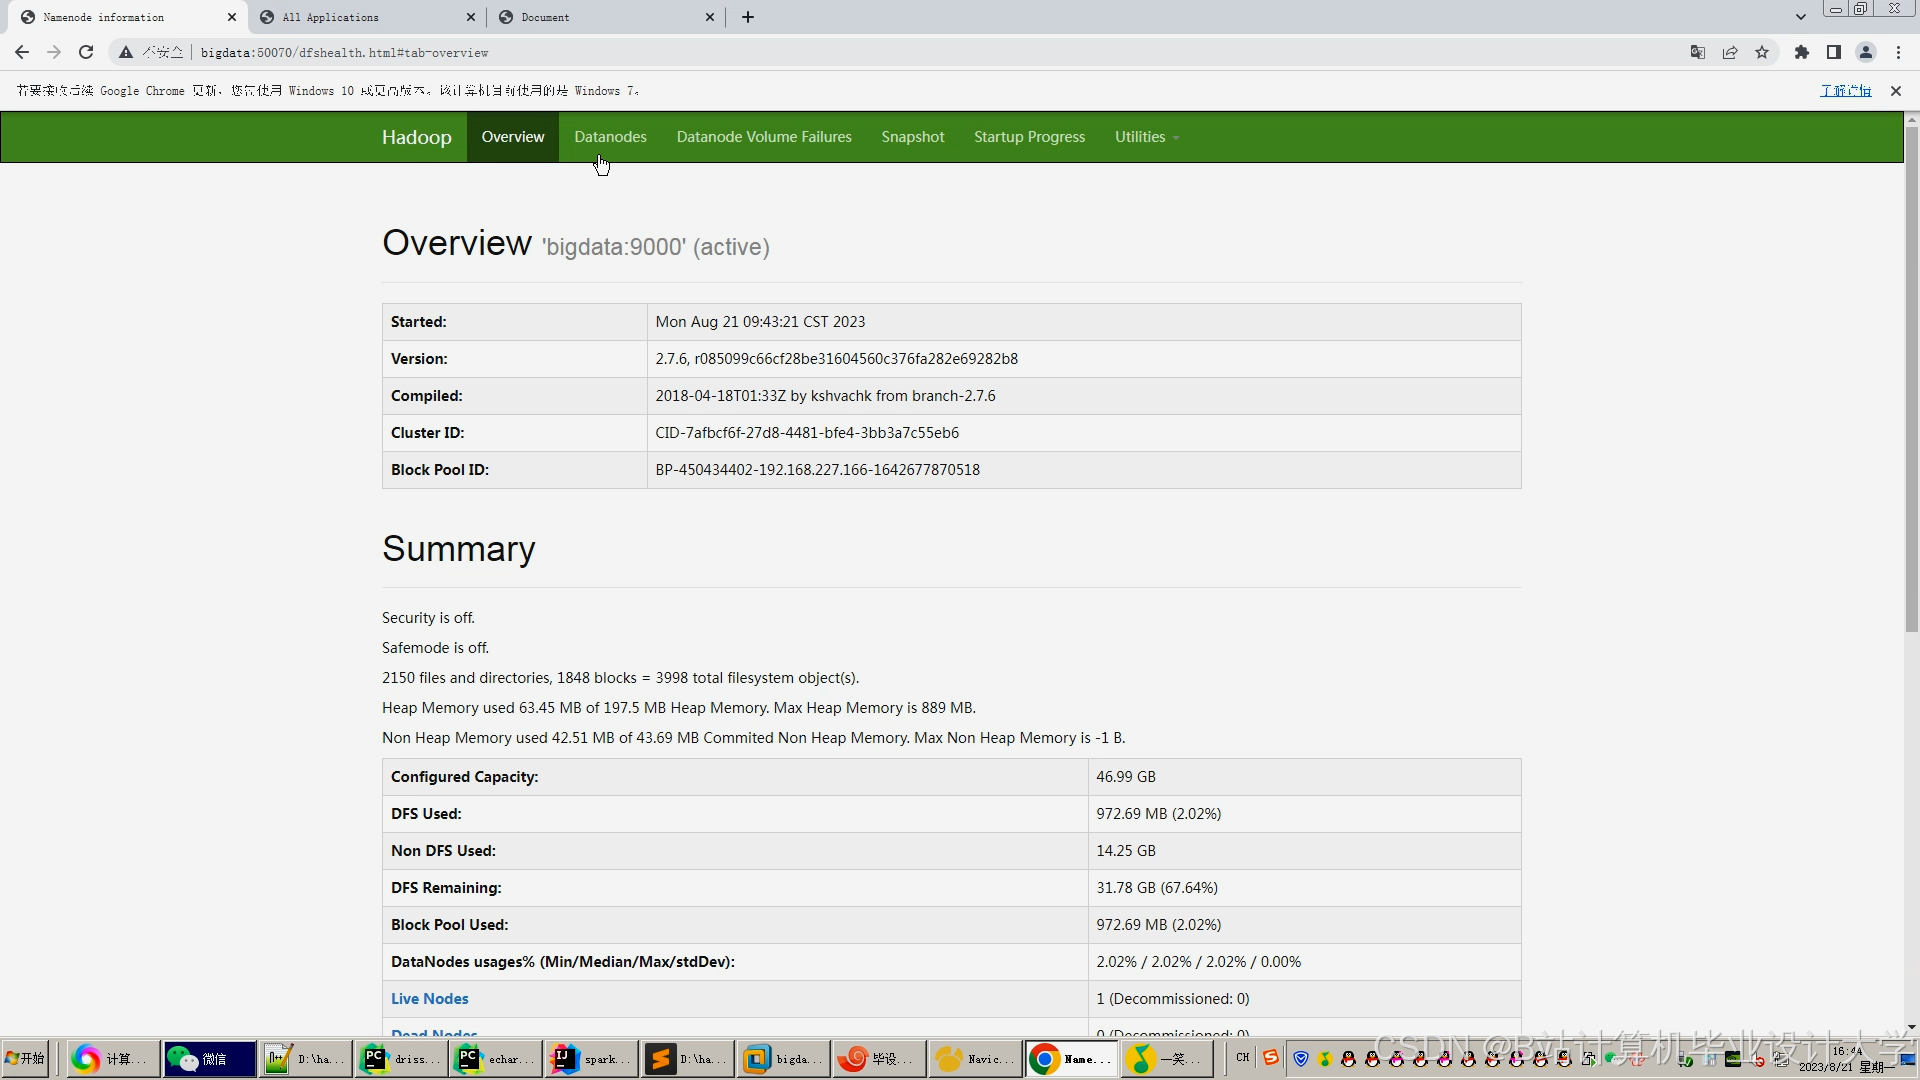
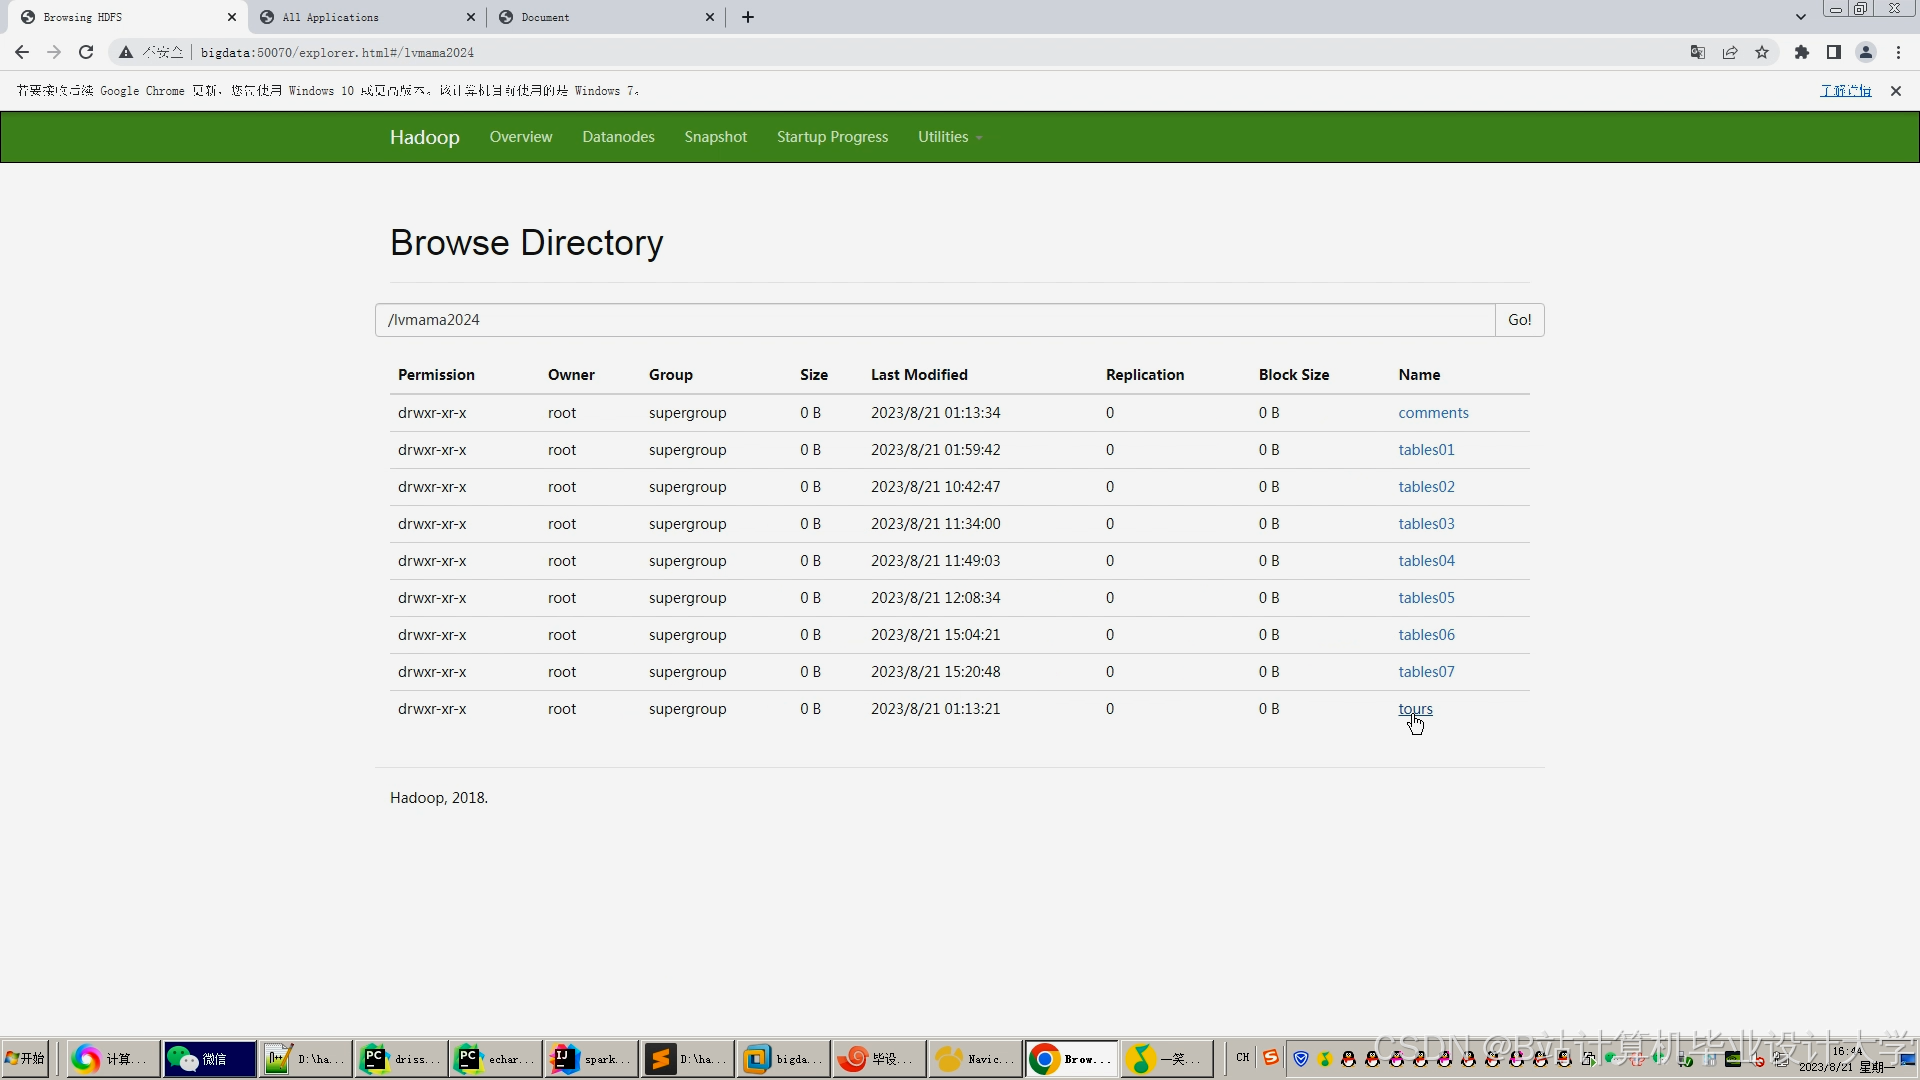
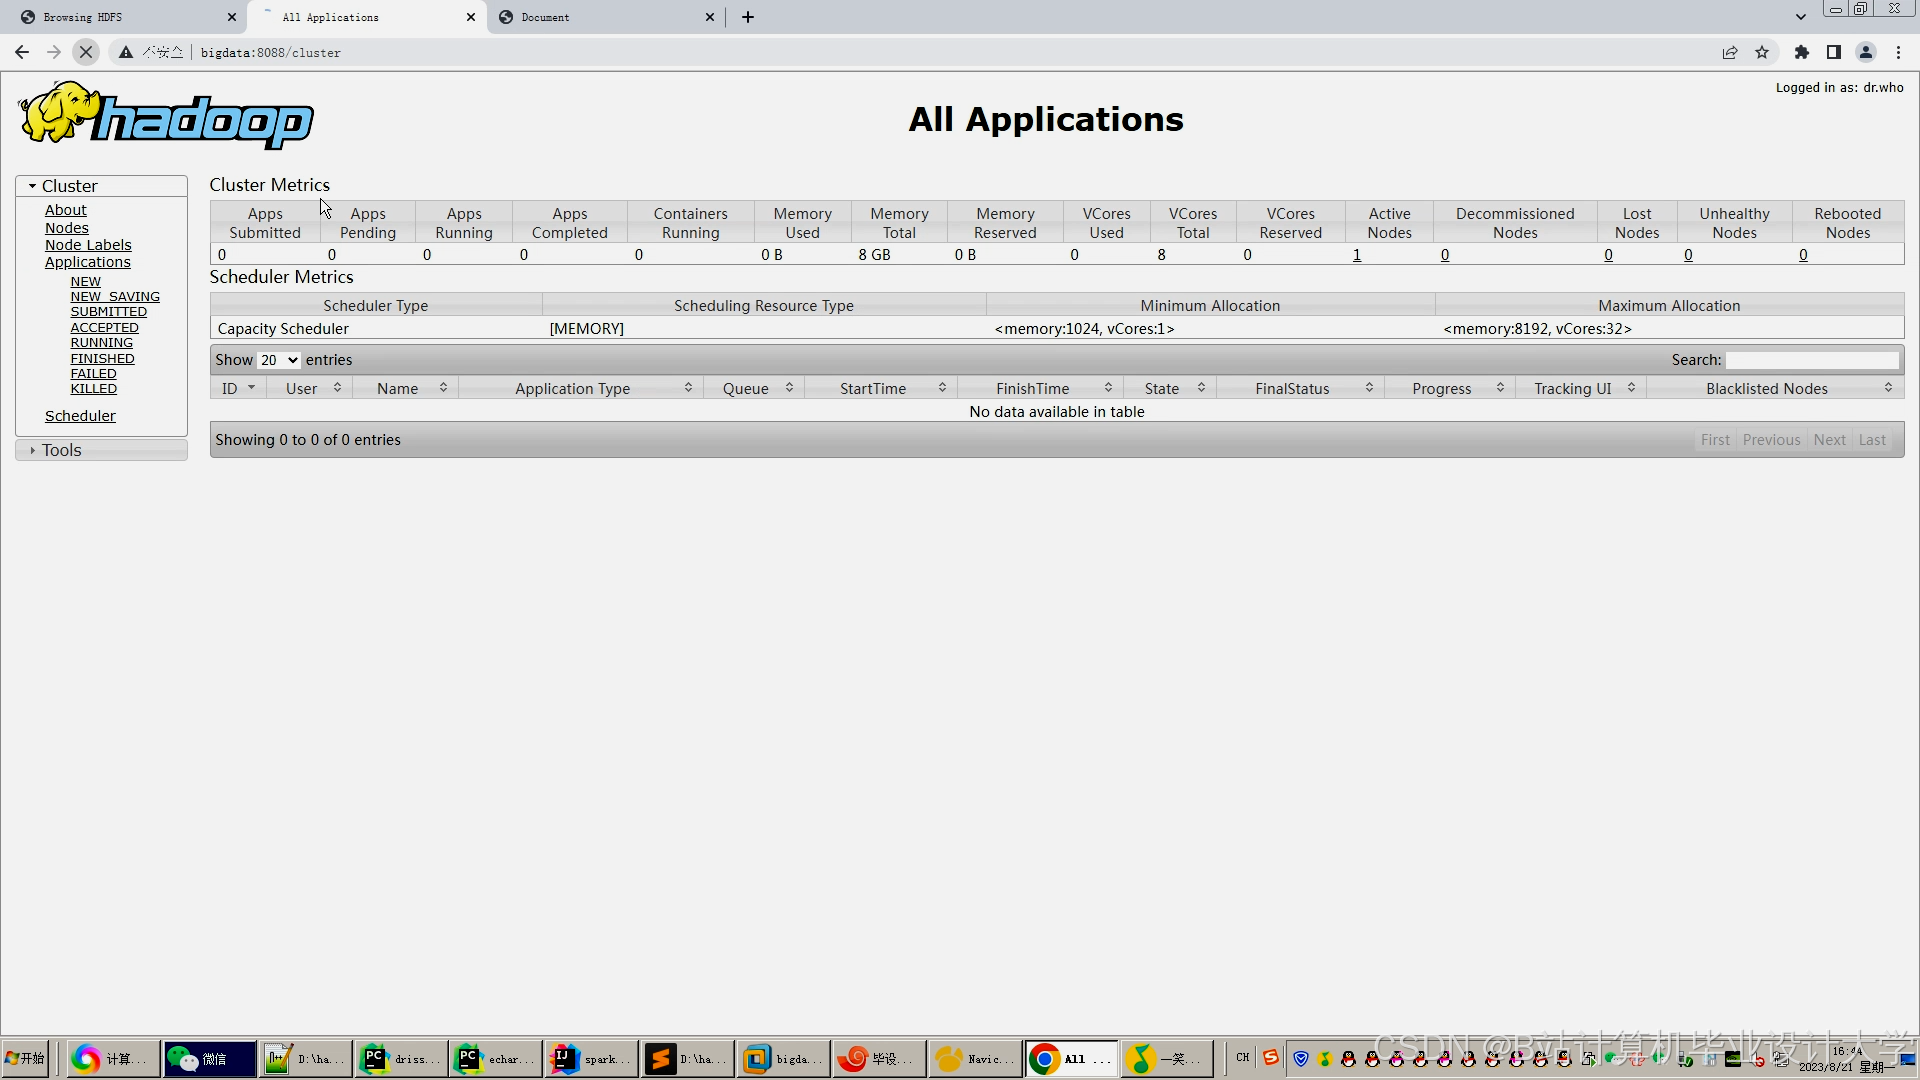
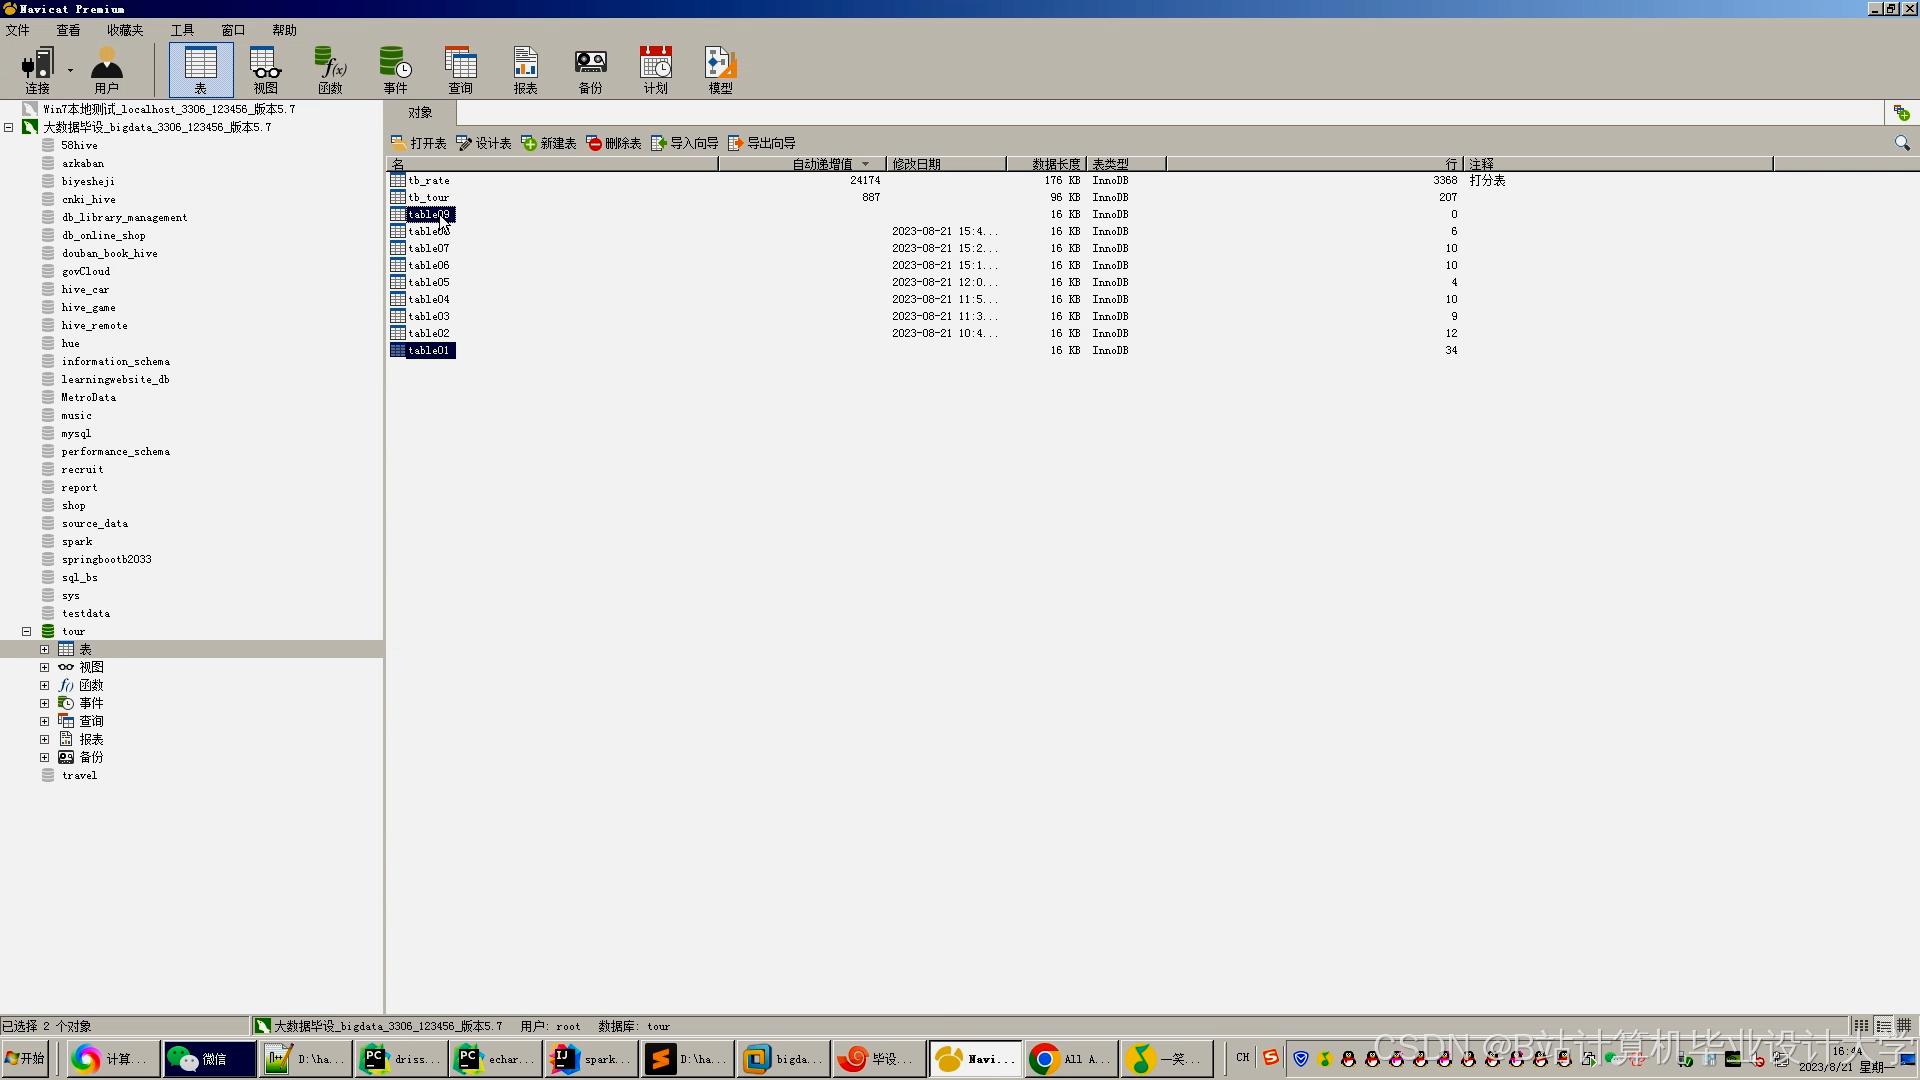
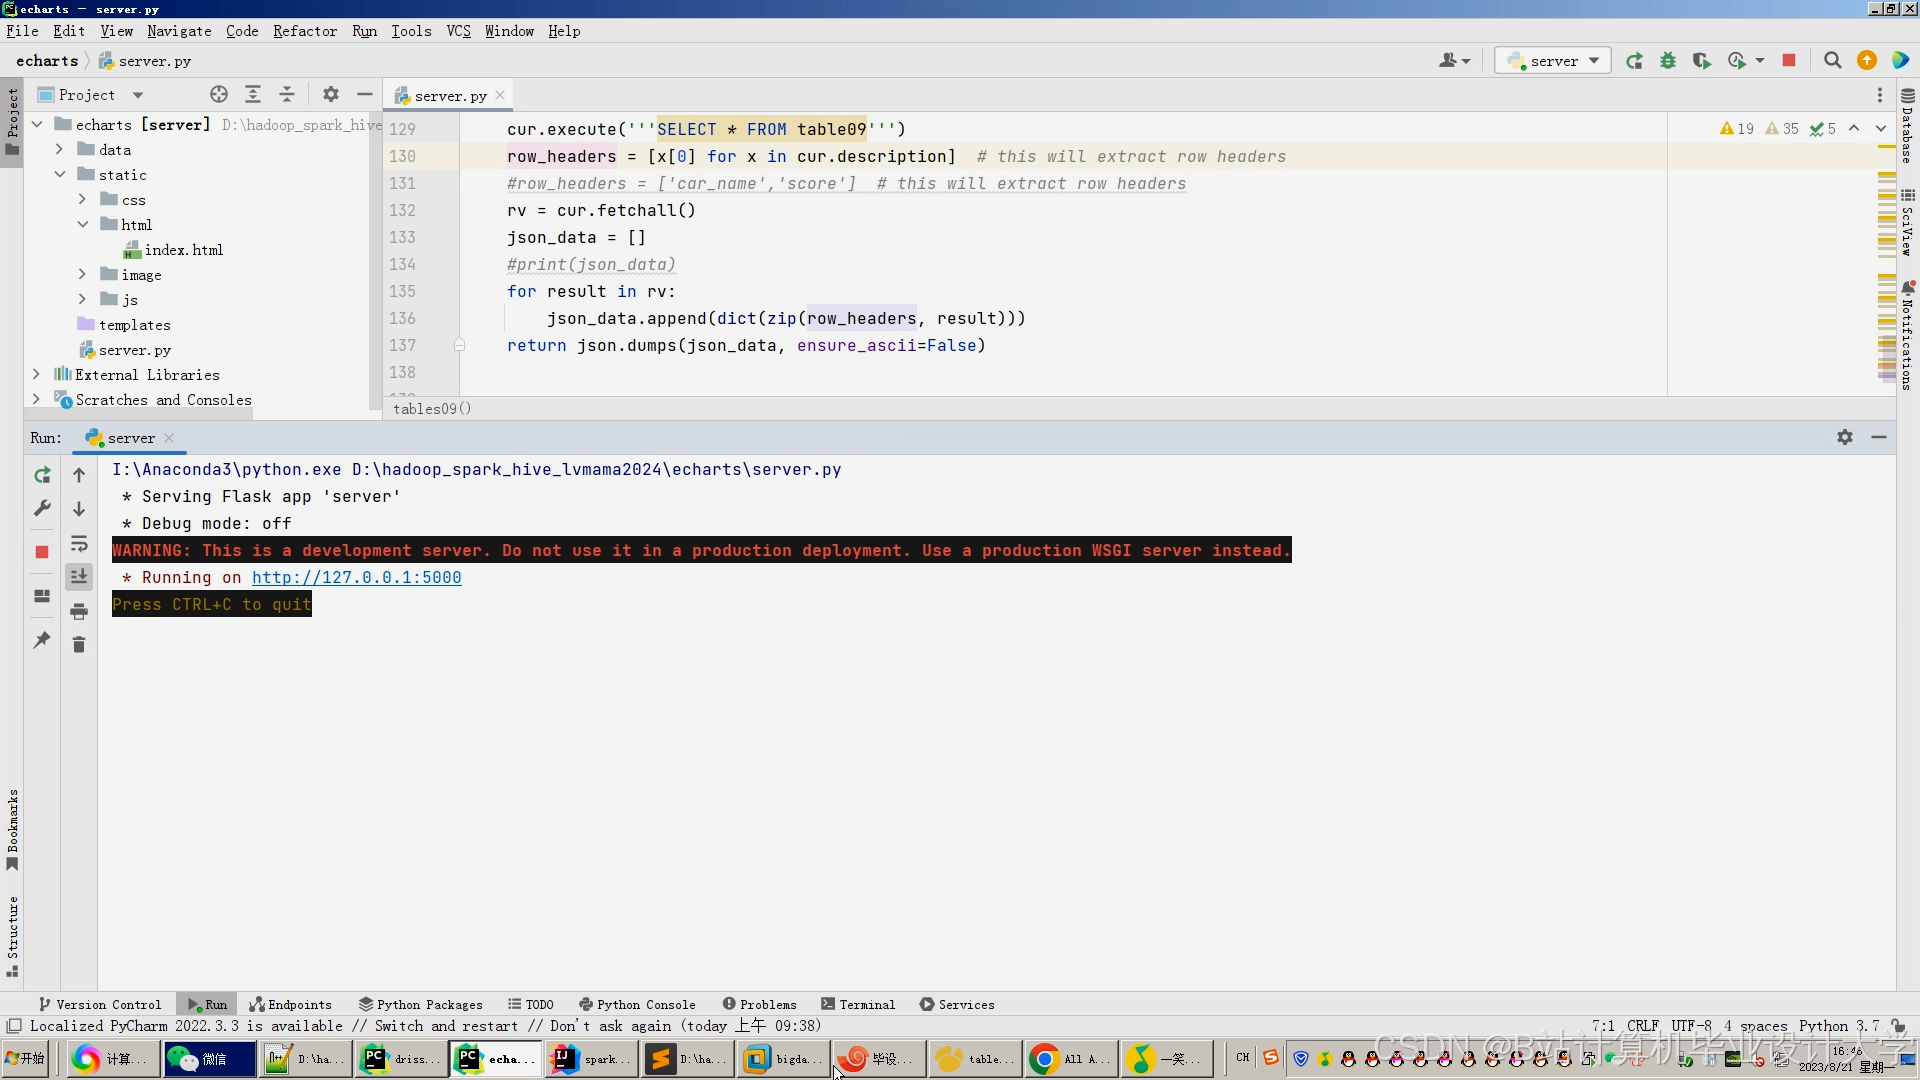
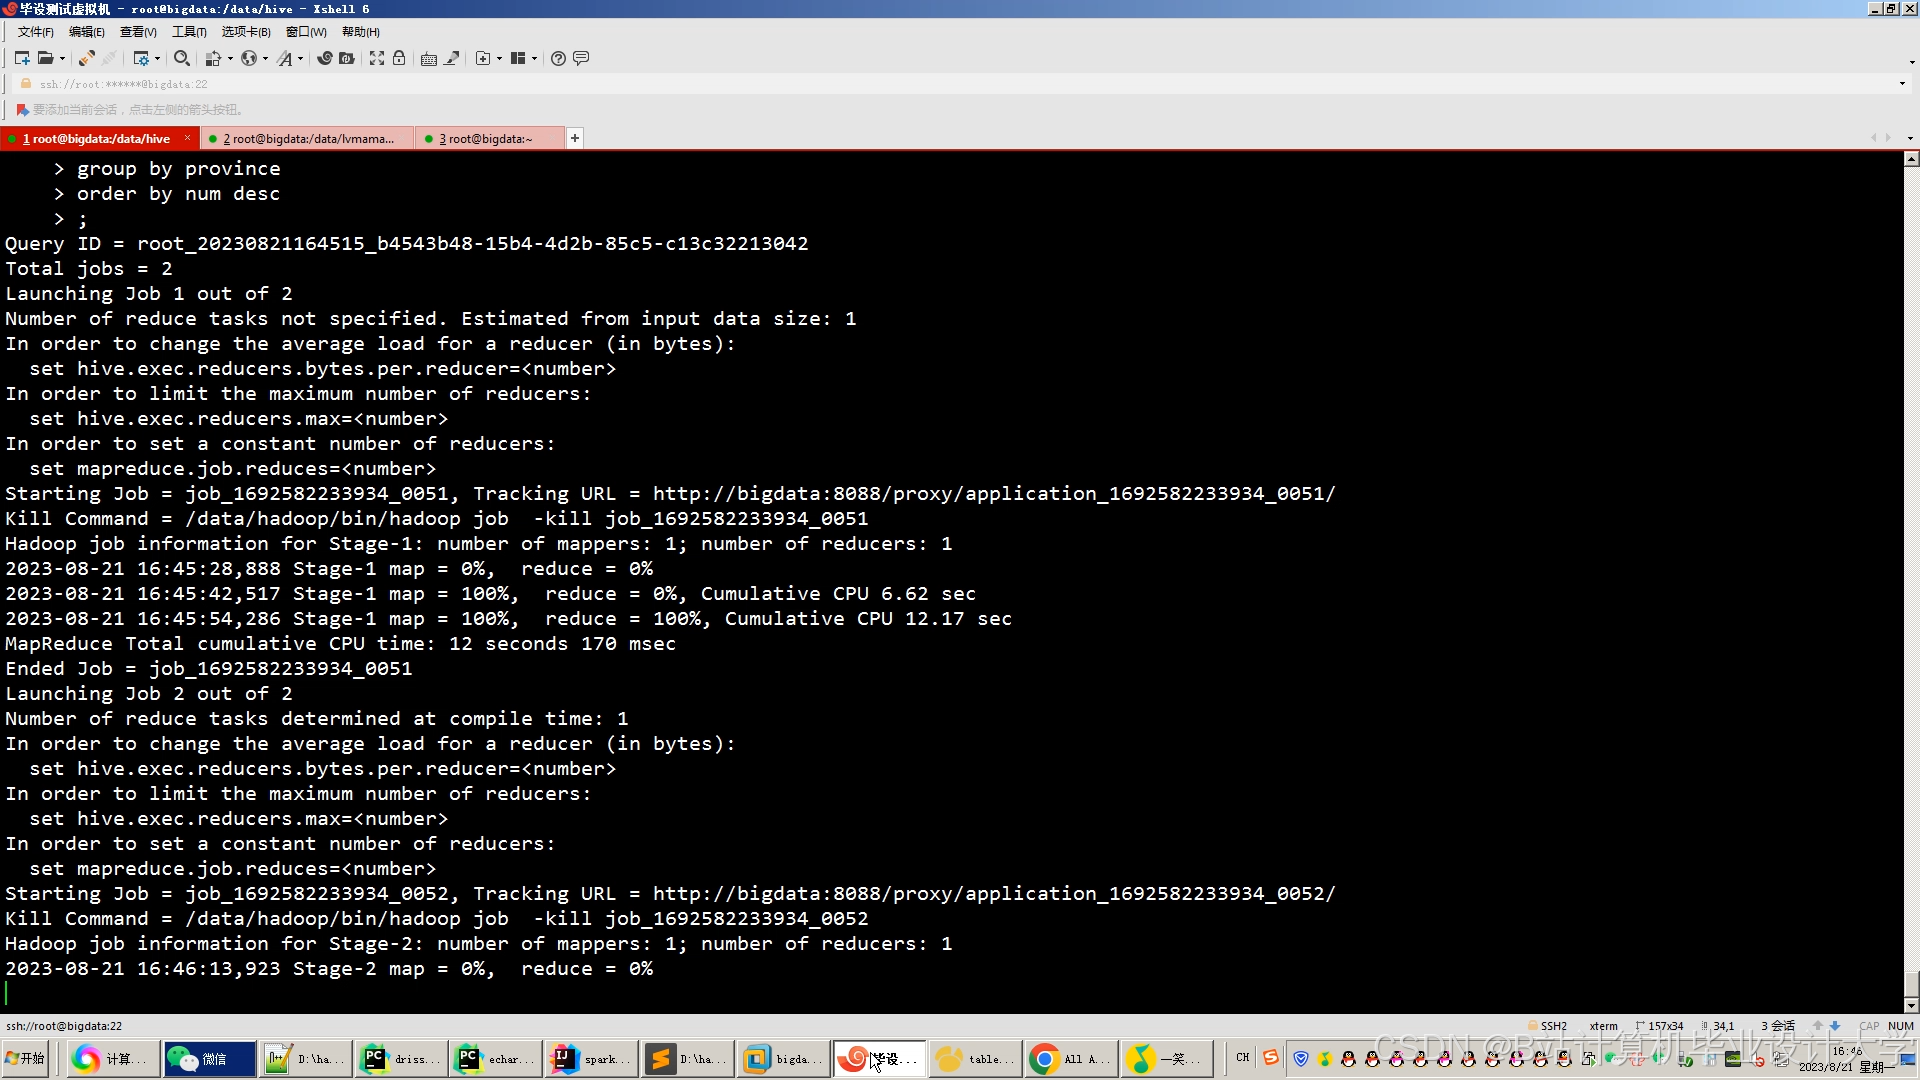
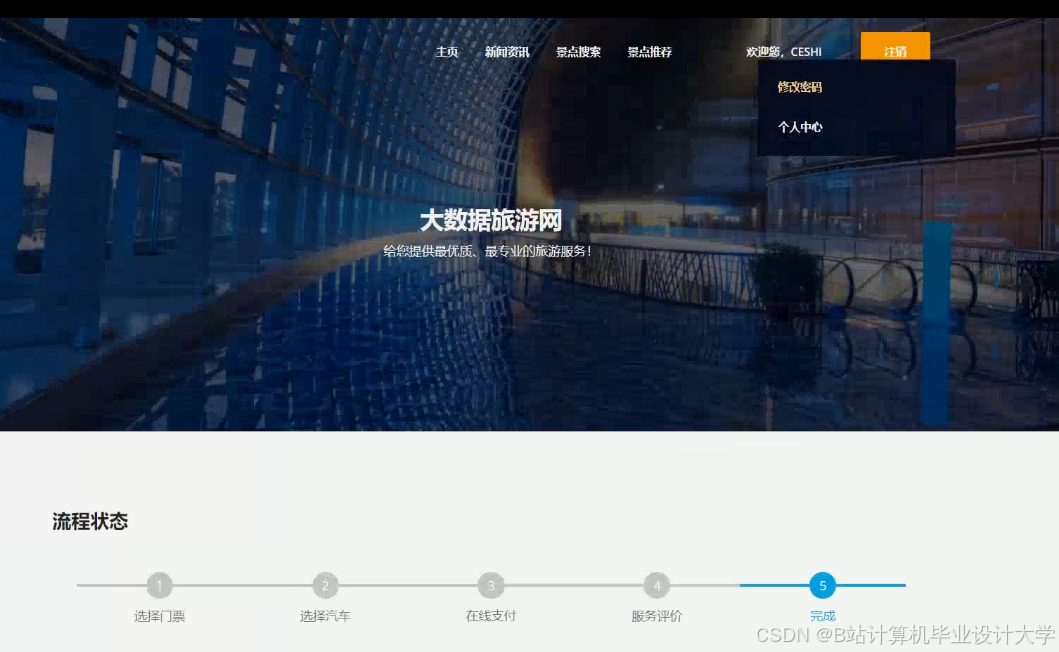
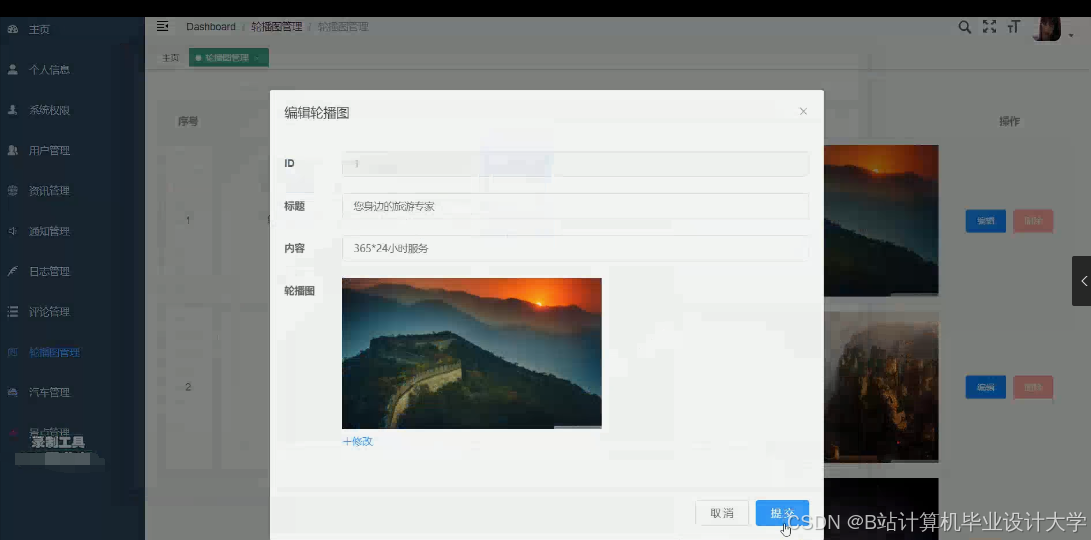
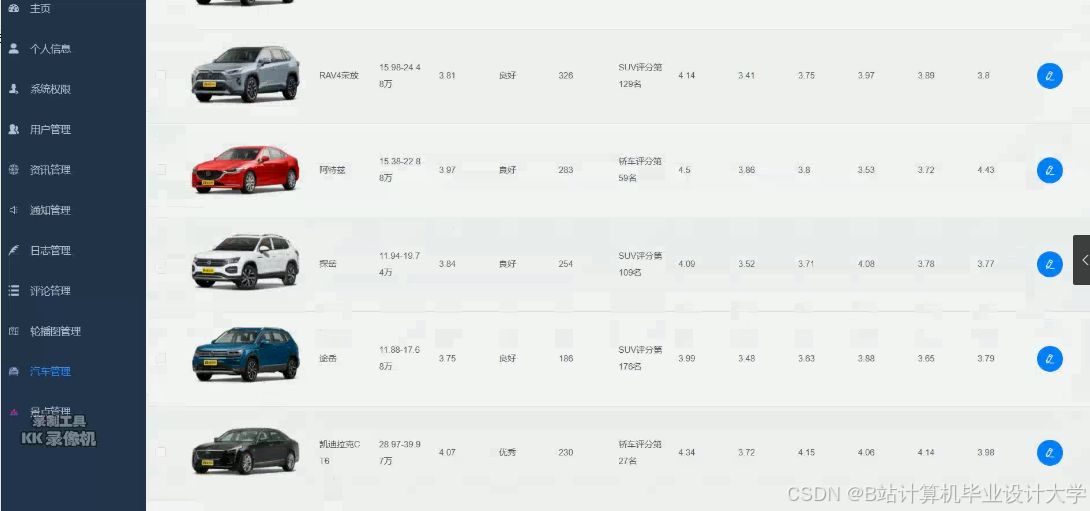
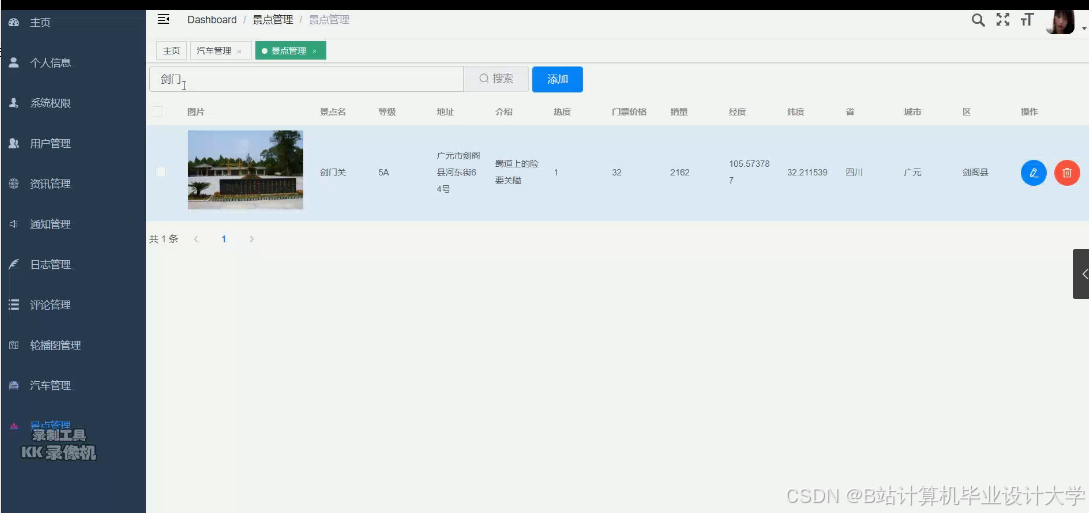
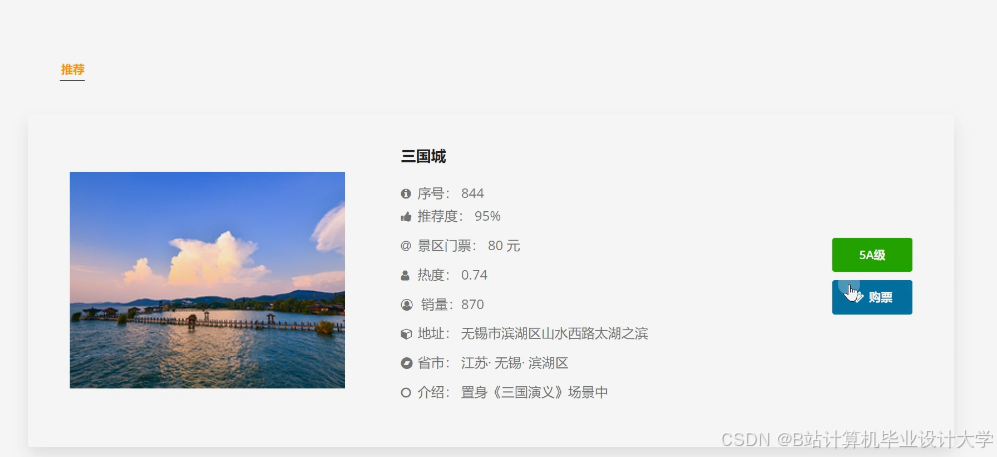
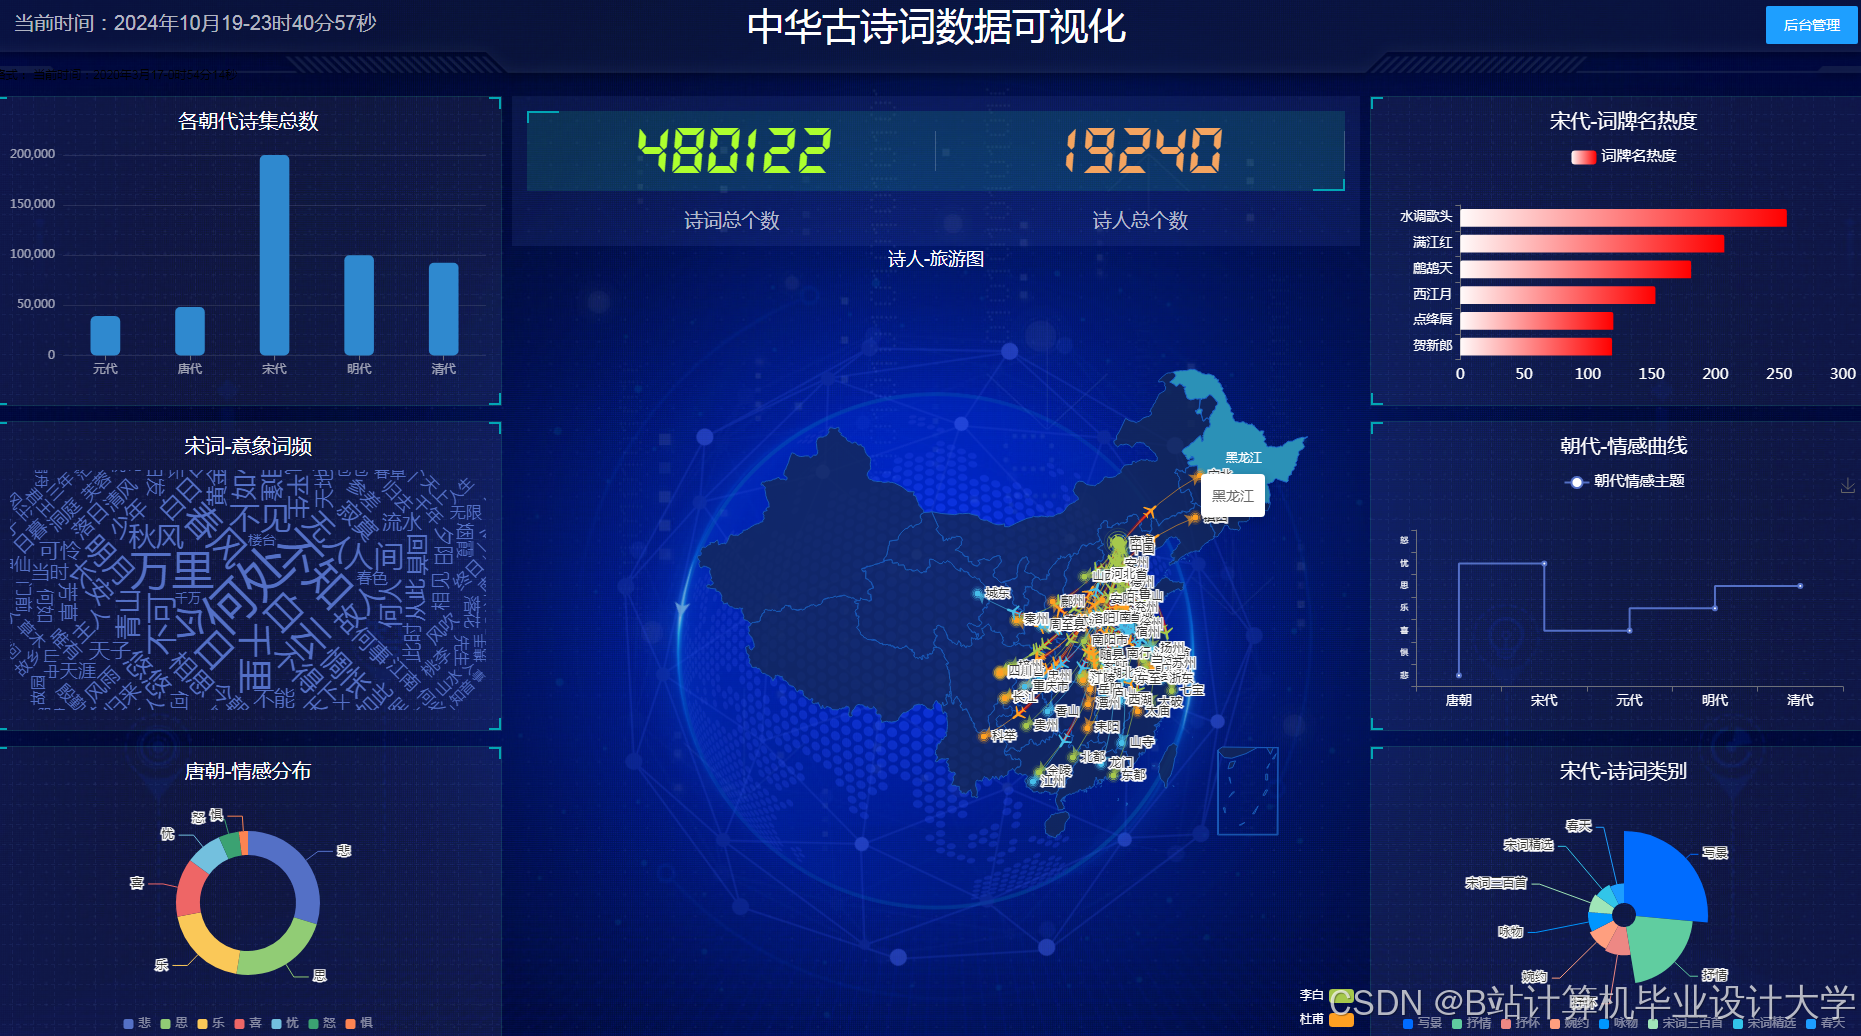
运行截图
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例




优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓
更多推荐



 7
 0
- 0


 已为社区贡献610条内容

所有评论(0)