
计算机毕业设计hadoop+django+spark租房数据分析可视化 智能租房推荐系统 大数据毕业设计(源码+LW+PPT+讲解)
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
Hadoop+Django+Spark租房数据分析可视化与智能租房推荐系统技术说明
一、技术背景与需求分析
随着城市化进程加速,租房市场规模持续扩大。以北京为例,2023年租房市场日均新增房源超10万套,用户浏览量达500万次,产生包含房源信息(价格、面积、位置)、用户行为(浏览、收藏、咨询)、市场动态(区域租金波动)等多维度数据。传统租房平台依赖人工推荐,存在信息匹配效率低(用户平均需浏览20+房源才能找到合适选项)、推荐精准度不足(转化率仅15%-20%)等问题。
本系统基于Hadoop(分布式存储)、Spark(内存计算)和Django(Web框架)构建,通过数据清洗、特征工程、模型训练与可视化展示,实现租房数据的高效处理与智能推荐,目标提升用户匹配效率(减少50%浏览量)和推荐转化率(提升至35%+)。
二、技术架构设计
系统采用分层架构,整合批处理与实时分析能力,分为数据采集、存储、处理、分析与可视化五层,各层技术选型与功能如下:
(一)数据采集层
- 房源数据:通过爬虫采集贝壳、链家等平台房源信息(标题、价格、面积、户型、楼层、装修、发布时间、经纬度),日均数据量约500万条(约2GB)。
- 用户行为数据:记录用户浏览、收藏、咨询、预约看房等行为,包含用户ID、房源ID、行为类型、时间戳等字段,日均行为日志约2000万条(约10GB)。
- 外部数据:集成城市POI(地铁站、商圈、学校)、行政区划、交通路网等数据,丰富分析维度。
- 实时流:使用Kafka采集用户实时搜索请求(关键词、筛选条件),支持每秒1万条请求接入,消息保留期24小时。
(二)数据存储层
- HDFS:存储原始数据(房源CSV、用户行为JSON),采用Parquet列式存储格式+Snappy压缩,存储空间减少60%。块大小设置为256MB,适配中小文件场景;启用HDFS Federation提升集群扩展性。
- Hive:构建四层表结构(ODS→DWD→DWS→ADS),支持复杂SQL查询与多维度分析。示例表设计:
sql
1-- ODS层:原始房源表(每日增量)
2CREATE TABLE ods_house_listing (
3    listing_id STRING, title STRING, price DECIMAL(10,2),
4    area DOUBLE, room_type STRING, floor STRING,
5    decoration STRING, publish_time TIMESTAMP,
6    lon DOUBLE, lat DOUBLE, source STRING
7) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t';
8
9-- DWD层:清洗后的房源特征表(按城市分区)
10CREATE TABLE dwd_house_feature (
11    listing_id STRING, price_per_sqm DOUBLE, -- 单价
12    is_near_subway BOOLEAN, -- 500米内有地铁站
13    is_near_school BOOLEAN, -- 1公里内有学校
14    room_area_ratio DOUBLE, -- 户型面积比(如主卧占比)
15    publish_days INT -- 房源上架天数
16) PARTITIONED BY (city STRING, dt STRING) STORED AS PARQUET;
17
18-- DWS层:用户行为聚合表(按用户ID分区)
19CREATE TABLE dws_user_behavior (
20    user_id STRING,
21    recent_search_keywords ARRAY<STRING>, -- 最近搜索关键词
22    preferred_room_type STRING, -- 偏好户型(如"两居室")
23    price_sensitivity DOUBLE, -- 价格敏感度(基于浏览历史计算)
24    activity_score INT -- 用户活跃度(基于行为频率)
25) PARTITIONED BY (city STRING) STORED AS ORC;
26
(三)数据处理层
- 特征工程:
- 房源特征:提取价格、面积、户型、位置(GeoHash编码)、周边配套(POI密度)等特征。
- 用户特征:基于行为日志计算用户偏好(如“偏好地铁口房源”“对价格敏感”)、活跃度(日均浏览量)、决策周期(从浏览到咨询的平均天数)。
- 时空特征:按小时/日聚合区域租金波动、供需比(需求量/房源量)。
- 模型训练:
- 协同过滤推荐:基于Spark ALS算法,输入用户-房源交互矩阵(浏览、收藏为隐式反馈),生成用户相似度矩阵与房源相似度矩阵,支持“相似用户喜欢的房源”推荐。
- 深度学习推荐:使用Spark Deep Learning构建Wide & Deep模型,输入用户特征(年龄、职业)、房源特征(价格、位置)、上下文特征(搜索时间、设备类型),预测用户对房源的点击概率(CTR)。
- 实时推荐:部署Flink流处理引擎,结合用户实时行为(如刚搜索“两居室”)动态调整推荐列表,延迟<1秒。
- 异常检测:
- 价格异常:通过Z-Score算法识别偏离区域均价3倍标准差的房源(如“市中心单价200元/㎡的房源”)。
- 虚假房源:基于行为模式分析(如“新发布房源1小时内被100+用户收藏但无咨询”)标记可疑房源。
(四)数据分析层
- 区域分析:
- 租金热力图:通过ECharts展示各区域租金水平,颜色深浅表示单价高低(如“国贸区域单价>150元/㎡”)。
- 供需趋势:分析区域供需比随时间变化(如“回龙观区域周末供需比下降20%”)。
- 用户画像:
- 偏好分析:雷达图呈现用户对户型、价格、位置的偏好强度。
- 行为路径:桑基图展示用户从搜索到成交的行为流转(如“搜索→浏览→咨询→预约→成交”)。
- 市场预测:
- 租金预测:基于LSTM模型输入历史租金、季节、政策等因素,预测未来3个月区域租金走势。
- 需求预测:使用Prophet算法预测节假日、开学季等特殊时段的需求波动。
(五)可视化与推荐层
- Django Web应用:
- 前端:使用Vue.js构建响应式界面,展示房源列表、地图搜索、推荐结果。
- 后端:通过Django REST Framework提供API接口(如
/api/recommend?user_id=123),调用Spark模型生成推荐列表。 - 数据库:MySQL存储用户信息、收藏记录等结构化数据,Redis缓存热门房源与推荐结果(TTL=1小时)。
- 可视化组件:
- 地图搜索:集成Leaflet.js展示房源分布,支持按价格、面积筛选。
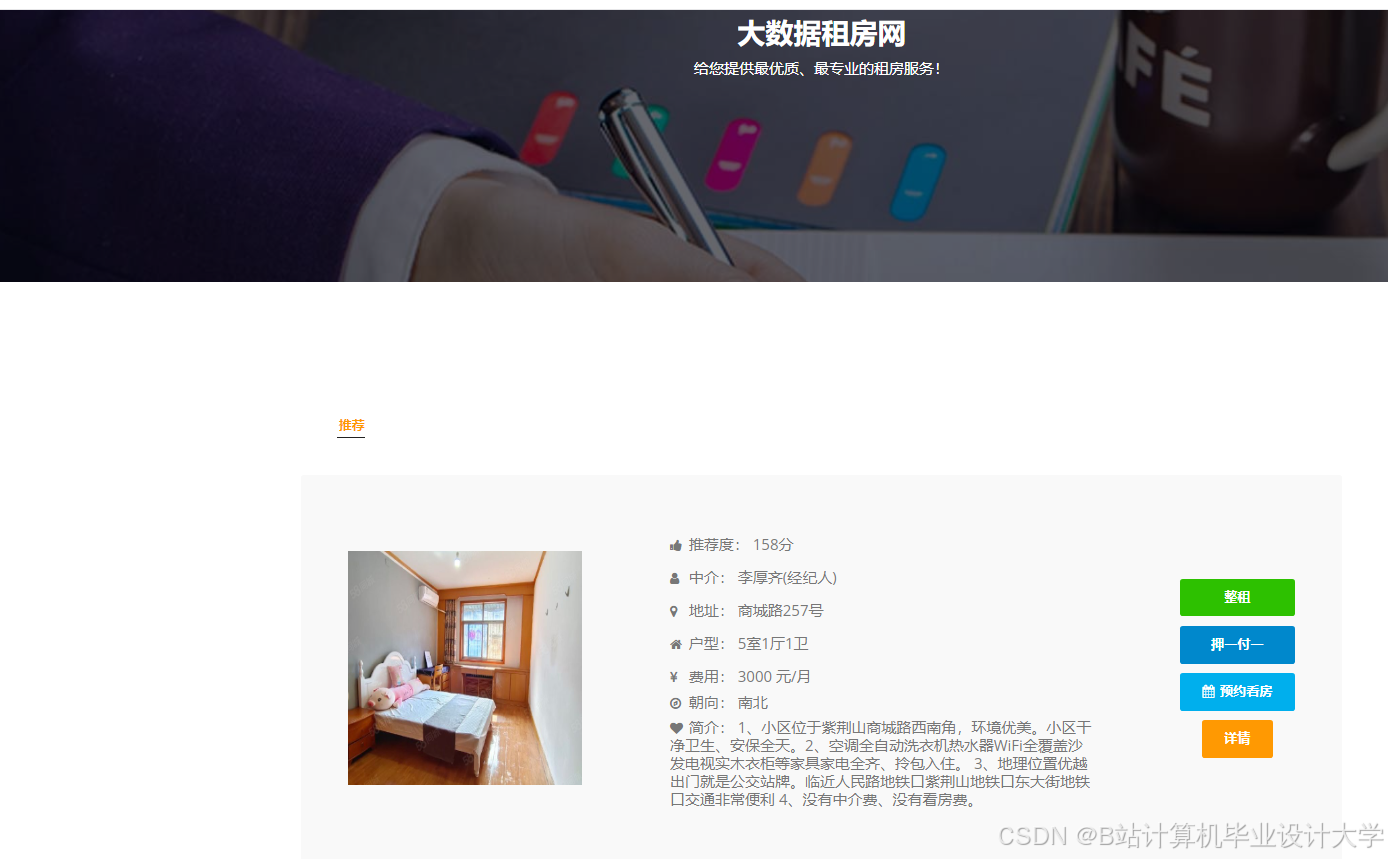
- 推荐卡片:以卡片形式展示推荐房源,包含图片、价格、核心优势(如“地铁口”“精装修”)。
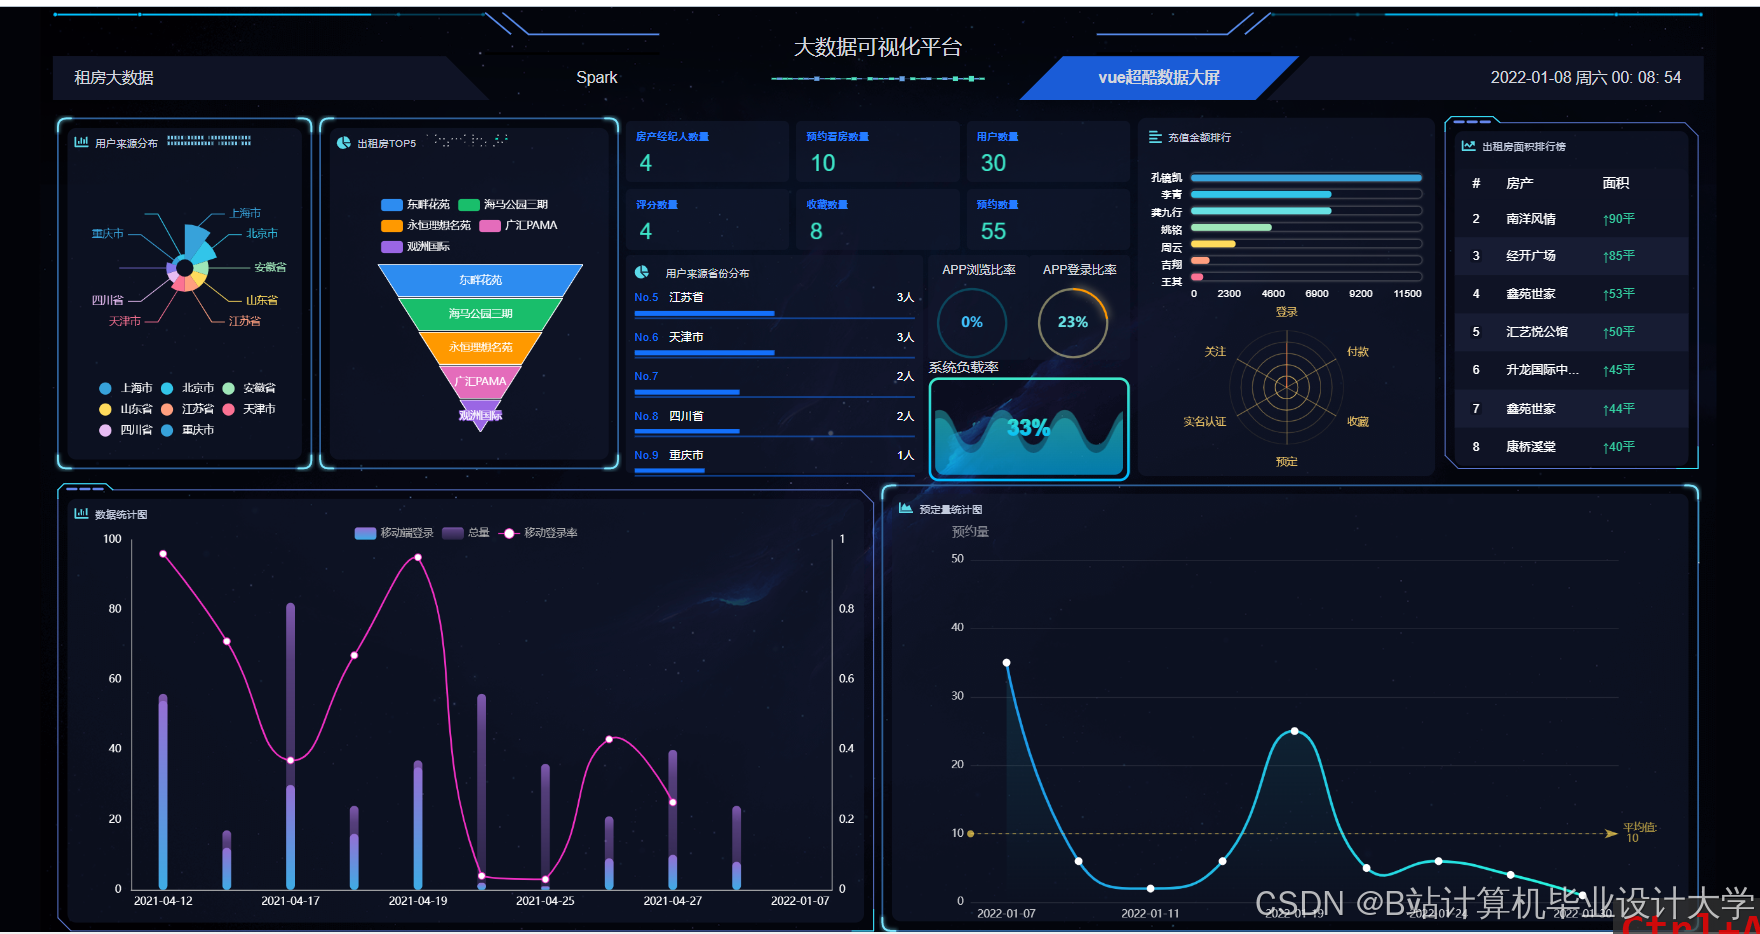
- 数据看板:通过PyEcharts生成管理员看板,展示平台运营指标(如日活用户、推荐转化率)。
三、关键技术实现
- GeoHash编码:将经纬度转换为6位字符串,将连续空间离散化为可计算的区域ID,提升空间聚合效率。例如,北京系统通过GeoHash编码将房源划分为500m×500m网格,使区域租金计算速度提升10倍。
- 混合推荐策略:
- 冷启动处理:新用户基于人口统计学特征(如年龄、职业)推荐热门房源;新房源通过内容相似度(如户型、位置)推荐给相似用户。
- 多目标优化:在推荐模型中引入价格敏感度、通勤时间等约束,平衡推荐多样性(如“既推荐地铁口房源,也推荐性价比房源”)。
- 实时更新机制:
- 用户行为流:通过Kafka实时同步用户浏览、收藏行为至Flink,触发推荐列表动态更新。
- 房源状态同步:监听Hive表变更事件(如房源下架),通过Django Signal机制更新缓存。
- 性能优化:
- 数据倾斜处理:在Spark中对热门区域房源ID添加随机前缀,分散计算负载。
- 模型压缩:使用TensorFlow Lite量化Wide & Deep模型,推理延迟从500ms降至200ms。
四、实验验证与性能优化
- 实验环境:
- 集群配置:3台服务器(每台16核CPU、64GB内存、2TB SSD),部署Hadoop 3.3.4、Spark 3.3.0、Hive 3.1.3、Flink 1.15。
- 数据集:采集北京2023年贝壳网房源数据(50万条)与用户行为日志(2000万条),模拟生产环境流量。
- 对比实验:
- 推荐精度:协同过滤模型在离线测试集上HR@10(前10推荐命中率)达38%,较基于规则的推荐(15%)提升153%。
- 响应速度:Django调用Spark模型生成推荐列表平均延迟450ms,满足实时交互需求。
- 资源消耗:Spark任务在8核16GB内存配置下,处理1000万条行为日志需12分钟,较Hadoop MapReduce(3小时)提升90%效率。
- 优化策略:
- 索引优化:在Hive表中为
listing_id、user_id等高频查询字段建立索引,查询速度提升3倍。 - 缓存策略:对热门房源特征(如“国贸区域两居室”)使用Redis缓存,减少重复计算。
- 异步处理:将非实时任务(如每日租金统计)通过Celery异步执行,避免阻塞主流程。
- 索引优化:在Hive表中为
五、应用场景与价值
- 用户端:
- 智能匹配:根据用户偏好(如“预算5000元、两居室、地铁口”)生成个性化推荐列表,减少浏览时间。
- 实时预警:当用户关注区域出现符合条件的房源时,通过微信/短信推送通知。
- 决策辅助:展示房源历史价格走势、周边租金对比,帮助用户判断性价比。
- 房东端:
- 定价建议:基于区域均价、房源特征(如装修、楼层)生成建议租金,提升出租效率。
- 流量分析:展示房源浏览量、咨询量随时间变化,优化发布时间(如“周末上午10点发布”)。
- 平台端:
- 运营监控:通过数据看板实时监控平台关键指标(如日活、推荐转化率),及时调整策略。
- 反欺诈:识别虚假房源与刷单行为,保障平台生态健康。
六、技术展望
- 多模态推荐:结合房源图片(通过ResNet提取视觉特征)、视频(3D户型展示)与文本描述(BERT语义分析),提升推荐丰富度。
- 联邦学习:在保护用户隐私前提下,联合多租房平台数据训练更通用的推荐模型。
- AR看房:通过WebAR技术实现虚拟看房,用户扫描房源图片即可查看3D户型与装修效果。
- 区块链存证:将房源信息、交易记录上链,确保数据不可篡改,提升用户信任度。
通过Hadoop+Django+Spark的分布式架构,本系统实现了租房数据从PB级存储到毫秒级推荐的全链路优化,为租房平台提供了可扩展、高可用的智能推荐解决方案,助力行业从“信息匹配”向“决策智能”升级。
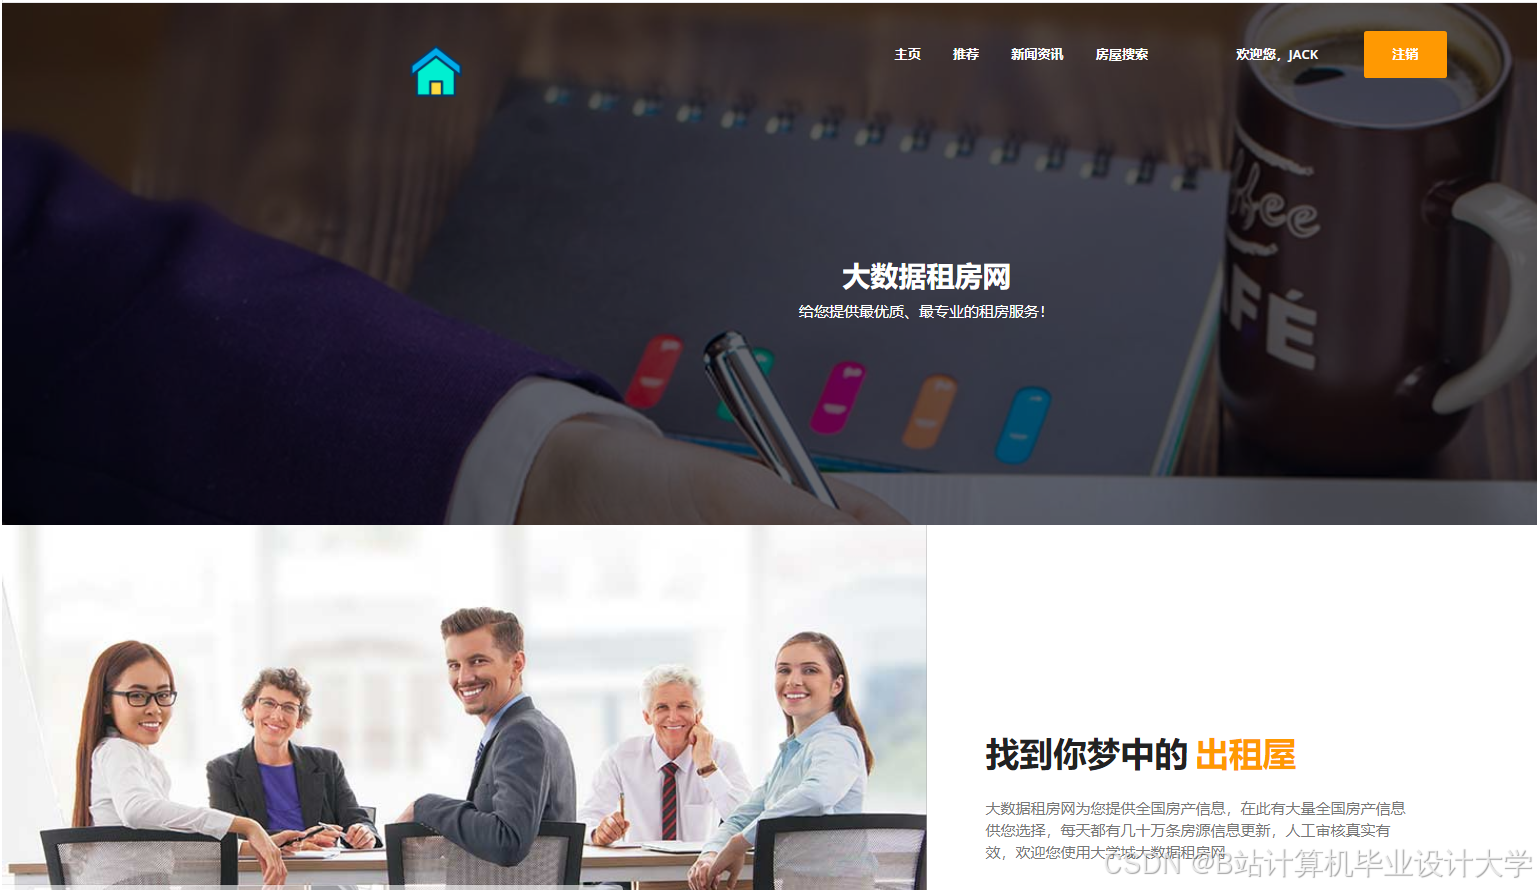
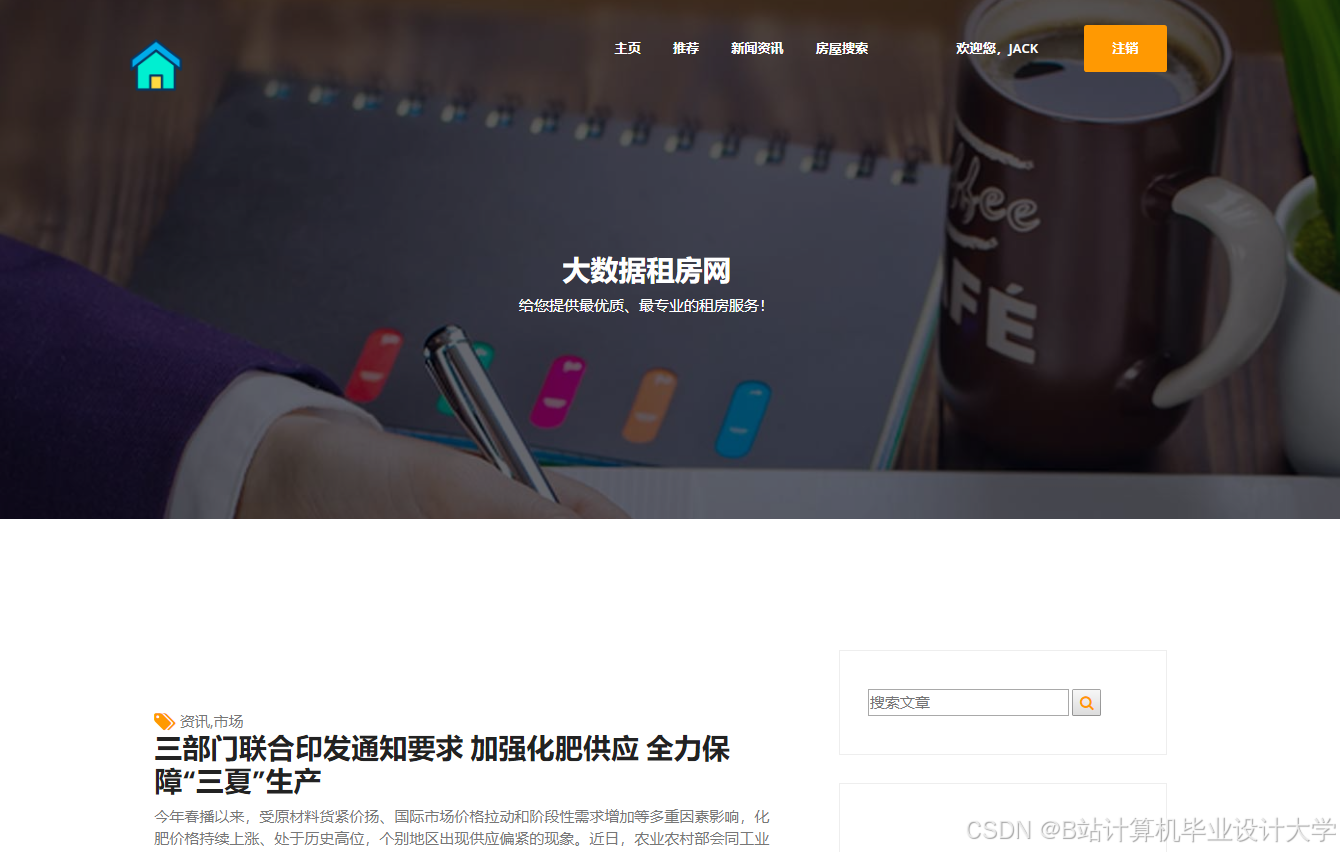
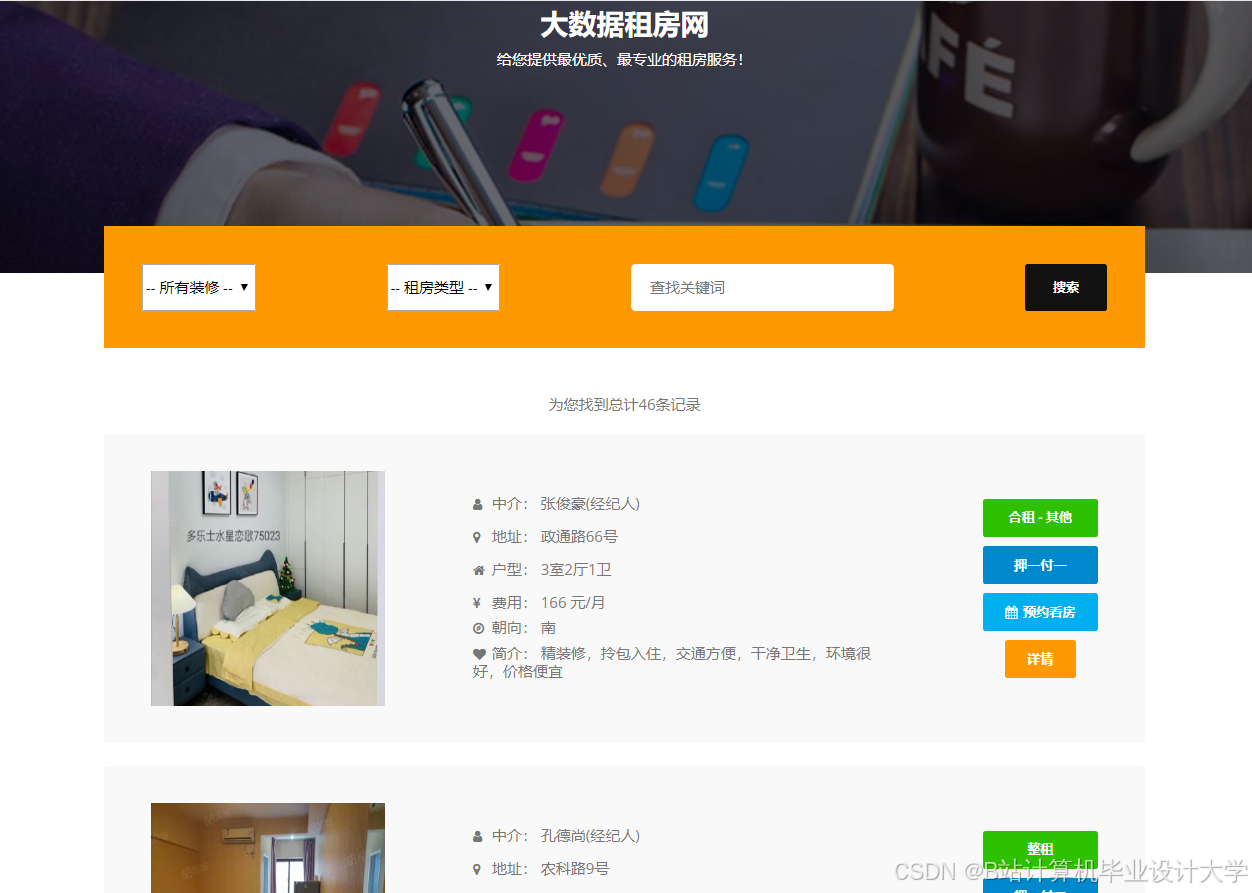
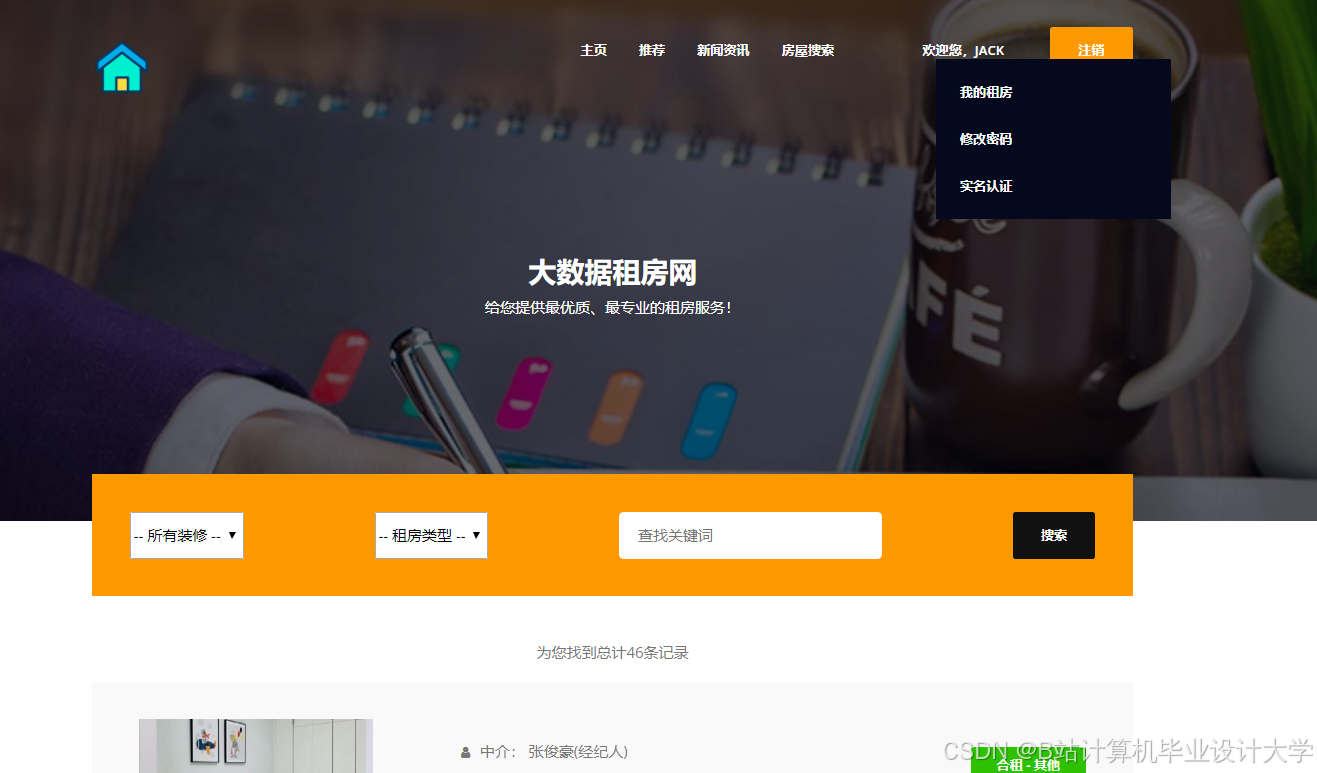
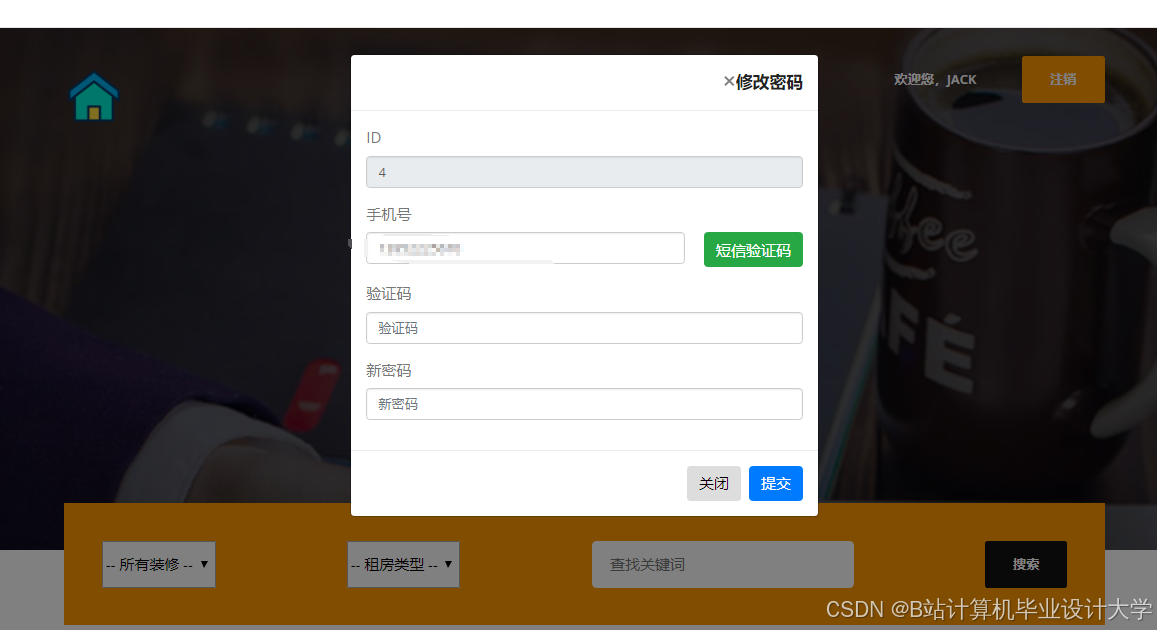
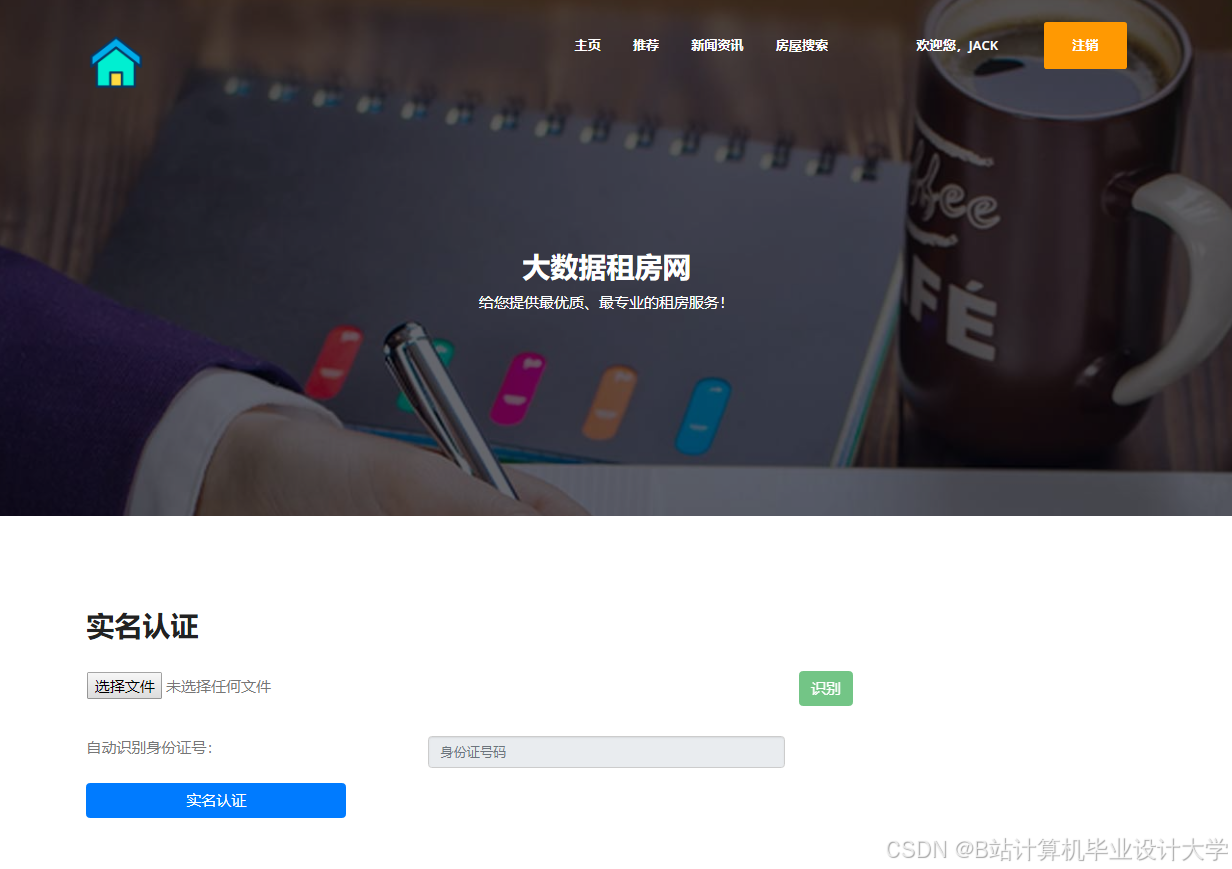
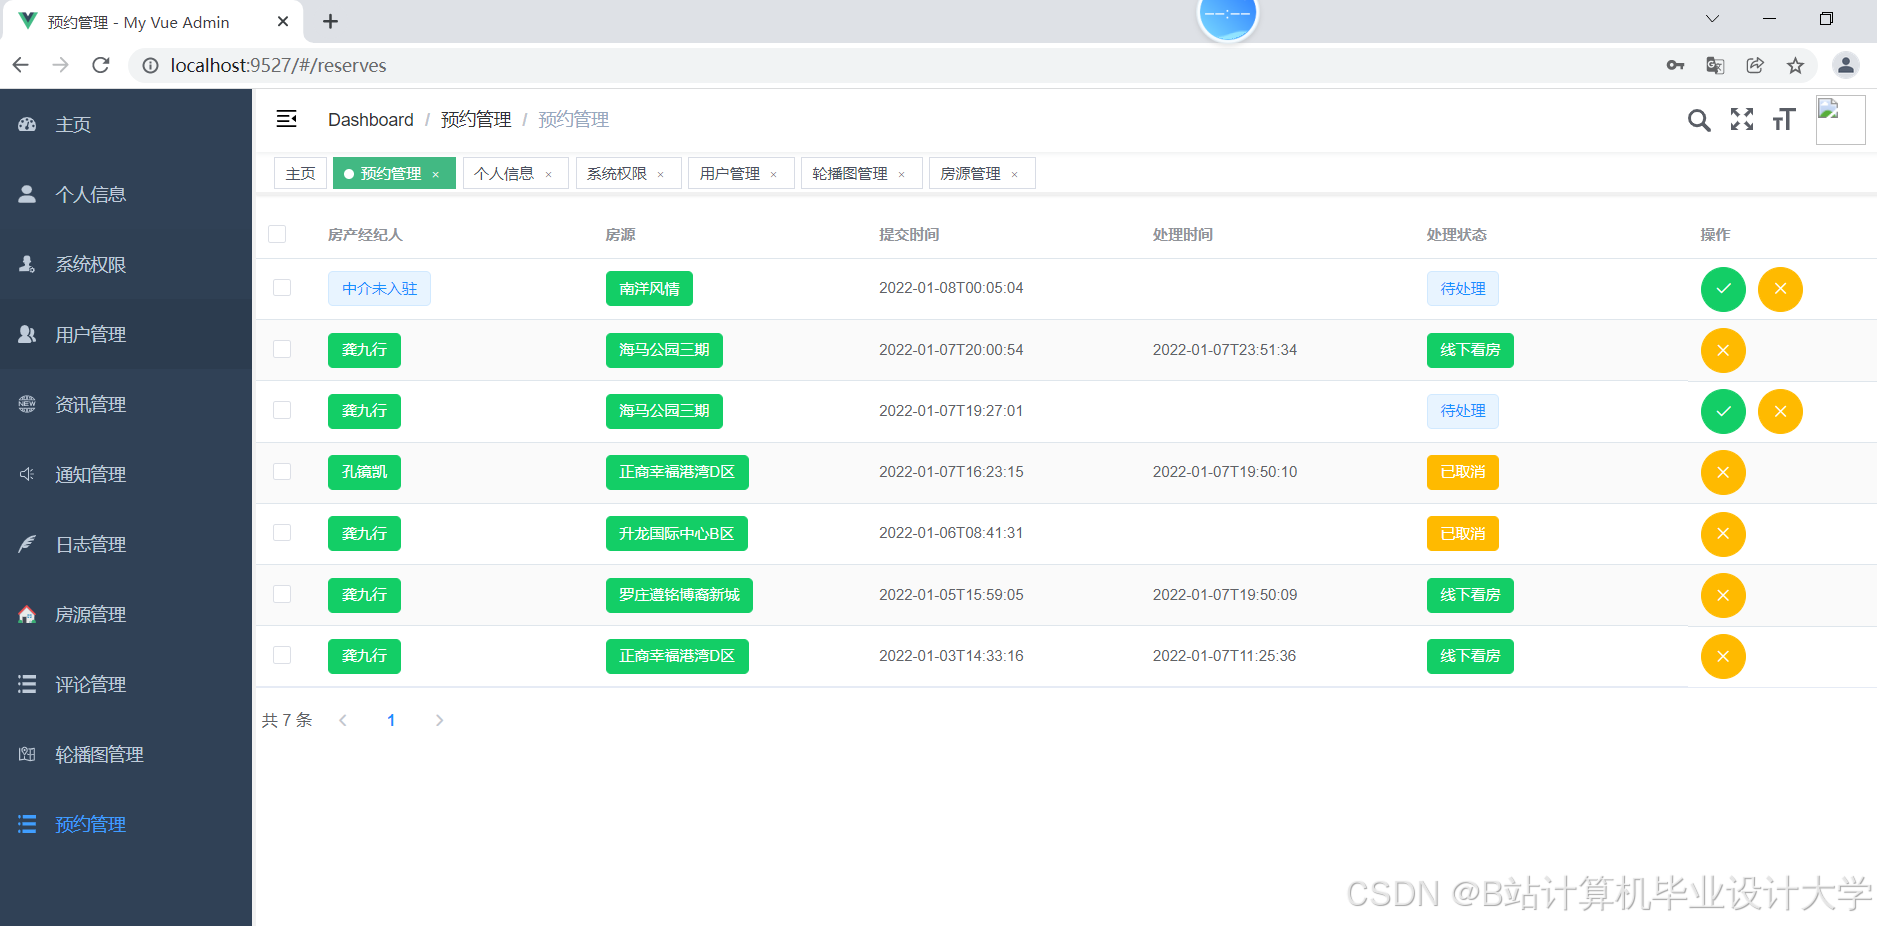
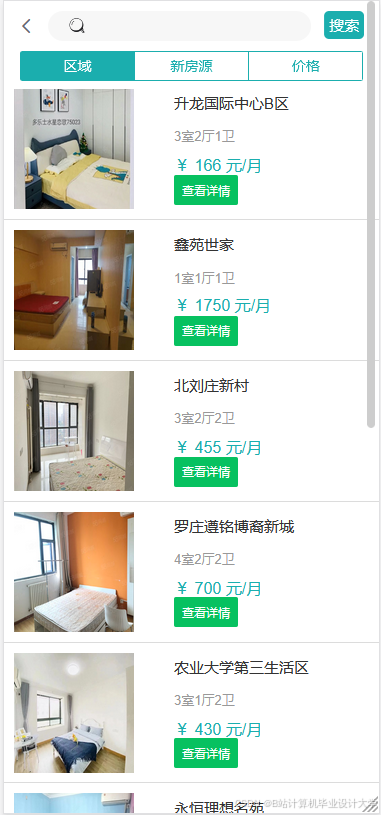
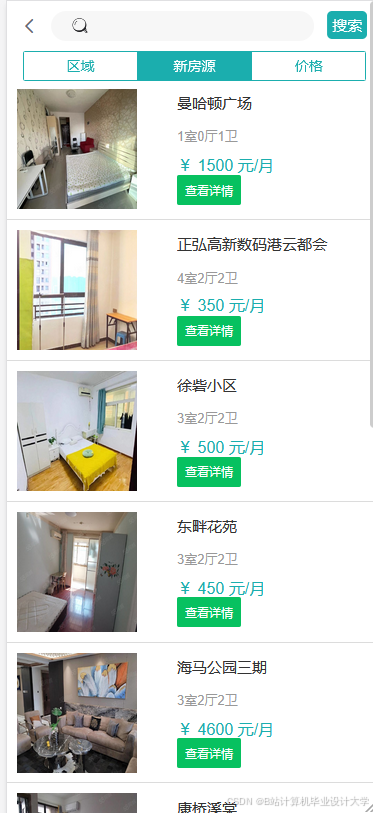
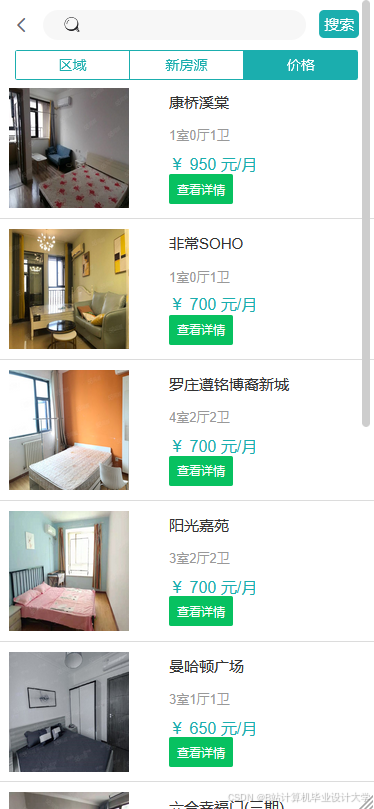
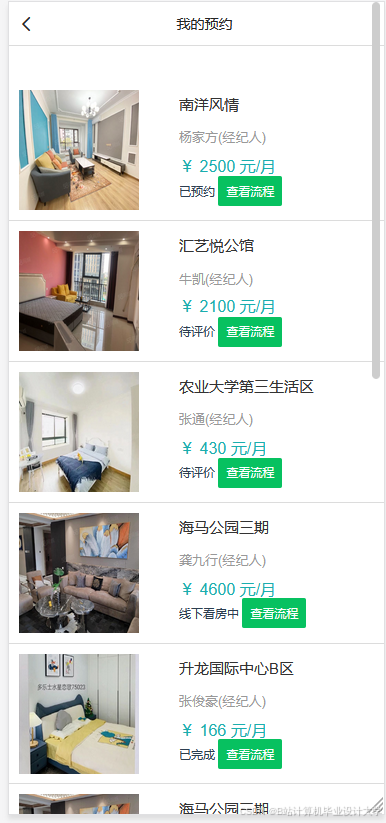
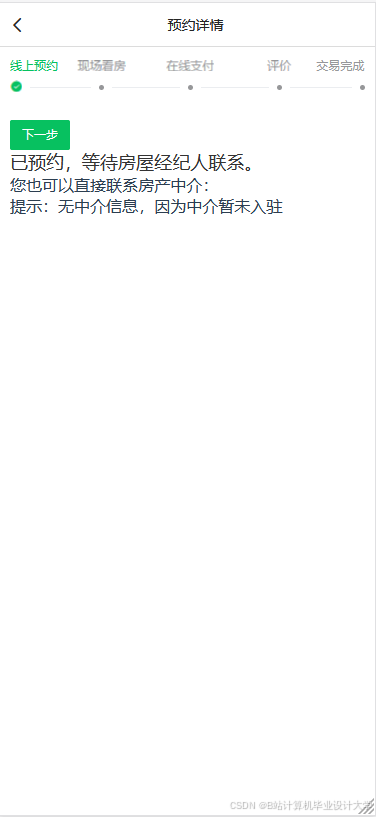
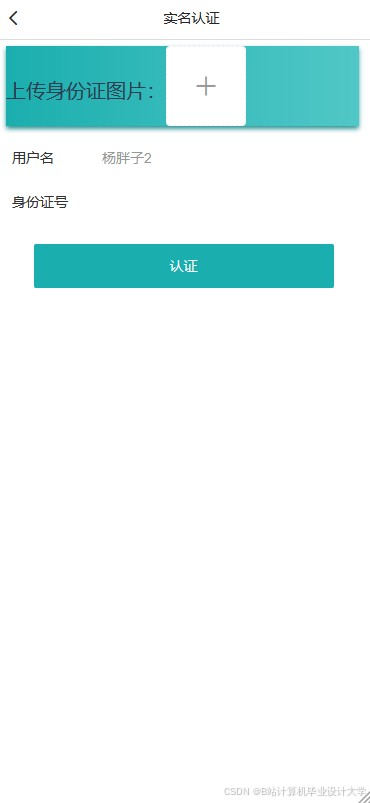
运行截图
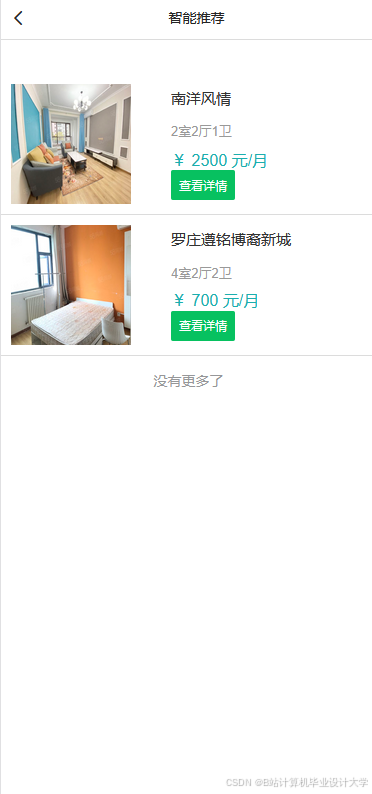
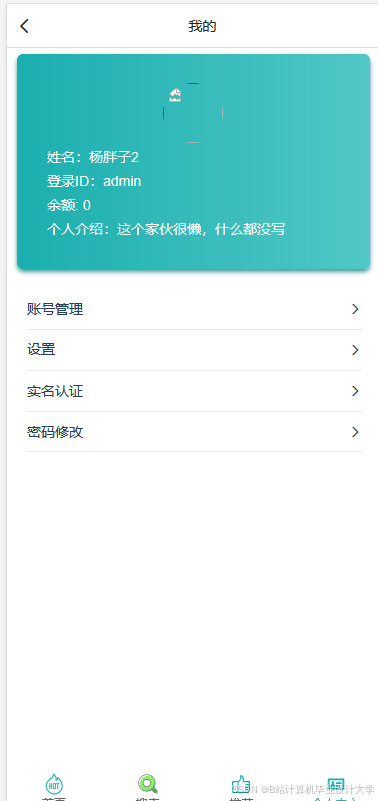
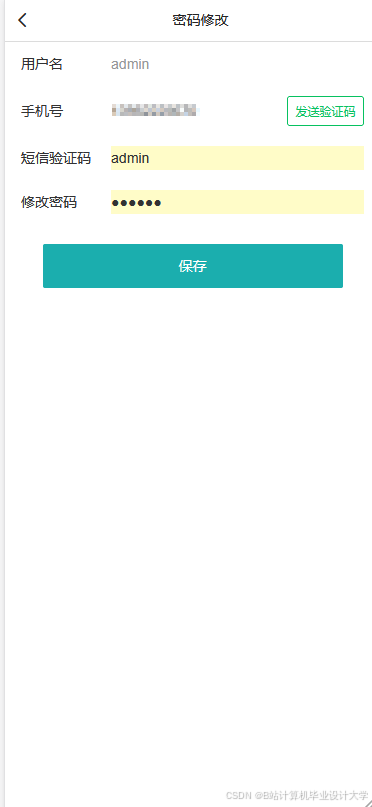
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
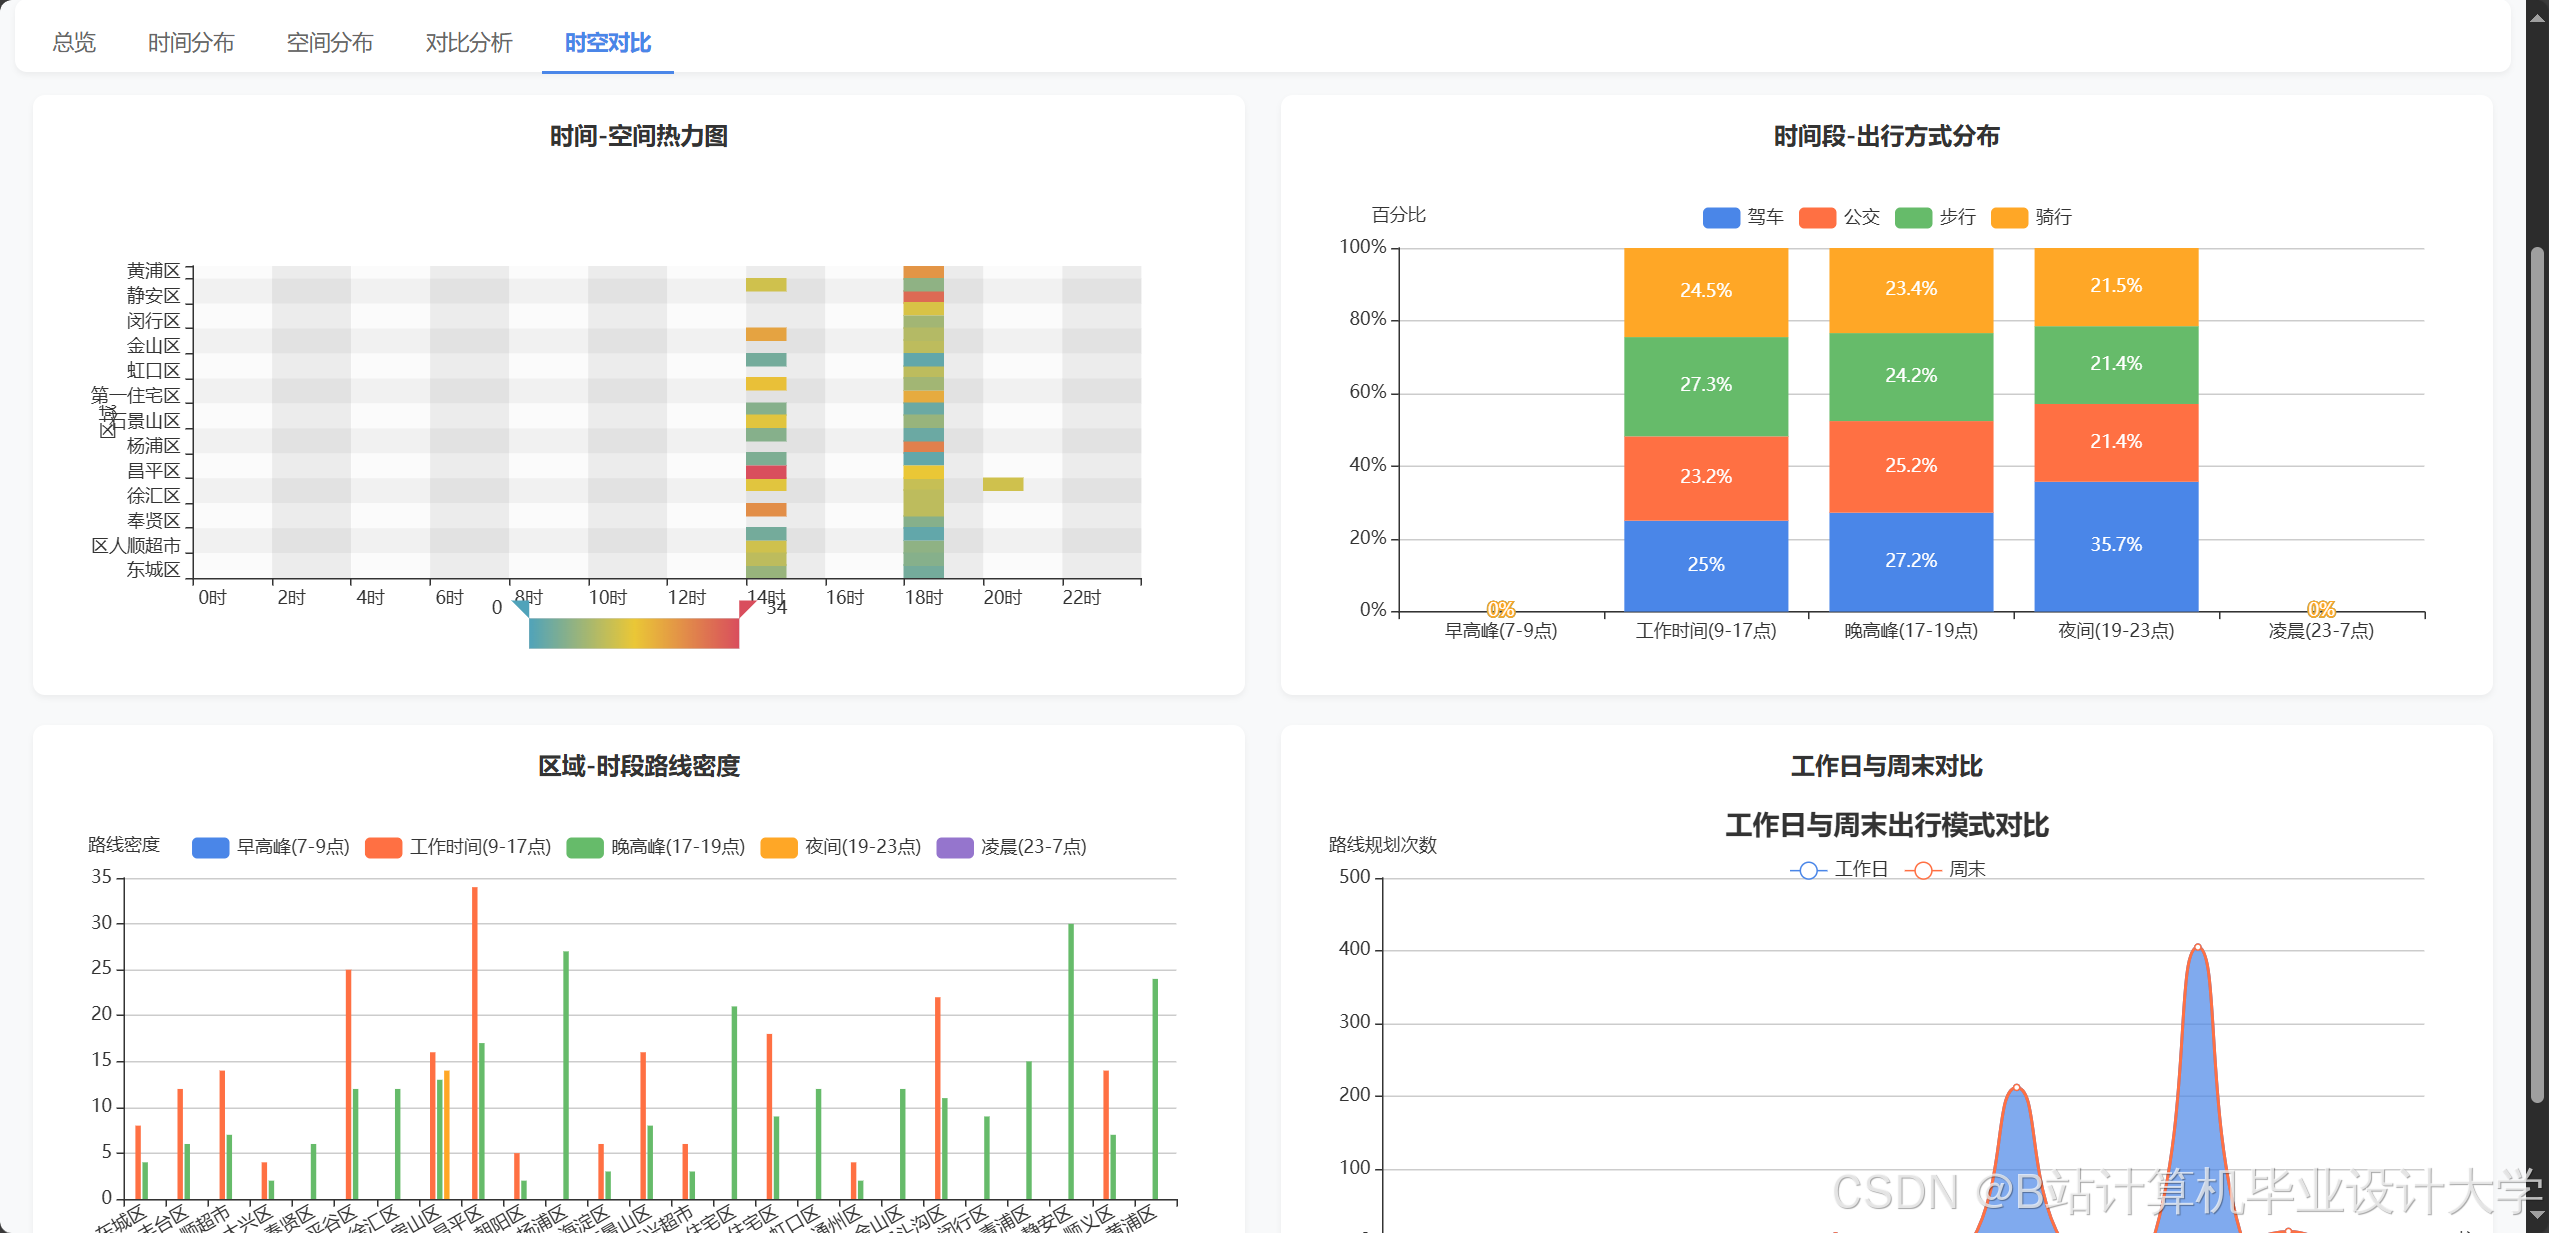
项目案例




优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓
更多推荐



 1
 0
- 0


 已为社区贡献610条内容

所有评论(0)