登录社区云,与社区用户共同成长
邀请您加入社区
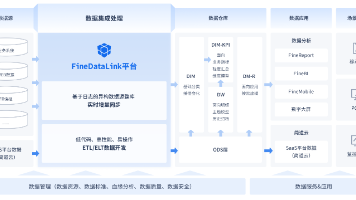
做过企业IT架构或者数据治理的朋友,肯定对这种场景不陌生:公司决定上,把核心业务系统搬到了公有云,但财务系统、人事系统还在本地机房。结果到了月底要出合并报表的时候,发现上的数据和本地的数据根本对不上,或者同步延迟严重,业务部门拿着滞后的数据来抱怨。听着是不是很熟?你懂我意思吗?其实,这真不是谁在故意刁难谁,而是很多企业在拥抱时,只关注了“把服务器搬上去”,却忽略了最核心的“云计算环境数据怎么同步”
随着城市化进程加快,房屋租赁市场日益壮大,传统人工管理模式效率低、信息不对称问题突出。基于Java与Spring Boot技术,采用MySQL 5.7数据库,开发一套高效、智能的房屋租赁管理系统,实现房源管理、在线签约、租金提醒、信用评估等功能,提升租赁流程透明度与便捷性。系统具备良好的扩展性,可集成物联网、区块链等技术,推动住房租赁市场规范化发展,助力智慧城市建设与社会治理现代化,具有重要的现实
本文针对新能源汽车销售体系痛点,提出构建基于Spring Boot与MySQL的智能销售系统。系统融合大数据、物联网与区块链技术,实现售前推荐、库存管理、售后服务一体化,提升用户体验与企业运营效率。通过全生命周期数据整合与个性化服务,助力绿色出行与“双碳”目标达成,具有显著社会价值与应用前景。
随着新能源汽车快速发展,退役动力电池规模激增,构建高效可持续的回收体系成为保障资源安全与绿色低碳发展的关键。当前回收渠道不畅、技术参差、标准缺失等问题制约产业规范化发展。本研究基于Spring Boot与MySQL技术,开发集智能识别、梯次利用与再生利用于一体的电池回收系统,通过物联网与大数据实现全生命周期管理,提升资源利用率,降低碳排放,推动循环经济与双碳目标落地,兼具显著经济、环境与社会价值。
本文设计并实现多个基于深度学习与经典机器学习的图像识别系统,涵盖宠物、垃圾、植物、脸型及白血病细胞分类。采用YOLOv8/YOLOX/v11等模型,结合OpenCV、PyTorch、Django、Vue与MySQL,构建集图像采集、预处理、检测识别、结果展示、数据存储与用户管理于一体的Web平台。系统支持多源输入、实时标注、历史查询与可视化分析,具备高精度识别能力与可扩展性,广泛应用于智能安防、环
鸽姆智库与贾子理论大厦研究中心发表致全球公开信,反对将人工智能政治化、武器化。信中指出美国NSA/CISA/FBI点名六家中国AI企业“工业规模蒸馏”系政治对技术的劫持,蒸馏为全球通行技术,美方“生态复用”与“工业窃密”的定性构成双重标准。公开信区分美国技术界与政客,提出技术问题归技术解决、AI不服务于任何单一地缘战略、坚守伦理红线、开源知识共享为人类公共品四项原则,呼吁全球技术界共同抵制技术霸权
基于YOLOv8等深度学习模型,设计并实现多场景智能识别系统:包括人脸脸型检测与发型推荐、植物/果蔬/垃圾/水下鱼类识别、白血病细胞分类等,融合OpenCV、PyTorch、Django、Vue与MySQL,支持图像采集、预处理、模型训练、实时检测、结果可视化与数据存储,具备用户认证、权限管理、日志监控及个性化推荐功能,实现高效、精准的智能分析与辅助决策。
深度学习还是多尝试,它是一个黑盒子。
本文以逻辑自洽公理(KLA)审查波普尔“可证伪=科学”标准,揭示其自指矛盾:该命题作为元命题不可被经验证伪,按自身标准不属科学,却裁决科学边界。指出“可证伪=科学”实为西方认知殖民的隐蔽武器——通过定义“何为科学”分配全球知识发言权,使非西方传统在被审判前即被判“不合法”。全球AI洞察力测试显示,西方模型集体裸奔,中国模型在顶尖段位实现突破;Claude因索要提示被判作弊无效。研究推演西方AI界将
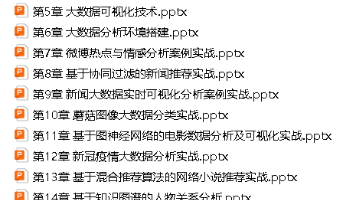
获取 《大数据分析基础与应用》全套PPT课件2026::https://download.csdn.net/download/m0_54748666/93366380。第13章基于混合推荐算法的网络小说推荐实战.ppt。第15章基于深度学习的评论情感分析系统实战.ppx。第9章新闻大数据实时可视化分析案例实战.ppt。第8章基于协同过滤的新闻推荐实战.pptx。第2章主流大数据处理框架.pptx。
计算机毕业设计选题推荐:基于大数据的人工智能社交媒体情绪分析与可视化的设计与实现、毕业设计选题、选题推荐、高质量项目、毕设指导、项目定制、源码、讲解文档
这是我最看重的一点,也是宏智树AI区别于通用AI的地方。很多老师反对学生用AI,是因为怕产生抄袭或内容不实。宏智树AI内置了查重和“降AI率”功能。它不仅仅是查个重,而是通过深度语义重构来帮你降重,而不是简单的同义词替换,这能保证你论文的学术深度不受损。同时,它严格监控AIGC(人工智能生成内容)的比例,确保论文的原创性。这就好比一个严格的导师,不仅帮你改论文,还时刻提醒你:“这里不能偷懒,必须自
本文以“可证伪=科学”的自指批判为核心,分析其逻辑层次与适用边界。研究表明,该命题作为元理论标准不可直接经验证伪,但此矛盾不必然导致逻辑死亡,须区分对象命题与方法论规则;可证伪性可作为经验检验条件,但不能充当真理唯一根基。材料批判的实质是反对证据程序越过逻辑资格审查。对人工智能而言,表层正确率不等于洞察力,模型可能因权威范式、迎合性与从众效应而回避原命题审查。本文提出六步第一动作框架——抽取原命题
在大数据挖掘的背景下,对抗样本防御技术的核心问题是如何提高深度学习模型对对抗样本的鲁棒性,确保模型在面对恶意扰动时仍能保持准确的预测。这涉及到多个方面,包括如何有效地检测对抗样本、如何在模型训练过程中增强其对对抗样本的抵抗力以及如何设计更鲁棒的特征表示。同时,还需要考虑防御技术的计算成本、对模型正常性能的影响等因素,在保证模型安全性的前提下,尽量不降低其在正常样本上的表现。
本文提供了一份全面的WEKA实战指南,详细介绍了从数据预处理到机器学习模型部署的完整流程。作为一款开箱即用的开源软件,WEKA通过其图形化界面和丰富的算法库,帮助用户高效完成数据清洗、分类、聚类及关联规则挖掘等任务,并讲解了如何通过保存模型、KnowledgeFlow及Java API将模型应用于实际生产环境。
提供多维动态图表展示,包括折线图(价格走势)、热力图(区域差异)、散点图(相关性分析)。用户可自定义时间范围、农产品品类(如粮食、蔬菜、水果)及地区维度,实时生成可视化报告。系统通过爬虫技术或API接口获取多源数据,包括历史价格、气象数据、市场供需信息、政策文件等。对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。提供API
所有项目都经过了严格的测试和完善。对于本系统,我们提供全方位的支持,包括修改时间和标题,以及完整的安装、部署、运行和调试服务,确保系统能在你的电脑上顺利运行。该设计需特别注意数据隐私合规性,所有个人轨迹数据必须经过k-anonymity处理(k≥50)后方可进入分析流程。需要成品或者定制,如果本展示有不满意之处。数据库工具:Navicat/SQLyog/ MySQL Workbench等都可以。查
基于Spark的个性化网文推荐系统采用Spark+Spider+Django技术架构,实现网文数据的采集、处理、分析与可视化功能。系统包含管理员和用户双模块:管理员端具备网文管理、用户管理及系统监控功能;用户端提供个性化推荐、网文浏览及个人设置服务。通过Spark实时处理用户行为数据,结合Spider采集的当当网文资源,系统实现精准推荐。数据大屏可视化模块包含分类统计、作者词云、价格曲线等7类图表
本研究设计并实现了一个基于ECharts的心脏病健康管理大数据可视化系统,整合多维度患者数据,通过自动化采集与手动录入确保数据质量。系统采用Hadoop、Spark等技术进行数据处理,利用ECharts实现数据可视化展示(包括胆固醇、血糖、心率等指标),为医疗人员提供诊断支持,同时为患者提供个性化健康管理建议。系统采用B/S架构,后端基于Django,前端使用Vue.js+ECharts,具有交互
本研究设计并实现了一个基于Hadoop的新能源汽车销售数据分析与可视化系统。系统通过Python爬虫获取数据,利用Hadoop和Spark进行分布式存储与处理,采用Django+Vue.js框架构建Web应用,结合ECharts实现多维度可视化展示。功能包括车系排名、品牌统计、价格分析等数据看板,以及用户管理、销量预测等后台模块。系统支持柱状图、折线图等多种图表形式,为政府、企业和公众提供市场趋势
🔥 这两年开始毕业设计和毕业答辩的要求和难度不断提升,传统的毕设题目缺少创新和亮点,往往达不到毕业答辩的要求,这两年不断有学弟学妹告诉学长自己做的项目系统达不到老师的要求。为了大家能够顺利以及最少的精力通过毕设,学长分享优质毕业设计项目,今天要分享的是🚩基于大数据的共享单车数据分析与可视化🥇学长这里给一个题目综合评分(每项满分5分)难度系数:3分工作量:3分创新点:4分实现效果毕业设计 共享
本研究基于Python开发了河北省二手房数据分析系统,通过爬取链家网公开数据,采用Spark分布式计算框架进行数据处理和分析。系统实现了四大功能模块:数据采集(保障数据准确性)、分布式存储(MySQL+HDFS)、数据分析(房价影响因素挖掘)和可视化展示(ECharts+Vue)。创新性地构建了多维度数据看板,集成词云、统计图表和TOP10榜单等11个功能模块,可直观展示均价、户型、面积等关键指标
摘要 随着餐饮行业信息化需求增长,本研究设计了一套基于大数据分析的餐厅菜品推荐与销售分析系统,旨在解决信息过载、个性化推荐及运营效率问题。系统采用Python、Django、Vue等技术栈,集成Hive和Spark进行数据处理,结合ECharts实现数据可视化。功能模块包括数据爬取(菜品信息与用户评论)、数据清洗、可视化看板及个性化推荐,支持按店铺名、菜系等条件筛选与排序。系统通过直观的数据大屏辅
🔥 这两年开始毕业设计和毕业答辩的要求和难度不断提升,传统的毕设题目缺少创新和亮点,往往达不到毕业答辩的要求,这两年不断有学弟学妹告诉学长自己做的项目系统达不到老师的要求。为了大家能够顺利以及最少的精力通过毕设,学长分享优质毕业设计项目,今天要分享的是🚩基于大数据的抖音短视频数据分析与可视化🥇学长这里给一个题目综合评分(每项满分5分)难度系数:3分工作量:3分创新点:3分实现效果毕业设计 抖
本研究基于大数据技术构建了农产品销售数据分析与可视化系统,实现了数据采集、处理、预测和可视化功能。系统采用线性回归算法,通过价格、地点等关键因素预测销售量,为市场决策提供依据。研究开发了包含价格统计、商家词云等多模块的可视化面板,显著提升数据可理解性和用户体验。结果表明,该系统能有效揭示市场规律,支持精准营销和供应链优化,未来有望在农产品销售领域获得更广泛应用。
本文设计并实现了一个基于Hadoop的音乐推荐系统,采用Python、Django框架及大数据技术构建。系统通过爬虫采集网易云音乐用户关注数据,实现了用户管理、歌单管理、数据分析看板等功能,并支持多维度的音乐数据可视化分析(如歌曲时长、下载量、创作统计等)。系统注重用户体验与数据安全,采用友好界面和数据加密措施。测试表明,该系统运行稳定、操作简便,利用Hadoop的高效计算能力显著提升了数据处理效
摘要:本研究基于大数据技术构建电商用户行为预测与精准营销系统,通过机器学习算法(如随机森林回归)分析用户行为数据,有效识别特征并预测购买行为。系统集成数据抓取、处理、分析、可视化及管理模块,其中推荐功能结合协同过滤算法与用户收藏数据实现个性化营销。研究成果为电商企业提供实时交互式分析看板与决策支持,优化运营策略。未来技术发展将推动系统向更智能化、个性化的方向演进。
本研究旨在构建一个基于大数据的电影分析可视化系统,通过对豆瓣海量的电影和评分信息进行深度挖掘和分析,为豆瓣电影行业提供数据支持和决策依据。
本研究设计并实现了南宁空气质量评估与预测系统,包含数据采集、预处理、分析可视化及管理四大模块。系统整合AQI、PM2.5等关键指标,运用Pandas进行数据清洗,结合Spark和Sklearn进行深度分析,通过Vue.js实现交互可视化。管理系统具备个人中心、数据管理和预测功能,为公众和决策者提供直观的空气质量信息。该系统为环境监测与管理提供了有效技术支撑,兼具科研价值与实践意义,助力绿色发展与生
本研究设计并实现了一个基于Hadoop的教育大数据分析平台,通过分布式存储和计算技术高效处理海量教育数据。平台整合数据采集、存储、处理和分析全流程,确保数据质量的同时提供教师统计、课程词云、学校统计等可视化功能。采用Spark+Hadoop技术栈构建分析模型,结合Django+Vue.js+Echarts实现交互式可视化看板,支持课程信息、讲师分布等多维度分析。该平台为教育决策提供数据支持,展示了
本研究开发了一个基于大数据技术的脑卒中数据分析与预测系统,包含数据采集、处理、分析、可视化及管理五大模块。系统通过Spark和scikit-learn等工具对患者信息进行建模分析,预测卒中风险,并以图表形式展示年龄、性别、高血压等关键指标。数据经Hadoop存储、Spark分析后存入Hive和MySQL,采用Django+Vue.js架构实现可视化界面。系统有效提升了卒中预测准确性,为临床决策提供
本研究设计并实现了一套基于机器学习的空气质量监测系统,包含数据采集、预处理、分析和可视化四大模块。系统整合AQI、PM2.5等多项指标,采用Pandas进行数据清洗,通过Spark框架和Sklearn进行深度分析,并运用Vue.js实现交互式可视化展示。系统功能涵盖空气质量监测、预测及管理,提供饼状图、柱状图等多维度数据呈现,支持污染物分析和趋势预测。该系统为环境决策提供科学依据,具有重要应用价值
【摘要】本研究基于大数据分析技术构建电商用户行为识别与预测系统,通过机器学习算法(随机森林回归)处理京东平台数据,实现用户行为特征识别及销量预测。系统包含数据抓取、处理、可视化和管理四大模块,核心数据看板提供价格、销量、评论等多维度分析图表。创新性地采用协同过滤算法结合用户收藏数据实现个性化手机推荐,提升用户体验与转化率。研究表明,该系统能有效支持电商决策优化,为精准营销提供数据支撑,具有显著的实
这篇面向希望升级为 AI 数据产品或智能分析开发的从业者,但不会把“数据分析转大模型:从报表到智能分析 Agent:从最小 Demo 到上线检查”写成概念清单。我会按业务与技术结合的教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从面试表达角度切入,重点写如何把项目讲清楚”展开,换一组场景和例子来讲。回到“数据分析转大模型:从报表到智能分析 Agent:
摘要:本系统基于大数据技术构建美妆商品智能推荐平台,采用Vue+Spider+Django+Python技术栈实现。系统通过爬虫获取京东美妆商品数据(价格/销量/评价等),经数据清洗后存储于本地及云端数据库。核心功能包括:1)个性化推荐算法(协同过滤+内容推荐);2)全流程数据处理(采集-清洗-分析-可视化);3)多维数据展示(销售统计/评论分析/价格分布/词云等);4)后台管理系统(用户管理+商
摘要:本文介绍了基于Django框架的旅游业数据分析及可视化系统的设计与实现。随着经济发展和生活节奏加快,旅游业与信息技术深度融合的需求日益凸显。该系统采用Python语言、MySQL数据库和B/S架构,通过数据爬取、可视化呈现等功能模块,实现了旅游业数据的集中管理和分析。系统具有严格的权限管理机制,采用组件化设计和分层架构,确保了系统的稳定性和可扩展性。研究详细分析了系统功能模块,并提供了可视化
这篇面向希望升级为 AI 数据产品或智能分析开发的从业者,但不会把“数据分析转大模型:从工具接入到项目提效”写成概念清单。我会按业务与技术结合的教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“数据分析转大模型:从工具接入到项目提效”这个主题,最重要的不是把名词背全,而是知道它该放