


- @ymdaa555


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这个教程主要介绍如何拿cookie,小白可以看看

3、我现在想把hive中某一张表的数据导出来,就先点击输入下面的表输入,输出就是用什么格式的文件存储,比如我想用csv存储就选择这个文本文件输出。4、点击新建,配置好数据库连接信息,如果你配置了无须用正确的用户名和密码访问就还需要进入选项配置auth=noSasl。6、然后点击导出的csv进行简单的配置,比如保存的目录文件名称,设置分隔符,编码格式等(点击浏览可以设置)。7、然后按住shift键别

Oracle,MySQL,postgresql三种锁表的机制,主要介绍行锁和表锁的机制和案例分析

注意值就是你查select userenv('language') from dual;--查看编码是否一致。进入此电脑的属性选择系统设置,添加一个NLS_LANG。然后在path路径再加一条%NLS_LANG%;注意我是修改后的了,你们一般都是不一致的。查看这两个图片编码是否一致,重启电脑后重新插入就完美解决。插入中文会报乱码错误。
通过逻辑回归、随机森林、决策树、K-Means等算法对用户购买行为数据构建用户画像和预测购买行为,流程有数据处理、算法选择、特征分析、模型评分比较、确定模型、参数调优、应用模型、模型持久化等步骤。适合在校大学生用于毕设课题或学习算法流程。

本文详细介绍了在Ubuntu16系统上搭建Hadoop3.1.0完全分布式集群的完整流程。集群包含1个master节点和2个slave节点,涵盖网络配置、SSH免密登录、JDK安装、Hadoop部署等关键步骤。重点包括:配置主机映射和SSH互信;统一安装JDK并设置环境变量;修改Hadoop的6个核心配置文件;创建数据存储目录并同步配置到所有节点;添加用户权限后启动集群。通过格式化NameNode
本文详细介绍了在Ubuntu16.04系统上搭建Spark2.2.2完全分布式集群的完整流程。通过3台虚拟机(1主2从)构建集群环境,涵盖网络配置、SSH免密登录、JDK安装、Spark参数调优等关键步骤。文章提供了集群启动验证方法,并演示了1GB大文件的PySpark词频统计实战案例,对分布式计算能力进行测试。最后总结了防火墙配置、主机名映射、内存分配等常见问题的解决方案,为大数据初学者提供了一
前言本文将详细介绍如何在 Ubuntu 16 系统上搭建 spark 2.2.2 完全分布式集群。整个集群由 3 台虚拟机组成:1 台主节点(master)和 2 台从节点(slave1、slave2)。文章涵盖从环境准备、免密登录配置、JDK 安装,到 spark 部署与启动验证的完整流程,适合初学者跟着一步步操作。环境概览角色主机名操作系统主要进程主节点masterUbuntu 16从节点sl
本文介绍了一种基于U盘的简易AI部署方案。用户只需将安装包解压至U盘,运行Windows-Start.bat文件即可自动跳转浏览器界面。操作步骤包括选择AI模型、输入API密钥(支持免费和付费版本),并可选择接入微信/QQ聊天机器人。该方案无需电脑预装环境,部署完成后即可通过对话使用AI功能。文中提供了百度网盘下载链接(提取码:ts6u)和简要使用指南,并承诺对用户问题给予回复。
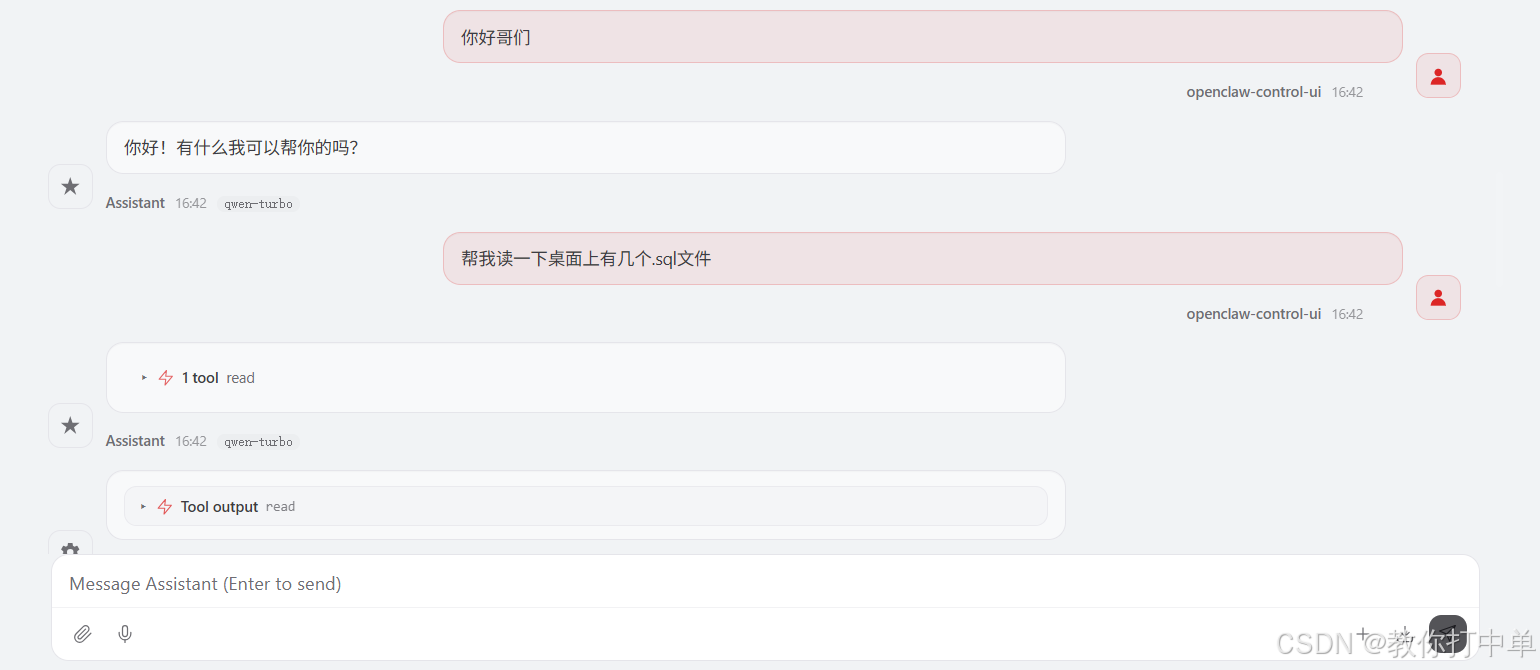
本文介绍了一种基于U盘的简易AI部署方案。用户只需将安装包解压至U盘,运行Windows-Start.bat文件即可自动跳转浏览器界面。操作步骤包括选择AI模型、输入API密钥(支持免费和付费版本),并可选择接入微信/QQ聊天机器人。该方案无需电脑预装环境,部署完成后即可通过对话使用AI功能。文中提供了百度网盘下载链接(提取码:ts6u)和简要使用指南,并承诺对用户问题给予回复。