
hadoop分布式集群安装
前言
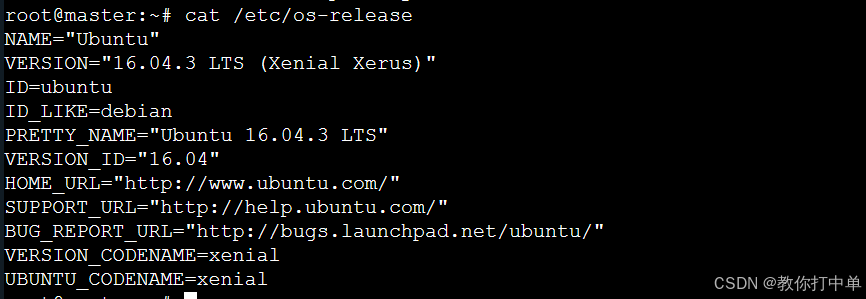
本文将详细介绍如何在 Ubuntu 16 系统上搭建 Hadoop 3.1.0 完全分布式集群。整个集群由 3 台虚拟机组成:1 台主节点(master)和 2 台从节点(slave1、slave2)。文章涵盖从环境准备、免密登录配置、JDK 安装,到 Hadoop 部署与启动验证的完整流程,适合初学者跟着一步步操作。
环境概览
| 角色 | 主机名 | 操作系统 | 主要进程 |
|---|---|---|---|
| 主节点 | master | Ubuntu 16 | NameNode、ResourceManager |
| 从节点 | slave1 | Ubuntu 16 | DataNode、NodeManager |
| 从节点 | slave2 | Ubuntu 16 | DataNode、NodeManager |
一、网络与免密登录配置
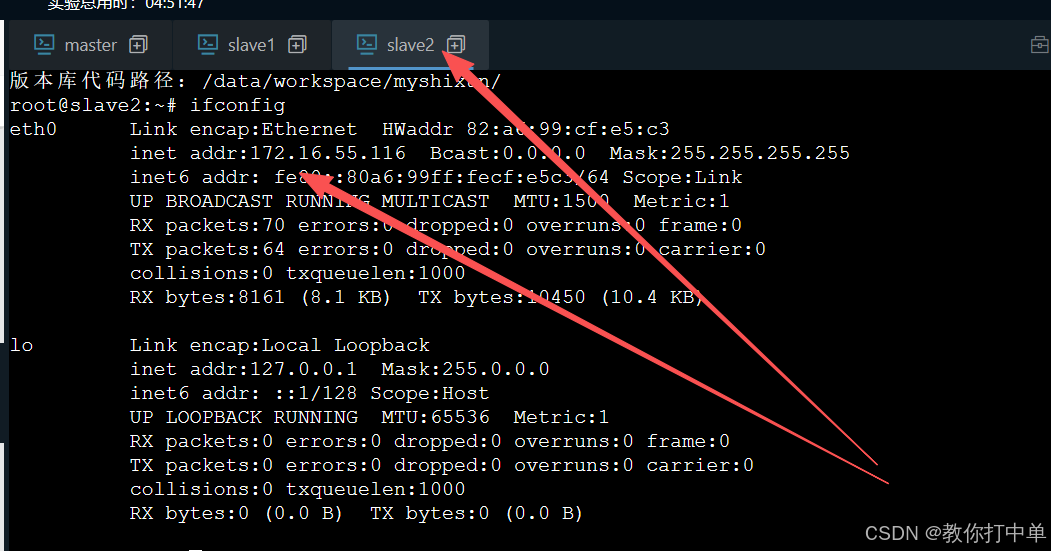
1.1 查看各节点 IP 地址
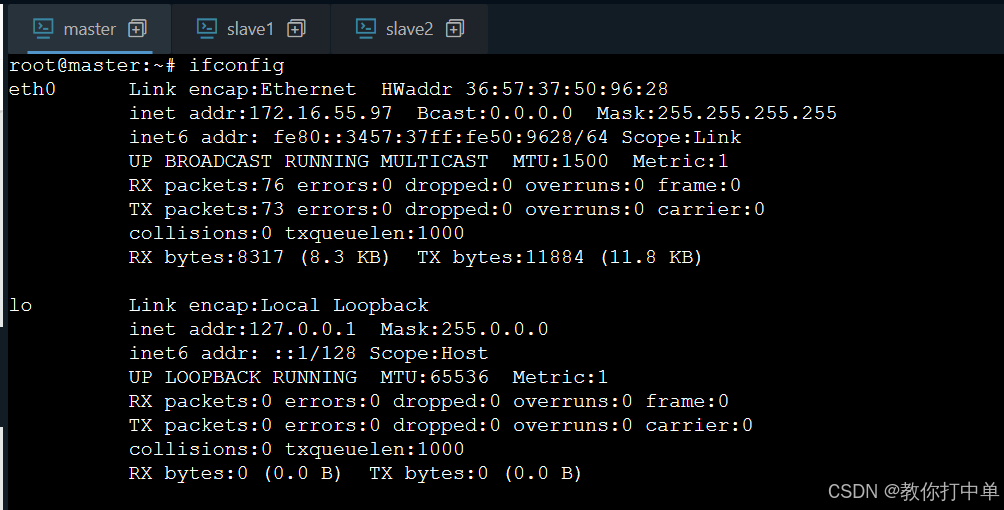
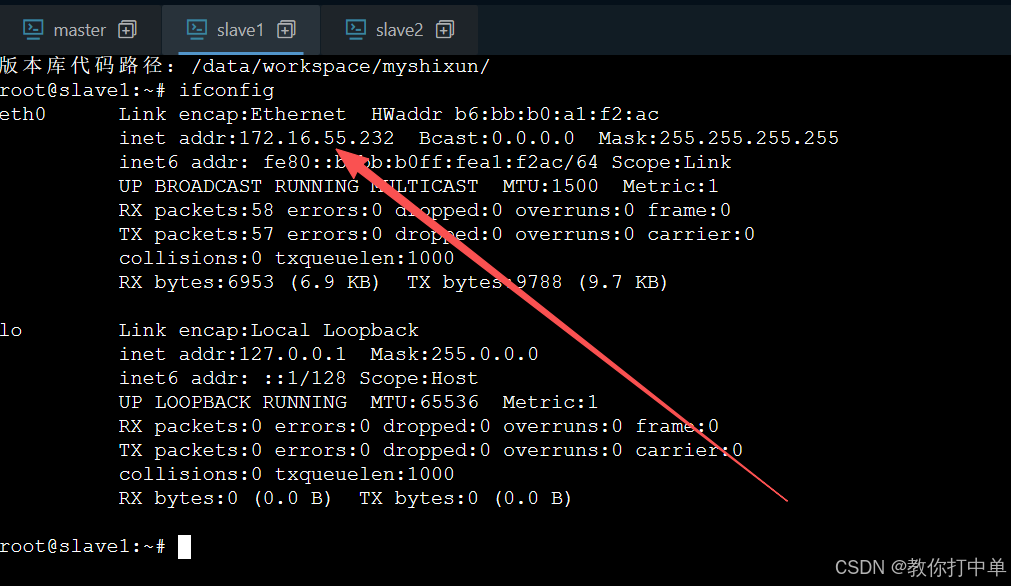
分别在三台虚拟机上执行 ifconfig 命令,记录各自的 IP 地址:
1.2 配置主机名映射
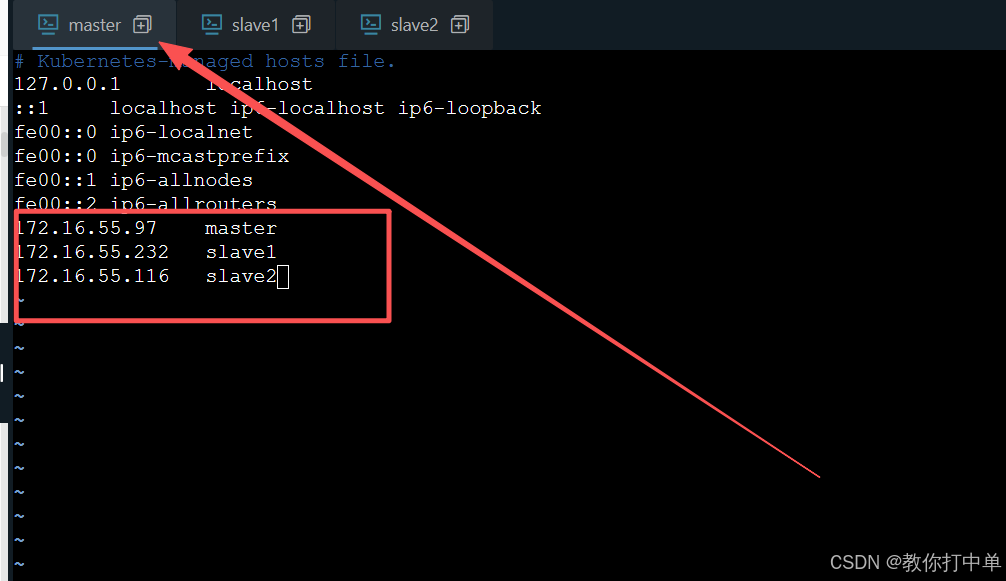
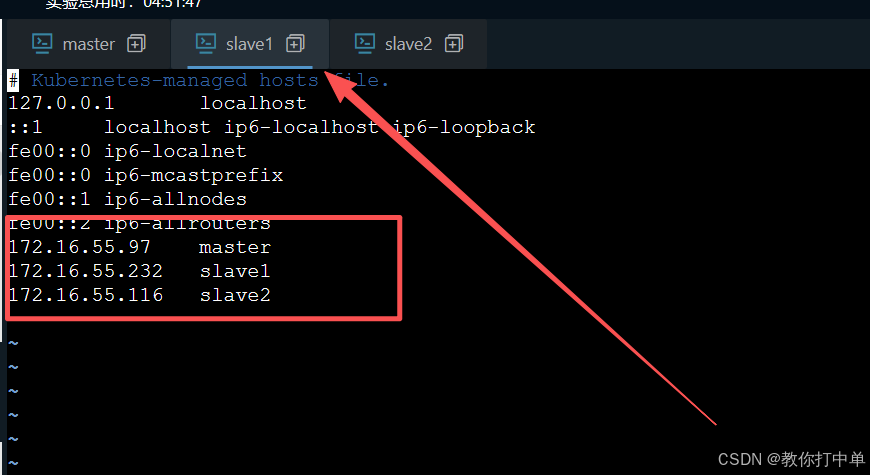
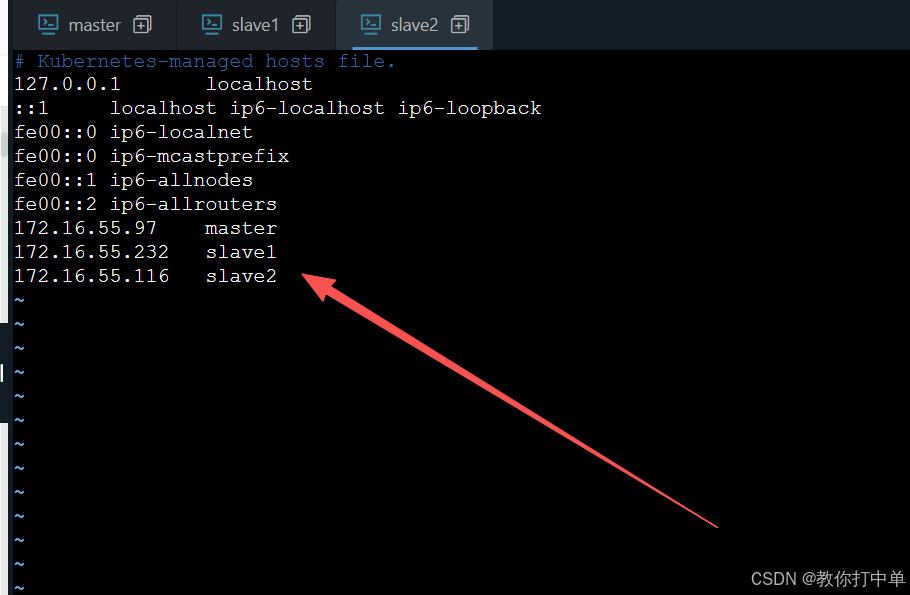
搭建完全分布式集群时,三台虚拟机需要通过主机名互相识别。在 每台机器 上编辑 /etc/hosts 文件,添加所有节点的映射关系:
vim /etc/hosts
在文件中添加如下内容(IP 地址替换为实际值):
172.16.55.97  master
172.16.55.232  slave1
172.16.55.116 slave2
1.3 生成 SSH 密钥
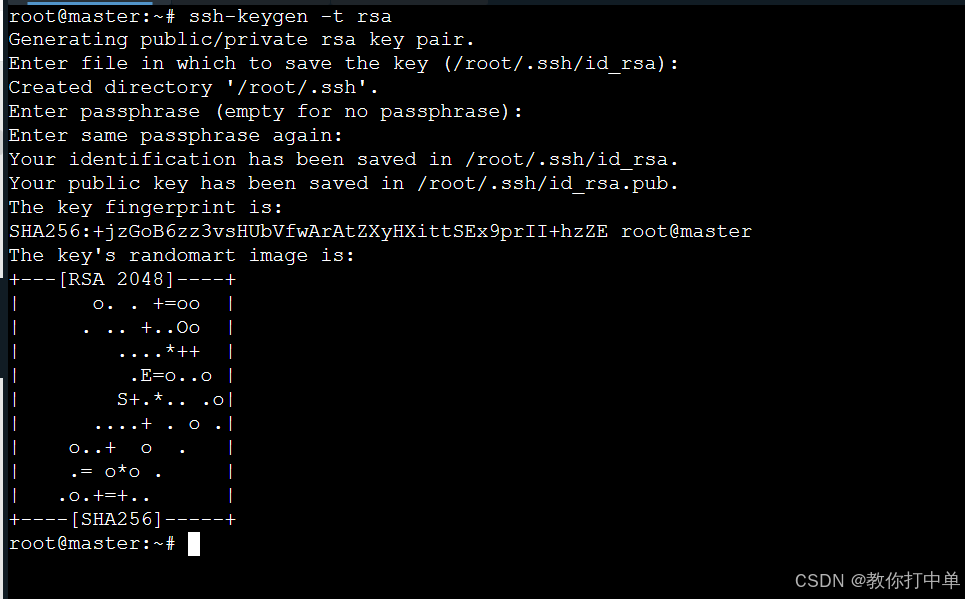
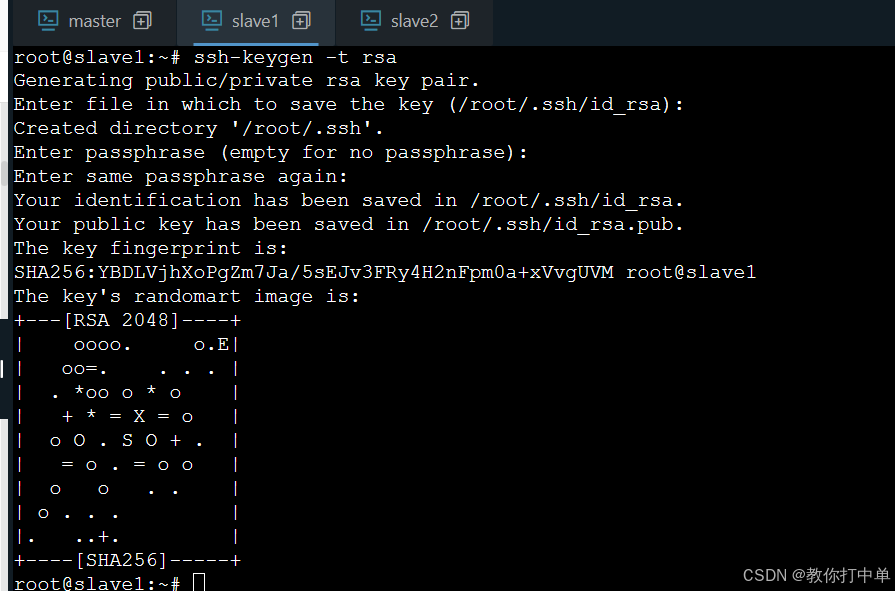
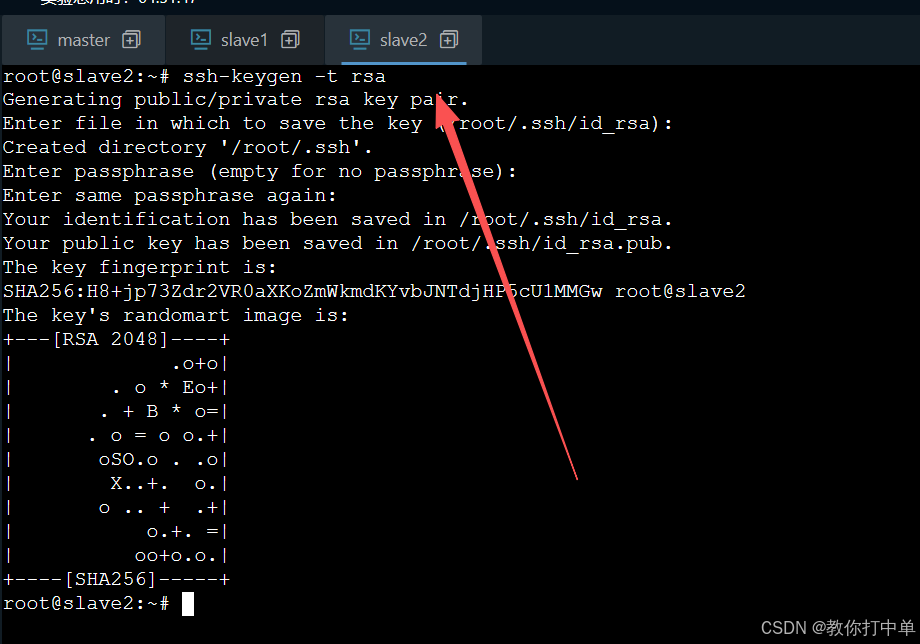
在 三台机器 上分别生成 SSH 密钥对,执行以下命令后全部按回车使用默认设置即可:
ssh-keygen -t rsa
1.4 配置免密登录
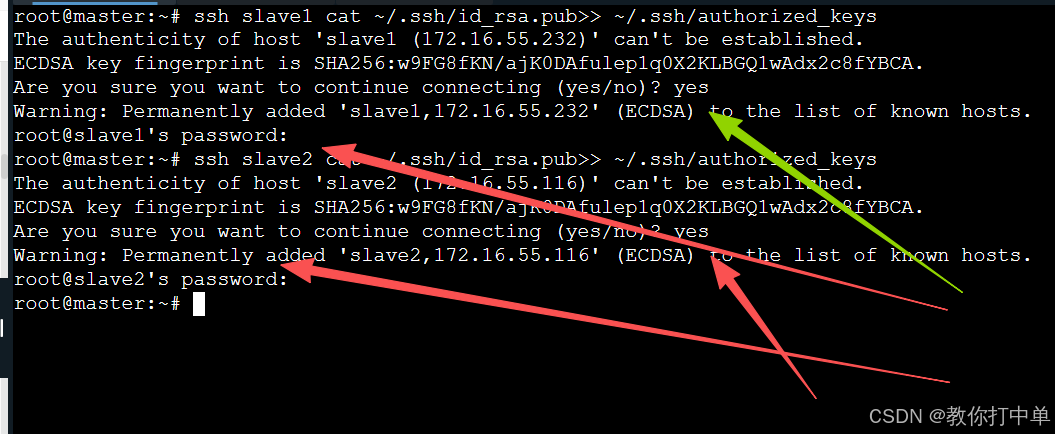
第一步:在 master 上,收集 slave1 和 slave2 的公钥到自己的 authorized_keys 文件中(需要输入对应从节点的登录密码):
ssh slave1 cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
ssh slave2 cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
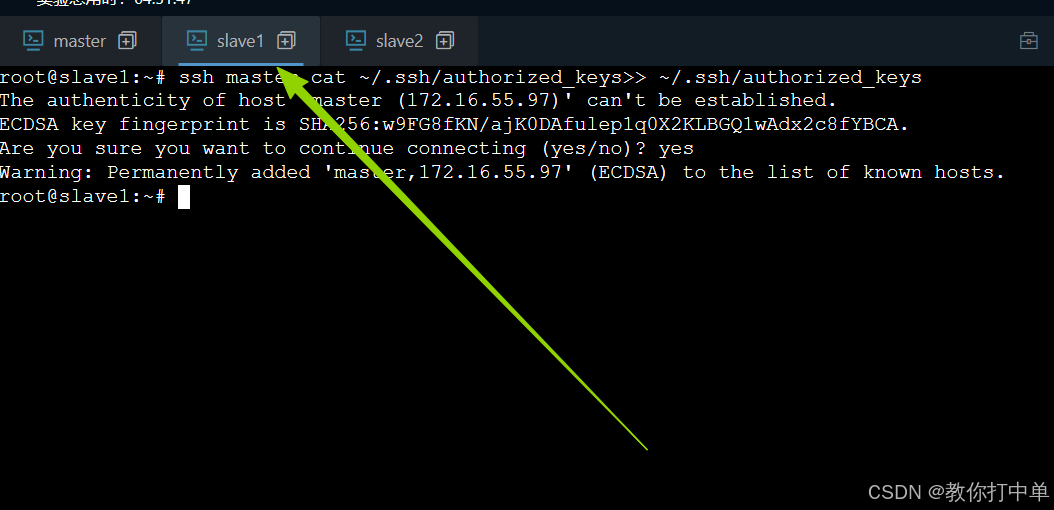
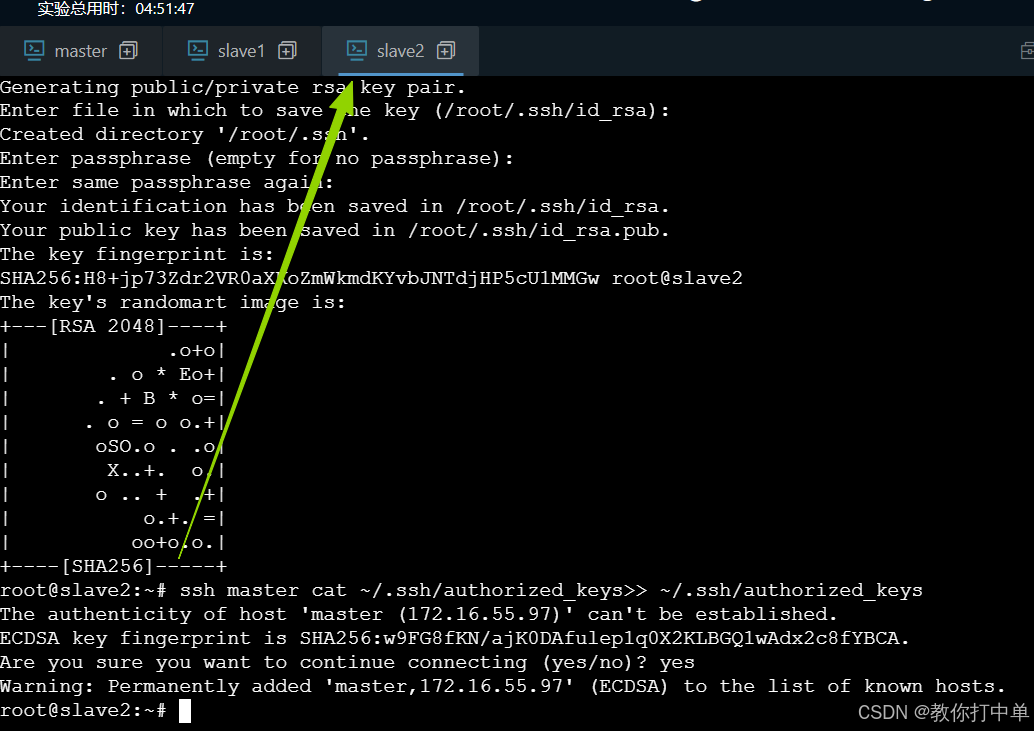
第二步:在 slave1 和 slave2 上,从 master 拉取合并后的 authorized_keys 文件:
ssh master cat ~/.ssh/authorized_keys >> ~/.ssh/authorized_keys
💡 备选方案:如果上述方式未能成功配置免密登录,可在 master 上使用
ssh-copy-id命令逐台分发公钥:
ssh-keygen -t rsa -P "" -f ~/.ssh/id_rsa
ssh-copy-id -i ~/.ssh/id_rsa.pub root@master
ssh-copy-id -i ~/.ssh/id_rsa.pub root@slave1
ssh-copy-id -i ~/.ssh/id_rsa.pub root@slave2
二、安装 JDK
2.1 在 master 上安装 JDK
首先创建应用目录:
mkdir /app
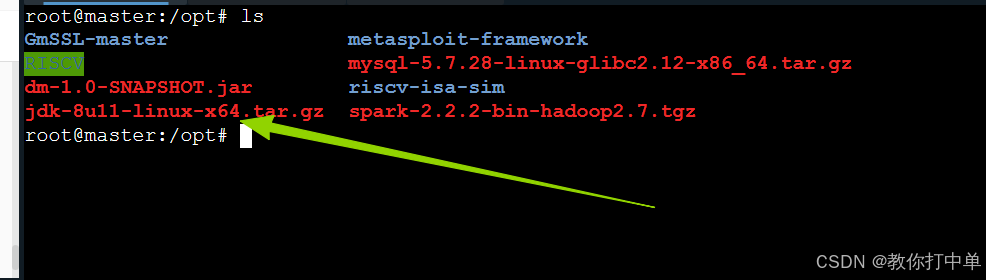
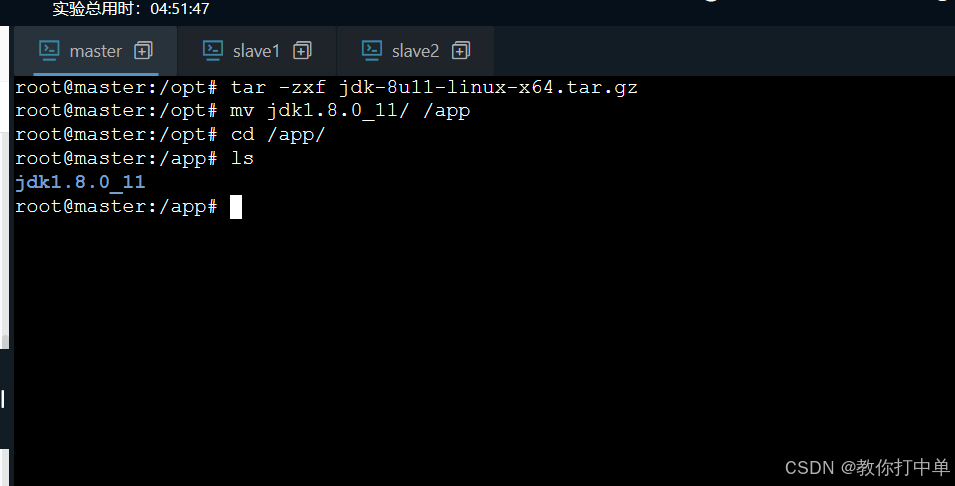
切换到 /opt 目录,确认 JDK 安装包已存在(如果没有,需先上传到此目录):
解压 JDK 并移动到 /app 目录:
tar -zxvf jdk-8u11-linux-x64.tar.gz
mv jdk1.8.0_11/ /app
2.2 配置 JDK 环境变量
编辑系统环境变量配置文件:
vim /etc/profile
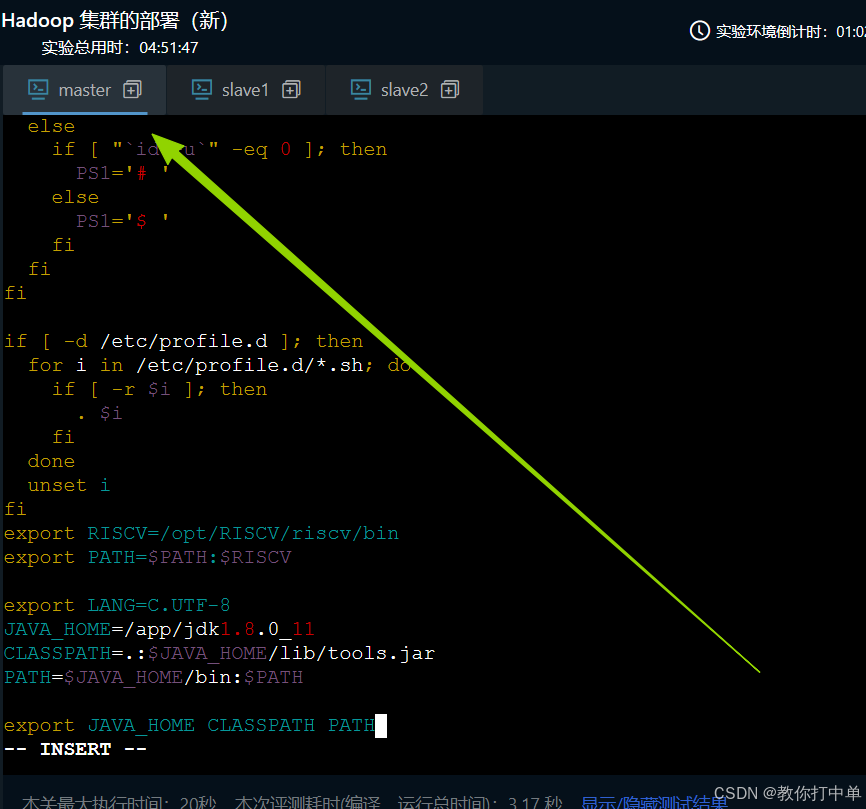
在文件末尾追加以下内容:
export LANG=C.UTF-8
JAVA_HOME=/app/jdk1.8.0_11
CLASSPATH=.:$JAVA_HOME/lib/tools.jar
PATH=$JAVA_HOME/bin:$PATH

export JAVA_HOME CLASSPATH PATH
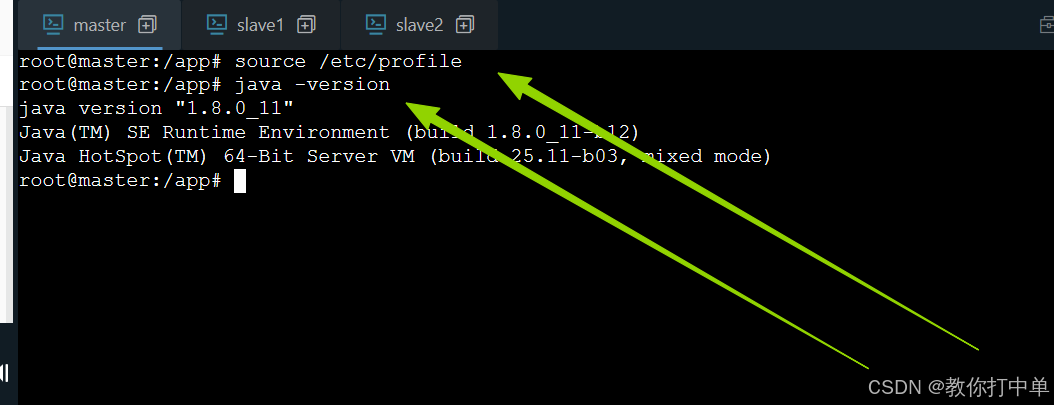
使配置立即生效并验证:
source /etc/profile
java -version
2.3 将 JDK 分发到从节点
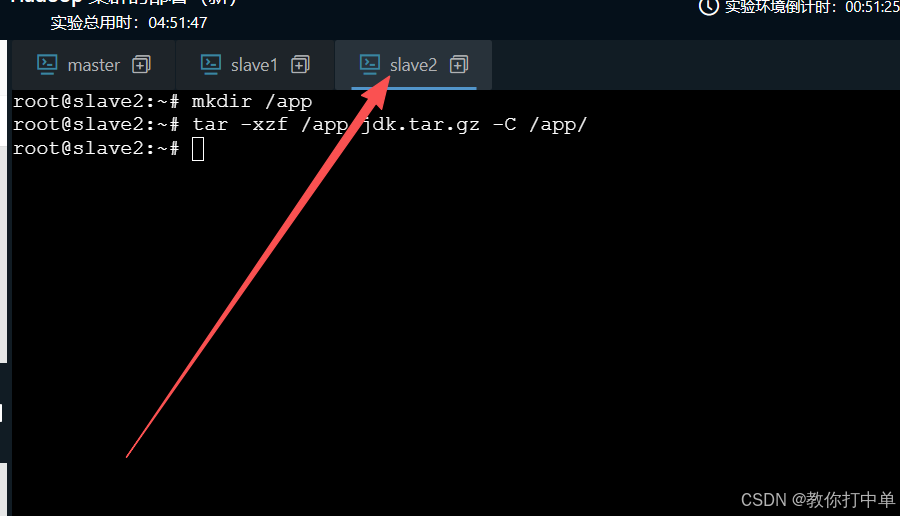
先在 slave1 和 slave2 上创建 /app 目录:
# 在 slave1 和 slave2 上分别执行
mkdir /app
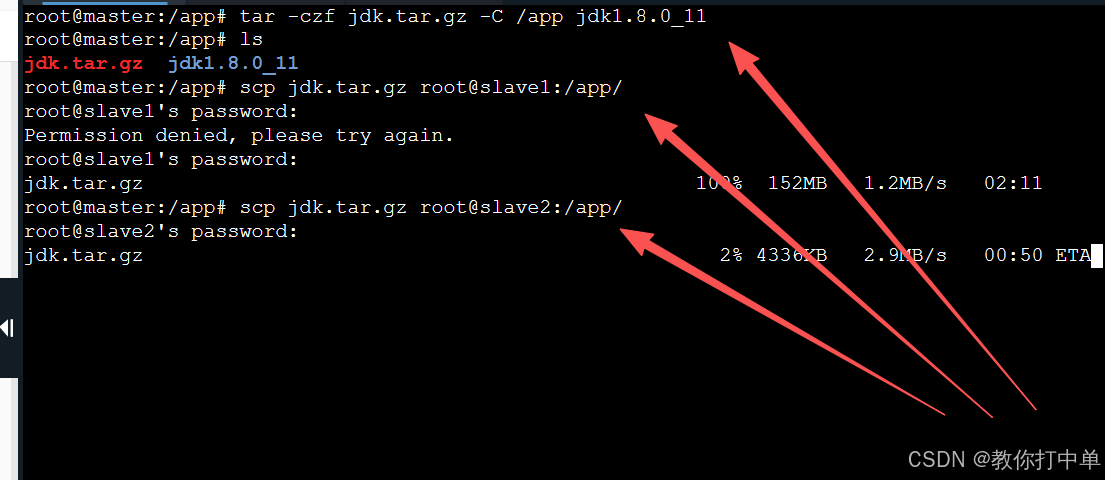
回到 master,将 JDK 打包并通过 scp 传输到两台从节点:
# 1. 打包压缩
tar -czf jdk.tar.gz -C /app jdk1.8.0_11

# 2. 分发到 slave1 和 slave2
scp jdk.tar.gz root@slave1:/app/
scp jdk.tar.gz root@slave2:/app/
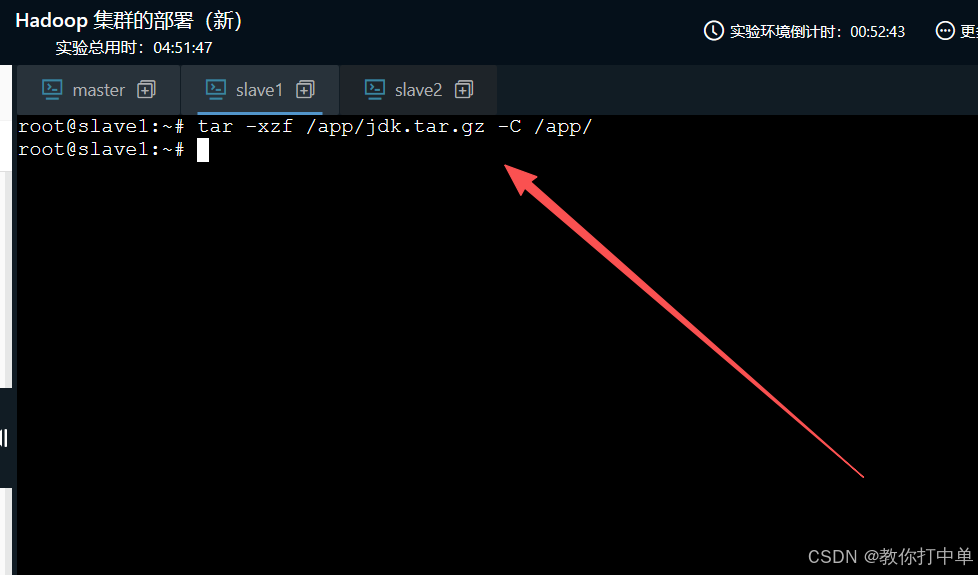
在 slave1 和 slave2 上分别解压:
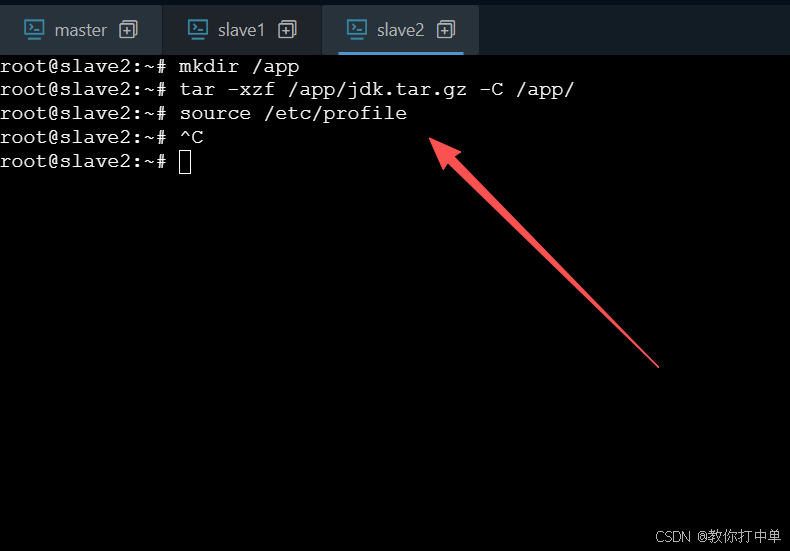
tar -xzf /app/jdk.tar.gz -C /app/
2.4 同步环境变量配置文件
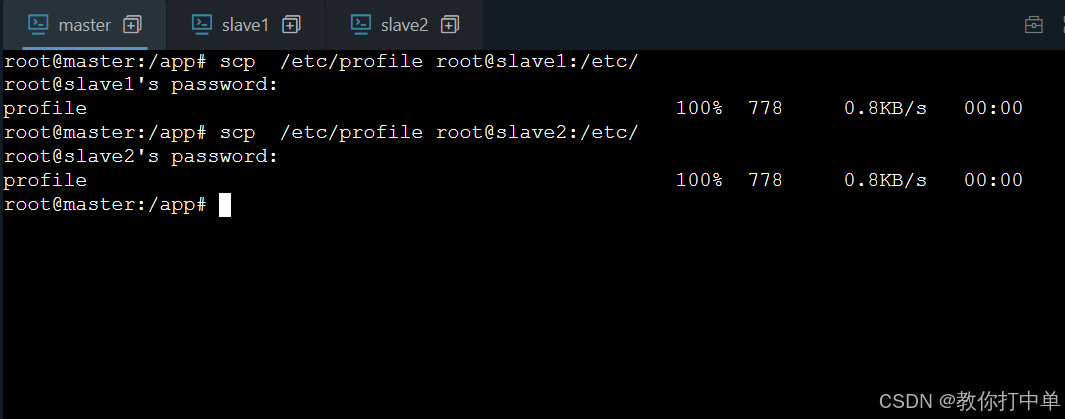
在 master 上将配置文件发送到从节点:
scp /etc/profile root@slave1:/etc/
scp /etc/profile root@slave2:/etc/
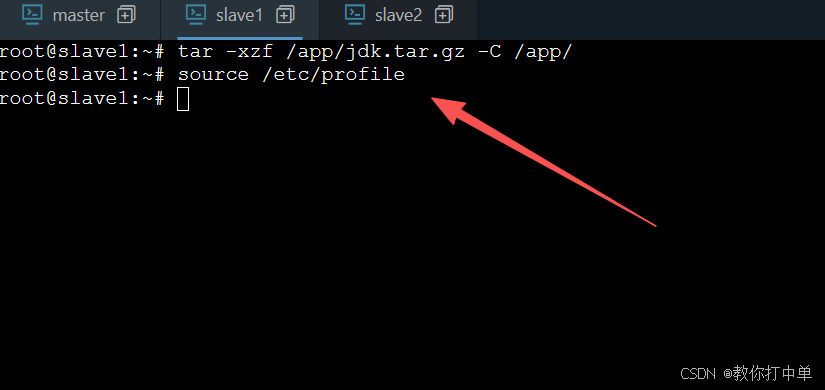
在 slave1 和 slave2 上使配置生效:
source /etc/profile
三、安装与配置 Hadoop
3.1 解压 Hadoop
在 master 上将 Hadoop 安装包解压到 /app 目录,并重命名文件夹以简化后续路径:
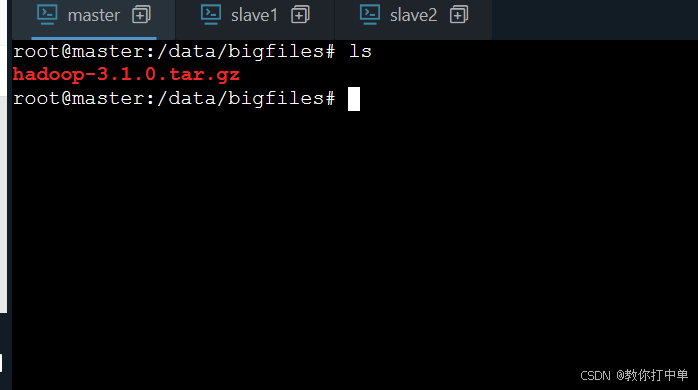
tar -zxvf hadoop-3.1.0.tar.gz -C /app
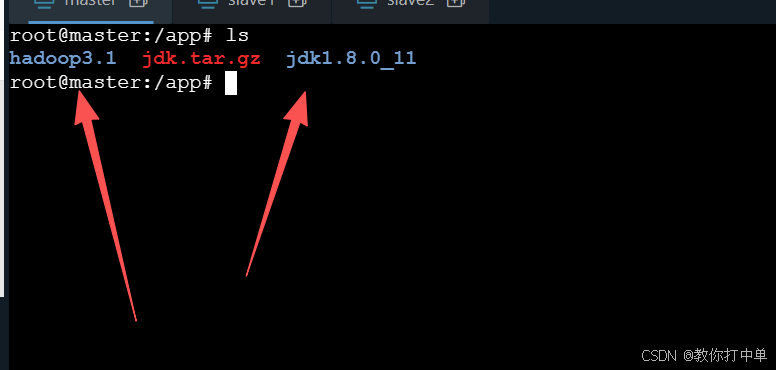
cd /app
mv hadoop-3.1.0/ hadoop3.1
3.2 修改 Hadoop 配置文件
Hadoop 的配置文件位于 /app/hadoop3.1/etc/hadoop/ 目录下,需要依次修改以下 6 个文件:
| 配置文件 | 作用 |
|---|---|
| hadoop-env.sh | 指定 Hadoop 运行所需的 JDK 路径 |
| yarn-env.sh | 指定 YARN 运行所需的 JDK 路径 |
| core-site.xml | 配置 HDFS 的默认文件系统地址和临时目录 |
| hdfs-site.xml | 配置 NameNode 和 DataNode 的存储路径及副本数 |
| mapred-site.xml | 指定 MapReduce 使用 YARN 框架 |
| yarn-site.xml | 配置 ResourceManager 地址和 Shuffle 服务 |
进入配置文件目录:
cd /app/hadoop3.1/etc/hadoop/
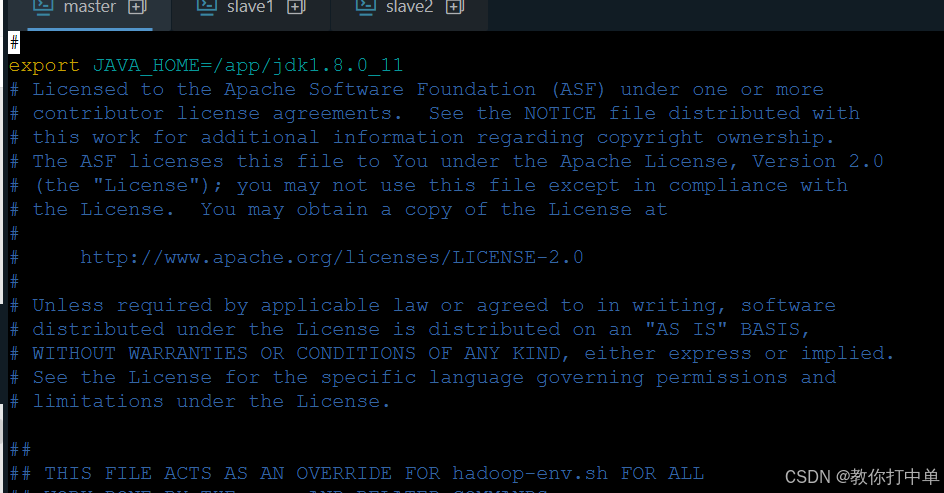
① hadoop-env.sh
vim hadoop-env.sh
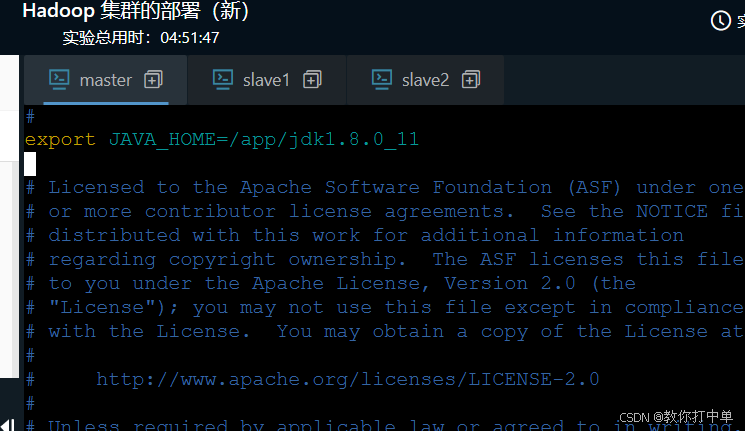
添加 JDK 路径:
export JAVA_HOME=/app/jdk1.8.0_11
② yarn-env.sh
vim yarn-env.sh
同样添加 JDK 路径:
export JAVA_HOME=/app/jdk1.8.0_11
③ core-site.xml
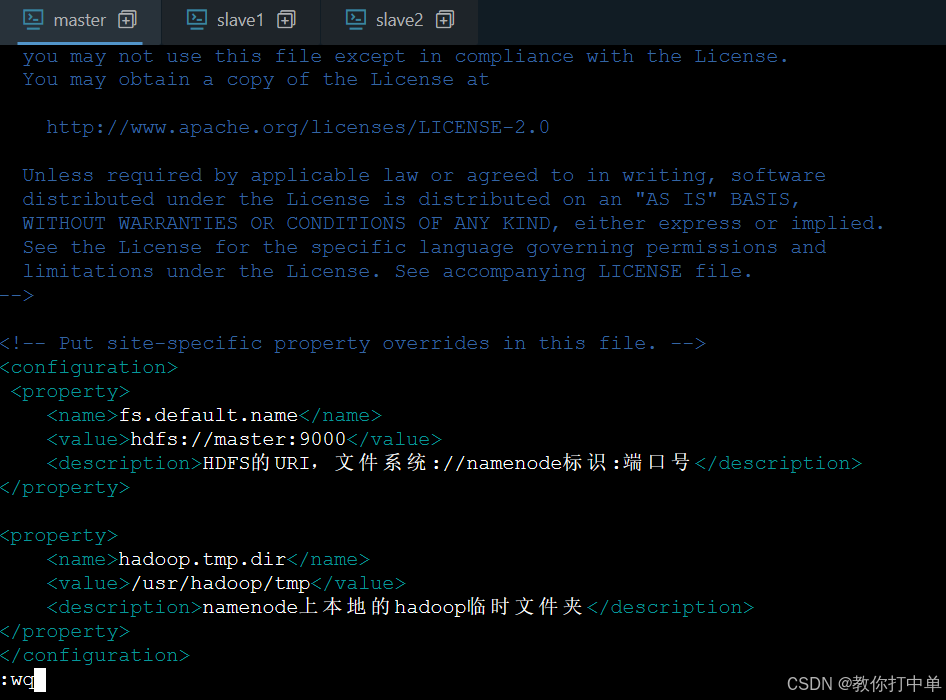
vim core-site.xml
在 <configuration> 标签内添加以下内容:
<configuration>
 <property>
    <name>fs.default.name</name>
    <value>hdfs://master:9000</value>
    <description>HDFS的URI,文件系统://namenode标识:端口号</description>
</property>

<property>
    <name>hadoop.tmp.dir</name>
    <value>/usr/hadoop/tmp</value>
    <description>namenode上本地的hadoop临时文件夹</description>
</property>
</configuration>
④ hdfs-site.xml
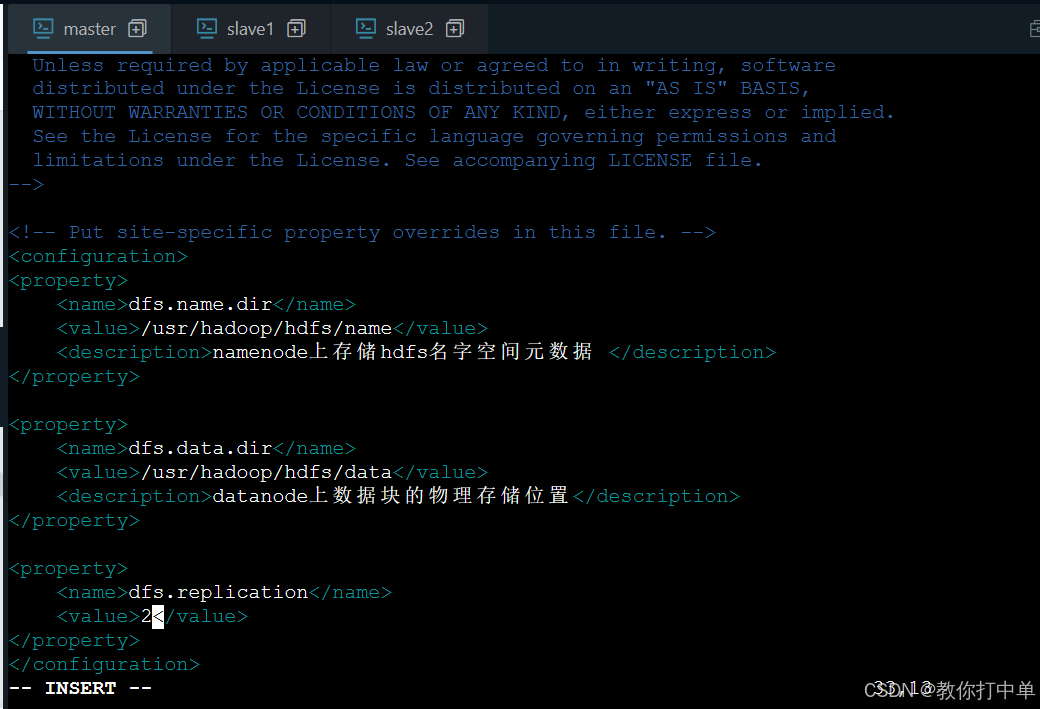
vim hdfs-site.xml
配置 NameNode 元数据路径、DataNode 数据存储路径,以及副本数(设为 2,与从节点数量一致):
<configuration>
<property>
    <name>dfs.name.dir</name>
    <value>/usr/hadoop/hdfs/name</value>
    <description>namenode上存储hdfs名字空间元数据</description>
</property>

<property>
    <name>dfs.data.dir</name>
    <value>/usr/hadoop/hdfs/data</value>
    <description>datanode上数据块的物理存储位置</description>
</property>

<property>
    <name>dfs.replication</name>
    <value>2</value>
</property>
</configuration>
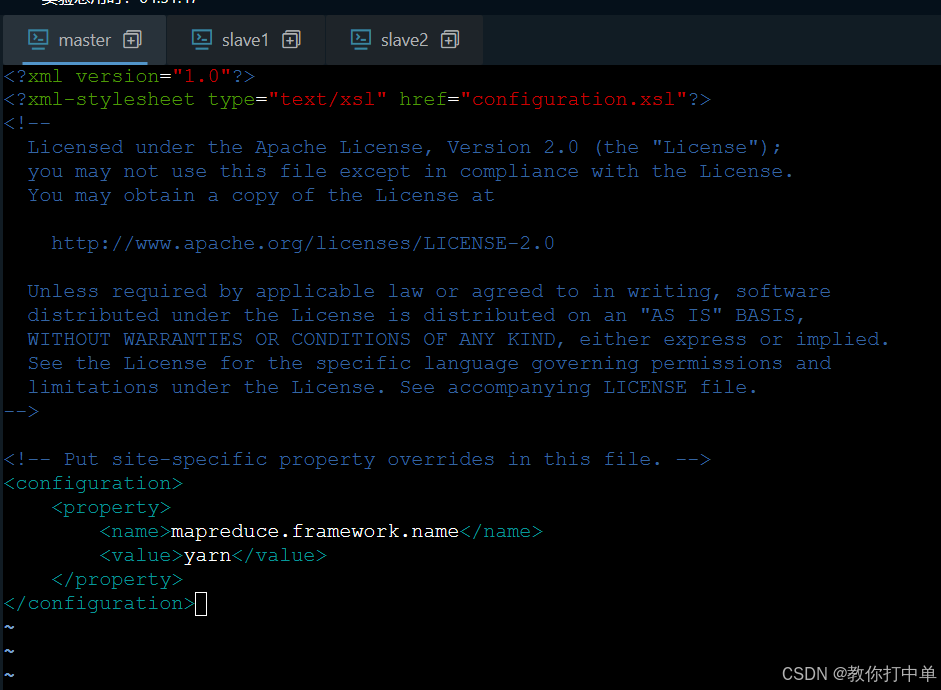
⑤ mapred-site.xml
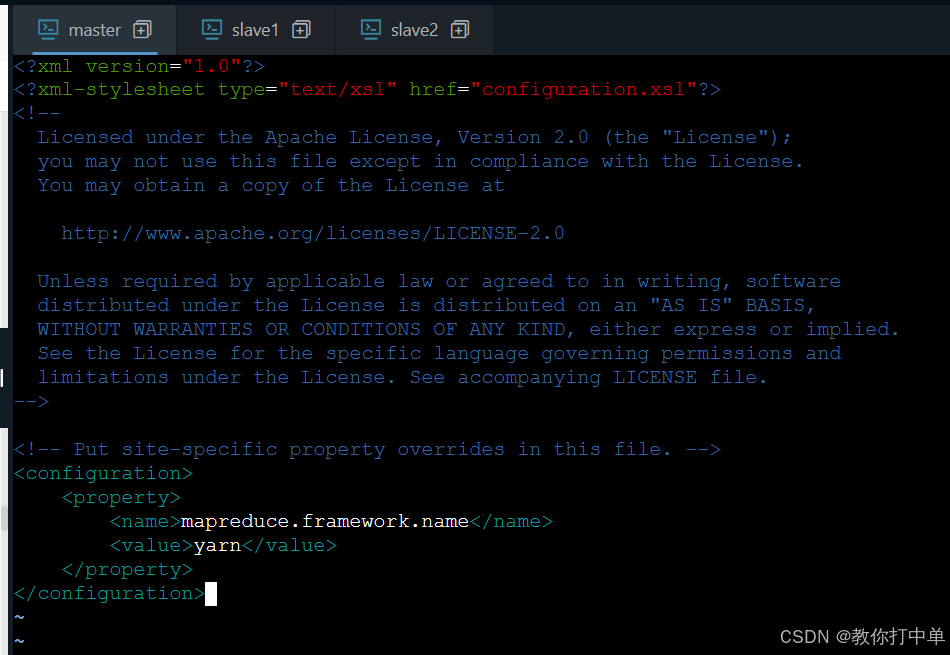
vim mapred-site.xml
指定 MapReduce 作业运行在 YARN 框架之上:
<configuration>
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
</configuration>
⑥ yarn-site.xml
vim yarn-site.xml
指定 ResourceManager 所在主机和 NodeManager 的 Shuffle 服务:
<configuration>
<property>
            <name>yarn.resourcemanager.hostname</name>
            <value>master</value>
</property>
<property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
</property>
</configuration>
⑦ workers 文件
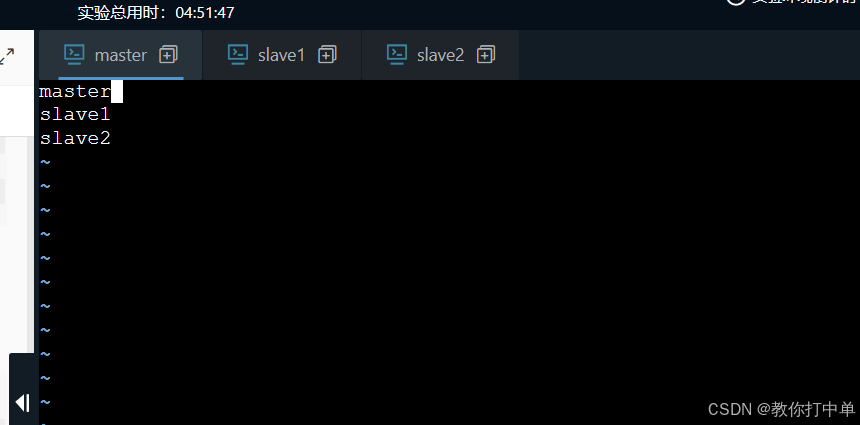
编辑 workers 文件,写入所有从节点的主机名(每行一个):
vim workers
内容如下:
slave1
slave2
3.3 创建数据存储目录
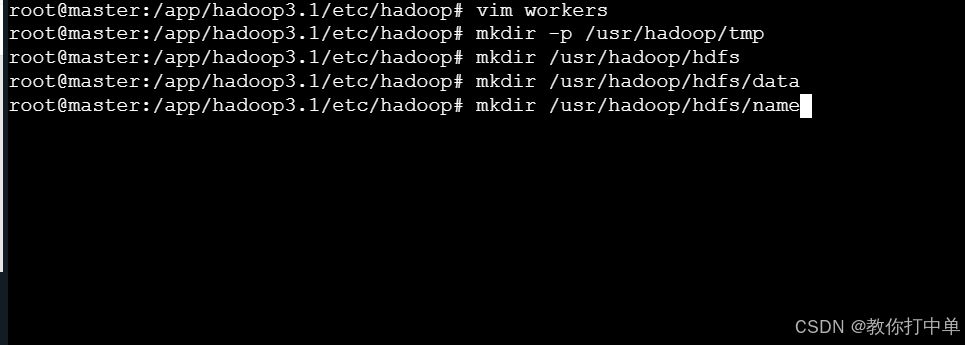
在 三台机器 上创建 Hadoop 运行所需的临时目录和 HDFS 数据目录:
mkdir -p /usr/hadoop/tmp
mkdir -p /usr/hadoop/hdfs/data
mkdir -p /usr/hadoop/hdfs/name
3.4 配置 Hadoop 环境变量
编辑 /etc/profile,在文件末尾追加:
# Hadoop Environment
export HADOOP_HOME=/app/hadoop3.1
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
使配置生效:
source /etc/profile
四、分发 Hadoop 并配置启动脚本
4.1 修改启动脚本的用户配置
由于使用 root 用户操作,需要在启动脚本中显式指定运行用户,否则 Hadoop 会拒绝启动。
进入 /app/hadoop3.1/sbin 目录:
cd /app/hadoop3.1/sbin
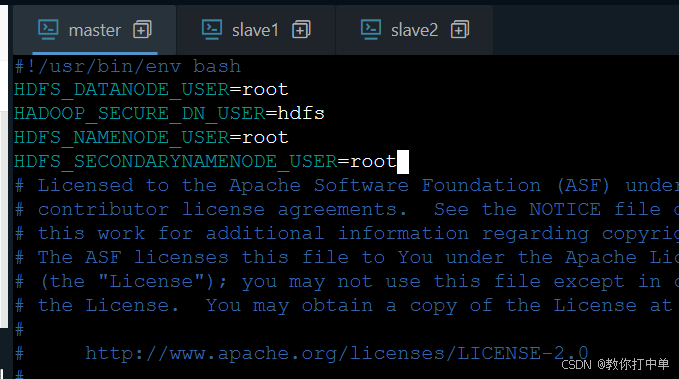
在 start-dfs.sh 和 stop-dfs.sh 文件 顶部 添加:
HDFS_DATANODE_USER=root
HADOOP_SECURE_DN_USER=hdfs
HDFS_NAMENODE_USER=root
HDFS_SECONDARYNAMENODE_USER=root
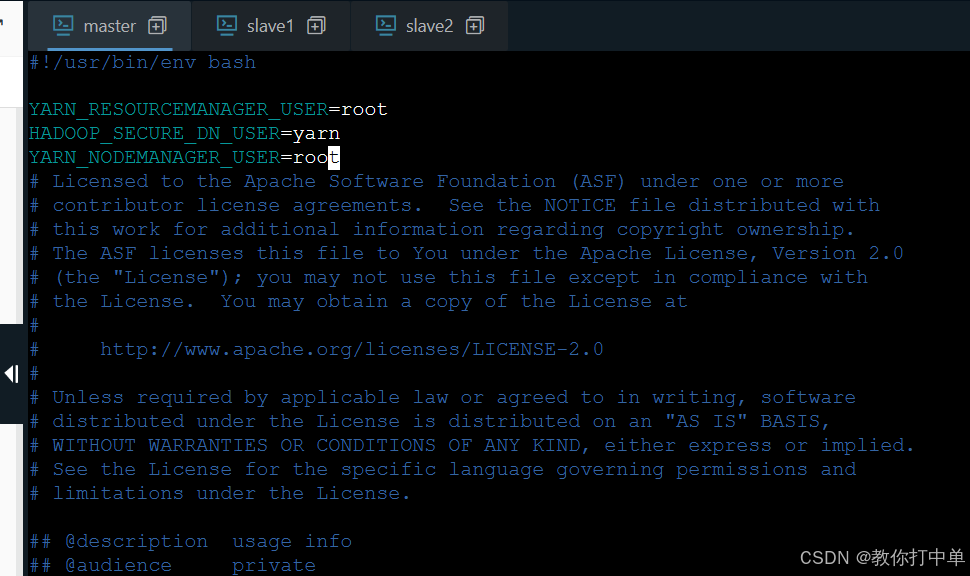
在 start-yarn.sh 和 stop-yarn.sh 文件 顶部 添加:
#!/usr/bin/env bash
YARN_RESOURCEMANAGER_USER=root
HADOOP_SECURE_DN_USER=yarn
YARN_NODEMANAGER_USER=root
4.2 将 Hadoop 分发到从节点
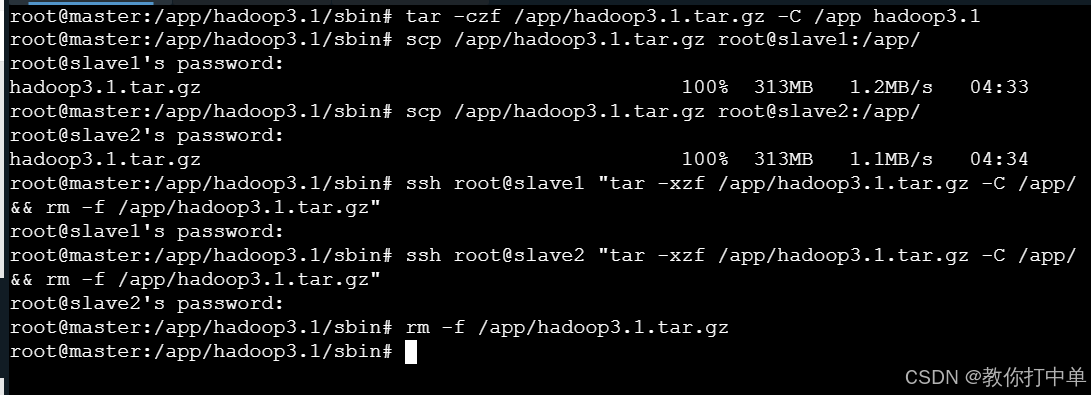
在 master 上打包并分发 Hadoop 到 slave1 和 slave2:
# 1. 在 master 上将 hadoop3.1 打包压缩
tar -czf /app/hadoop3.1.tar.gz -C /app hadoop3.1

# 2. 将压缩包快速传输到 slave1 和 slave2
scp /app/hadoop3.1.tar.gz root@slave1:/app/
scp /app/hadoop3.1.tar.gz root@slave2:/app/

# 3. 分别在 slave1 和 slave2 上解压(可直接使用 ssh 远程一键解压)
ssh root@slave1 "tar -xzf /app/hadoop3.1.tar.gz -C /app/ && rm -f /app/hadoop3.1.tar.gz"
ssh root@slave2 "tar -xzf /app/hadoop3.1.tar.gz -C /app/ && rm -f /app/hadoop3.1.tar.gz"

# 4. 最后清理 master 上的临时压缩包
rm -f /app/hadoop3.1.tar.gz
4.3 同步环境变量到从节点
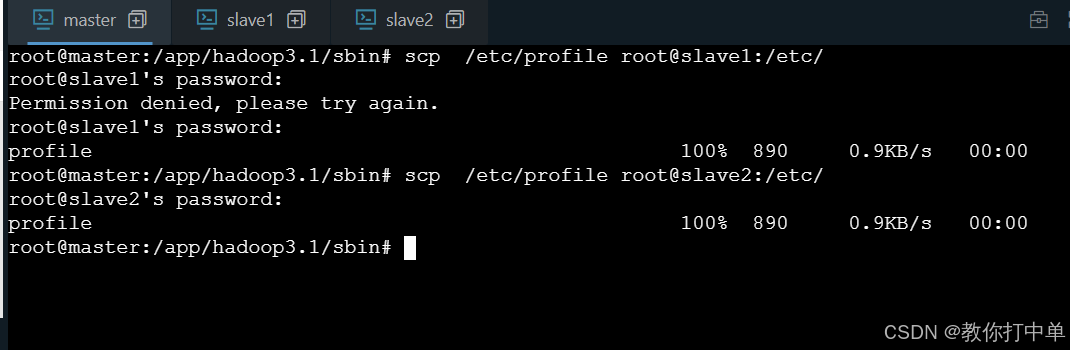
将更新后的 /etc/profile 发送到从节点,并使配置生效:
scp /etc/profile root@slave1:/etc/
scp /etc/profile root@slave2:/etc/
在每台从节点上执行:
source /etc/profile
五、启动与验证
至此,所有环境已配置完成!接下来进行格式化和启动验证。
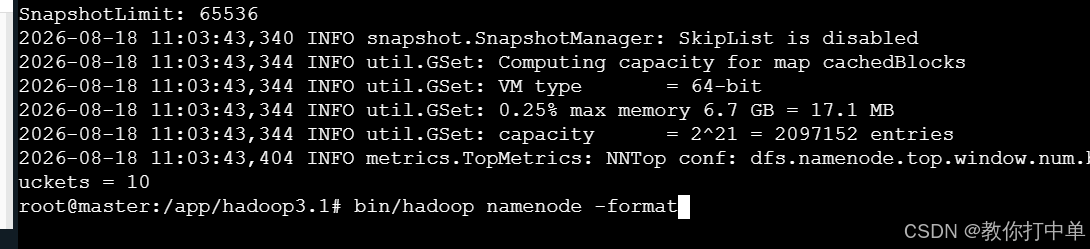
5.1 格式化 NameNode
⚠️ 注意:此命令仅在首次启动时执行,重复格式化会导致 DataNode 无法识别 NameNode。
cd /app/hadoop3.1
bin/hadoop namenode -format
5.2 启动集群并验证
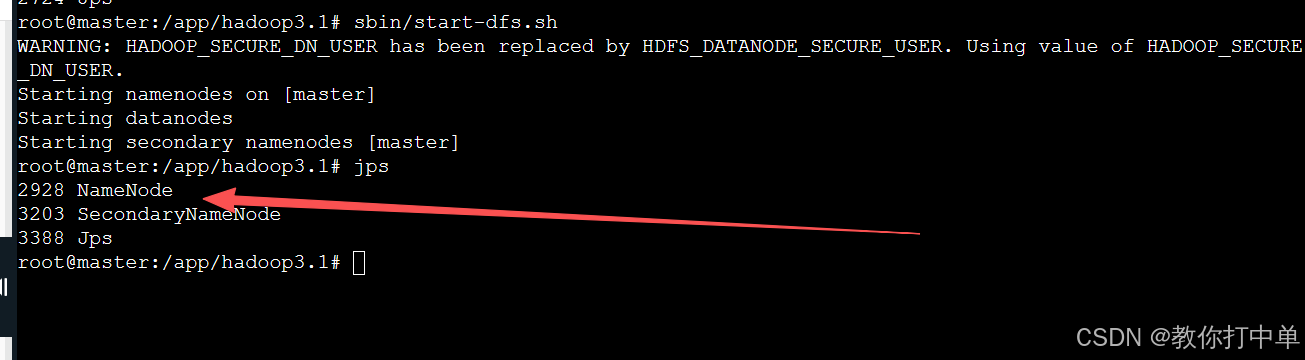
启动 HDFS 和 YARN:
start-dfs.sh
start-yarn.sh
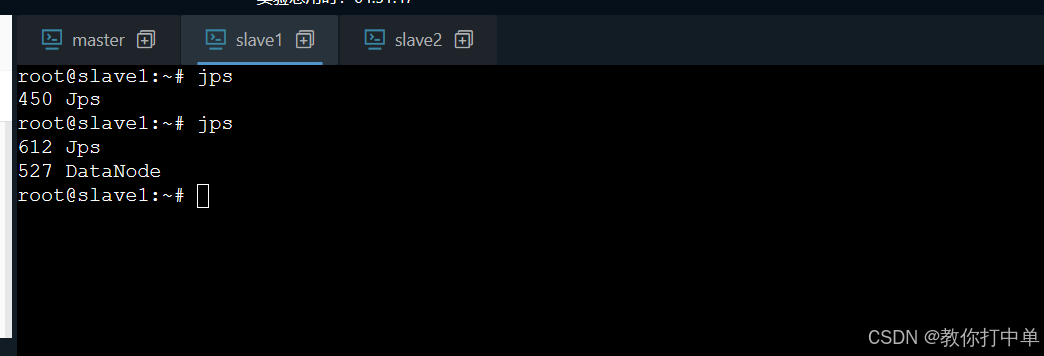
在各节点上使用 jps 命令查看运行的进程:
- master 应出现:NameNode、SecondaryNameNode、ResourceManager
- slave1 / slave2 应出现:DataNode、NodeManager
也可以通过浏览器访问 Hadoop Web UI 进一步确认:
- HDFS 管理界面:
http://master:9870 - YARN 管理界面:
http://master:8088
总结
本文完成了 Hadoop 3.1.0 完全分布式集群的搭建,整体流程可归纳为以下几个关键阶段:
- 网络互通:配置 hosts 映射 + SSH 免密登录
- JDK 部署:安装、配置环境变量,并分发到所有节点
- Hadoop 配置:修改 6 个核心配置文件,明确集群角色分工
- 分发与启动:将 Hadoop 和配置同步到从节点,格式化后启动集群
如果在搭建过程中遇到问题,建议优先检查以下几点:
- 各节点之间是否能通过主机名
ping通 - SSH 免密登录是否配置成功(
ssh slave1不需要输入密码) - JDK 和 Hadoop 的环境变量是否在所有节点上都已生效
- 防火墙是否已关闭或放行了相关端口
更多推荐



 6
 0
- 0


 已为社区贡献3条内容

所有评论(0)