
【大数据实战】Spark 2.2.2 完全分布式集群搭建
前言
在大数据生态体系中,Apache Spark 凭借其基于内存计算的高性能架构,已成为海量数据分布式处理的事实标准。
本文将手把手带大家在 Ubuntu 16.04 系统上搭建 Spark 2.2.2 完全分布式(Standalone)集群。整个集群由 3 台虚拟机组成(1 台 Master 节点 + 2 台 Slave 工作节点)。文章从最底层的网络环境配置、SSH 免密互信、JDK 部署,到 Spark 核心参数调优、集群一键同步分发、Web UI 监控验证,最后通过一个 1GB 真实大文件的 PySpark 词频统计(WordCount)案例 进行分布式计算实战测试,步骤详尽、逻辑严谨,适合大数据初学者跟着一步步动手实操!
一、集群环境与角色规划
在开始部署前,请先明确各节点的角色分配与规划:
| 节点角色 | 主机名 (Hostname) | 推荐 IP 示例 | 操作系统 | 运行核心进程 | 说明 |
|---|---|---|---|---|---|
| 主节点 (Master) | master | 172.16.55.97 | Ubuntu 16 | Master | 集群资源管理与作业调度 |
| 从节点 (Worker 1) | slave1 | 172.16.55.232 | Ubuntu 16 | Worker | 负责执行具体的计算任务 |
| 从节点 (Worker 2) | slave2 | 172.16.155.4 | Ubuntu 16 | Worker | 负责执行具体的计算任务 |
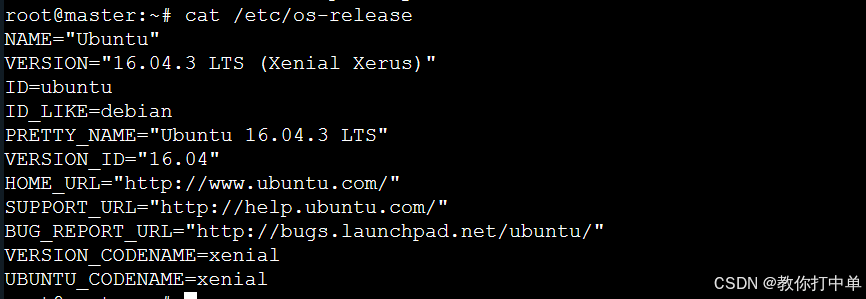
二、网络互通与 SSH 免密登录配置
2.1 查看并确认各节点 IP 地址
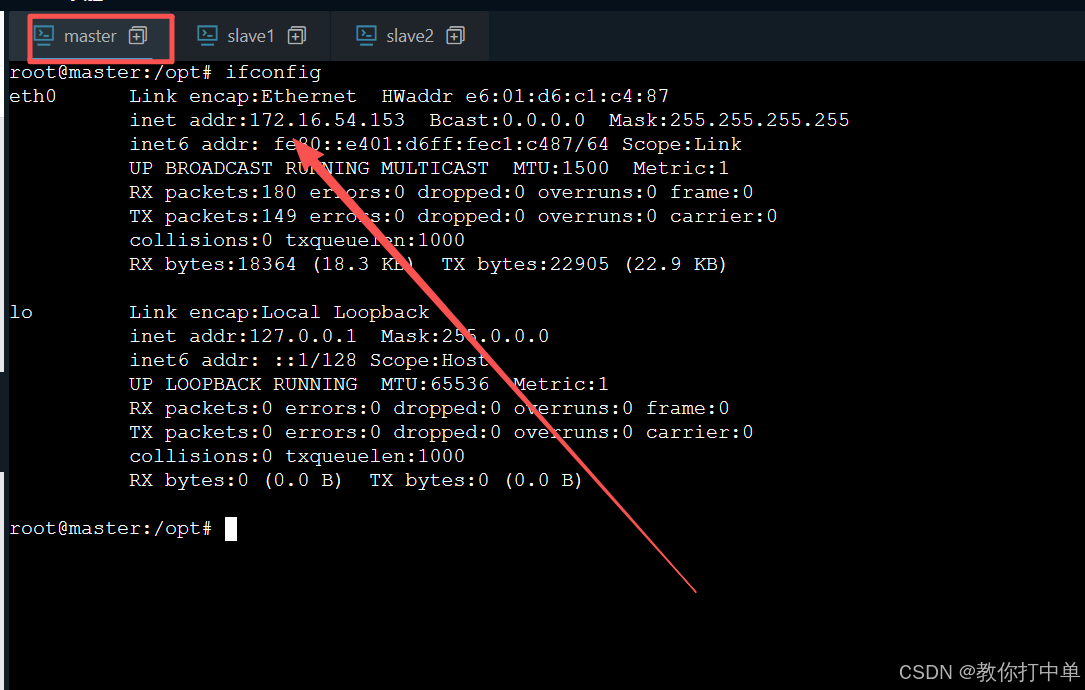
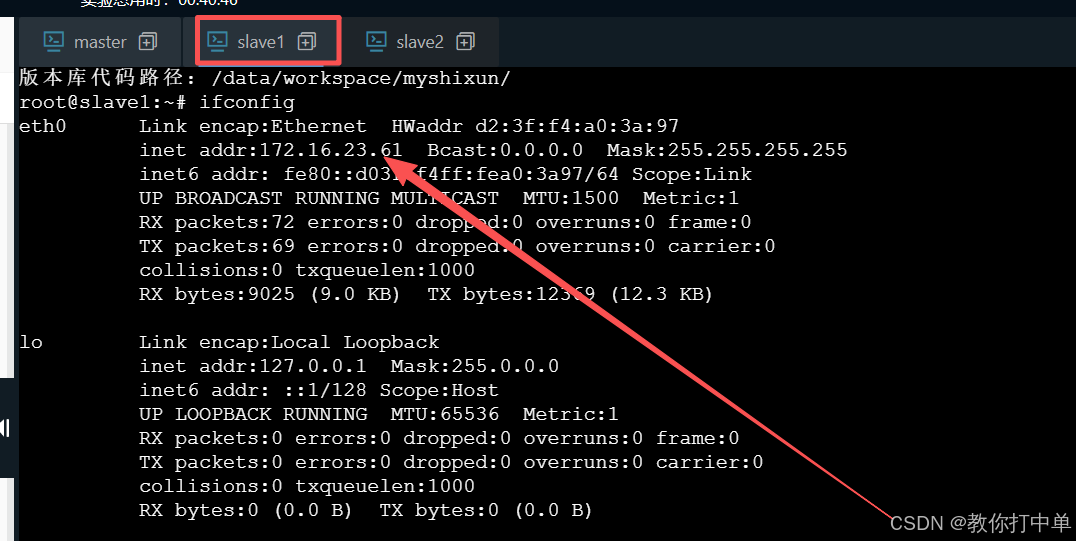
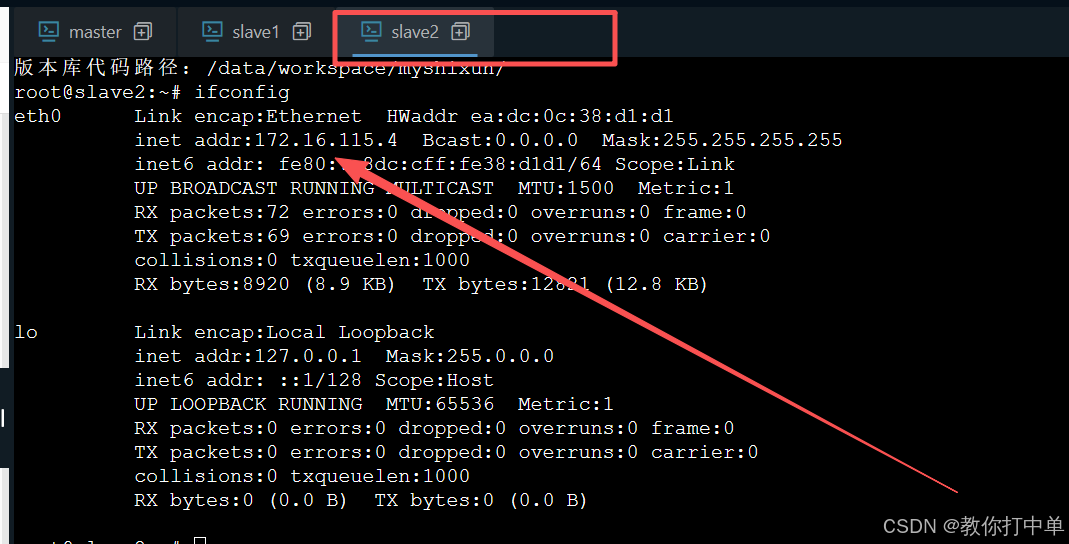
分别在三台虚拟机终端执行 ifconfig 命令,获取并记录当前节点的局域网 IP:
ifconfig
2.2 配置全局主机名与 IP 映射(三台机器均需执行)
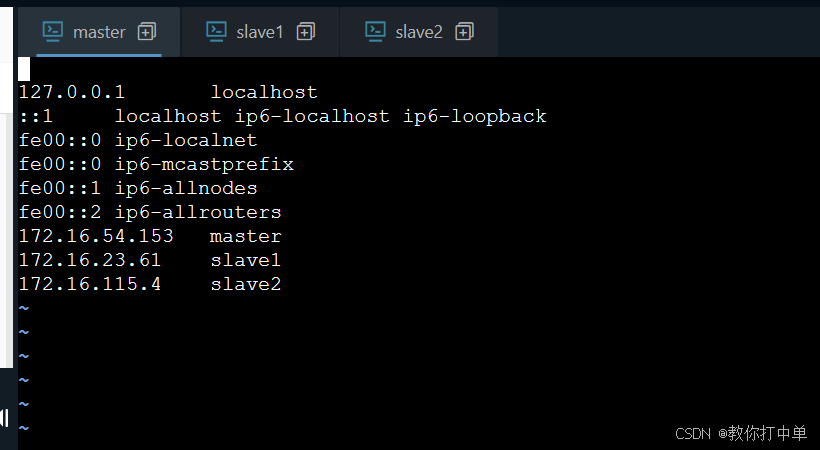
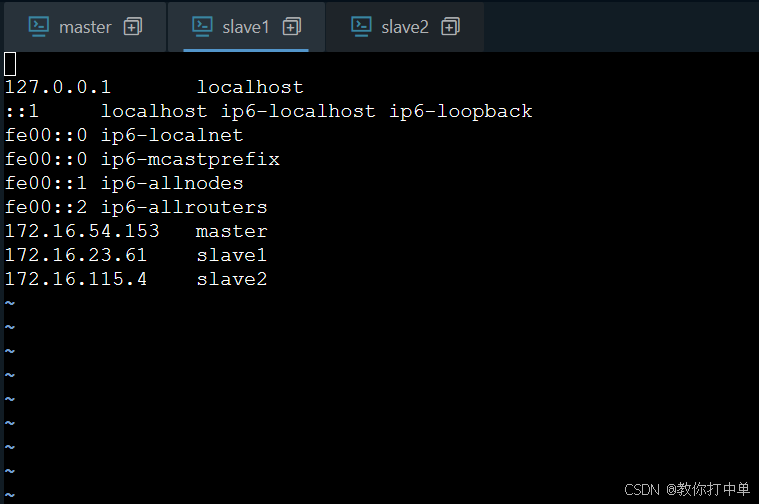
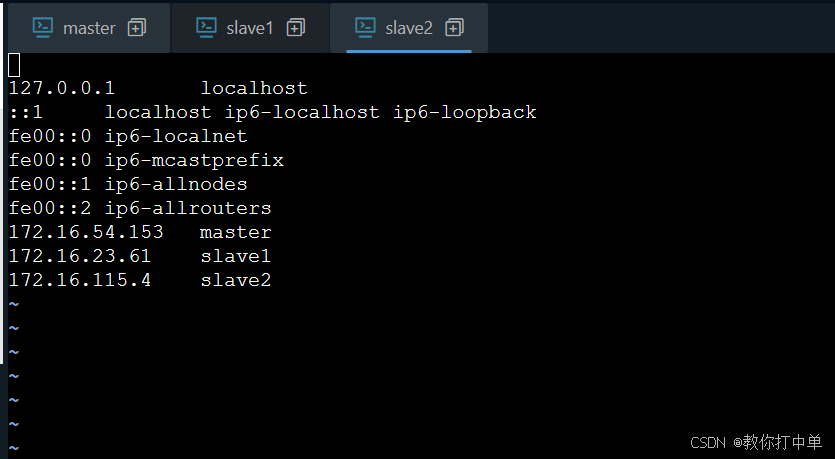
搭建完全分布式集群时,三台虚拟机需要通过主机名互相通信。在 每台机器 上编辑 /etc/hosts 文件,添加所有节点的映射关系:
vim /etc/hosts
在文件中添加如下映射内容(请替换为您机器的实际 IP 地址):
172.16.55.97 master
172.16.55.232 slave1
172.16.155.4 slave2
2.3 配置 Master 到所有节点的 SSH 免密登录(仅在 Master 上操作)
Spark 集群启动脚本(start-all.sh)需要 Master 节点通过 SSH 协议免密登录到各 Worker 节点拉起进程。
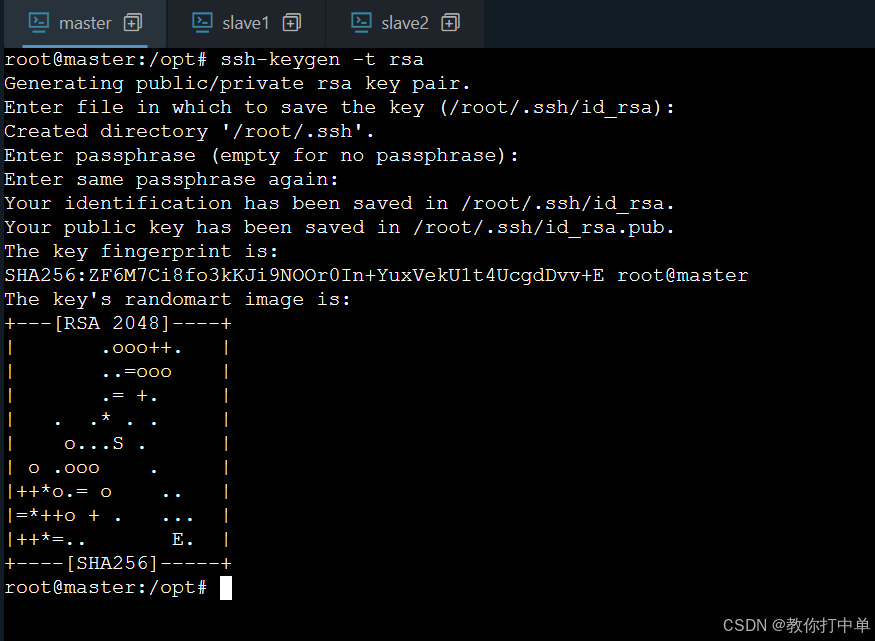
1. 在 master 节点生成 RSA 密钥对(遇到提示直接按三次回车):
ssh-keygen -t rsa
2. 将密钥依次拷贝给三台机器(过程中需要输入对应机器的 root 登录密码,Linux 下密码输入无回显):
ssh-copy-id master
ssh-copy-id slave1
ssh-copy-id slave2
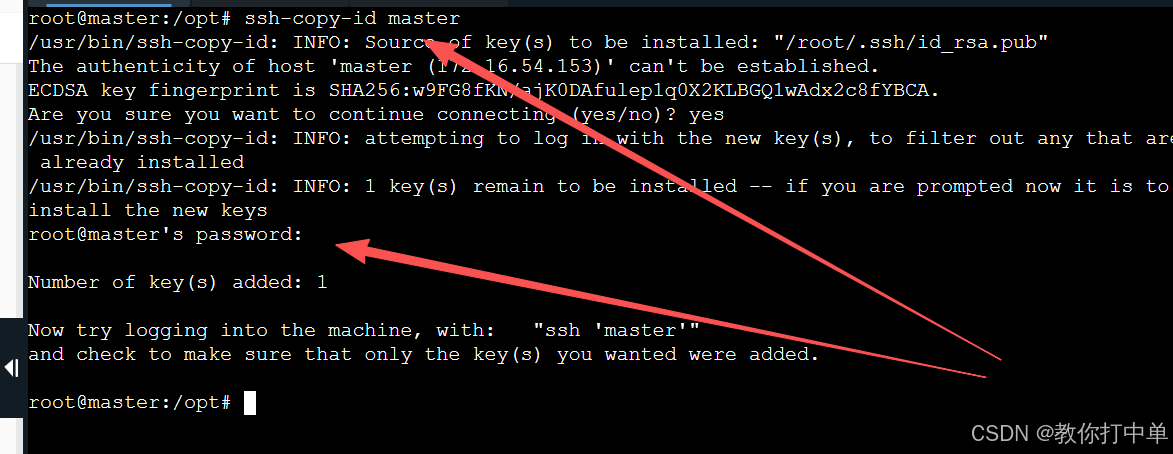
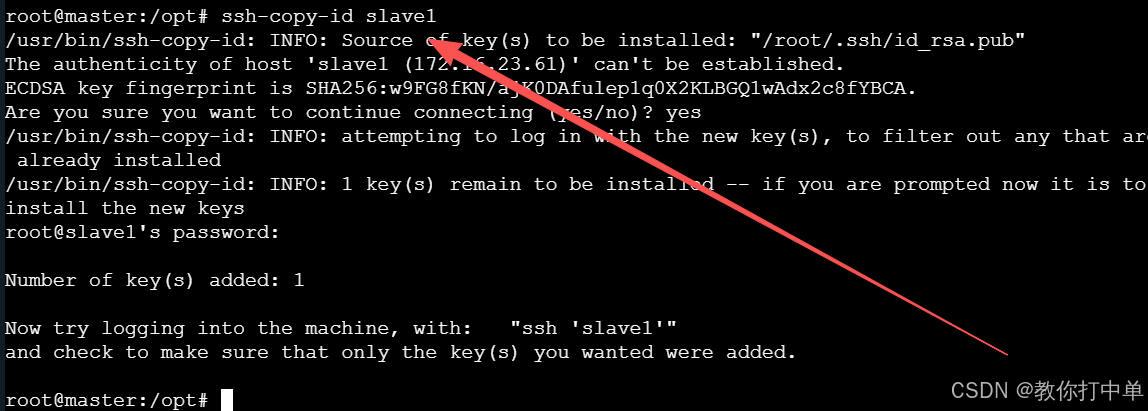
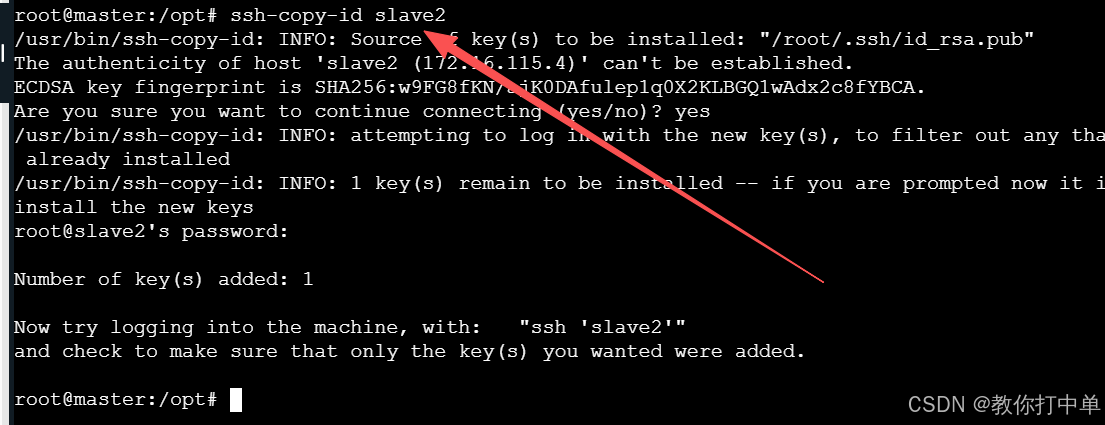
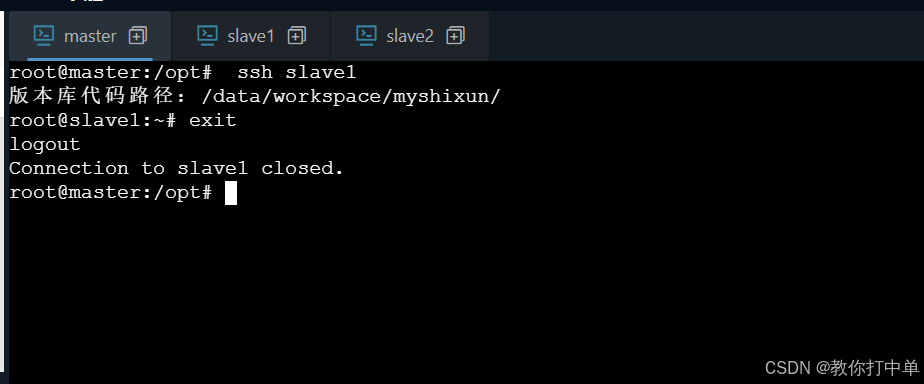
3. 免密验证测试:输入 ssh slave1,如果不需要输入密码直接登录成功,输入 exit 退出即可。
三、JDK 运行环境安装与配置
Spark 依赖 Java 运行时环境,此处以 JDK 1.8 为例。
3.1 解压并配置 JDK(先在 Master 上操作)
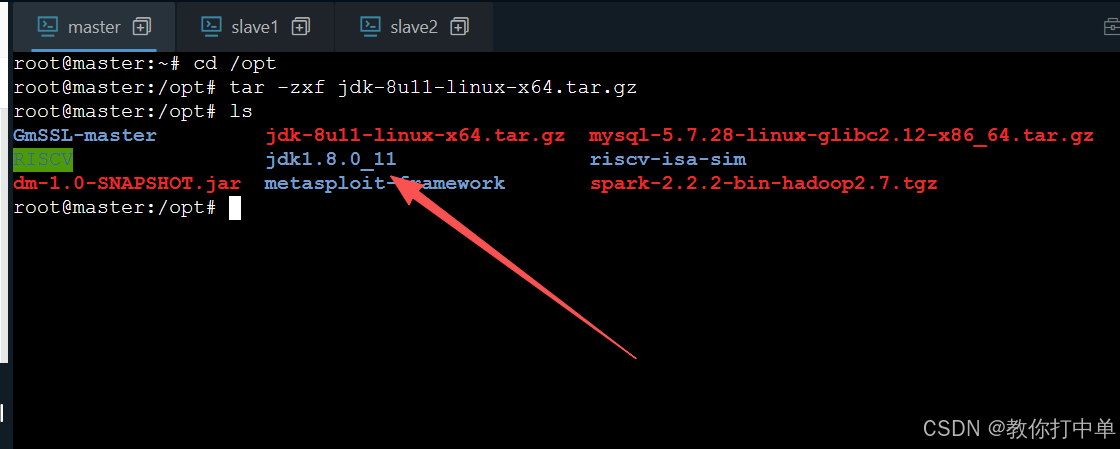
将 JDK 安装包上传至 /opt 目录并解压:
cd /opt
tar -zxvf jdk-8u11-linux-x64.tar.gz
3.2 配置系统环境变量
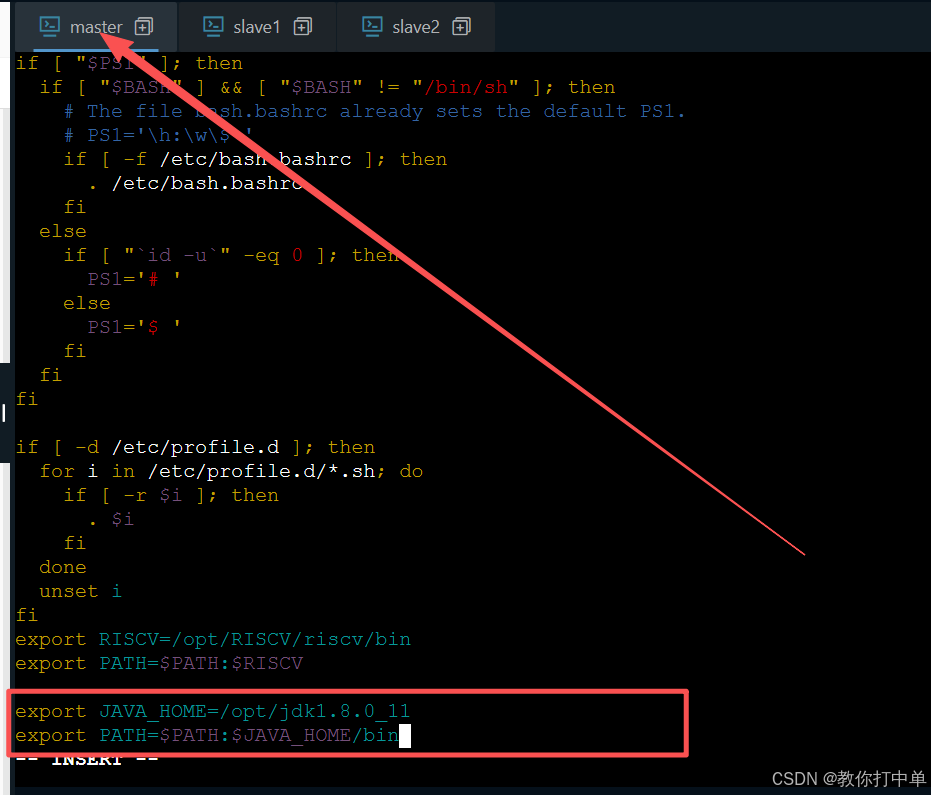
打开环境变量配置文件 vim /etc/profile,在文件最底部添加:
export JAVA_HOME=/opt/jdk1.8.0_11
export PATH=$PATH:$JAVA_HOME/bin
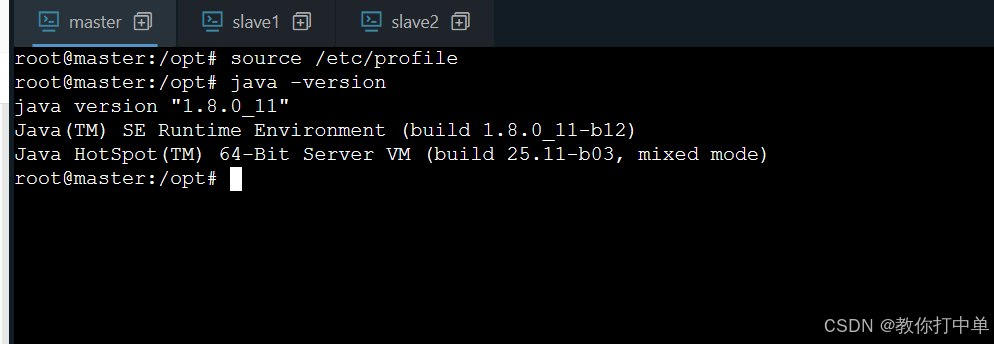
3.3 刷新环境变量并验证 Java
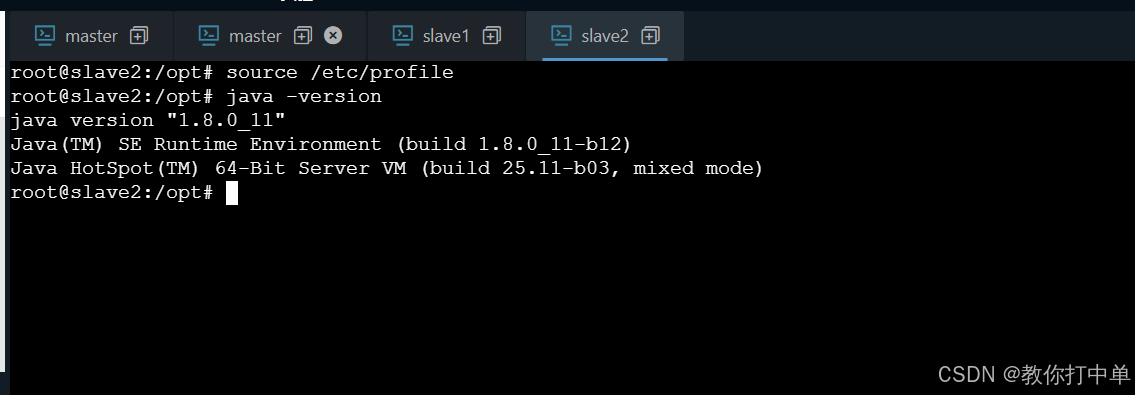
source /etc/profile
java -version
四、Spark 完全分布式集群部署
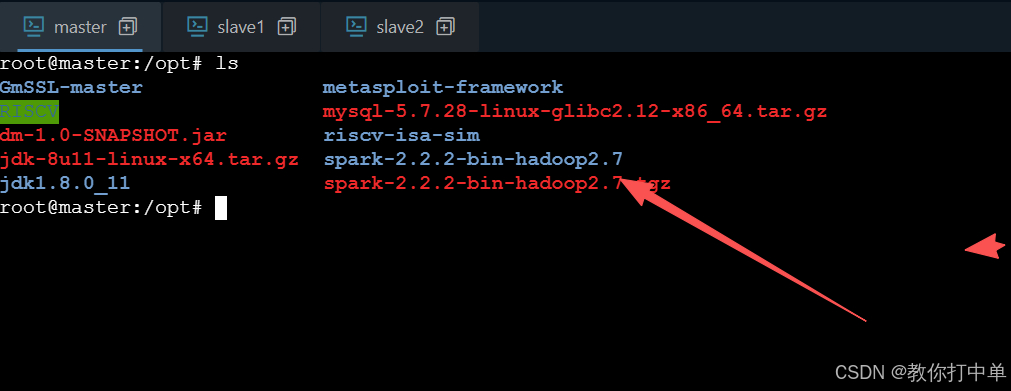
4.1 解压 Spark 安装包(在 Master 上操作)
cd /opt
tar -zxvf spark-2.2.2-bin-hadoop2.7.tgz
4.2 配置 spark-env.sh 核心文件
cd /opt/spark-2.2.2-bin-hadoop2.7/conf
cp spark-env.sh.template spark-env.sh
vi spark-env.sh
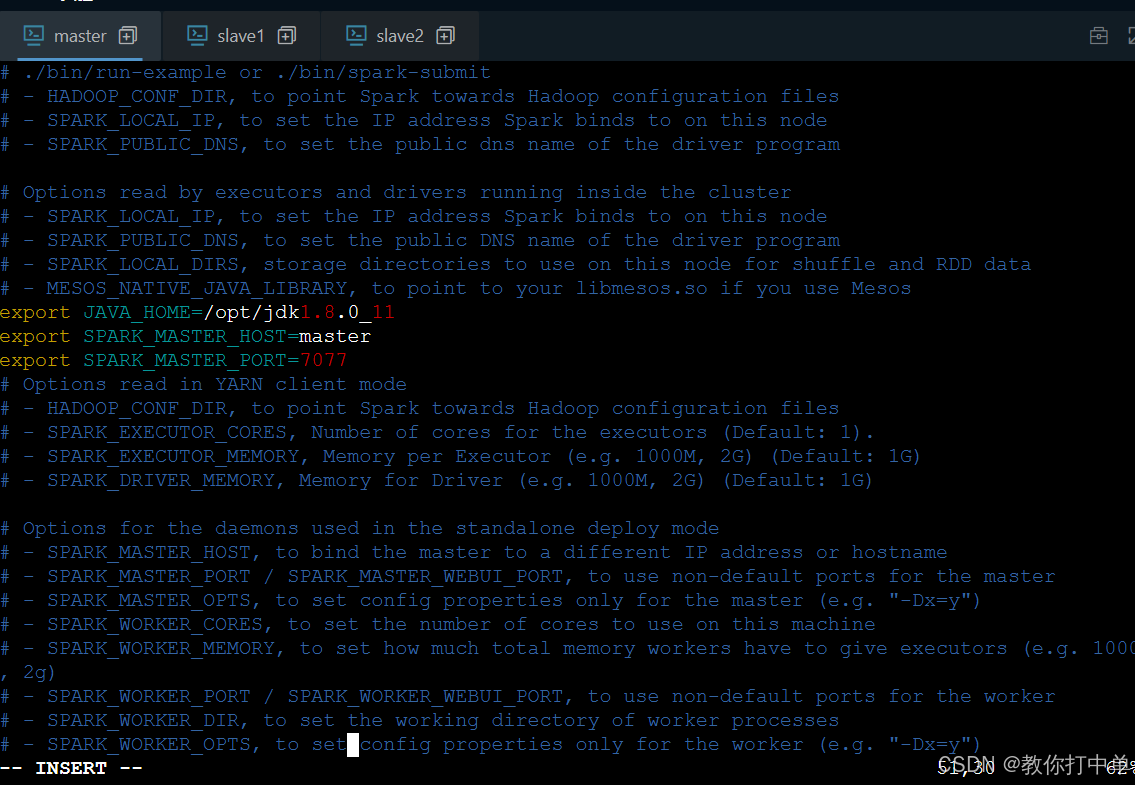
在文件末尾添加以下核心参数:
export JAVA_HOME=/opt/jdk1.8.0_11
export SPARK_MASTER_HOST=master
export SPARK_MASTER_PORT=7077
4.3 配置 slaves 从节点文件
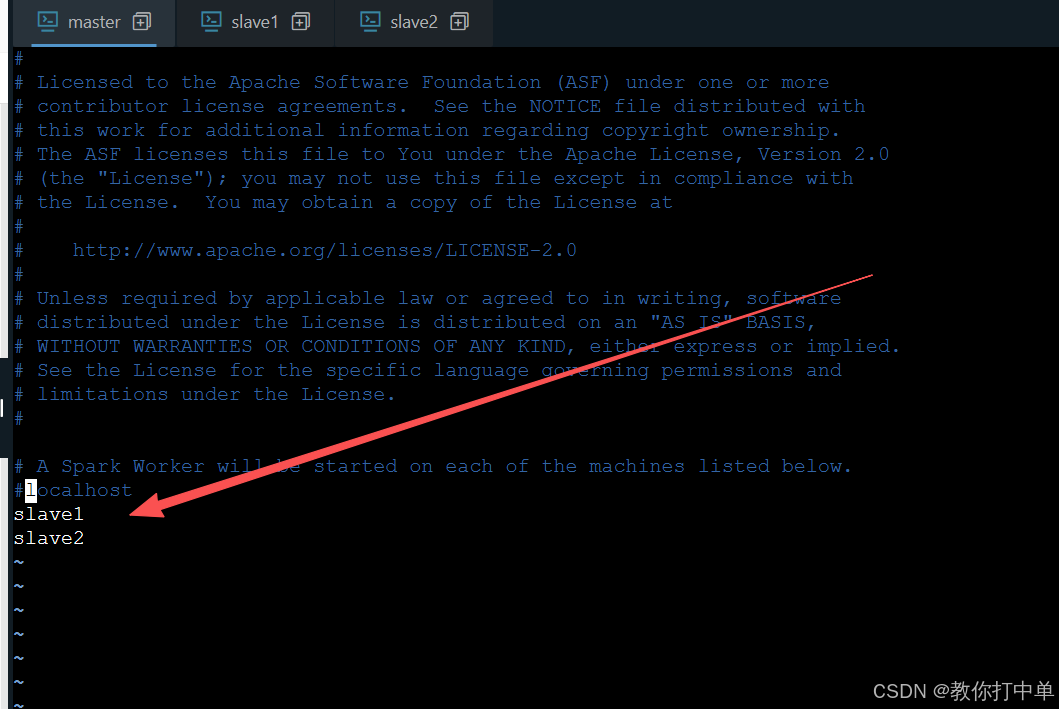
指定从节点 Worker 名称,删除默认的 localhost:
cp slaves.template slaves
vi slaves
写入两个从节点的名称:
slave1
slave2
4.4 一键同步:打包并分发文件至从节点
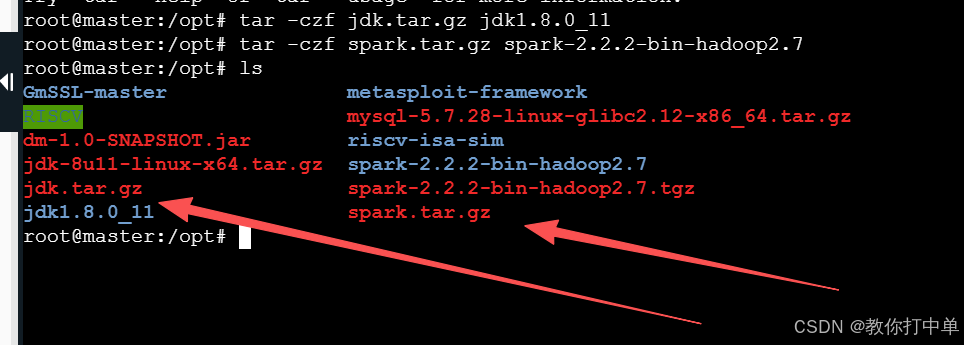
在 master 节点的终端直接运行以下同步命令,先压缩再分发,极大加快传输速度:
cd /opt

# 1. 打包 JDK 和 Spark
tar -czf jdk.tar.gz jdk1.8.0_11
tar -czf spark.tar.gz spark-2.2.2-bin-hadoop2.7

# 2. 传输压缩包
scp jdk.tar.gz spark.tar.gz root@slave1:/opt/
scp jdk.tar.gz spark.tar.gz root@slave2:/opt/

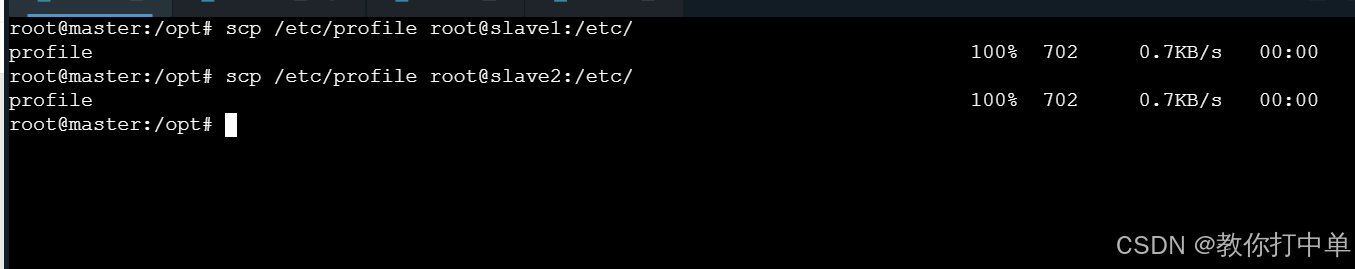
# 3. 传输环境变量配置
scp /etc/profile root@slave1:/etc/profile
scp /etc/profile root@slave2:/etc/profile
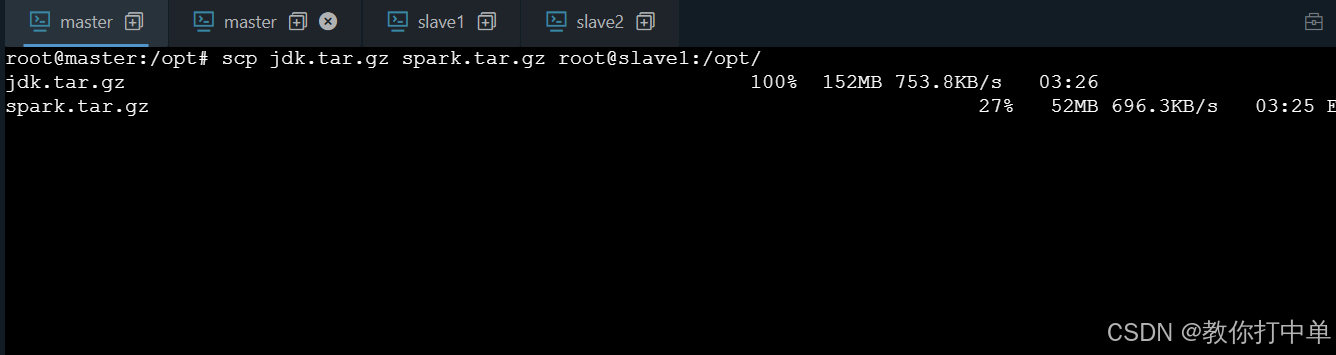
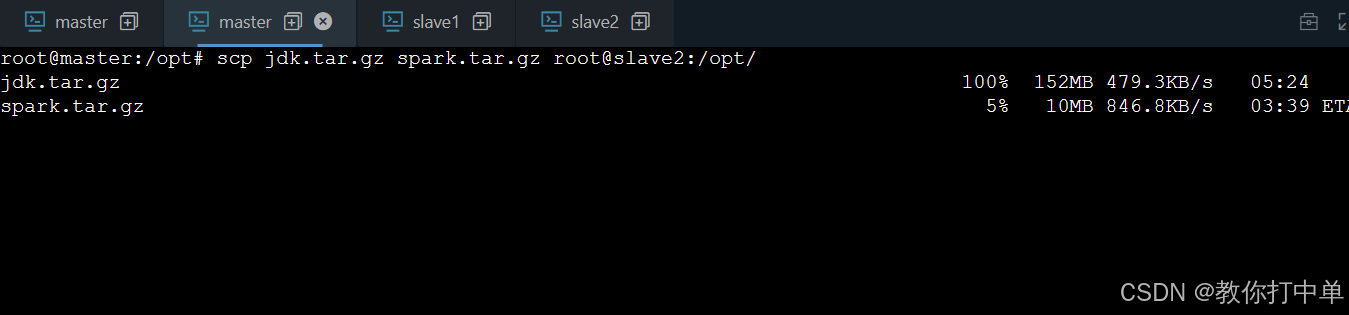
4.5 在从节点解压并生效环境变量(分别登录 slave1 和 slave2)
在 slave1 和 slave2 上分别执行:
cd /opt

# 解压安装包
tar -zxvf jdk.tar.gz
tar -zxvf spark.tar.gz

# 清理压缩包(可选,释放磁盘空间)
rm -f jdk.tar.gz spark.tar.gz

# 刷新环境变量
source /etc/profile
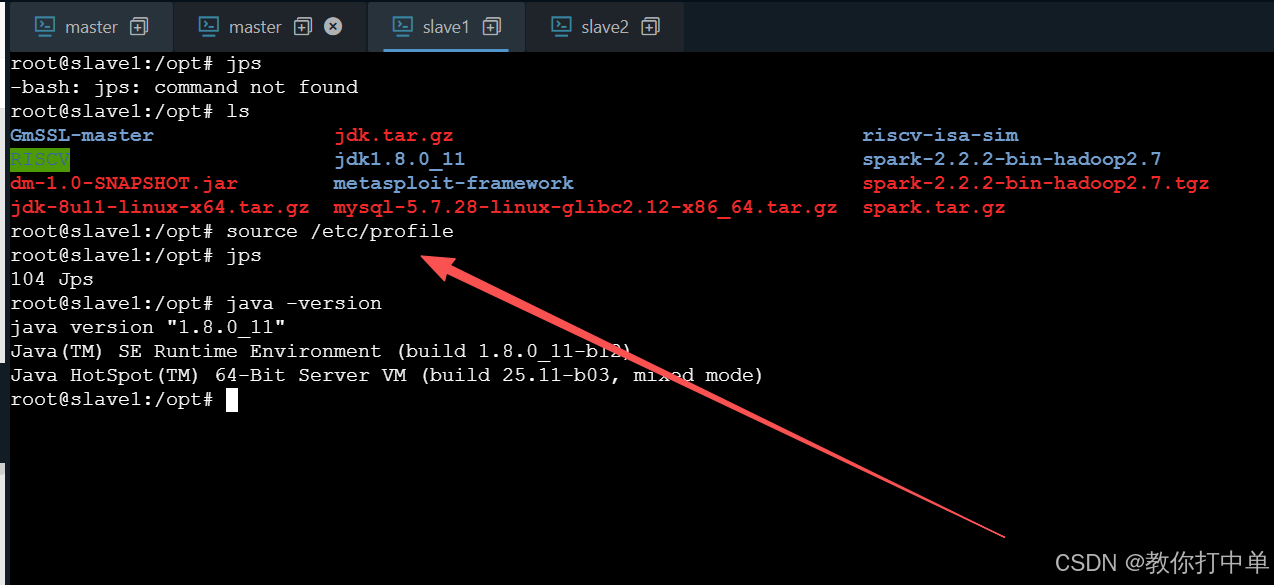
五、集群启动与 Web UI 监控验证
5.1 启动 Spark 集群
回到 master 节点,进入 Spark 目录启动集群:
cd /opt/spark-2.2.2-bin-hadoop2.7
./sbin/start-all.sh
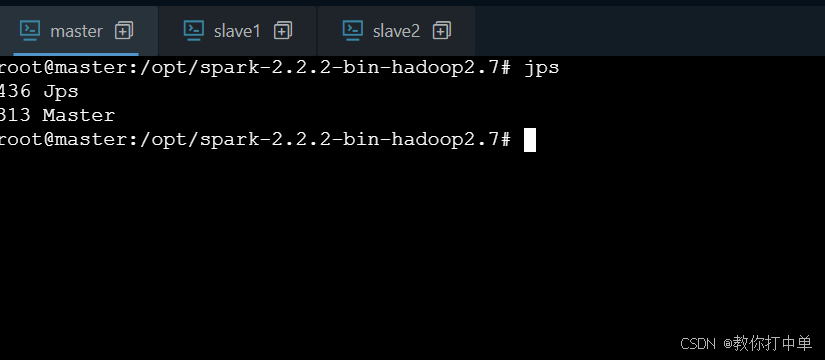
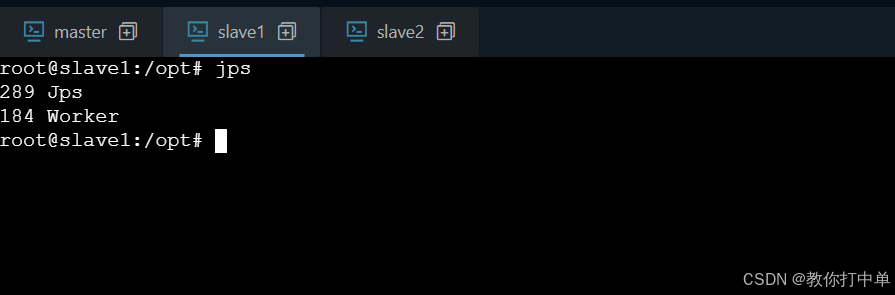
验证进程(JPS):
在 master 执行 jps 能看到 Master 进程,在 slave 节点能看到 Worker 进程,表示集群进程启动顺利完成!
5.2 访问 Spark Web UI 监控后台
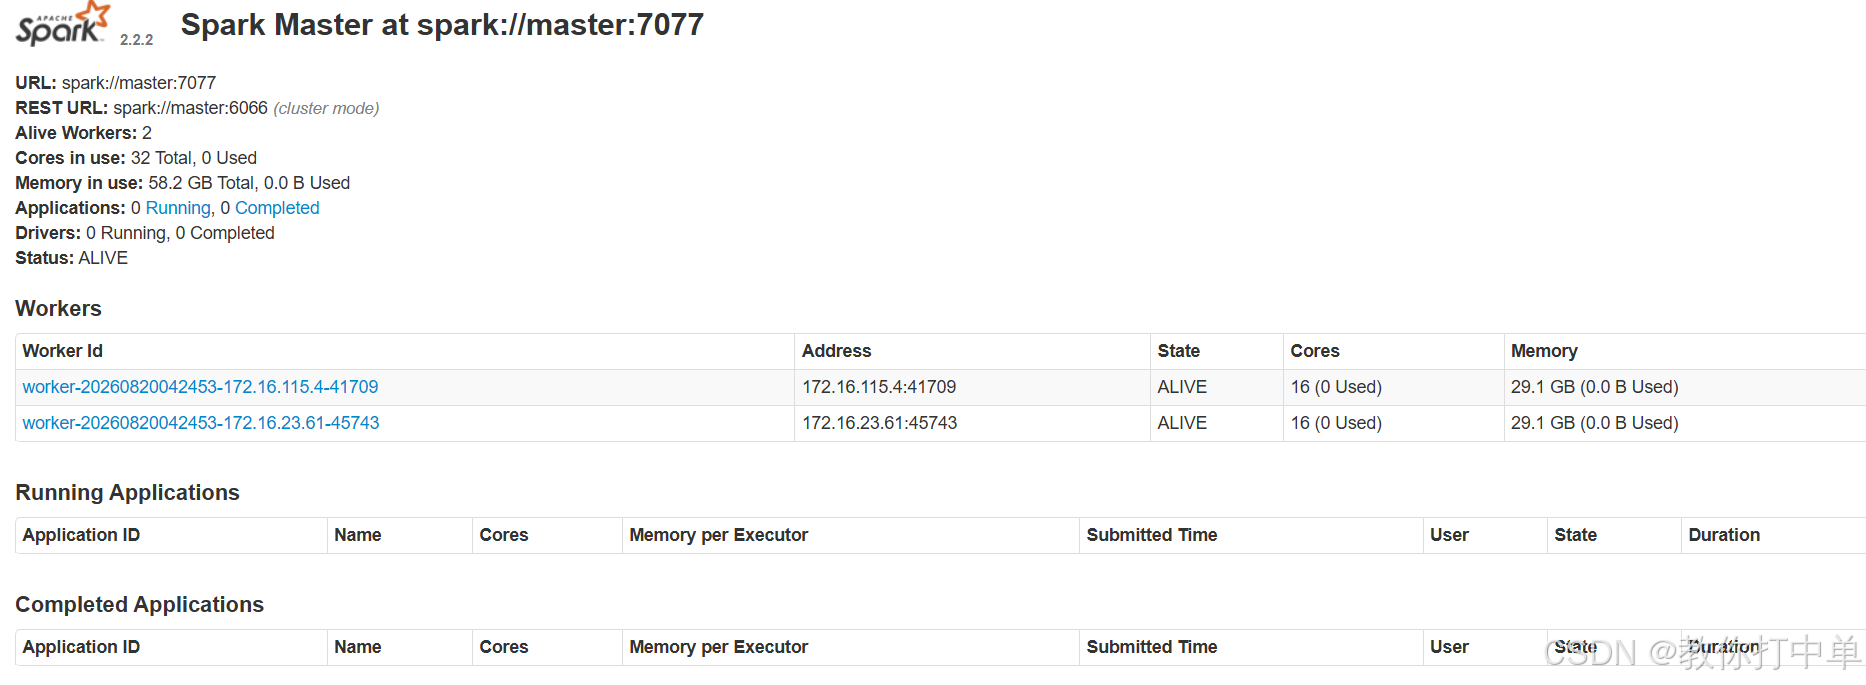
打开宿主机浏览器,输入 http://<master的IP>:8080。
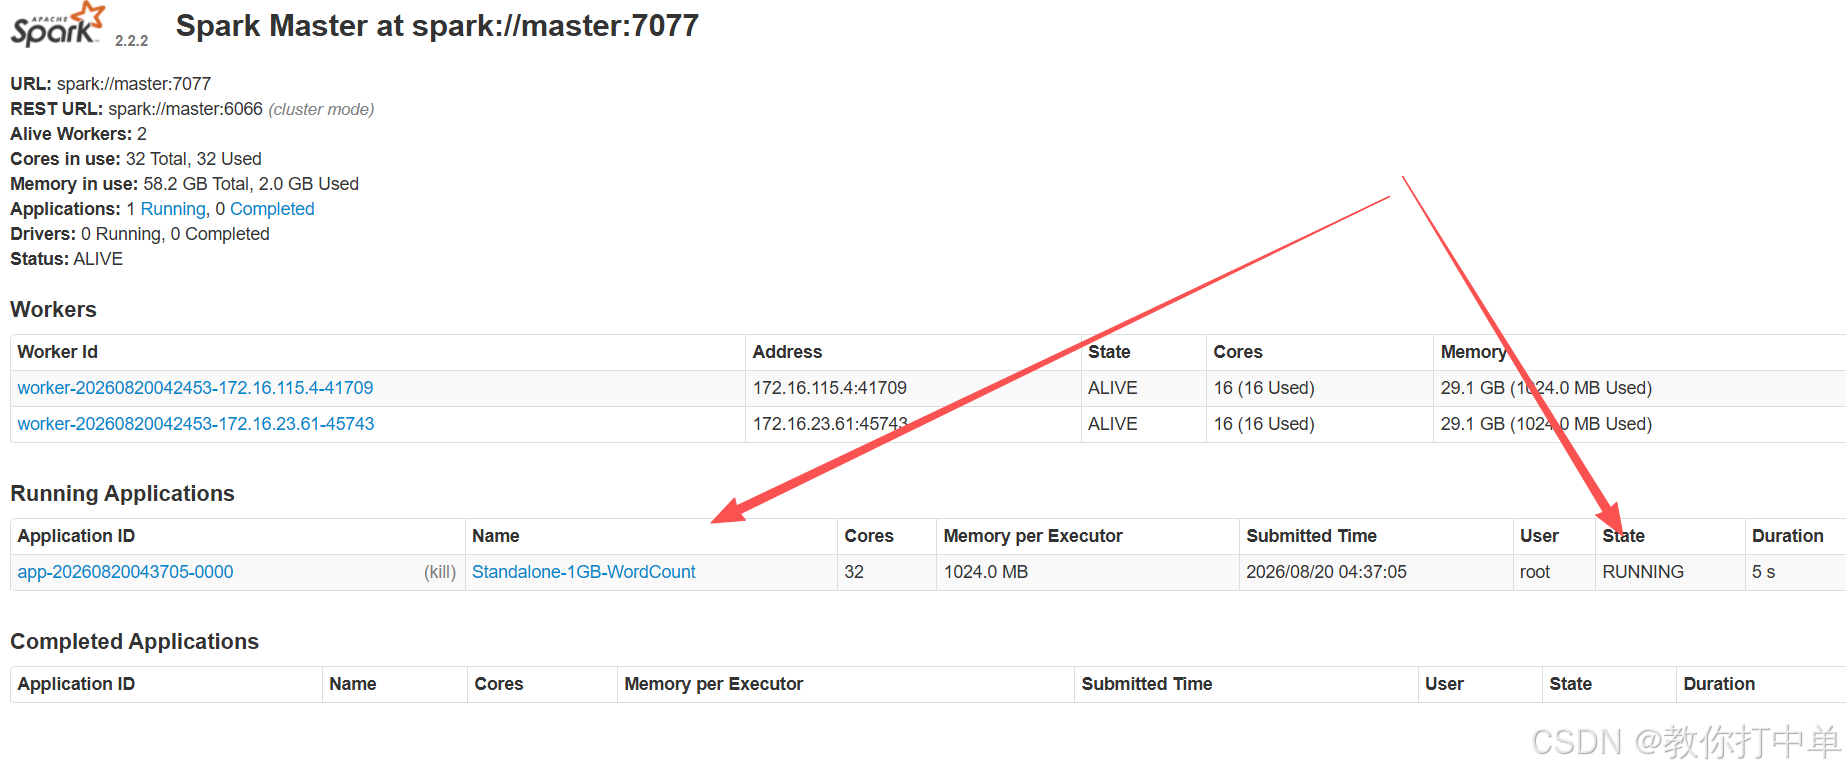
如果界面中 Workers (2) 显示正常且状态均为 ALIVE,说明你的完全分布式集群已经搭建成功!可以正式在上面运行 Spark 任务了!
六、实战案例:1GB 大数据量 WordCount 词频统计
为了检验集群的真实分布式计算能力,下面我们做一个 1GB 大文件词频统计 的分布式任务实战。
6.1 生成 1GB 测试数据(三台机器均需执行)
在每台机器的 /opt 目录下执行 Python 命令生成约 1GB 的测试文本:
python -c '
words = "spark hadoop java python master slave cluster data memory compute spark python cluster\n"
with open("/opt/data.txt", "w") as f:
    for _ in range(13000000): # 循环写入,生成约 1GB 文本
        f.write(words)
'
6.2 编写分布式 Python 任务脚本
在 master 的 /opt 目录下新建 Python 任务脚本 wordcount.py:
# -*- coding: utf-8 -*-
from pyspark.sql import SparkSession
import time

if __name__ == "__main__":
    # 1. 初始化 SparkSession
    spark = SparkSession.builder \
        .appName("Standalone-1GB-WordCount") \
        .getOrCreate()

    start_time = time.time()

    # 2. 读取本地数据 (注意 file:// 前缀)
    # Spark 会自动把这 1GB 文件切分为多个 Partition 分发给不同 Worker 节点并行处理
    lines = spark.read.text("file:///opt/data.txt").rdd.map(lambda r: r[0])

    # 3. 核心计算:切词 -> 组合 (word, 1) -> 按 key 聚合相加
    word_counts = lines.flatMap(lambda line: line.split(" ")) \
                       .map(lambda word: (word, 1)) \
                       .reduceByKey(lambda a, b: a + b)

    # 4. 触发计算并获取结果 (Action)
    results = word_counts.collect()

    # 5. 打印统计报表与计算耗时
    print("\n================ 📊 词频统计结果 ================")
    for (word, count) in results:
        print("%s : %d" % (word, count))
    print("==================================================")
    print("⏱️ 计算总耗时: %.2f 秒\n" % (time.time() - start_time))

    spark.stop()
6.3 提交作业至 Spark 集群
在 master 终端使用 spark-submit 提交任务到你的 Spark 集群(spark://master:7077):
/opt/spark-2.2.2-bin-hadoop2.7/bin/spark-submit \
  --master spark://master:7077 \
  /opt/wordcount.py
七、总结与避坑指南
- 防火墙状态:如果 Worker 无法注册到 Master,或者无法访问 8080 Web 界面,请先在三台节点上检查并关闭防火墙(
sudo ufw disable)。 - Hosts 映射别名:
/etc/hosts中请务必使用节点的局域网实际 IP 地址,不要映射到127.0.0.1,否则会导致集群节点间无法相互建立通信。 - Worker 内存分配:若虚拟机内存配置较低,可以在
spark-env.sh中添加SPARK_WORKER_MEMORY=1g限制单节点内存占用,防止作业执行时发生 OOM 内存溢出。
更多推荐



 3
 0
- 0


 已为社区贡献3条内容

所有评论(0)