


- @weixin_45556024


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
主要讲一下在Linux系统环境下(以ubantu22.04为例),如何用nginx部署前端Vue项目打包的dist静态资源。

戳链接下载:https://download.csdn.net/download/weixin_45556024/34913490或关注公众号【靠谱杨阅读人生】回复【行业】获取。整理不易,资源fu费,谢谢理解!国标:代码:1 import pandas as pd2 import pymysql3 """4 ------------------------------...
jpsall代码#!/bin/bashfor host in hadoop102 hadoop103 hadoop104doecho =============== $host ===============ssh $host jpsdone查看某个命令所在的路径which 【命令名称】whereis 用来查看一个命令或者文件所在的路径w...
jira7.12完整详细图文安装教程(Windows)
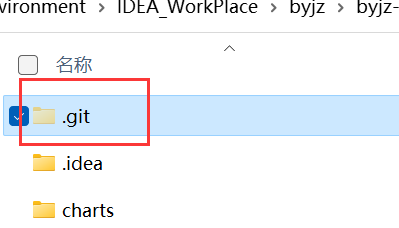
解决办法:修改缓存大小打开项目所在路径下的git目录找到config文件,用记事本打开编辑。添加如下内容并保存即可[http]postBuffer = 1048576000
2.特征工程2.1 数据集2.1.1 可用数据集Kaggle网址:https://www.kaggle.com/datasetsUCI数据集网址: http://archive.ics.uci.edu/ml/scikit-learn网址:http://scikit-learn.org/stable/datasets/index.html#datasets2.1.2 安装scikit...
代码在上次的基础上做了一点优化,之前对项目要的最终结果理解有些偏差:原始数据的那一列行业编码是存在三位数和四位数的,我上次理解的三位数就是分割成两位数进行查找,其实三位数的编码是由于第一位的0没有显示,所以例如311的编码其实应该是0311,所以代码进行了修改,对于三位数需要在开头的位置补一个0,成为四位数再进行查找。把三个方法的参数做了优化,获取json字符串的方法只需要一个参数(国标文...
进度今天完整地进行了行业维度的清洗分析,把行业代码根据国家标准清洗出格式为 “编码·门类·大类·中类·小类” 的数据格式过程1、先把国家标准编码转化为json数据2、根据原始数据编码逐层遍历json数据,补全缺失数据和问题数据。代码1 import pandas as pd2 import xlwt3 rank10=""#A4 rank11="" ...
1 package com.lykion;23 import java.sql.Connection;4 import java.sql.PreparedStatement;5 import java.sql.ResultSet;6 import java.sql.SQLException;78 public class DBUtil {910 ...
wordpress搭建个人博客(阿里云服务器、宝塔面板、Elementor)