


- @qq_42836388


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
使用Cookie时导致的问题之基础拓展--setDomain、setPath和localhost与127.0.0.1的区别
第一步:启动及关闭数据库服务net stop mysqlnet start mysql第二步:找到数据库mysql位置并登陆进入找到位置:C:\phpStudy\PHPTutorial\MySQL\bin登陆:mysql –u 用户名 [–h主机名或者IP地址] –p密码mysql -u root 127.0.0.1 root数据库一些命令行操作:1.查看数据库列表...
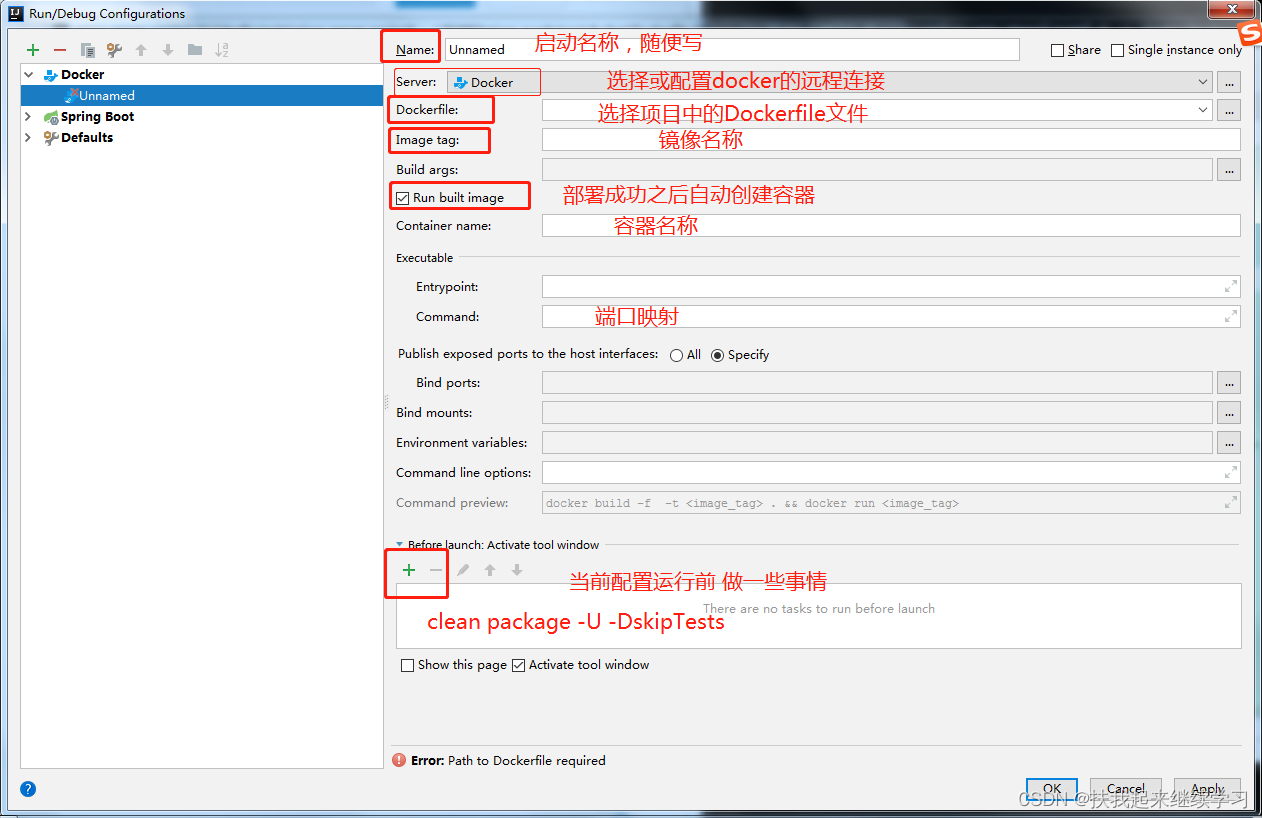
idea的server的docker部分会有日志访问容器所在服务器ip:映射到服务器的端口/项目名 所以这个项目的访问地址为http://192.168.175.130:8099/app。
在使用分页工具类进行分页操作时,如果使用一对多查询,会造成查询出来每一页数据数量不等于实际规定的每一个数据数量。原因在于,一对多查询的结果是包含了与子表链接的数据,例如在查询10个订单(order_header)数据时,假如有两个订单均包含2条订单条目(order_detail)数据,那么最终查询的10条数据只有8条order_header表的数据。通常,我们为了解决这种问题,首先会先获取到10条
2.需求方确定在标题中附带来源和作者相关信息,从标题中提取该部分信息,作为原创和作者绩效考核。
前言:在做图书查询,二手书买卖等经常需要用到图书信息,我们可以采用一种便捷的方式就是扫描图书后面的条形码,查询获取图书的信息。方式一:网页抓包法目前很多人都是采用douban的接口,但是现在豆瓣关闭的图书信息查询的接口,但是我们还是一个采用网页爬取的技术抓取信息。爬虫的方式很多中,go、php、python、java、js、.net等都是可以的例如我写的一个tp5爬取接口tips:可以将...
方式一 直接安装:`win+R=>cmd=>pip install jieba安装源在国外,容易安装过程超时而报错,可以考虑切换国内镜像源加速方式二 手动安装:先在官网下载python-jieba,然后进入下载文件中去输入python setup.py install显示下面情况显示按照安装成功notes:1.遇到’pip’不是内部或外部命令,也不是可运行的程序 或批...
Identification of Chinese herbal decoction pieces based on convolutional neural network写在前面:本文将介绍如何在matlab上面搭建卷积神经网络1.如何搭建cnn,2.常用概念,3.如何收集数据,4.程序解读一.背景图像识别技术已逐步应用于中医药领域,极大推动了中医药客观化、标准化相关研究。 采用模式识别方法不
1.确保已经安装node.js,如果没有去官网下载,然后手动一步步安装2.默认是使用npm,需要先换源,cnpm : 国内对npm的镜像版本3.也可以直接给npm换源,就不使用cpm x了4.安装yarn5.查看yarn版本6.给yarn换源7.yarn常用操作