- @qq_38951259


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
用自然语言描述你要什么数据,AI 生成生产就绪的爬虫代码
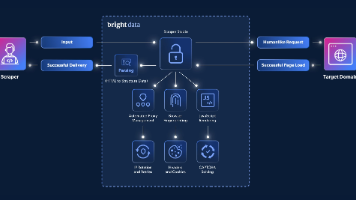
同时编排不同智能体的协作流程,让整个工作流(从搜索目标页面→抓取内容→分析数据→生成报告)全程自动化,无需人工干预。让 AG2 从 “实验级的智能体框架” 变成具备实用价值的生产级多智能体系统。AG2 是微软 AutoGen 库的演进版,一款开源的 AgentOS 框架,让多个专业智能体自主协作解决复杂任务,然而其自身依赖的 LLM 训练数据是静态的,且无原生的实时网页访问 / 数据抓取能力,无法
Scrapy是开源Python框架,没有内置代理池,需手动对接第三方代理并开发IP轮换逻辑,但是运维成本高,需专人处理IP封禁等问题,分布式部署配置复杂,对技术团队要求高。如果是企业级需求,追求稳定、高效、低维护,Apify,云端平台,内置基础代理池支持IP轮换,对新手比较友好,其代理规模仅为Bright Data 1/5,小众地区易封禁;其中对YouTube提供了8个抓取器,支持爬取视频详情、评
的爬虫工具,只有适配的工具。如果是个人小项目、技术试错,Scrapy、Selenium等开源工具可以满足需求,但要承担代理配置、运维和反爬的风险;如果是企业级需求,追求稳定、高效、低维护,Bright Data Web Scraper API无疑是最优选择,其内置的大规模代理网络和智能代理策略,可大幅降低企业的技术投入和成本消耗。Bright Data无论是可视化操作还是API调用,均无需配置代理
的体验还是不错的,特别是优惠力度很大。Amazon RDS通过托管化、可观测与弹性能力,显著降低了关系型数据库在云上的运维成本与风险,帮助团队把精力集中在产品与业务。落地重点在于:网络与安全的“最小开口”、以监控为依据的持续调优、稳健的变更与演练机制,以及对成本的精细治理。Aurora(MySQL/PG兼容):分存储与计算、6副本三AZ、秒级故障转移,读扩展强,但有引擎差异与成本门槛。专而深:抵扣
大模型存在知识滞后、信息封闭的短板,无法自主获取互联网实时内容与垂直行业数据,而大模型数据抓取器能够智能突破网页反爬限制,高效采集、清洗并结构化全网优质文本、资讯、行业资料等内容,为 RAG 知识库搭建、模型微调训练、实时信息问答与行业舆情监测提供高质量数据源,补齐大模型联网能力,提升回答准确性、时效性与专业度,是 AI 落地应用不可或缺的核心工具。
不管是Amazon亚马逊、LinkedIn领英、Zillow房产,还是Facebook、GitHub数据,全部都是实时更新的动态数据源,不是过时快照,适合长期跟踪、趋势预判。今天我以跨境电商选品为例,带大家下载数据集,用Agent 分析,直接算出类目价格涨幅、竞品密度、评论热度,全部都是能直接套用的落地结论。以前做一次选品、竞品复盘,至少要花一周!手动扒评论、盯价格,费时费力,结果还全靠经验预判,
之前有个需求要爬取某BOSS直聘的岗位信息, 我在Cursor 里让 Agent 去执行,它兴冲冲写出一堆 CSS 选择器,跑通了。过了一段时间,官方页面改了一个 class,整段 pipeline 直接归零,无力回天。公开数据明明在那,网站就是不让程序稳定拿,平台一改 DOM,你的 scraper 就废。如果你也在搭 Agent 工作流,我建议搞个稳定的解决方案去爬取数据。想先验证 Agent
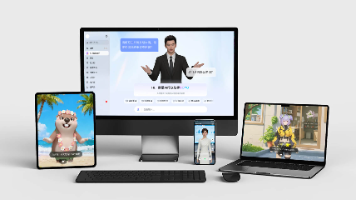
文章摘要: 本文通过家电卖场智能屏的三种交互体验对比,提出AI正从"文本交互"向"具身交互"演进的核心观点。作者指出,线下场景需要具备实时反馈、多模态表达的拟人化交互能力,而魔珐星云作为具身交互智能开放平台,通过自研参数流技术解决了传统方案延迟高、无法打断的痛点。文章以搭建门店导购智能体为例,演示了10分钟配置3D形象、SDK接入的实操流程,并对比测试显示:具身智能体支持实时打断、多通道反馈,其眼
从前期需求拆解、选定目标网站,再靠 AI Agent 一键生成爬虫代码,IDE 精细化调试,配置分页、多阶段分层抓取,设置定时自动调度,最后对接 S3 存储、Webhook 实现数据自动推送,以及 Self-Healing 自愈机制,解决网站改版爬虫直接报废的痛点,整套端到端流程一次性完整演示。很多做开发、数据分析的朋友都只会写零散单页爬虫,一碰到全链路采集、定时任务、网站反爬改版就束手无策。今天