


- @qq_15060477


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
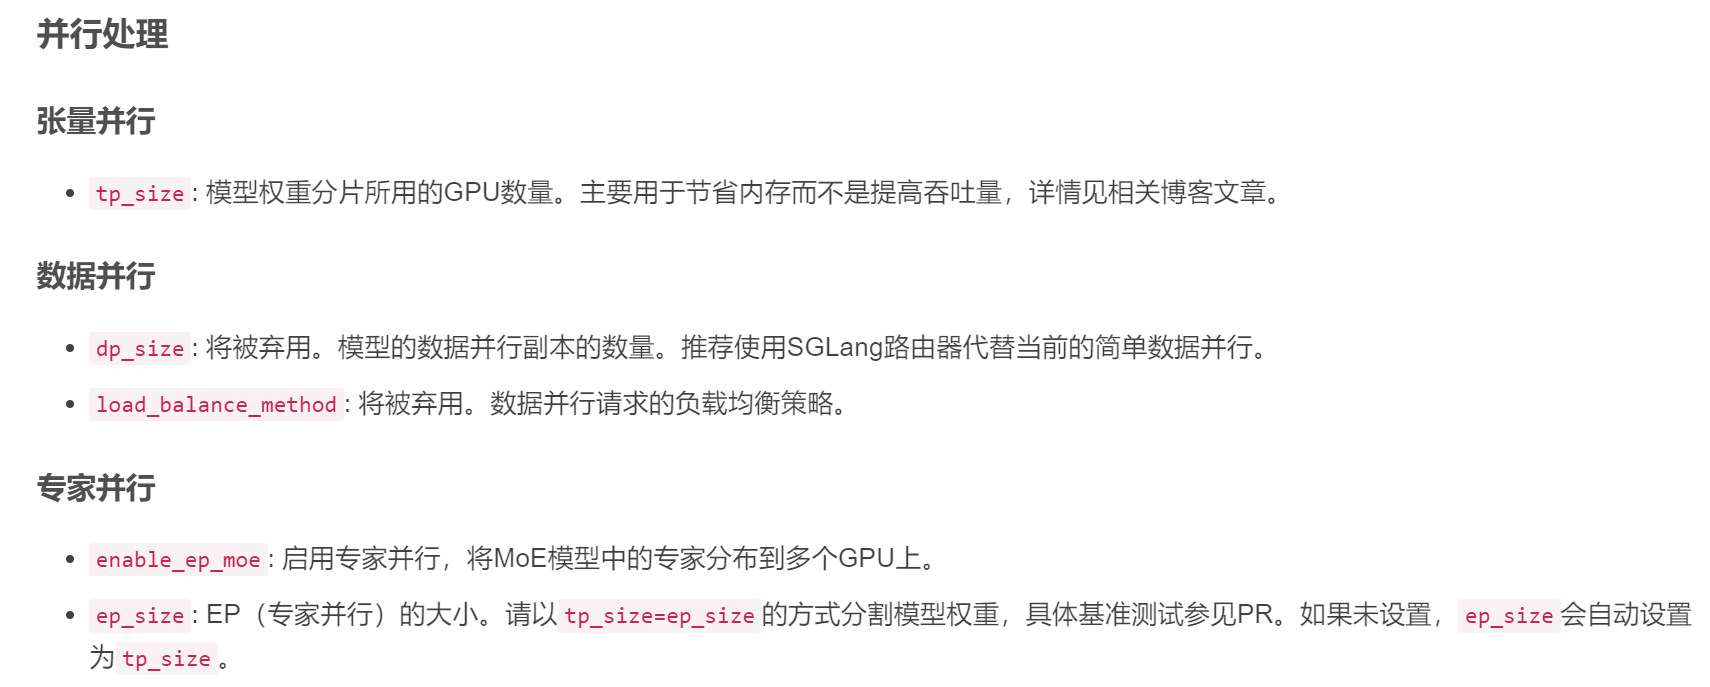
如果在服务过程中出现内存不足错误,请尝试通过设置较小的值来减少 KV 缓存池的内存使用量–mem-fraction-static。: 设置为true时,提供tokens给引擎并直接获取输出tokens,通常在RLHF中使用。: 使用的聊天模板。: 模型能够处理的token数量,包括输入的tokens。果在长提示的预填充过程中看到内存不足错误,请尝试设置较小的分块预填充大小。: 如果设置了此选项,则
1、下载之后安装bash miniconda3.sh2、按enter继续3、同意>>yes4、安装路径选择,若需要改变路径,在此处输入路径>>miniconda5、是否添加环境变量,选择yes>>yes6、安装完成,激活环境source ~/.bashrc7、更改镜像conda config --add channels https://mirrors.tuna
home/weights :存放权重文件,容器的home下被绑定。下面脚本中的ip_ad表示ip地址,比如10.101.21.10。进入容器,并切换到home目录下。
数据集已划分好|可以直接使用|yolov5|v6|v7|v8|v9|v10通用;yolo格式数据集之交通工具检测5种;数据整理不易,下载地址点。

如果在服务过程中出现内存不足错误,请尝试通过设置较小的值来减少 KV 缓存池的内存使用量–mem-fraction-static。: 设置为true时,提供tokens给引擎并直接获取输出tokens,通常在RLHF中使用。: 使用的聊天模板。: 模型能够处理的token数量,包括输入的tokens。果在长提示的预填充过程中看到内存不足错误,请尝试设置较小的分块预填充大小。: 如果设置了此选项,则
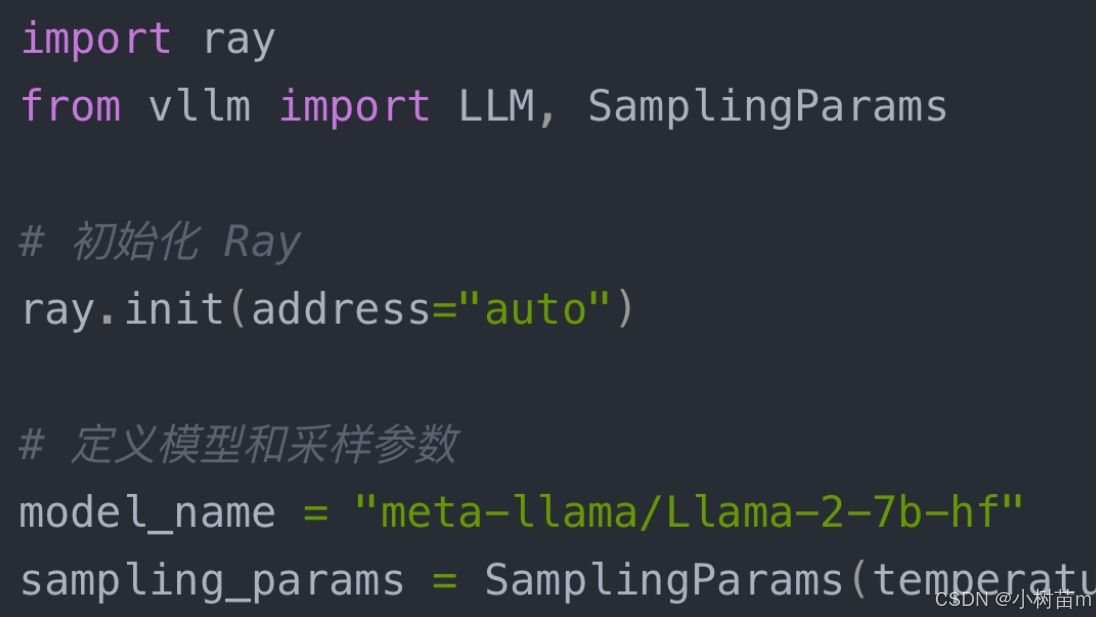
要在多节点多卡的环境中部署一个大模型,可以使用(Very Large Language Model)框架。vLLM 是一个高效的推理和服务框架,特别适合大规模语言模型的部署。
一、前言本翻译小程序功能为将ppt中的中文翻译称为英文。项目文件结构如下:1、newppt:转换成英文之后所存的ppt;2、oldppt:需要转换的ppt;3、chromedriver:需要自行下载,和电脑当中所使用的Google浏览器版本对应;4、main.py:主程序;5、translating.py:翻译的代码。二、main.py内容:#coding = utf-8from translat
数据集大小:约106M。

摘要:该代码定义了一个main函数,用于处理包含SQL内容的字符串。它使用正则表达式删除所有<think>标签及其内容,并去除字符串开头的空行。处理后的字符串还将所有下划线替换为连字符,最终以字典形式返回结果。该函数适用于清理和格式化包含特殊标记的文本内容。
数据集已划分好|可以直接使用|yolov5|v6|v7|v8|v9|v10通用;yolo格式数据集之交通工具检测5种;数据整理不易,下载地址点。