


- @master_hunter


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
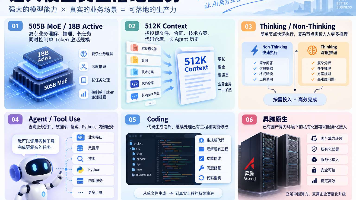
所以如果真把它放进企业系统,我不会让它包办一切,而是让它负责那些最难写成固定规则的理解、判断和规划,把计算、数据、权限和执行继续交给更确定的系统。模型变强以后,工程边界反而要画得更清楚。
在使用imblearn和sklearn库的时候调用from sklearn.datasets import make_classificationfrom sklearn.decomposition import PCAimport numpy as npimport pandas as pdfrom imblearn.combine import SMOTEENN报cannot import n
能使用机器学习算法模型的业务场景还是很少的,而且检验成本高,一般是建模比赛或者是其他相关赛事才能用到机器学习模型,而且衡量模型质量检测也是个问题。我们在学习阶段比较难应用到部分算法而且仅参照书本上少数例子很容易遗忘,在网上搜索有关机器学习算法练习的时候发现牛客正好有此题目分类,但是题目量比较少仅有五道,也算是练练手吧~牛客刷题使用方法题目还是太少了一下就做完了,希望牛客再出点题目,不够做。牛客刷题

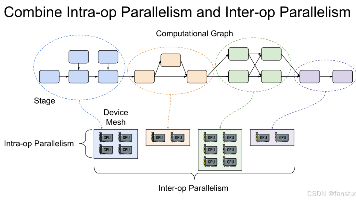
摘要:算子作为AI模型的"发动机",是深度学习落地的关键因素。文章指出,看似高大上的模型本质是由无数底层算子组成的流水线,算子将抽象指令翻译成硬件可执行的具体操作。通过实际案例展示了算子优化如何在不改变模型结构的情况下显著提升性能(280ms→80ms)。在大模型时代,FlashAttention等算子级创新已成为性能突破的核心。文章强调,理解算子对于解决跨平台部署、性能优化等
这轮重新跑完以后,我对 openPangu-2.0-Flash 的判断反而简单了不少。它没有在所有地方都赢,但在这一组严格结构化任务里,优势很明确。20 次正式请求全部首轮通过,没有字段漂移,没有多写一句不该出现的话,也没有进入修复流程。对于需要直接把模型输出交给下游程序的工作流,这种“按要求来”比回答得更漂亮更重要。
摘要: 当前Agent系统的核心挑战已从"能否运行"转向"如何优化"。传统日志仅记录执行结果,无法捕捉决策轨迹,导致优化缺乏数据支撑。openJiuwen的轨迹采集方案通过结构化记录工具描述、LLM参数等关键上下文,将Agent运行过程重构为可分析、可训练的数据对象。这种从"服务日志"到"决策轨迹"的范式转变,为强化学
本文探讨了企业级智能体系统从单Agent向多智能体协同的演进路径,重点分析了JiuwenClaw框架如何构建采购智能分析系统。文章指出,企业业务需求不是简单的问答,而是包含语义理解、任务规划、SQL生成、工具调用、数据分析等环节的连续任务链。传统单Agent方案存在职责臃肿、工具调度混乱、任务不可追踪三大问题。JiuwenClaw通过协同运行层架构,将复杂任务拆解为Planner、SQL、Data
通过本章的实战开发,我们借助腾讯云 CodeBuddy 高效构建了一个智能岗位推荐系统的核心模块。从项目初始化、岗位数据处理、用户画像建模,到岗位推荐算法和 API 接口搭建,每一个步骤都体现了智能代码助手在降低开发门槛、加快开发节奏、提升代码质量方面的巨大优势。

本文介绍了利用火山引擎Doubao-Seed-Evolving模型(1M上下文能力)开发"招标文件版本差异审查器"的全过程。该工具能自动识别两版招标文件中的新增、删除、修改等十类关键变化,并生成结构化差异报告。开发过程包括:1)环境配置与模型调用设置;2)Codex引导的项目开发,实现PDF解析、差异分析、结果校验等功能;3)测试验证,模型准确识别了预设的金额、日期、资格条件等

本文介绍了一个利用BrightData和Coze搭建的跨境选品情报Bot方案,旨在解决跨境卖家和小团队面临的市场信息获取难题。该Bot能够自动监控竞品价格、关键词排名和新品趋势,主要包含三个功能模块:竞品价格日报Bot、关键词SERP监控Bot和新品趋势雷达Bot。通过BrightData获取公开网页数据,再由Coze生成结构化市场报告,该方案将人工信息收集工作自动化,特别适合资源有限的跨境小卖家
