- @jusoucloud


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
SSH连接超时问题排查指南 当SSH连接出现"Connection timed out"错误时,通常表明请求未能到达目标主机的22端口。本文提供了系统化的排查流程: 网络层检查:首先验证本地网络环境,包括ping测试、代理设置和DNS解析。特别注意不同网络环境(如公司/家庭网络)可能存在的出口限制。 服务器状态确认:通过云控制台检查实例运行状态,使用VNC功能验证服务器是否响应,查看监控数据和事件
当AI应用从单点实验走向规模化落地,越来越多团队选择把训练任务拆解到不同云厂商——这并非追逐概念,而是为了绕过单一区域的GPU资源排队、降低跨地域推理延迟。这种“多云环境AI部署配置实践”正在从选答题变成必答题,而随之而来的镜像同步、数据一致性和容灾切换,考验着每一个没有专属云架构师的团队。
当企业从“大模型能跑”转向“用户能等”,首字延迟(TTFT)已经从技术细节升级为产品体验的生死线。一个实时对话场景中,几百毫秒的等待就可能触发用户刷新或跳出,而长文档分析任务里,TTFT一旦超过十秒,交互感便近乎崩溃。

几百万行日志滚屏,运维盯着屏幕找“error”——这种原始操作至今仍是不少团队的日常。告警刷得人麻木,真故障反而被淹没。把排查工作交给一个本地大模型日志分析方案,让模型替你做语义理解,才有余力去处理真正值得关注的事件。
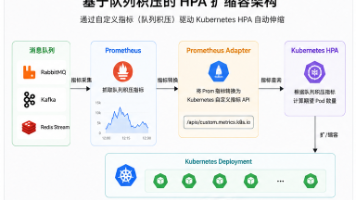
Kubernetes 原生的 Horizontal Pod Autoscaler(HPA)默认只认 CPU 和内存这类资源指标,但资源使用率高≠业务繁忙,资源使用率低≠队列清空。基于队列积压的 HPA 扩缩容,本质上是把消息队列的长度、任务积压量这类业务指标通过自定义指标通道喂给 HPA,让它根据“还有多少活没干”来决定要不要加 Pod、加几个 Pod。
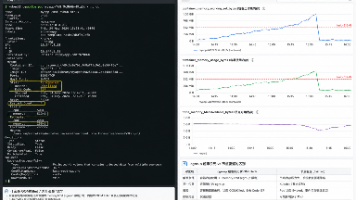
线上容器服务突然重启、日志近乎空白,用kubectl describe一查,状态栏赫然显示OOMKilled——这类故障没有堆栈、没有报错,排查起来就像在找一只隐形的黑洞。本文从内核机制和cgroup约束出发,给出一套可落地的Pod OOMKilled排查修复路径,帮你把“为什么被杀”和“怎么不再被杀”一次理清。
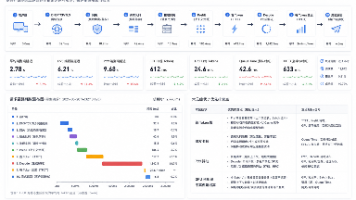
模型跑通了,demo 很流畅,一上线用户喊“慢”——这是 2025 年以来我们帮多家做 AI 应用的团队做排障时,听得最多的场景。大模型应用延迟排查之所以棘手,是因为延迟不是单一维度的“推理慢”,而是从客户端、网络、网关、推理实例到 Token 生成的整条链路上,任一环节都可能成为瓶颈。不建立全链路的时间线,几乎没法对症下药。
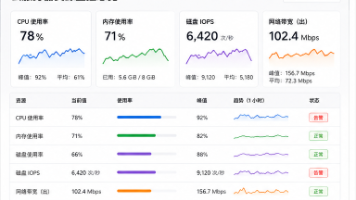
拿到“云服务器运行变慢怎么办”这个问题的运维人,多半已经试过重启,看着监控曲线却找不到明确病因——这才是最让人抓狂的时刻。服务器性能降级不像宕机那么干脆,往往是 CPU、内存、磁盘和应用程序纠缠在一起逐步恶化,排查思路一旦跳跃,很容易陷入“补丁式”调优。
线上 GPU 推理服务第一次报 OOM,多半不是权重加载撑爆显存,而是跑了一段时间后,某个并发请求或长序列把最后几 GB 击穿。
成都地区的大模型推理服务一旦出现延迟升高,团队第一反应往往是升级GPU机型,但真正需要先做的是成都阿里云大模型延迟排查:确认延迟来自算力、显存带宽还是请求排队。否则加卡可能只增加成本,不解决问题。