
深圳火山引擎代理商经验:GPU大模型推理OOM如何降低显存占用
本文由 国内云代理商『聚搜云 JuSouYunClouD -服务器服务商•撰写』如需转载请注明!
火山引擎大模型推理显存优化:深圳代理商实战指南
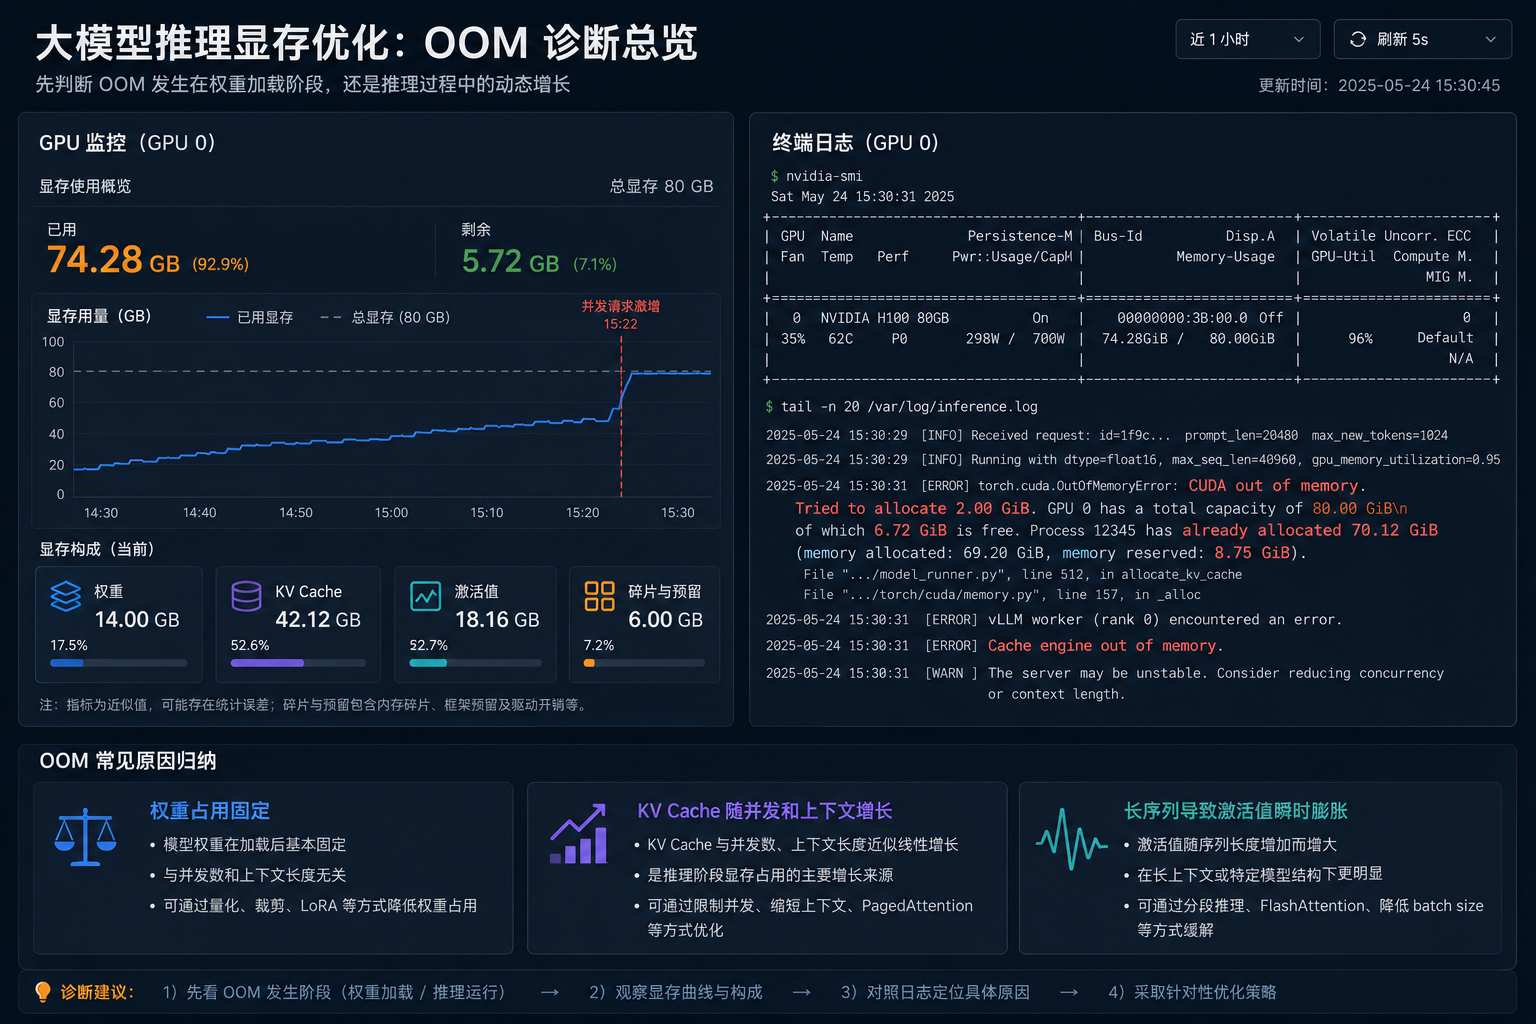
线上 GPU 推理服务第一次报 OOM,多半不是权重加载撑爆显存,而是跑了一段时间后,某个并发请求或长序列把最后几 GB 击穿。nvidia-smi 显示显存顶满,进程被 K8s 或 systemd 反复拉起。深圳火山引擎代理商在排查火山引擎大模型推理显存优化问题时,会先确认 OOM 是发生在权重加载阶段,还是推理过程中的动态增长,这一步判断决定后续优化方向。
为什么GPU大模型推理会出现OOM?
这类故障在日志里不会只说一句 CUDA out of memory,关键要看报错中的分配量、已占用和剩余显存。很多运维第一次看到 OOM 就调小 batch size,但如果显存碎片或 KV Cache 预留设置不合理,问题很快会复发。
OOM到底意味着什么?
OOM(Out of Memory)是 CUDA 向显存池申请连续空间失败,不是 GPU 硬件故障。PyTorch 里常见报错为 torch.cuda.OutOfMemoryError: CUDA out of memory,vLLM 里会看到 Cache engine out of memory。典型日志会给出 Tried to allocate、already allocated 和 free 三个关键值:
CUDA out of memory. Tried to allocate 2.00 GiB (GPU 0; 80.00 GiB total capacity; 70.12 GiB already allocated; 6.72 GiB free; 8.75 GiB reserved in total by PyTorch)
Tried to allocate 后的 2GiB 只是触发失败的那次请求,already allocated 70.12GiB 才是当前占用。只盯 free 空间容易误判,真正要警惕的是显存碎片、KV Cache 预留过大和某些激活值瞬时膨胀。
显存都被谁吃掉了?
大模型推理显存主要由模型权重、KV Cache 和中间激活构成。权重加载后基本固定,如 FP16 的 7B 模型约 14GB;动态增长的是 KV Cache 和激活。KV Cache 随序列长度和并发 batch size 近似线性增长,长文档场景序列长度从 512 涨到 4096,KV Cache 占用可能放大数倍,几十路并发易击穿 80GB 显存。激活值受输入形状影响,长序列下 attention 层常临时申请大块显存。因此只看 nvidia-smi 总占用不够,还要用 profiler 拆出三类峰值。
显存优化核心思路与常见误区
显存优化怎么着手
在火山引擎GPU实例上遇到大模型推理OOM,先不要急着调小batch size。更大的显存消耗往往来自KV Cache和中间激活值,而不是模型权重本身。以7B参数模型为例,FP16权重约占14GB显存,但在多轮对话或长文档场景下,KV Cache随序列长度和并发数线性增长,很容易超过权重占用。建议先用nvidia-smi --query-gpu=memory.used,memory.total --format=csv记录基线和请求过程中的显存变化,再决定优化方向。深圳火山引擎代理商聚搜云在整理这类推理环境时发现,多数OOM并不是权重放不下,而是KV Cache分配上限与目标并发数没有匹配,调错参数后问题会反复出现。
避开优化误区
把batch size调到极小并不是安全策略,反而会让GPU计算单元利用率大幅下降,吞吐变差,服务延迟波动更明显。更合理的做法是设置显存水位阈值,并配合连续批处理动态调度请求。量化方面不要默认INT4一定严重损伤精度,应先从INT8开始,在自有评测集上验证精度损失,再决定是否进一步压缩。所有调参都应基于nvidia-smi或Profiling工具的监控数据,而不是凭拍脑袋改参数。深圳火山引擎代理商的实际运维中,只调参数不看显存分布导致的重复OOM很常见,换一个batch size无法根治KV Cache膨胀带来的问题。
降低显存占用的关键技术方法
显存优化不是把 batch size 调小就完事。从深圳火山引擎代理商聚搜云接触到的企业运维场景来看,多数显存 OOM 是 batch size、KV Cache 和模型权重三者叠加触顶,单独调整一个参数往往只能延后故障,无法根治。下面按三个方向说明如何在火山引擎 GPU 实例上降低大模型推理显存占用。
一、如何调整批处理大小:先定显存预算,再设并发上限
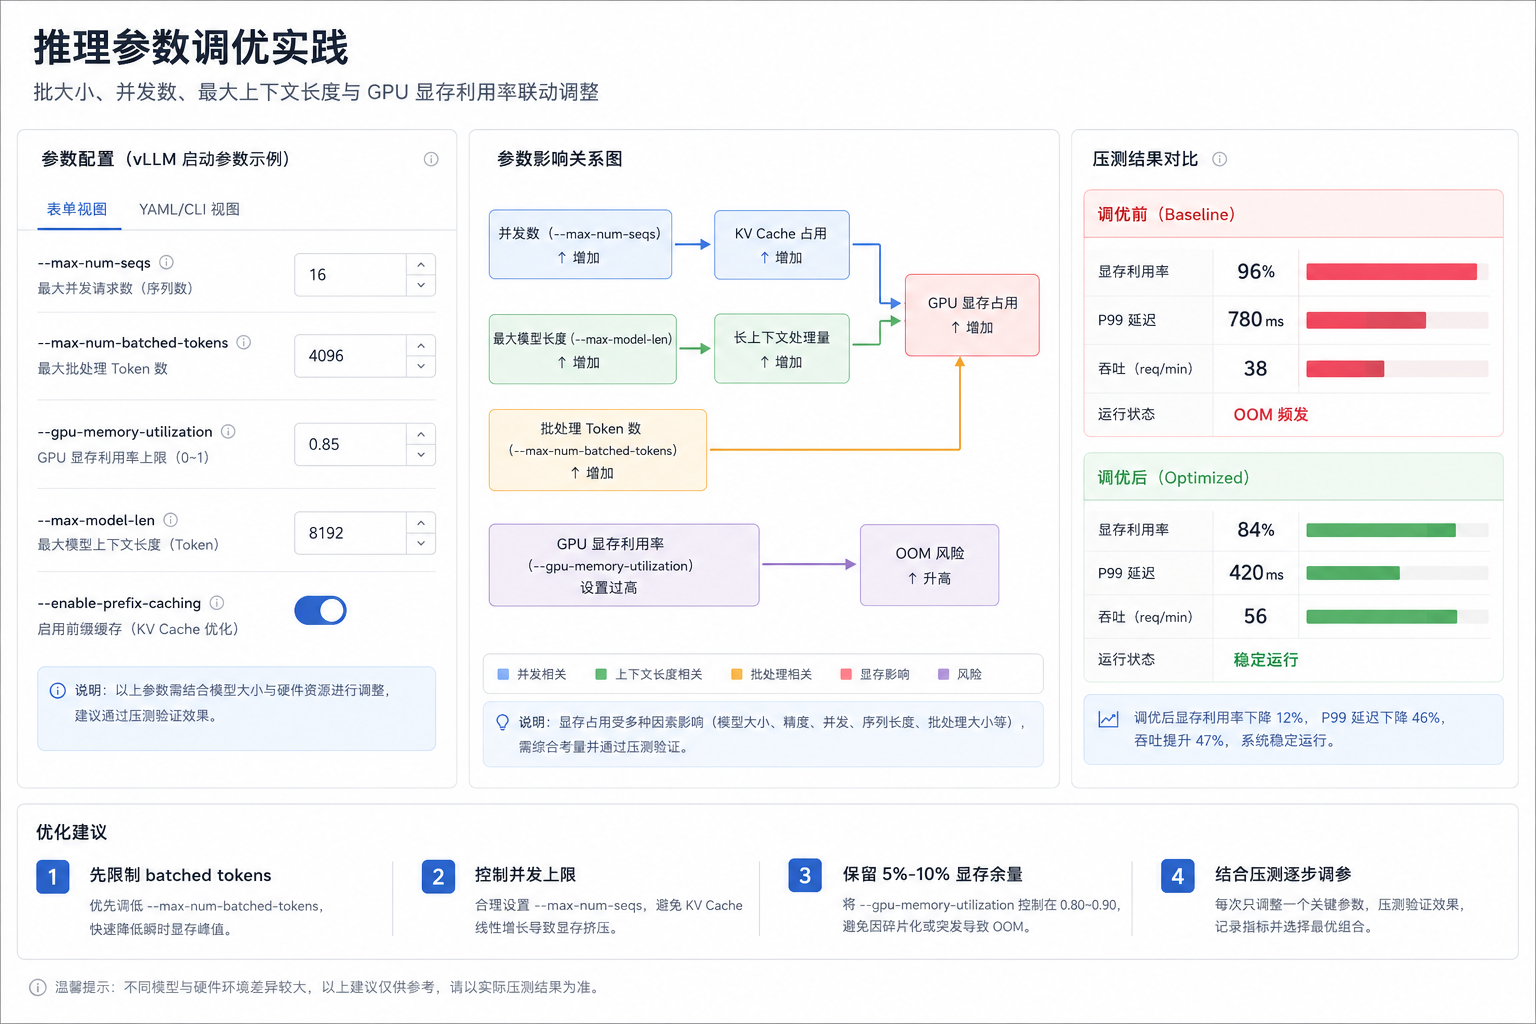
batch size 会同时放大激活值和 KV Cache 占用,瞬时并发峰值比平均负载更容易打穿显存。先在火山引擎 GPU 实例上用 nvidia-smi -l 1 观察显存基线,再在推理框架里限制并发。vLLM 建议同时配置 --max-num-seqs 和 --max-num-batched-tokens:
python -m vllm.entrypoints.openai.api_server \
  --model /data/models/Qwen2.5-7B-Instruct \
  --max-num-seqs 16 \
  --max-num-batched-tokens 4096 \
  --gpu-memory-utilization 0.85
max-num-batched-tokens 对长文本请求尤其关键,它限制单个 batch 的 token 总量,比只限制请求数更贴近显存占用。批大小不是越小越好,过小会明显降低 GPU 利用率和吞吐,应以压测中显存占用稳定在 85% 以下为上限。
二、如何启用 KV Cache 优化:PagedAttention 不是万能,要预留余量
长上下文和多轮对话中,KV Cache 随序列长度和并发数线性增长,是 OOM 的主要推手。vLLM 默认启用 PagedAttention,但 --gpu-memory-utilization 不宜拉满。该参数决定 KV Cache 可使用的显存比例,设置到 0.90 以上时,权重加载后的剩余显存可能不足,启动阶段就报 OOM。可先按以下配置启动:
python -m vllm.entrypoints.openai.api_server \
  --model /data/models/Qwen2.5-14B-Instruct \
  --max-model-len 8192 \
  --gpu-memory-utilization 0.88 \
  --enable-prefix-caching
--enable-prefix-caching 对多轮对话的重复前缀有直接收益。压测时除了看 nvidia-smi,还要关注日志中 cache_config 分配的 GPU KV cache 大小和可用 token 数,留 5% 到 10% 余量比追求最大缓存更稳定。
三、如何应用模型量化:INT8 先验证,INT4 再压空间
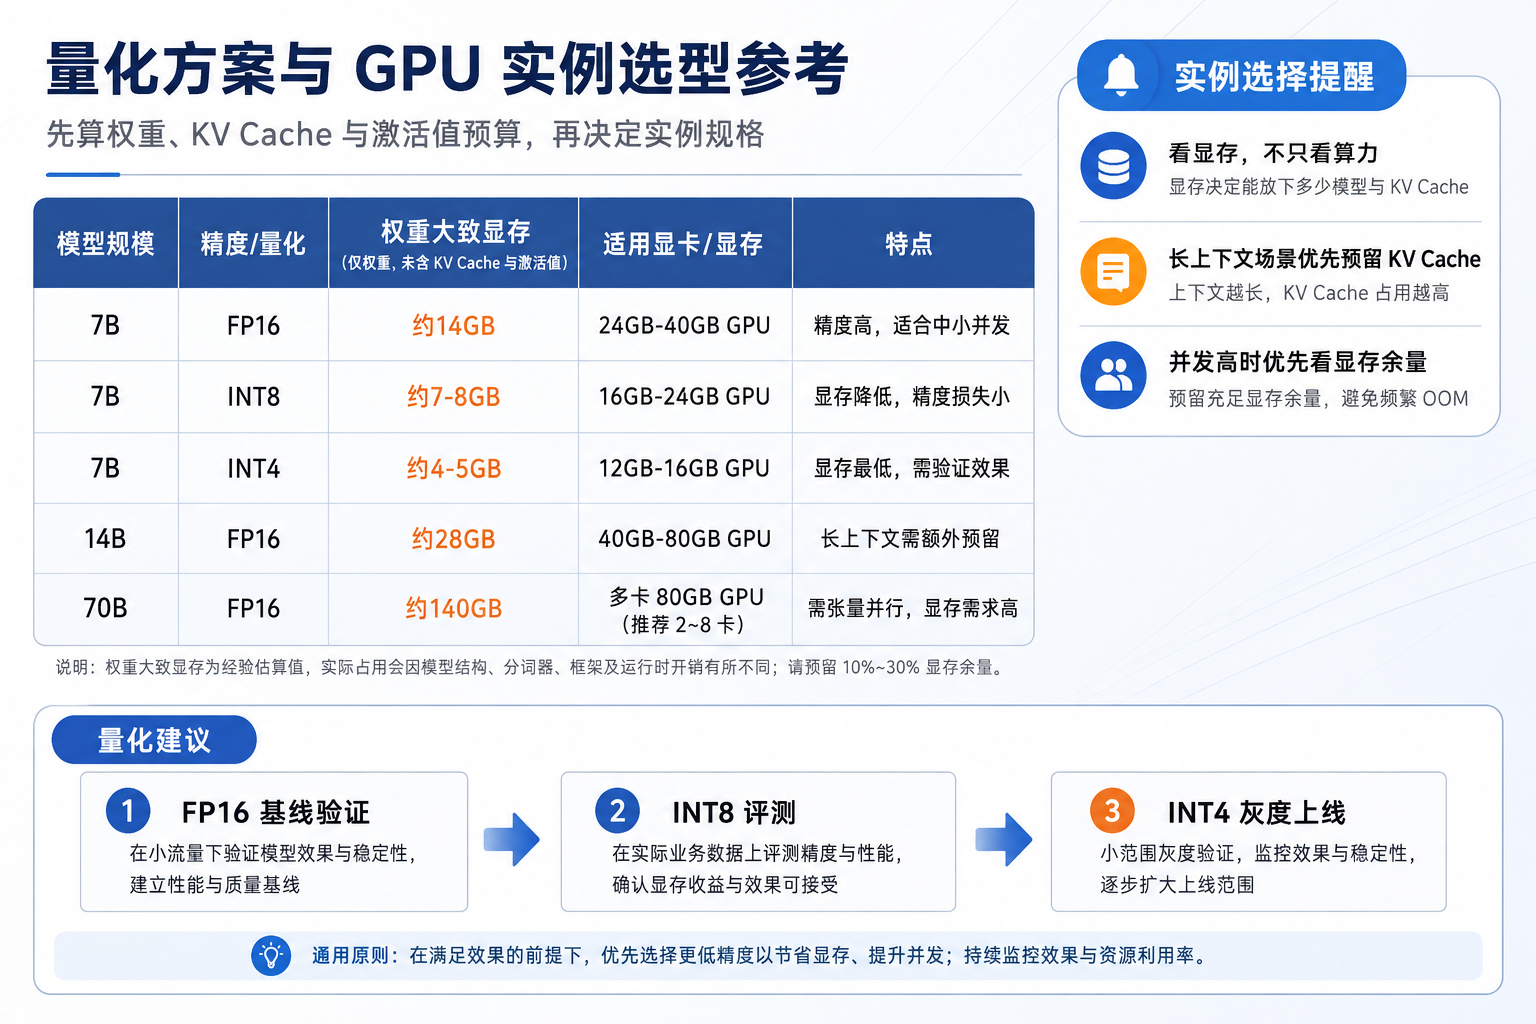
量化主要降低权重显存占用,对激活值和 KV Cache 压缩有限,适合权重占比高、并发不高的场景。不要直接上 INT4,先用 INT8 做业务评测,精度可接受再继续压缩。Transformers 加载 INT8 模型示例:
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

quant_config = BitsAndBytesConfig(load_in_8bit=True)
model = AutoModelForCausalLM.from_pretrained(
    "/data/models/Qwen2.5-7B-Instruct",
    quantization_config=quant_config,
    device_map="auto"
)
如果使用 vLLM 加载 GPTQ/AWQ 量化模型,加 --quantization awq 即可。量化不是无损,是否可用要回到 ROUGE、问答准确率或人工抽检等业务指标判断,并保留原始权重作为回退版本。
火山引擎GPU服务的显存配置实践
显存配置的核心不是找最低价实例,而是先算出模型权重、KV Cache和激活值这三部分各自需要多少空间。从深圳火山引擎代理商聚搜云整理到的运维案例来看,多数OOM并不是卡不够快,而是显存预算没做细,下面按实例选型和加速工具配置两条线展开。
火山引擎实例怎么选:先算权重和KV Cache两笔账
选 GPU 实例先看显存,不要只盯 TFLOPS。70B 参数 FP16 权重就占 140GB,单张 80GB A100/A800 放不下,须多卡或 INT4;7B/13B FP16 在 80GB 卡上可行。深圳火山引擎代理商在选型时通常建议先用 nvidia-smi 跑一次空载权重加载,再按目标并发预留 KV Cache 余量。火山引擎上 A100/A800/H800 80G、T4 16G 需据此匹配。
如何配置加速工具:vLLM 的显存控制参数
vLLM 的 PagedAttention 能降低 KV Cache 碎片,但参数要显式调。启动时用 --gpu-memory-utilization 0.90 --max-model-len 4096 --max-num-seqs 32,其中 gpu-memory-utilization 控制显存上限,max-model-len 限制单请求最大长度,max-num-seqs 限制并发数。长上下文 OOM 时优先降 max-num-seqs 或收紧 gpu-memory-utilization,不要直接砍 max-model-len。量化可加 --quantization awq,先 INT8 验证精度再压 INT4。
深圳企业使用火山引擎的实战经验
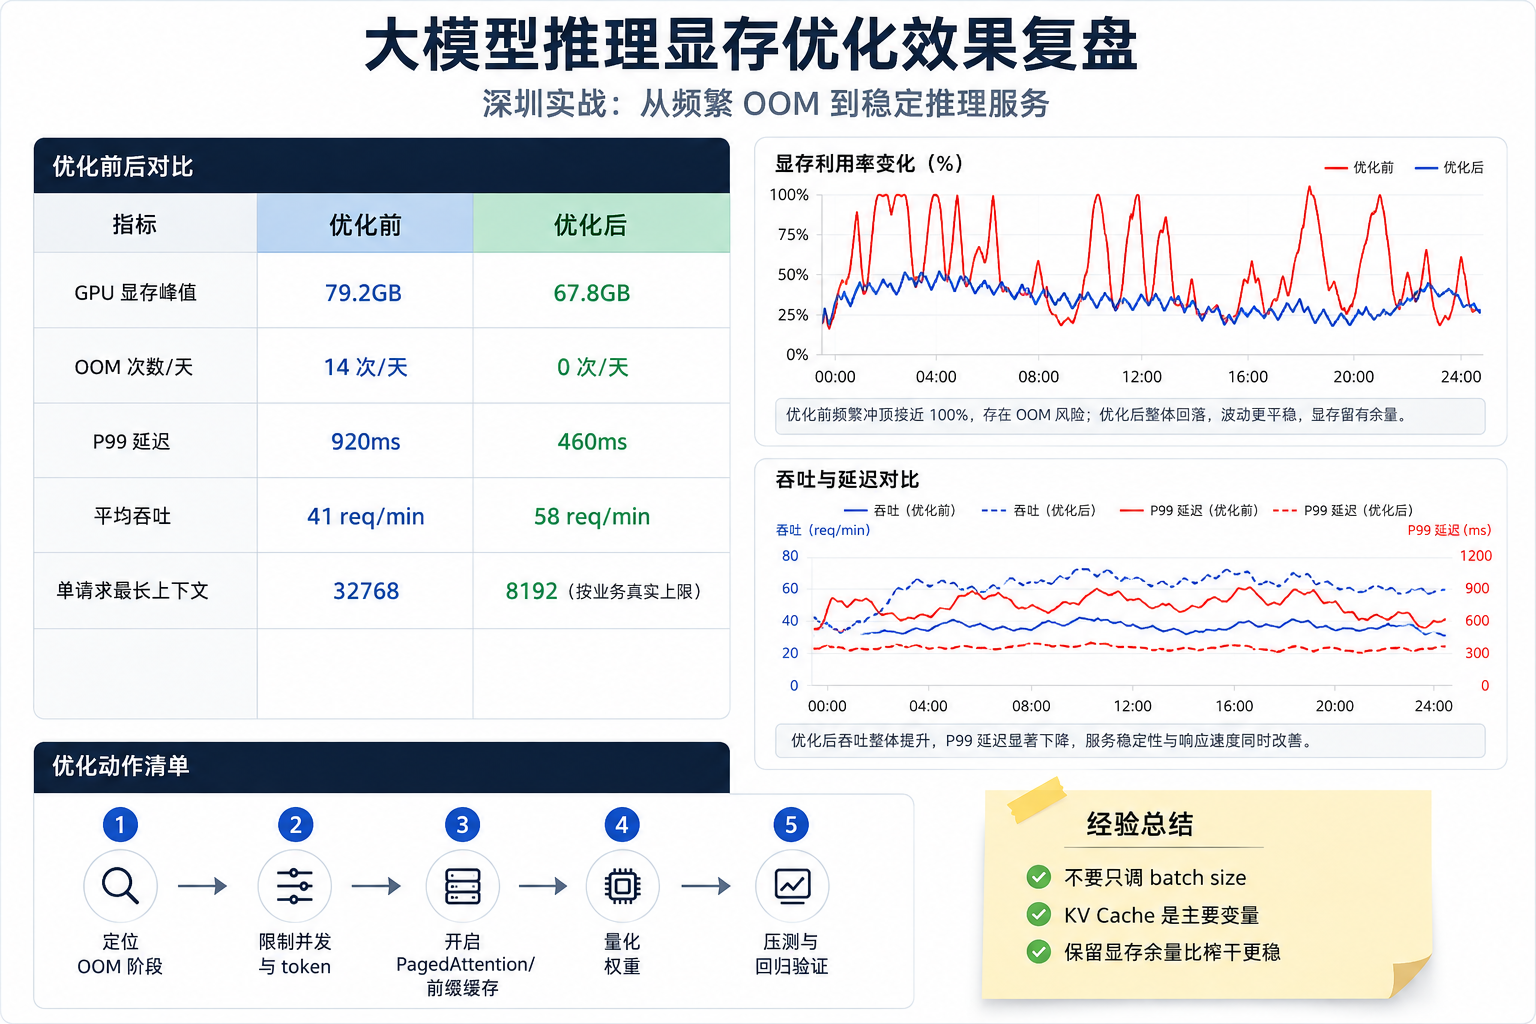
在深圳本地企业部署火山引擎 GPU 实例做在线推理时,显存优化通常不是“加钱换卡”就能解决。从深圳火山引擎代理商聚搜云接触到的运维场景来看,多数 OOM 出现在默认参数下 KV Cache 膨胀、连续批处理并发未设上限,或 max-model-len 远大于真实请求长度。先量化显存去向,再动参数,比盲目降 batch size 更可靠。
本地案例如何优化:先给 KV Cache 设上限,再用 PagedAttention 降碎片
本地案例里较有效的路径是:用 nvidia-smi --query-gpu=memory.used,memory.total --format=csv -l 5 观察基线和峰值;vLLM 部署时把 --gpu-memory-utilization 从默认 0.9 调到 0.85 左右,留出激活值余量,同时设置 --max-num-seqs 限制并发,避免 KV Cache 被长文本请求打满。启用 PagedAttention 后,KV Cache 按页分配,碎片减少,长文档和长对话的 OOM 概率会明显下降。
常见问题怎么解决:INT8 先压权重显存,INT4 按业务验证
当模型权重占用过高,可用显存撑不住目标并发,先做 INT8 量化通常能降权重显存约一半,且主流推理框架对 INT8 支持成熟,精度损失需用业务评测确认。深圳火山引擎代理商在协助本地企业处理长上下文 OOM 时,一般建议保留一份 FP16 权重用于回退,同时把 --max-model-len 设置为业务真实上限,而不是直接拉到 32768。这样 KV Cache 不再按理论最大长度预分配,显存占用更贴近实际负载。
如何获取专业显存优化支持
代理商服务有哪些
从深圳火山引擎代理商聚搜云整理的运维案例来看,火山引擎大模型推理显存优化支持不是简单推荐更高显存实例,更多是调整推理引擎参数。例如 vLLM 的 gpu_memory_utilization 默认 0.90,长上下文下 max_model_len 过大时 KV Cache 会吃满剩余显存触发 OOM。合理服务应包含:用 nvidia-smi dmon 或 PyTorch Profiler 抓基线,确认权重/激活/KV Cache 占用比例,再给出 max_num_batched_tokens、max_num_seqs、max_model_len 的调整范围。只报价格不问并发和 token 长度的代理,给不出可落地的显存建议。
如何联系火山引擎代理
联系深圳火山引擎代理商前,先整理模型名称、参数量、量化格式、最大输入/输出 token、并发 QPS、显存规格、OOM 日志和 nvidia-smi 输出。这样可直接进入显存预算计算。选代理优先看是否熟悉 vLLM、TensorRT-LLM、SGLang 的显存参数,能否配合压测做 profiling。火山引擎官网合作伙伴页面会展示本地代理范围,具体名单以官方页面为准。最终判断标准只有一个:能否把 OOM 日志翻译成可执行的参数和配置变更。
更多推荐


 16
 0
- 0


 已为社区贡献13条内容

所有评论(0)