
大模型推理跑起来延迟很高?成都阿里云代理商聊聊核查思路
成都阿里云大模型延迟排查与GPU批处理优化
成都地区的大模型推理服务一旦出现延迟升高,团队第一反应往往是升级GPU机型,但真正需要先做的是成都阿里云大模型延迟排查:确认延迟来自算力、显存带宽还是请求排队。否则加卡可能只增加成本,不解决问题。
大模型推理延迟高的常见症状与影响
什么是推理延迟?为什么它更依赖显存带宽而不是浮点算力?
大模型推理延迟指从请求发出到生成完整回复的总耗时,包含首token延迟和后续生成时间。与训练不同,推理阶段单token计算量很小,瓶颈在显存带宽和KV Cache访存效率。阿里云GPU实例上,如果显存带宽被打满,即使GPU算力利用率不高,延迟也会显著上升。
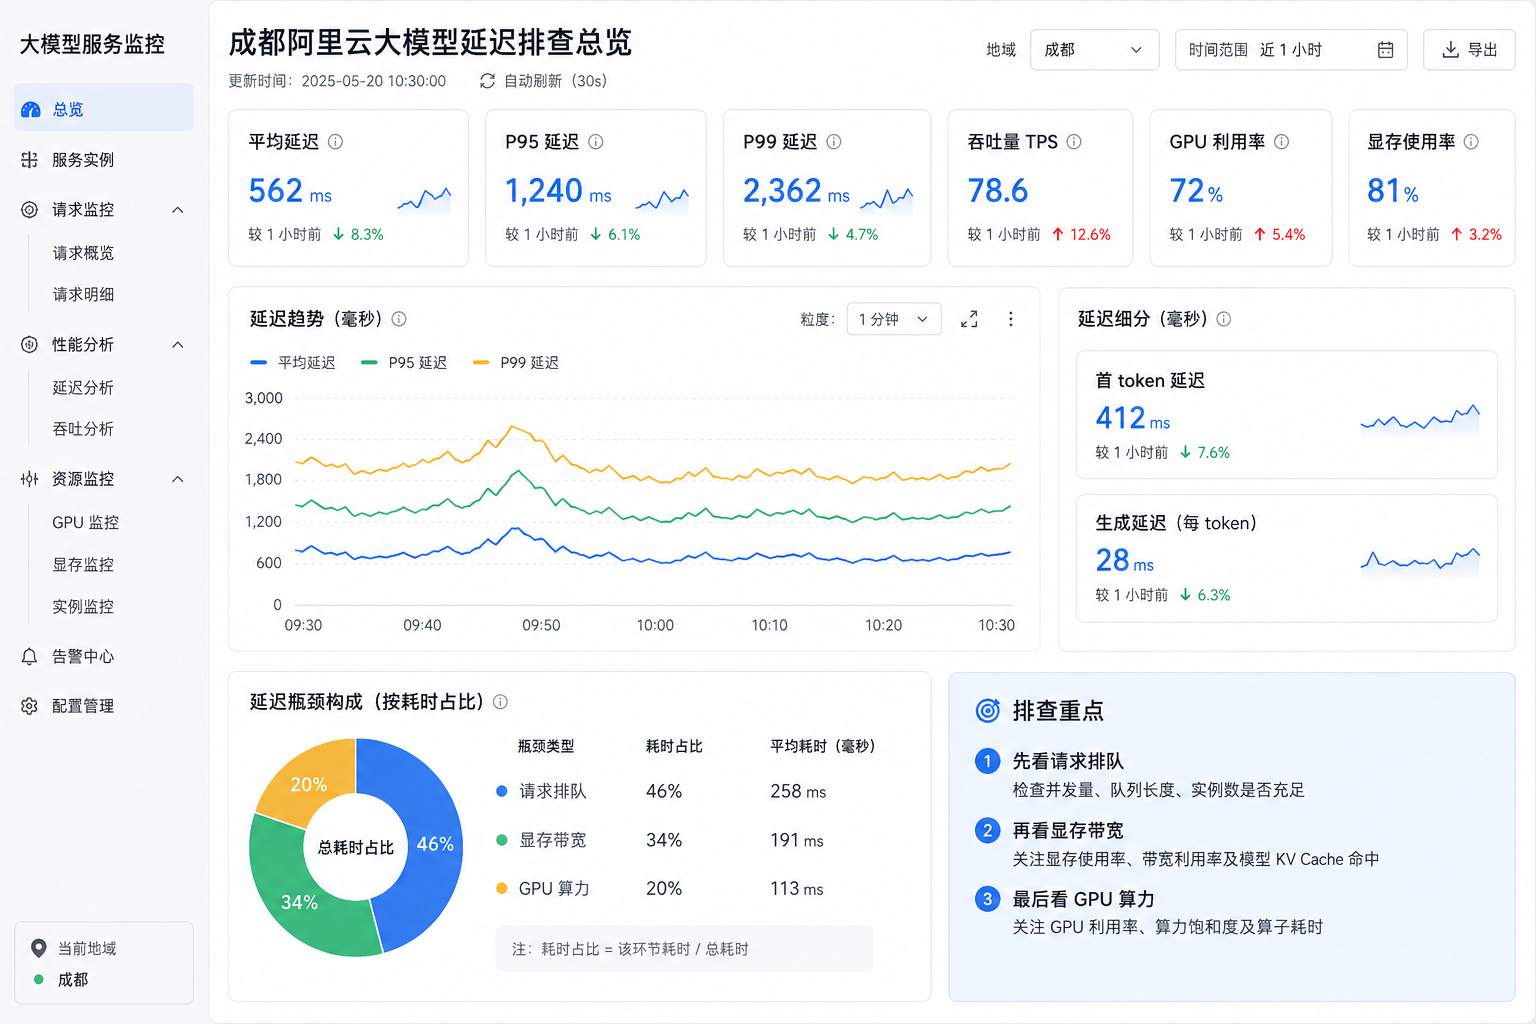
延迟高的典型表现有哪些?GPU利用率100%也可能是“假忙”?
从成都阿里云代理商聚搜云接触到的企业运维场景来看,不少团队看到GPU利用率100%就认为算力不足,实际上这是批处理队列积压导致的假忙。真正需要关注的是每秒完成的推理请求数——如果利用率高但吞吐不涨,说明请求在排队等待,而不是在计算。这类场景下盲目加大batch只会让P99延迟进一步恶化。
延迟对业务的影响有多大?为什么P99比平均延迟更关键?
大模型服务通常面向对话或生成类业务,用户对长尾延迟极其敏感。平均延迟正常但P99超过2秒,前端仍会出现明显卡顿。GPU降频可导致算力下降20%-30%,在成都夏季高温环境下尤其需要关注。因此延迟排查不能只看均值,P95/P99才是服务质量的核心指标。
GPU性能瓶颈的排查方法
在成都阿里云大模型延迟排查中,当CPU、内存和网络链路初步排除后,GPU侧通常成为主要怀疑对象。从成都阿里云代理商聚搜云接触到的运维场景来看,GPU延迟排查最容易被利用率指标误导:显存带宽、批处理队列和降频同样会拉高P99延迟。建议把GPU利用率、显存占用、时钟频率三个维度的数据放在一起看,而不是孤立盯一个数值。
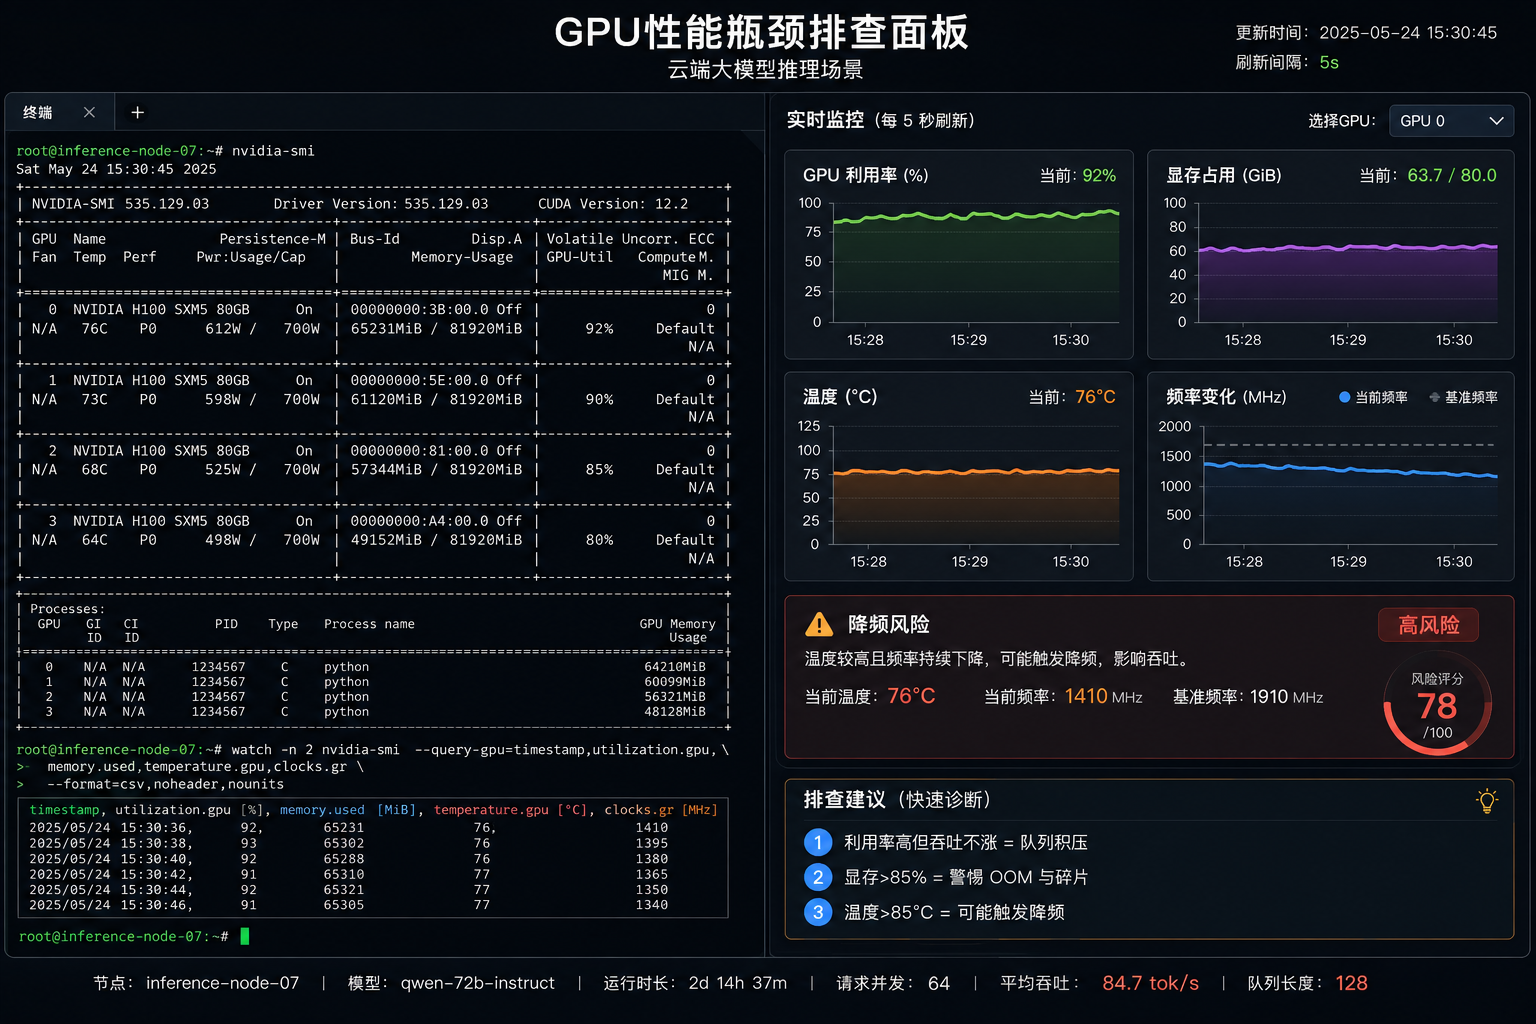
GPU利用率怎么看
nvidia-smi --query-gpu=utilization.gpu,memory.used,temperature.gpu,clocks.gr --format=csv -l 10 可做分钟级采样,阿里云云监控也提供GPU指标。判断时利用率100%不一定是有效产出,可能是动态批处理队列积压。若利用率长期低于30%但延迟仍高,瓶颈多在队列调度或数据传输等待,需要结合每秒完成请求数和P99判断。
显存不足的判定
先看 nvidia-smi --query-gpu=memory.used,memory.total,memory.free --format=csv -l 5,已用显存超过85%且持续上升时需警惕OOM。日志出现 CUDA out of memory 时,优先下调 max_batch_size 或 max_seq_len,或启用vLLM PagedAttention降低KV Cache碎片。显存稳定在90%以上但无OOM,也可能因频繁显存回收造成延迟毛刺。
频率与降频问题
用 nvidia-smi -q -d CLOCK,POWER,TEMPERATURE 查看频率,关注 Clocks Event Reasons 中的 SW Thermal Slowdown、HW Thermal Slowdown 或 Power Cap。成都地区夏季气温高,GPU温度超过85°C可能触发降频保护。云上实例虽由阿里云底层管理散热,仍建议在云监控中设置GPU温度>85°C、显存使用率>90%的告警;发现降频后应降低并发密度或错峰执行大批量任务。
批处理参数对延迟的影响
在成都阿里云大模型延迟排查中,批处理参数配置不当往往比 GPU 算力不足更容易被忽视。从成都阿里云代理商聚搜云整理的运维案例来看,相当一部分延迟升高并不是显存或算力吃紧,而是 batch size、并发队列和动态批处理上限长期使用“经验值”,业务模型变化后没有重新校订。下面从三个参数维度拆解。
批大小怎么设
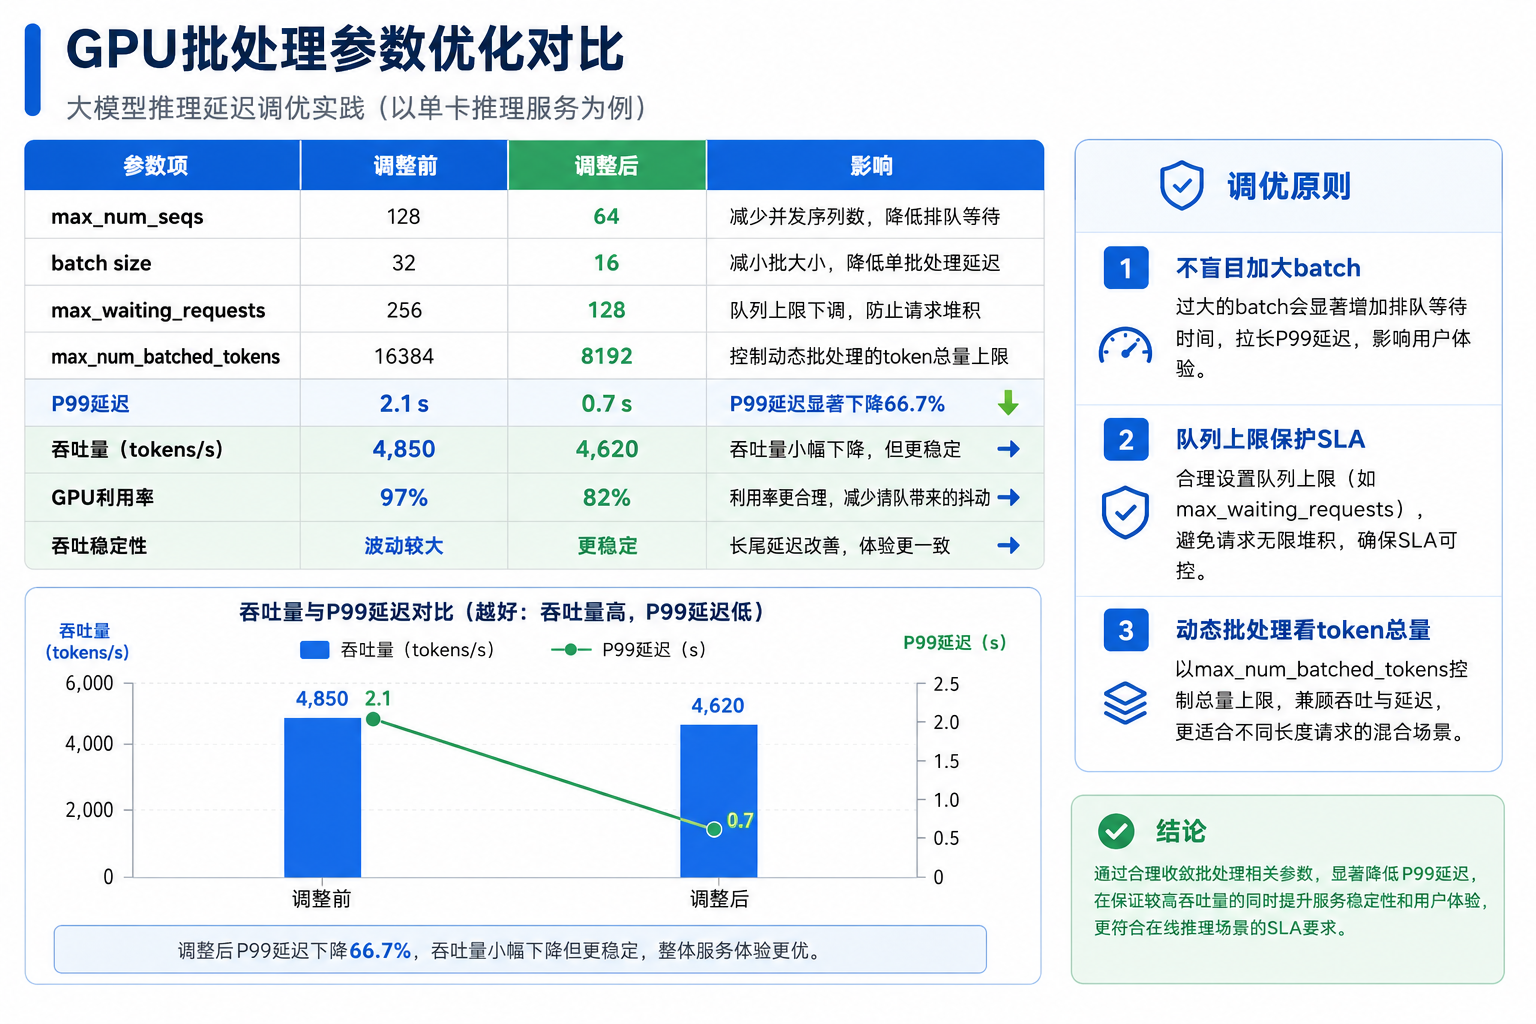
批大小不是越大越好,尤其在首 token 延迟敏感的场景。以单卡推理为例,batch size 从 1 调到 4,吞吐通常有 20%—40% 的提升,但单个请求的排队时间也会随之增加;当 batch size 超过 16 后,P99 长尾延迟上升更明显。建议用压测找到“延迟-吞吐”拐点:固定并发,逐步增大 max_num_seqs,记录 P99 从线性增长转为指数增长的临界值,把业务 SLA 作为硬上限反推上限,而不是照搬公开的推荐值。
并发与队列配置
并发突增时,如果 vLLM 的 max_num_seqs 与等待队列长度没有限制,请求会在入口处堆积,GPU 看似满载,实际大量时间消耗在调度与 KV Cache 抢占上。成都阿里云代理商在实际运维中遇到过类似情况:把 max_num_seqs 从 32 下调到 8,并设置 max_waiting_requests 为 50,让超出阈值的请求快速失败,P99 反而从 4 秒降到 1.2 秒左右,吞吐没有显著下降。队列上限的本质是保护核心链路,避免雪崩。
动态批处理权衡
动态批处理(Continuous Batching)通过将不同时刻到达的请求拼批提升利用率,但必须限制单次拼接的 token 上限。vLLM 的 max_num_batched_tokens 设置过大,会让短请求等待长请求,首 token 延迟变高;设置过小则拼批效率下降。建议按平均 prompt 长度和 max_tokens 估算,例如将 max_num_batched_tokens 设为 2048 到 4096,避免单批超大 token 拖慢整批。动态批处理并非“开了就完事”,上限参数需要跟着业务请求分布持续调整。
阿里云GPU实例配置建议
如何选GPU实例
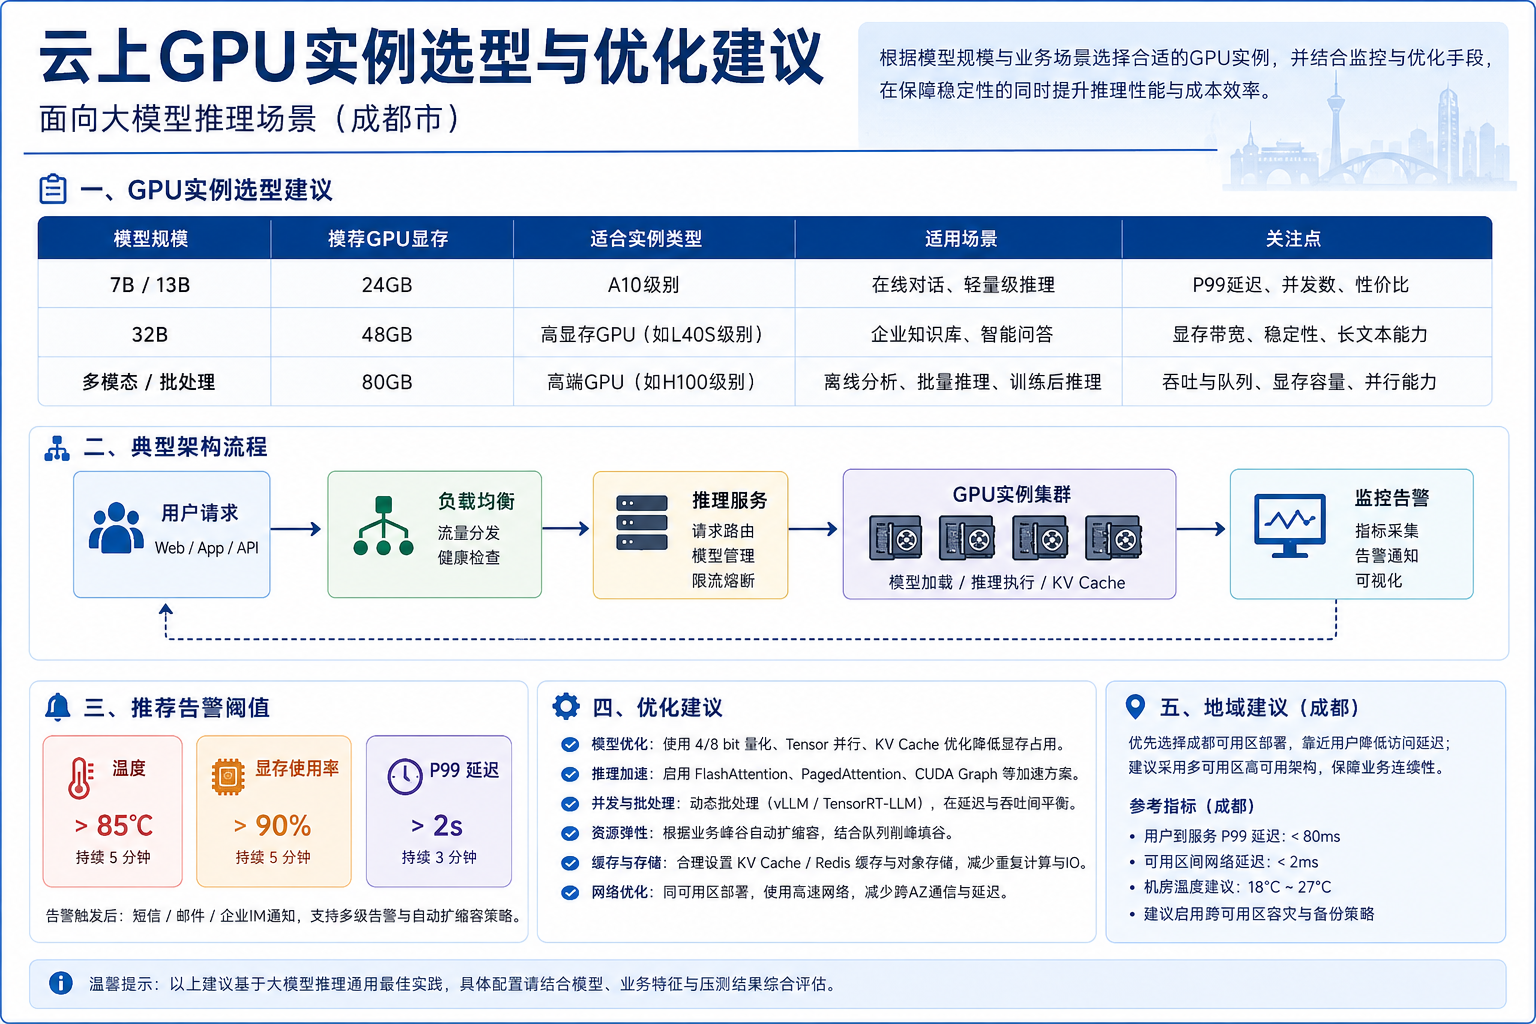
成都阿里云大模型延迟排查时,选型错误经常被忽略。推理是访存密集型,单 token 计算量不大,瓶颈集中在显存带宽和 KV Cache 容量,而不是纸面 FP16 算力。7B/13B 对话模型优先看 24GB 显存的 A10 实例(gn7i),它比老一代 V100 更容易在动态批处理下控制 P99。显存容量决定最大 batch size,带宽决定单 token 生成速度,两者应优先于 TFLOPS。从成都阿里云代理商聚搜云整理的运维案例来看,高算力但显存不变的升级通常不会改善延迟,先估算权重、KV Cache 和中间激活的显存占用,再反推实例规格更可靠。
弹性伸缩应对流量
大模型推理服务潮汐特征明显,固定 GPU 实例数会造成低峰浪费、高峰排队。阿里云弹性伸缩(ESS)建议采用定时与指标伸缩组合:按业务时段预设节点数,如客服系统 9:00-18:00 保持较多节点,夜间缩容;同时以 GPU 利用率或推理队列长度作为动态触发条件。无状态推理节点更适合弹性伸缩,模型需从 OSS/NAS 快速加载,启动时间要计入扩容周期,否则突发流量时新节点还没就绪,延迟已经恶化。
监控与告警设置
GPU 实例监控不能只看 CPU 和内存。应采集利用率、显存使用率、温度与降频事件,阿里云云监控可覆盖一部分,但建议通过 DCGM Exporter 接入 Prometheus,关注 DCGM_FI_DEV_MEM_COPY_UTIL 和 DCGM_FI_DEV_GPU_TEMP。告警按链路分级:对话/生成接口看 P99 延迟,超过 2 秒触发;批处理任务看平均耗时和失败率。显存超过 90% 或温度超过 85°C 要单独告警,降频引发的延迟恶化在业务日志里很难直观看到。
成都企业实战优化案例
成都本地团队在阿里云GPU实例上跑大模型推理时,延迟问题大多集中在批处理策略和显存分配两个环节,而不是单纯算力不足。下面三个场景分别对应在线对话、离线批处理和参数调优的不同侧重点。
客服机器人调优
在线客服机器人对首token延迟敏感,业务SLA通常要求P99小于800ms。初期把max_num_seqs设到32,高峰时GPU利用率显示97%,但P99延迟飙到2.1s。查vLLM日志发现大量请求阻塞在等待队列,动态批处理虽然开了,但max_waiting_sequences没限制。把max_num_seqs降到16、等待队列上限设为8,并让超时请求直接返回失败。调整后P99回到700ms以内,GPU利用率降到82%,但实际有效吞吐反而更平稳。
医疗影像分析优化
医疗影像场景属于离线批处理,对单张延迟不敏感,更关注每小时处理量。成都一家影像AI企业用阿里云GN7实例部署SAM-Med,默认batch size为1,GPU利用率长期不到30%。排查发现KV Cache预分配过高,导致显存碎片化,不敢开大batch。把KV Cache预分配比例从0.8调到0.55,并启用continuous batching,batch size动态上限设为4。调整后单卡吞吐明显提升,P99延迟从约4s增至约6s,仍在可接受范围。
调参前后对比
调参前最大的误区是把GPU利用率当作唯一健康指标。客服场景下利用率97%却延迟高,是因为队列积压让GPU看似满载,实际大量时间在等待新请求填充batch。调参后利用率降到82%,但请求排队时间占比从45%降到12%,P99延迟从2.1s降到0.7s。医疗场景则是另一个方向:适当牺牲单请求延迟换取吞吐,batch size从1调到4后,单位时间处理量提升但P99延迟上升,整体资源成本下降。
如何选择成都阿里云代理商
在完成成都阿里云大模型延迟排查和 GPU 批处理参数调优之后,如果企业仍需通过成都阿里云代理商补充实例或调整架构,选择重点应该从“谁能给更低折扣”转移到“谁能在延迟升高时给出可执行的定位路径”。推理服务的故障窗口往往只有几分钟,代理商的响应能力直接影响业务 SLA。
技术支持能力评估
从成都阿里云代理商聚搜云整理的运维案例来看,大模型推理延迟问题很少靠升配解决,更多依赖对 vLLM、TensorRT-LLM 等框架参数的理解。评估技术支持时可以问:能否解释动态批处理中 max_num_seqs 与显存占用的关系;能否通过 nvidia-smi 和云监控 GPU 温度、降频事件快速定位。只会报配置单的代理商,延迟突发时很难给出可执行的判断。
服务响应与SLA
看代理商承诺的 SLA 时,不要只盯着“可用性 99.9%”这类指标。大模型推理对延迟更敏感,GPU 显存长期高于 90%、温度超过 85°C 导致降频时,需要有人及时处置。建议把“GPU 故障响应时间”和“降频告警处理时限”写入服务要求,比如收到云监控告警后 15 分钟内响应、4 小时内完成节点隔离或迁移。这类条款比笼统的可用性承诺更贴近实际运维。
代理方案怎么选
方案选型要看业务潮汐特征和批处理延迟拐点,而不是只看单价。如果业务存在白天高峰、深夜低峰的潮汐特征,可以要求成都阿里云代理商提供定时伸缩加指标伸缩的组合方案;同时让对方基于实际模型给出不同 batch size 下的吞吐与 P99 延迟测试数据,用来反推实例数量和队列上限。若对方只能给报价单和配置表,后续排队延迟问题大概率还要自行承担。
更多推荐


 9
 0
- 0


 已为社区贡献13条内容

所有评论(0)