
大模型应用延迟排查Token推理实例调优
大模型应用延迟排查全攻略:从Token到推理实例
模型跑通了,demo 很流畅,一上线用户喊“慢”——这是 2025 年以来我们帮多家做 AI 应用的团队做排障时,听得最多的场景。大模型应用延迟排查之所以棘手,是因为延迟不是单一维度的“推理慢”,而是从客户端、网络、网关、推理实例到 Token 生成的整条链路上,任一环节都可能成为瓶颈。不建立全链路的时间线,几乎没法对症下药。
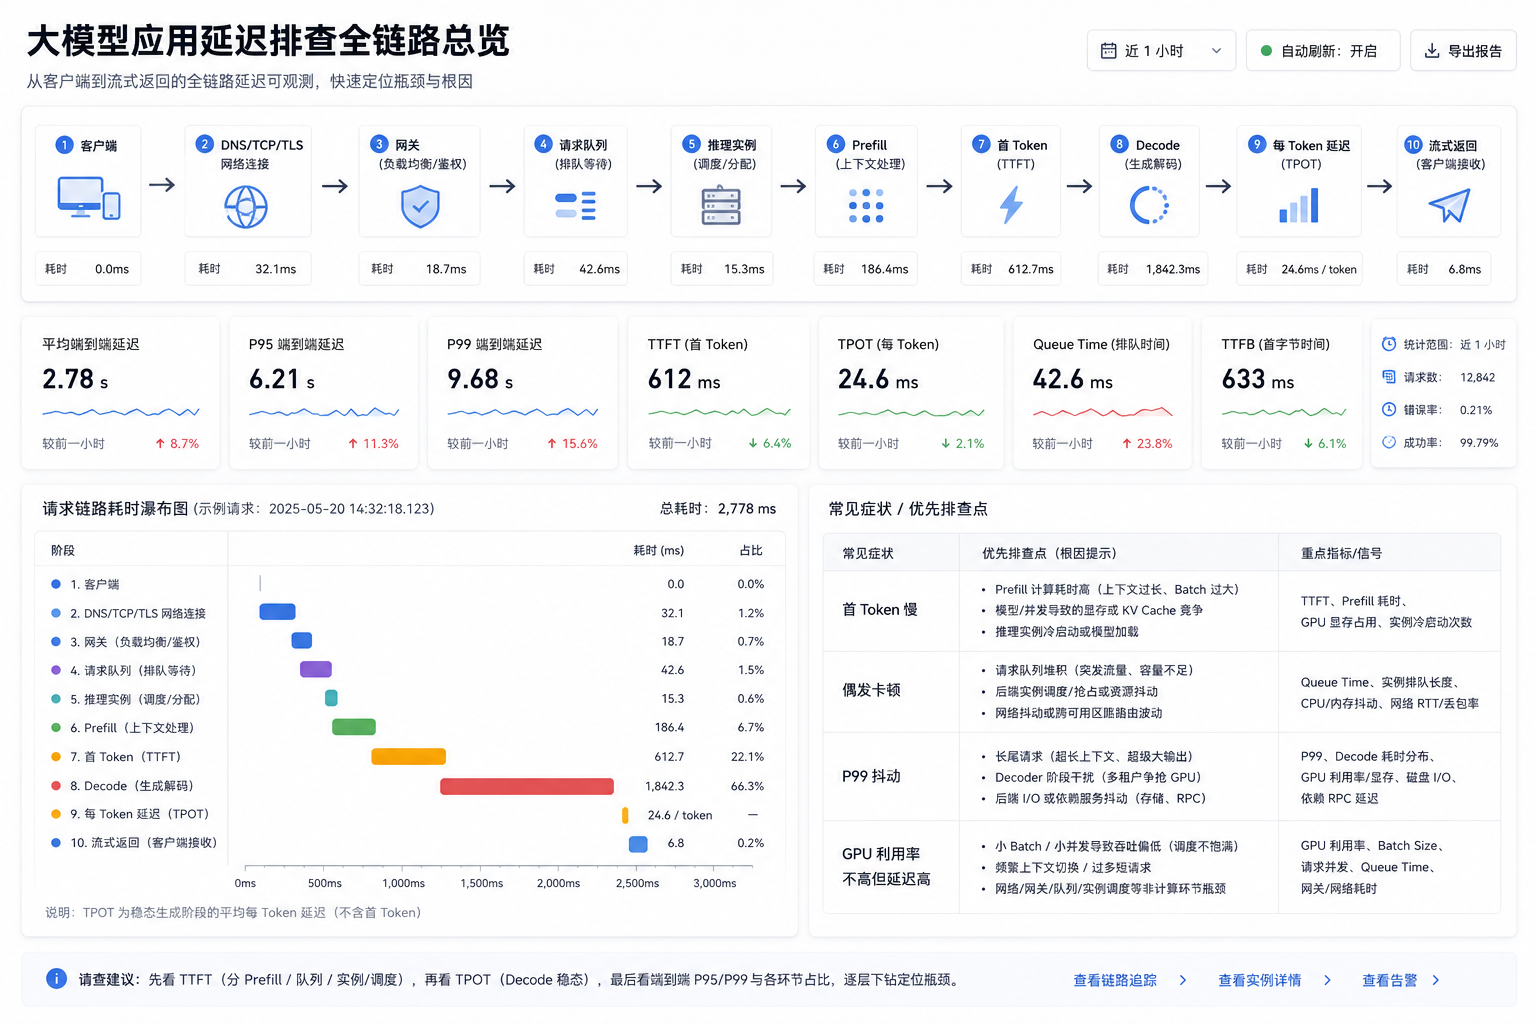
大模型应用延迟飙升的常见症状与影响
为什么 GPU 利用率没满,延迟却突然蹿升?
一个容易被误判的现象是:推理实例的 GPU 利用率看上去并不高,但首 Token 延迟从 800ms 一路涨到 3 秒以上。多数人第一反应是“推理引擎没饱和,问题不在实例”,这恰恰踩进了误区。推理的场景里,GPU 核心算力不是唯一的瓶颈——显存带宽、KV Cache 的命中率和请求排队深度,往往比 SM 占用率更能解释延迟异常。我们遇到过一个案例,团队给问答机器人加长 system prompt 后,TTFT 陡增,GPU 利用率却没明显变化;拆开看才发现是输入 Token 过长导致 prefill 阶段在显存上反复搬运数据,而 KV Cache 又没有命中,整个请求被堵在队列里。
什么环节最容易造成“时好时坏”的 P99 抖动?
看平均延迟没问题,但用户抱怨“偶尔卡一下”——这类 P99 尾部延迟的抖动,排查起来最耗时间。根因常常不在推理框架内部,而在接入层和网络层的隐性排队。比如并发连接数突然从几十跳到几百,HTTP/2 长连接复用的一侧线程配得太小,就会让新建连接在网关端排队;如果同时启用了 SSE 流式输出,后端的逐 Token 推送链路一旦出现某个中间代理的缓冲策略过于保守,也会把输出流切成间歇性的“卡顿块”。2025 年下半年,一个做实时翻译产品的团队就因为这个原因,P99 延迟从 300ms 飙到 2.1s,最终靠抓取链路中的 TTFB 与 Token 间的端到端 gaps 才定位到反向代理层的一个 keepalive 配置。
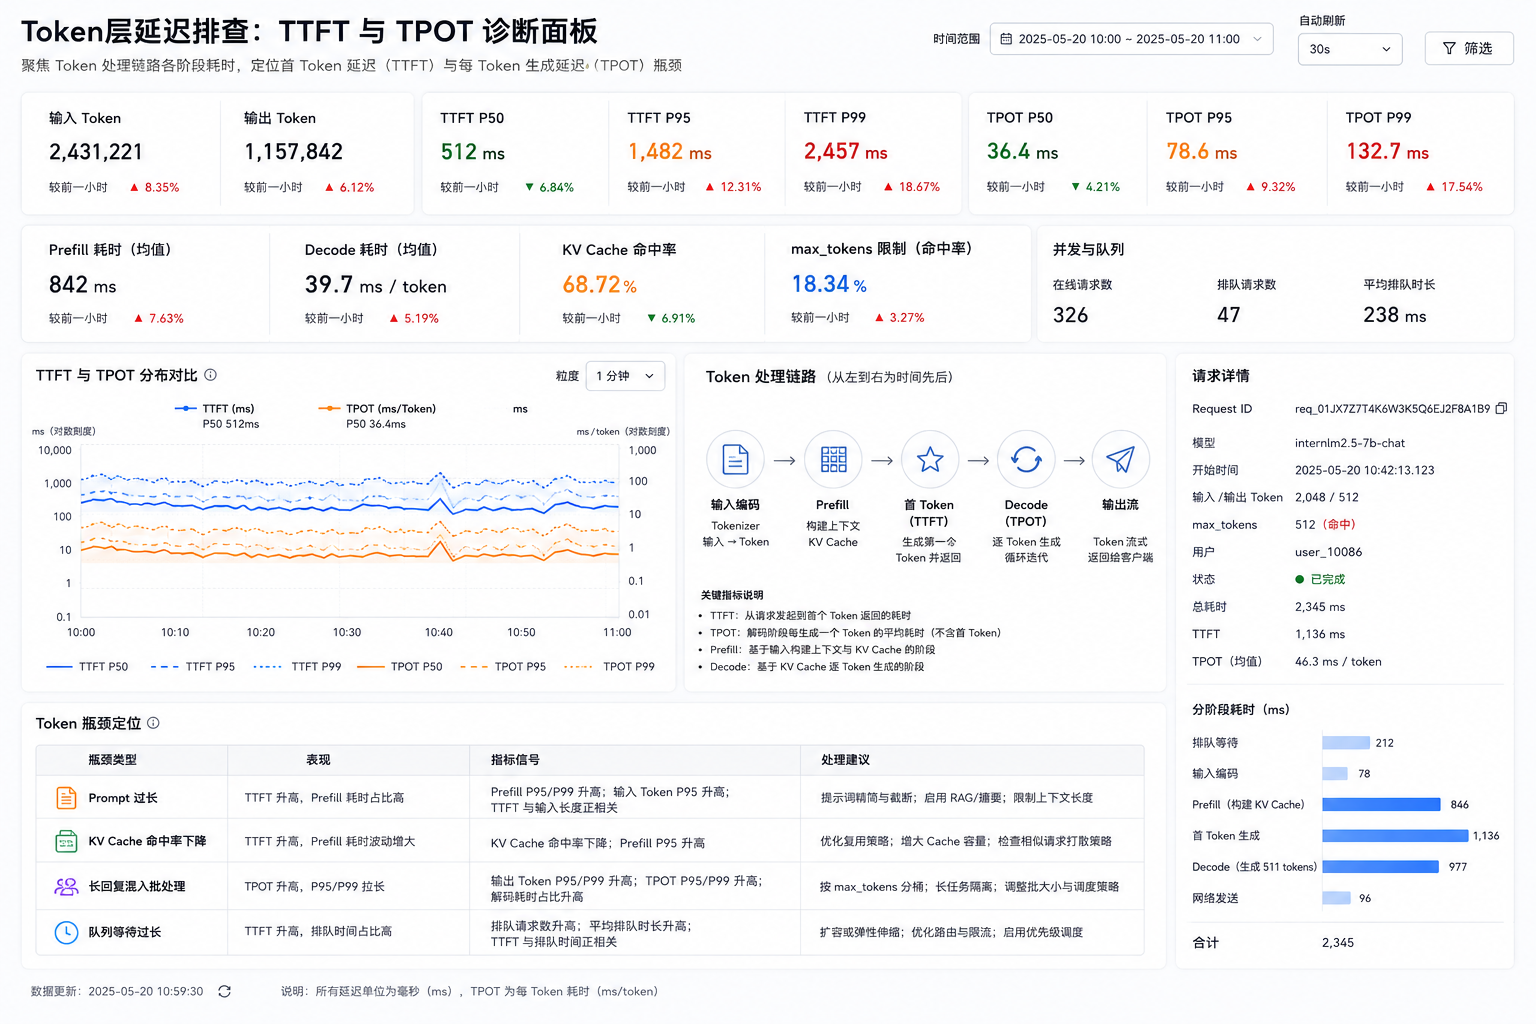
Token层面的延迟排查:从输入到输出
大模型推理的延迟问题很少是一团迷雾,它几乎总能在 Token 处理流程中被精确拆解。在一次完整的推理请求中,用户体感到的“慢”实际上由两个可独立观测的阶段构成:首 Token 延迟(TTFT)和每输出 Token 延迟(TPOT)。TTFT 决定了用户发出请求后多久能看到第一个字符,它主要消耗在预填充(prefill)阶段——模型需要一次性处理全部输入 Token,完成注意力计算并生成首个输出 Token。TPOT 则主导了后续内容“流”出的速度,反映模型逐 Token 自回归生成的效率。很多团队上线初期只监控平均生成速度,却忽略了 TTFT 的陡增——一个电商客服机器人在流量翻倍后,TTFT 从 400ms 飙升至 2.3s,监控显示 GPU 利用率并未打满,真正的原因是长 prompt 请求大量积压,KV Cache 争抢导致 prefill 阶段排起了队。
Token 处理流程是什么
一次典型的大模型调用,Token 会经历从输入编码到输出解码的严格时序。Prefill 阶段一次性消费所有输入 Token,计算出第一个输出 Token,计算量近似与输入长度成正比;随后进入 decode 阶段,每生成一个新 Token 都要基于之前的缓存完成一次前向通行。这意味着,TTFT 的瓶颈常出在输入长度失控或 KV Cache 容量不足引发的频繁驱逐与重计算,而非单纯缺少算力;而 TPOT 更多受显存带宽、批处理并发调度的影响。我们实际测量过一个 13B 参数模型,128 个 Token 生成的 decode 阶段平均每 Token 耗时约 18ms,但混入批量超长请求后,该数值最高可被拖到 120ms 以上,原因就是 shared GPU memory 带宽被争抢,而非计算核心不够用。
如何定位 Token 瓶颈
定位 Token 层面的延迟,建议从 TTFT 和 TPOT 的 P99 值入手,而非均值。其中一个有效手法是在每次推理请求中钉入 Request ID,并在网关、推理引擎侧同步记录 prefill 耗时、队列等待时长、每步 decode 耗时。某实时对话产品发现 P99 TPOT 高达 870ms,而均值仅 42ms,排查后发现动态批处理窗口内偶尔混入生成 2000 Token 的超长回复,挤压了同批次其他短回复的显存带宽,调整 max_tokens 限制并拆分长生成后,P99 降至 160ms。同样,TTFT 毛刺往往与输入长度分布和 KV Cache 命中率高度相关——一旦观察到 TTFT 异常,应先检查是否有大量异常长的 prompt 涌入,或缓存命中率是否突然下跌,这比直接加 GPU 实例更指向根因。
网络层面的延迟排查:传输与连接
网络延迟隐藏在客户端与推理实例之间的每一条链路里——从 DNS 解析、TCP 握手、TLS 协商到首字节到达,任何一个环节的抖动都可能被用户直接感知为“模型反应慢”。尤其当业务上线后流量陡增,原本正常的 TTFB(首字节时间)突然从 30ms 窜上 200ms,监控面板却显示 GPU 使用率不到 50%,这种假象最容易让人误判为推理引擎瓶颈,实际症结往往就在网关或负载均衡的排队策略上。因此,排查大模型应用的延迟,绕不开对传输层和连接层的精细拆解。
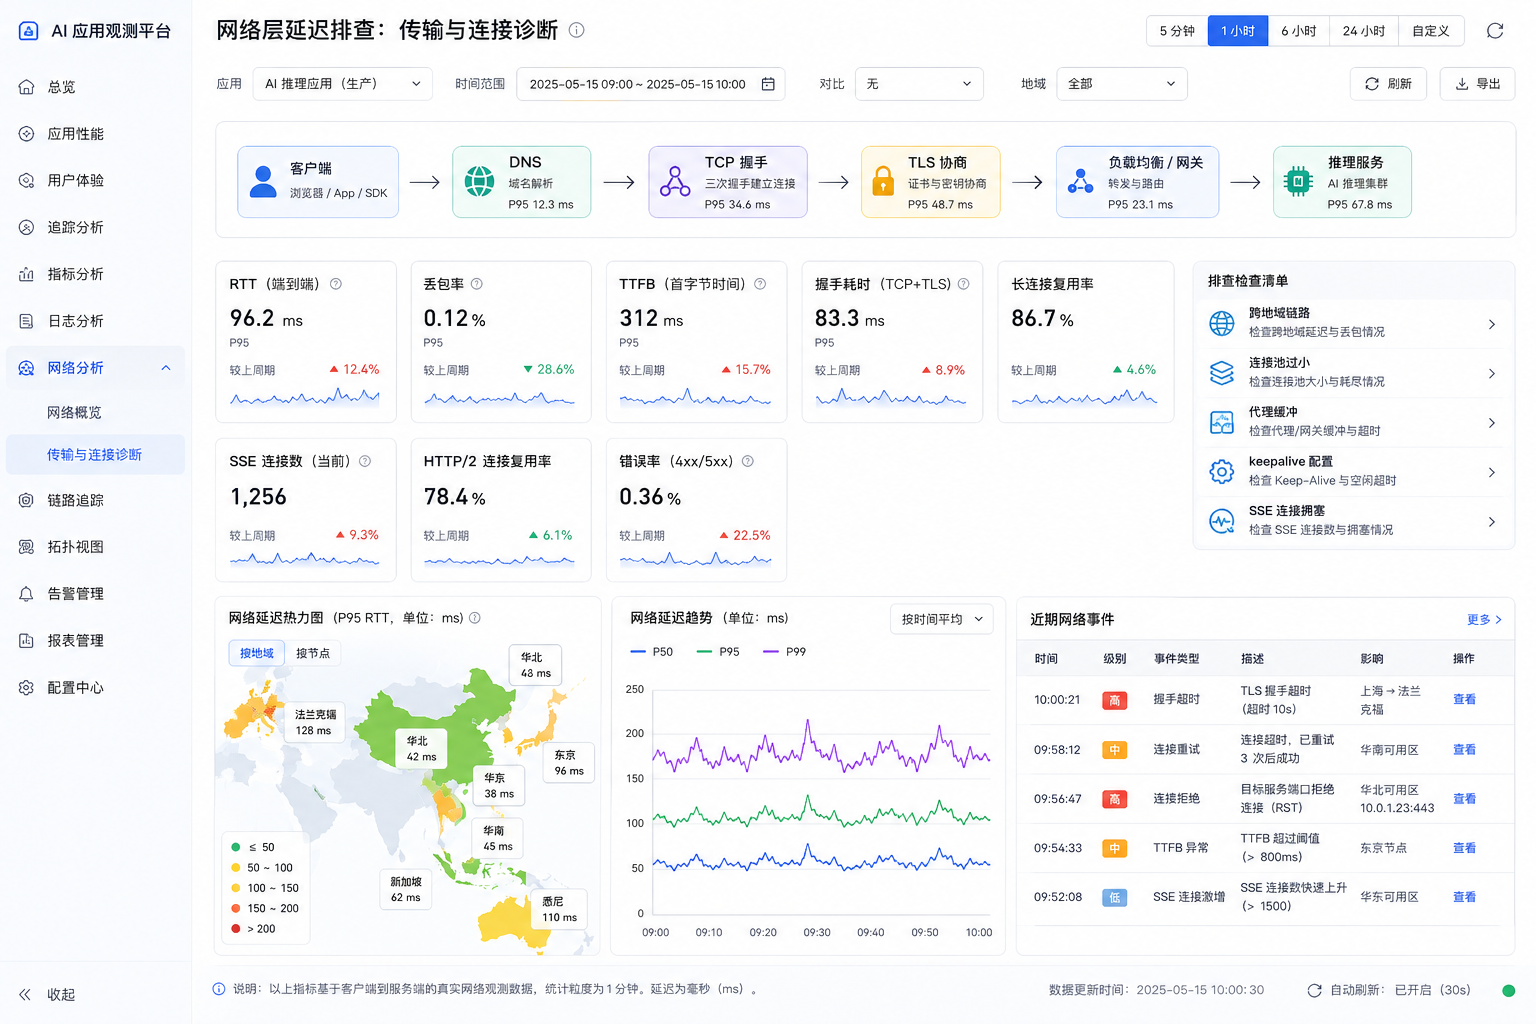
网络延迟如何影响体验
大模型应用大多采用流式输出(SSE 或 WebSocket),用户体感延迟并非以完整响应的到达时间为准,而是先看“第一个 token 什么时候出现”。首 token 延迟(TTFT)每增加 100ms,在交互式场景(如对话或代码补全)中就可能让用户放弃等待。实际案例中,一个部署在单地域 A100 集群的对话应用,由于客户端到服务端跨洲 TLS 握手耗时 180ms,即便模型推理的 TTFT 只有 70ms,用户端首词出现仍要 250ms 以上。更隐蔽的是,高并发下连接池管理不当,会导致 TCP 连接建立反复震荡,P99 延迟瞬间放大数倍,哪怕平均延迟依然正常。
怎么检测网络瓶颈
排查网络瓶颈不能只依赖云厂商提供的控制台均值图,必须同时抓取 RTT、丢包率和连接耗时分布。常用做法是结合 mtr、tcpdump 和链路追踪 ID,把一次推理请求拆分为客户端-网关、网关-推理节点两段甚至三段网络 RTT。例如在压测时注入真实地理分布的流量,一旦发现某云厂商某地域的 P95 握手时间异常上升,就可以通过调整负载策略或 CNAME 切换,将流量引向延迟更低的其他云节点。
推理实例层面的延迟排查:算力与并发
当延迟问题排除了Token层面的原因后,下一个关键排查节点是推理实例本身。一个常被忽略的事实是:GPU利用率高不代表推理快,利用率低也不代表没瓶颈。推理场景的吞吐与延迟,核心制约往往不是计算单元,而是显存带宽和KV Cache。在实践中,我们见过大量案例——监控面板上GPU利用率不到60%,但P99延迟已经飙到8秒以上,原因就卡在显存带宽被打满、请求在队列里堆积。
实例性能指标有哪些
推理实例需要关注三层指标:(1)计算层——GPU SM利用率和Tensor Core占用,但对于自回归解码,这两个值通常不会打满,一般维持在40%-70%就属正常;(2)显存层——显存带宽利用率和KV Cache命中率,这是比核心利用率更直接的性能信号,带宽打到90%以上基本意味着Generation阶段已到上限;(3)排队层——请求在推理引擎侧的等待时间(Queueing Time),连续批次调度(Continuous Batching)模式下,一个长P refill可能会把后面所有请求堵在队列里,导致TTFT异常偏高。
如何调整实例配置
调整配置的前提是先做尾延迟定界。如果P50正常而P99很差,优先检查KV Cache容量和调度策略,不是先加显卡。具体来说:KV Cache余量低于20%就扩大C ache Block数量或换更大显存的实例;Queueing Time占总耗时超过30%,考虑调整max_batch_size或切换到更高效的batching策略,而不是盲目加实例做水平扩展。如果是TPOT拖后腿,显存带宽型和更大HBM容量实例(如H20、A100-80G)比单纯堆计算核心更对症——这个结论已经在2025年下半年多个生产级文生文应用中被反复验证。
全链路排查实战:从现象到根因
延迟排查最忌“盲人摸象”。我们见过一个典型案例:某AI写作工具的API接口在平均延迟只有1.2秒的情况下,运营团队仍被频繁投诉“卡顿”。技术团队最初翻遍了GPU监控都没发现问题,直到接入全链路追踪才发现,P99延迟高达12秒,每300次请求就会有一次超过8秒的长尾超时——而这一现象在平均值的曲线图上被完全抹平了。
问题出在批处理策略上。推理实例默认开启了动态批处理,当并发请求不足时,系统会等待50ms积累更多的请求再一起推理。这个设计在高吞吐场景下确实能提升显存利用率,但代价是特定请求会被“拖”着等凑齐一批。换句话说,这不是模型跑不动,是排队策略在低流量窗口制造了尾部延迟,而GPU利用率正常恰恰是最大的误导信号。
用什么样的工具把链路串起来
排查这类问题,OpenTelemetry(OTel)是目前社区接受度最高的一套标准。它的优势不在于功能多强,而在于能让网关、推理引擎和模型服务说同一种语言。具体做法是:在请求进入网关时注入一个Trace ID,这个ID随请求流向推理实例,实例在prefill和decode阶段分别打Span,记录TTFT和每个Token的生成时间。配合Jaeger或Grafana Tempo做后端存储,能从一次慢请求的火焰图里直观看到:是网关层握手花了300ms,还是prefill阶段因为长Prompt消耗了2秒。
一次完整复盘能教给你的
去年底一个电商推荐系统迁移到大模型后,峰值时段频繁出现5秒以上的超时。排查后发现,问题不在推理实例——实例的显存占用一直稳定在60%。真正的瓶颈是SSE连接数:流式输出需要保持长连接,而负载均衡器默认配置下,当并发SSE连接超过800个时,新连接建立的成功率骤降到70%。TCP握手的重试叠加本身就有800ms的RTO(重传超时),用户端的体感就是“有时秒回,有时白屏等半天”。解决方案是降本向的——不急着加GPU,先把网关层的连接复用策略从HTTP/1.1升级到HTTP/2多路复用,再调整SSE连接的keepalive间隔。改完后的P99录得下降62%,而算力成本一分没加。这个案例的价值在于,它验证了一件事:延迟排查的终点,往往是那些你以为是“基础设施”所以从不怀疑的环节。
延迟优化决策:提升体验的最终方案
走到全链路排查这一步,通常已经能定位到延迟的具体瓶颈层。但知道问题在哪和知道怎么修,中间还隔着一层判断力。实际项目中,我们看到不少团队在“优化”上犯同一个错:把增加算力当作唯一解。某个做AI客服的团队,首Token延迟P99接近3秒,第一反应是升级GPU实例。排查后发现瓶颈根本不在推理引擎——是网关层在流量峰值时段TLS握手占比过高,因为没开启会话复用,每次新连接都要完整握手。切换到长连接方案后,同等算力下P99压到了800毫秒以内。
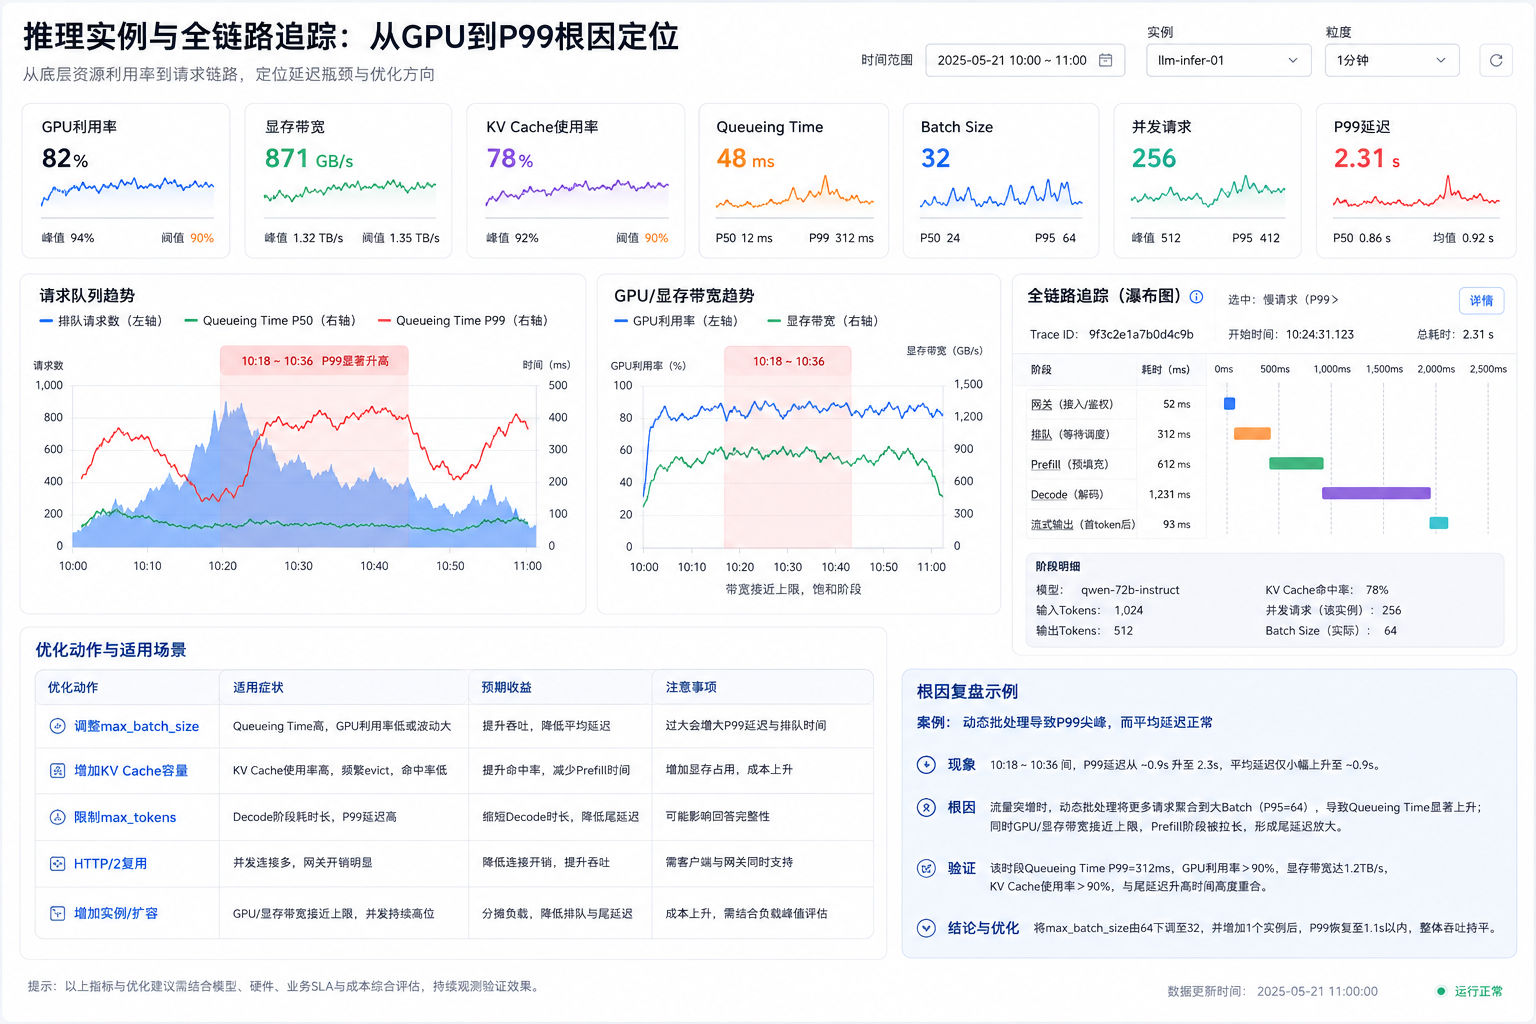
优化措施怎么选
优先看P99/P95而非平均值,这是决策的起点。尾部延迟直接对应极端用户体验,而大部分优化动作都应该瞄准这里。接着是分层比对基线数据:若TTFT占比过高,先查prompt预填充时长和请求排队情况,调整KV Cache策略或批处理上限往往比加卡有效;若TPOT是短板,显存带宽和并发批处理配置才值得动;若网络RTT异常,可能该换个地域节点或切CDN加速回源链路,不关推理实例的事。排序错了,钱就花在不对的地方。
如何持续监控与预警
延迟优化不是一次性工程。建议为每个请求绑定链路ID,用OpenTelemetry这类工具把客户端耗时、网关转发、推理排队、TTFT、TPOT全部打标串联。告警阈值直接绑在P99或P95上,别用平均延迟自欺欺人。我们见过一个案例:平均响应时间稳定在600毫秒以内,系统无告警,但P99已飙到4秒以上,只有少量用户投诉“时好时坏”。脉冲式流量和长文本请求常造成这种隐性恶化。持续监控的意义不在发现问题,而在避免体感崩盘后才被动响应。
更多推荐


 12
 0
- 0


 已为社区贡献13条内容

所有评论(0)