


- @Lenhart001


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Filebeat采集日志kafka topic存起来日志->logstash去kafka获取日志,进行格式转换->elasticsearch->kibana。

依次进行网段分配,分别是10.1.1.0、10.1.2.0、10.2.3.0、10.2.4.0、10.3.5.0,以及11.1.1.0、11.1.2.0、11.1.3.0、11.1.4.0、11.1.5.0,一共10个网段,子网掩码均是255.255.255.0。通过虚拟局域网(Virtual LAN),可以把一个较大的局域网分割成一些较小的、与地理位置无关的逻辑上的VLAN,每个VLAN都是一个
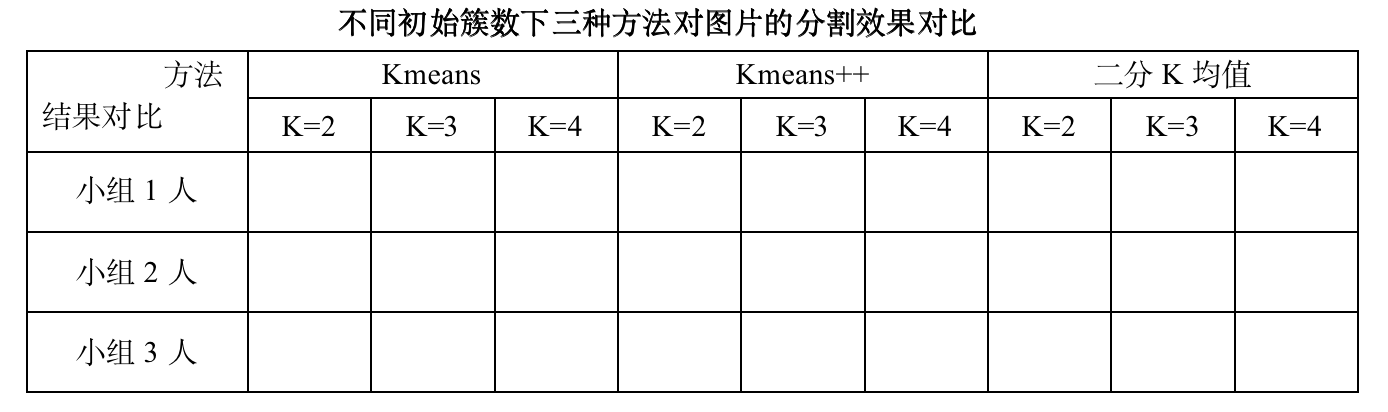
2、构建聚类模型可以采用Kmeans及GMM,并训练。4、查看聚类中心或混合成分参数,分析并对比聚类效果。i.即聚类的各类别是否反应其真实所属。【 救救孩子,不会做 π _ π 】3.训练分类模型并预测居民收入。2.进行主成分分析(PCA)

将该高校的地理位置以地图的形式展示。将该高校近几年计算机相关专业的考研(或高考)录取成绩、人数信息,专业师资队伍,考试科目及内容等等以合适的柱状图、折线图、饼图等方式表示出来,图表能够清晰得呈现不同数据的变化,使得观察图表的人能够迅速得获取信息。录取成绩、人数信息、专业师资队伍柱状图、折线图、饼图对个人感兴趣的导师、研究方向等多属性、多维度、多关系数据选用关系、词云等可视化方法,使数据清晰有效地表
【数据结构】实验六:图论
树和二叉树实验分享
(详细描述数据集:如特征属性名称及意义、记录数等)(写出项目中涉及的主要算法原理及模型评价方法)
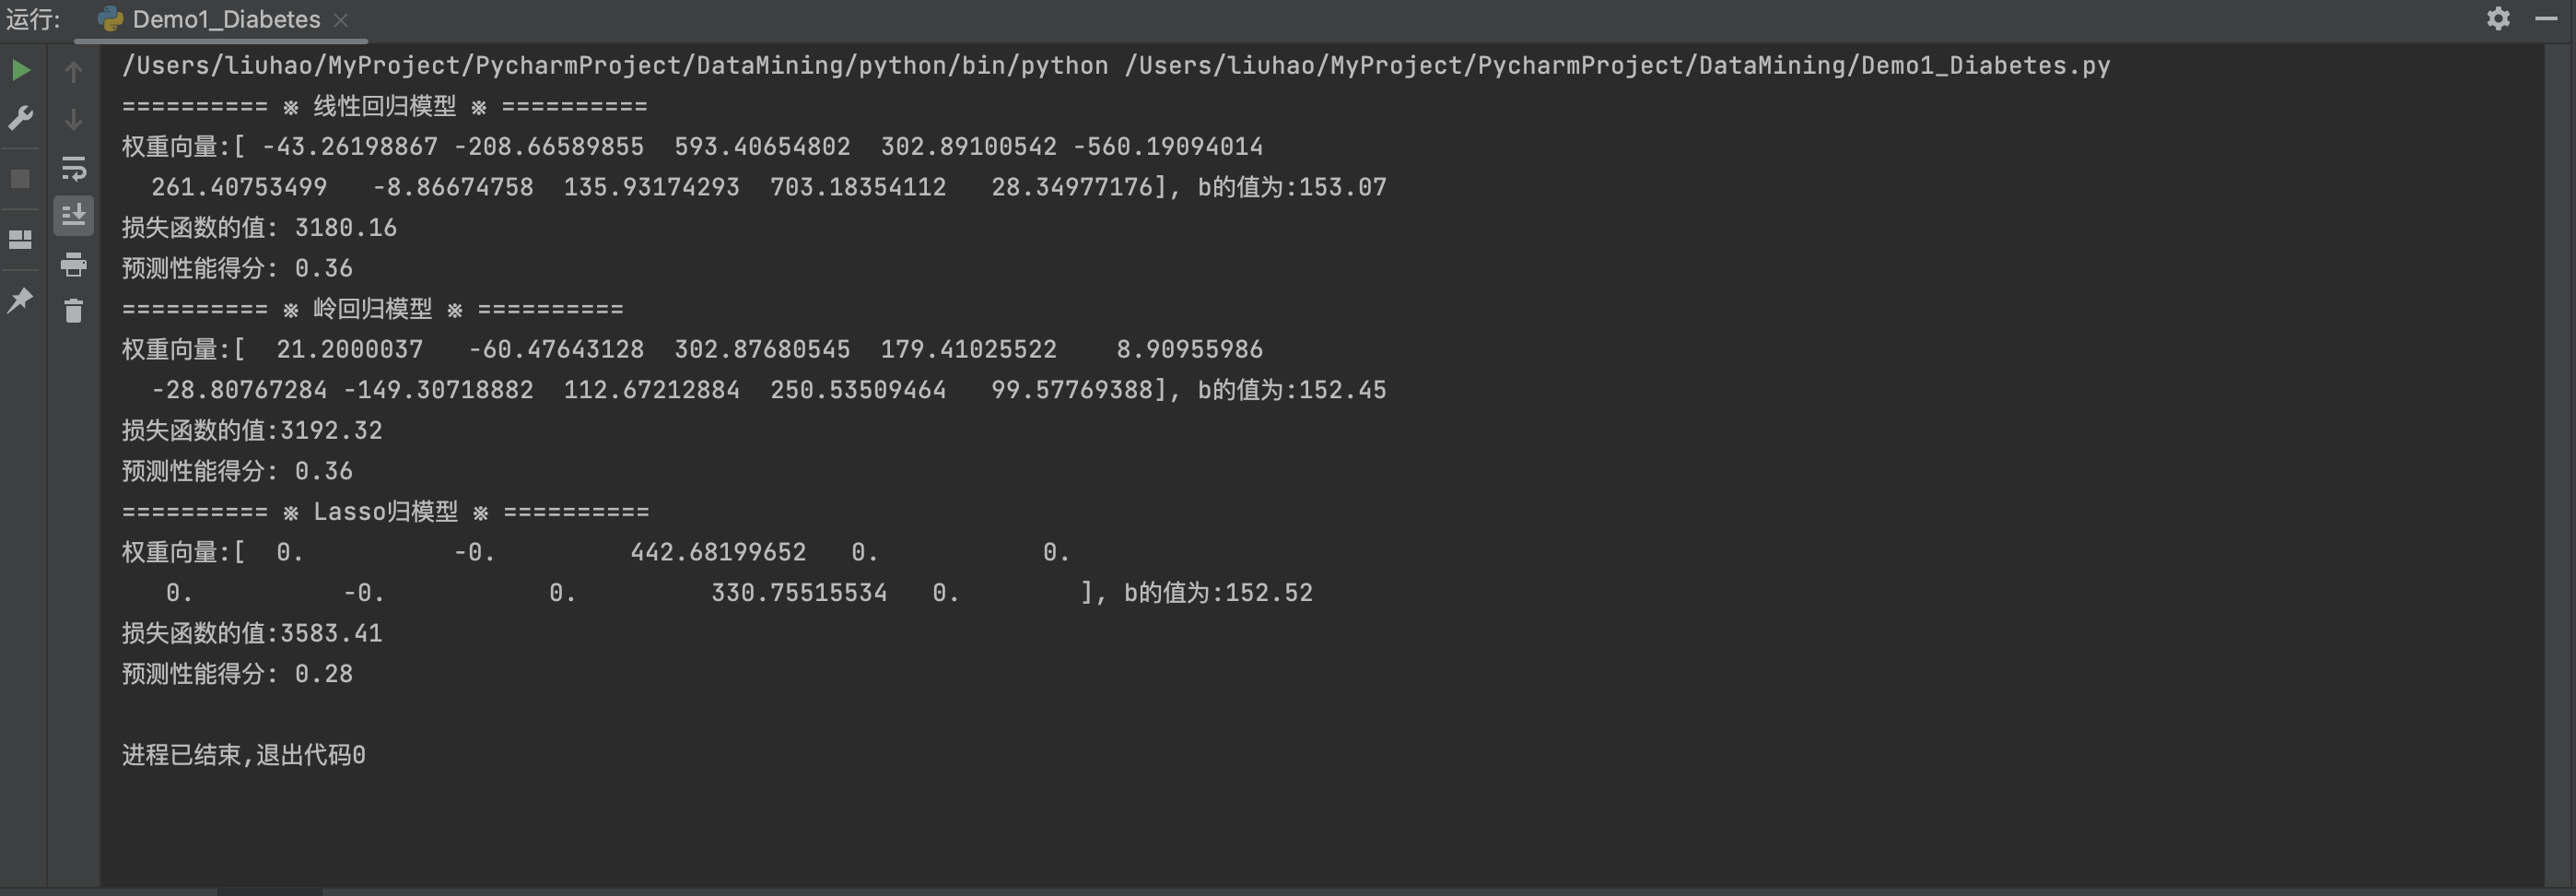
Apriori算法的基本思想是利用频繁项集的性质,即如果一个项集是频繁的,那么它的所有子集也是频繁的。该算法从单个项集开始,逐渐生成更大的项集,直到不能再生成频繁项集为止。算法采用逐层扫描的方法,通过连接步骤生成候选项集,然后通过剪枝步骤排除非频繁项集,最终得到频繁项集。生成候选项集: 初始阶段,生成所有单个项的候选项集。扫描数据集: 统计候选项集在数据集中的支持度(出现次数)。剪枝: 剪枝步骤通
【Mac】Mac键盘快捷键大全
主要内容项目框架数据源解析统计推荐模块基于LFM的离线推荐模块基于自定义模型的实时推荐模块其他形式的离线相似推荐模块基于内容的模块推荐基于物品的协同过滤推荐模块。
