登录社区云,与社区用户共同成长
邀请您加入社区
这部分是预训练,目的是让 AI 简单学会基础语法,能够续写语料。1.0 开始的开始这个项目的起源在于斯坦福的 AI 神课 CS336。个人认为这门课的作业部分教育指导意义远大于讲课视频,Transformer、优化器等等等等都是要亲手实现才能理解,看视频、看blog、单纯调用 torch.nn.functional 库中的函数与类永远无法弥补此点。
本项目旨在从零搭建一个基于 GPT-2 Medium 衍生架构的多模态大模型,使其至少支持文本、图像两种模态输入,同时尽可能减少对Pytorch封装库的直接调用,在此中熟练掌握基础的知识、模型的预训练微调等等处理技术和对多模态技术的了解。
大家好,我是林焱。过去这几年,我一直扎根在电商业务自动化架构研发的最前线。看着无数团队从单机单店的“草莽时代”,一路狂奔,走向拼多多、TEMU、TikTok Shop 的全域矩阵铺货。在这个过程中,大家在享受机器替人带来的巨大效率红利时。也几乎都经历过极其惨痛的系统性崩溃与重构。刚开始拥抱自动化时,业务部门的诉求往往非常简单。找个懂点技术的运营人员,用影刀 RPA 拖拽几个“点击”和“输入”的控件
安全锥作为临时交通管控和施工区域的核心警示设施,其自动化识别对于智能交通、自动驾驶及施工安全管理具有重要意义。本研究基于YOLO26目标检测算法,构建了一个针对安全锥的单类别检测系统,数据集包含训练集5960张、验证集341张、测试集170张,共计6471张图像。训练过程中,模型在训练集上表现出损失函数的稳定下降,但在验证集上的关键评估指标表现不佳。本研究所使用的安全锥检测数据集共包含6471数据
在许多实际应用中,传统算法的高效性与深度学习的强大表征能力相结合,形成了优势互补的解决方案。深度学习的兴起标志着图像处理技术进入了新的发展阶段。同时,与增强现实、虚拟现实、元宇宙等新兴技术的结合,将为图像处理开辟更广阔的应用场景,推动数字世界与物理世界的深度融合。早期,图像处理主要依赖于手工设计的特征提取器和基于数学模型的方法,这些方法虽然在特定任务上表现良好,但往往缺乏通用性和鲁棒性。随着计算能
任务:多分类问题(例如,将图像分为猫、狗、鸟三类)。模型:Softmax回归(或称多项逻辑回归)。输入:一个样本的特征向量x。输出:该样本属于每个类别的概率。真实标签:通常使用one-hot 编码。例如,如果真实类别是“狗”(第二类),那么真实标签向量y模型估计:模型会输出一个概率分布ŷ例如,模型可能输出ŷ我们的目标是让模型的输出ŷ尽可能地接近真实标签y。
协方差矩阵是机器学习中重要的数学工具,能够描述多维数据特征间的线性关系。本文系统梳理了其在AI领域的核心应用:作为主成分分析(PCA)的基石实现特征降维;在数据预处理中用于特征选择和数据白化;在异常检测中结合多元高斯分布;以及在深度学习中的创新应用,如协方差池化和模型正则化。文章还提供了Python实战代码,展示如何计算协方差矩阵并实现PCA降维。随着AI发展,协方差矩阵正从外部工具内化为模型的一
函数输入要求输出维度支持广播使用场景灵活灵活✅通用矩阵乘法torch.mm两个2D张量2D❌严格矩阵乘法torch.mv2D矩阵 × 1D向量1D❌矩阵向量乘法。
协同过滤:基于相似性,适合小规模数据,但冷启动问题明显。矩阵分解:通过 ALS 等算法高效处理稀疏数据,PySpark 实现可扩展至大数据。实际应用:在电商或流媒体中,结合两者(如混合推荐)可提升精度。PySpark 代码可直接运行,建议使用分布式集群处理真实数据。通过此实现,您可快速构建推荐系统。如有具体数据或问题,欢迎提供细节进一步优化!
加一句all_features = all_features * 1 #把ture/false转换为1/0。values后面加个.astype(float)就行,三个都加一下。
首先我用gpt5查了梯度的含义,梯度在这里可以指代为一个函数或者曲线上升最快的方向,比如一个曲线在上升,利用高中的知识,x轴偏移量非常小的情况下,y轴偏移量除以x轴偏移量应该可以用来当作导数也就是上升的趋势,那么梯度就是正好和上升的趋势的指向的向量成90度角分布的那个向量,也就是可以代表上升最快的那个趋势向量,如果想要延缓上升的趋势,那么我们就可以用梯度向量的正相反的趋势向量去发展这个函数,这就是
是 PyTorch 中特有的方法,NumPy 中没有直接对应的方法。只在pytorch中有,numpy没有此操作,是transpose。numpy和pytorch都有此操作,改变数组的。但是view 要求张量在内存中是连续的。参数,可以精确控制每个轴的新位置。对于 N 维数组,如果不指定。可以任意重新排列所有轴。会反转所有轴的顺序。
2. **业务场景差异**:不同业务场景关注的指标不同。3. **召回率(Recall/Sensitivity)**:TP/(TP+FN),实际为正类的样本中被正确预测的比例。1. **准确率(Accuracy)**:(TP+TN)/(TP+TN+FP+FN),衡量模型整体预测正确率。4. **特异度(Specificity)**:TN/(TN+FP),实际为负类的样本中被正确预测的比例。2. *
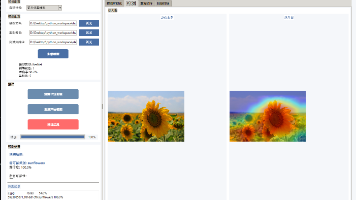
本文介绍了一款多功能图像分类模型可视化软件,具备以下核心功能:支持主流深度学习模型一键加载,提供智能预测与Grad-CAM热力图可视化;包含专业级模型评估工具,可生成混淆矩阵和详细性能报告;提供现代化UI设计,包含三套主题切换。软件适用于学生、科研人员及AI开发者,可用于教学演示、算法调试和项目开发。技术亮点包括智能热力图生成、多线程处理和专业性能评估工具,支持批量预测与结果导出,为深度学习研究提
基于python音乐推荐系统 用户画像的音乐推荐系统 基于用户协同过滤推荐算法 SVD矩阵分解 Last.fm Dataset 歌曲数据集 大数据 ✅
本文介绍了一个多模态社交媒体评论智能分析系统的设计与实现,该系统整合了NLP、CV和机器学习技术,用于分析城市公园的用户生成内容。系统处理了20,776条评论和91,831张图片,构建了包含10个一级维度、33个二级维度的标签体系。关键技术包括:视觉大模型图像描述生成、BERTopic主题建模、多标签分类、CLIP图文一致性分析等。实验结果显示68.2%的评论为积极评价,并识别出各类公园特征相关性
基于用户画像的音乐推荐系统 基于用户协同过滤推荐算法 SVD矩阵分解 Last.fm Dataset 歌曲数据集 大数据 毕业设计✅
《Kubernetes时代测试工程的范式迁移与创新实践》摘要:随着95%企业采用Kubernetes,测试面临动态环境四维挑战:1)37%测试失败源于Pod漂移;2)60%缺陷定位耗时在日志追溯。本文提出分层解决方案:容器级安全验证(Trivy/Falco)、编排层金丝雀测试框架、GitOps持续验证流水线(日均2000+次执行),以及混沌工程实践(MTTR降低至89秒)。创新性引入智能测试预言系
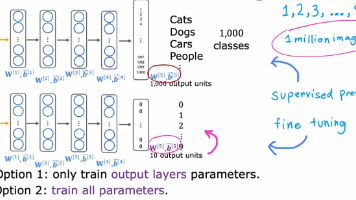
本文介绍了三种机器学习关键技术:数据增强、迁移学习和混淆矩阵。数据增强通过变换原始数据生成新样本,列举了图像、文本等不同数据的增强方法。迁移学习利用预训练模型进行微调,包含冻结参数和全参数训练两种方式。混淆矩阵用于评估分类模型性能,详细解释了TP、FP等核心概念及准确率、召回率等关键指标,特别强调了其在数据不平衡问题中的应用价值。文中还配有相关示意图辅助理解这些技术概念。
sklearn 的 LinearRegression 底层用 scipy.linalg.lstsq,它本质上就是在求。(Moore-Penrose pseudoinverse),记作。当局矩阵不可逆时,可以通过QR 分解和 SVD 分解来算伪逆。
本文提出了一套基于NeoLoad的微服务压测解决方案。方案针对微服务架构下拓扑复杂、链路追踪困难等痛点,采用图形化API流量录制和智能事务链建模技术。实施框架包含场景建模、环境构建、脚本开发、执行监控四个阶段,支持动态参数化和混沌工程注入。关键技术包括全链路事务建模和故障注入配置,通过SLA监控点实现端到端性能检测。结果分析采用黄金指标矩阵和四象限法,有效识别数据库锁等待、线程池配置等关键瓶颈。该
摘要:本文解析云测试环境成本构成,资源闲置损耗占比45%,流量传输成本30%,超额配置浪费25%。提出三大优化策略:Spot实例调度(节省60-90%)、数据层优化(DynamoDB/S3/RDS方案节省30-80%)及成本监控体系搭建。以某电商案例展示优化后成本降低64%,资源利用率提升112%。未来将整合混沌工程、AI预测和碳足迹监控实现持续优化。(150字)
本文介绍了一个基于用户画像和协同过滤算法的音乐推荐系统。系统采用Python3开发,使用Django框架连接前后端,数据存储在MySQL/sqlite3数据库中。通过结合基于用户的协同过滤算法和用户画像分析,系统能更精准地为用户推荐音乐。主要功能包括:音乐播放、喜好标记(喜欢/不喜欢/收藏)、个性化推荐列表生成等。系统利用公开音乐数据集,采用SVD矩阵分解分析用户评分,预测潜在喜好。该推荐系统旨在
(2)模型训练:从mysql数据库中读取评分数据通过spark构建模型后填充数据进行模型训练,模型训练后可以保存模型到本地,当有新数据时再重新训练,这个过程可以用采用本地启动spark进行运算也可以将任务提交到spark集群上运算(前提时已搭建好spark集群)(1)数据清洗:过滤重复的数据,比如同个书编的书籍信息,评分为0分的不合理信息,将清洗后的数据保存到mysql数据库中。(3)数据推荐:为
订单系统重构:从单体到微服务的演进与挑战 随着业务量激增,传统的单体订单系统面临性能瓶颈和开发效率低下等问题。本文探讨如何通过微服务化重构订单系统,解决分布式环境下的数据一致性和事务管理难题。 核心要点: 服务拆分:基于领域驱动设计(DDD)划分订单、库存、营销等服务边界,实现高内聚低耦合。 通讯优化:采用Feign和gRPC实现高性能服务间调用,结合Nacos实现动态服务发现与负载均衡。 数据一