登录社区云,与社区用户共同成长
邀请您加入社区
深度学习模型在边缘设备(手机、嵌入式、物联网)上的部署面临存储、内存和功耗的严峻挑战。模型轻量化技术通过减少参数量和计算量,在尽量不损失精度的前提下压缩模型。本课系统讲解三种主流轻量化方法:量化(将浮点权重转换为低比特整数,如INT8)、剪枝(移除冗余连接或通道)、知识蒸馏(用大模型指导小模型学习)。深入剖析每种技术的原理、优缺点及适用场景。使用TensorFlow Model Optimizat
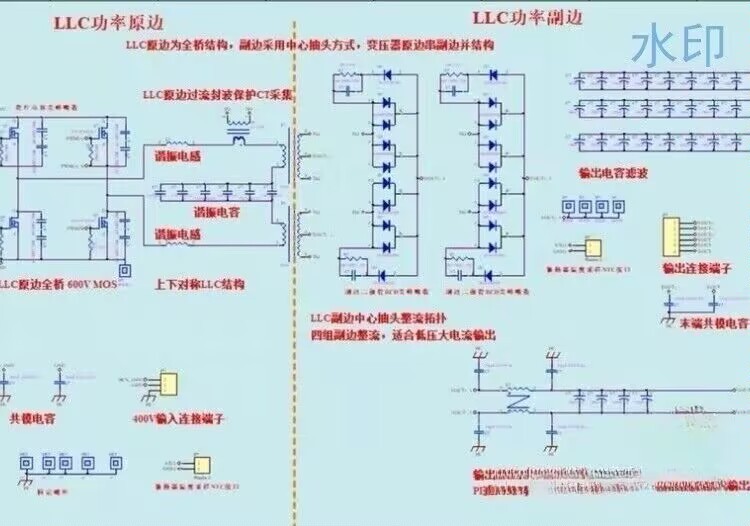
第一次跑闭环时,DSP的CLA协处理器突然发疯,把PWM占空比锁死在98%。这玩意儿真是把DSP和MCU的优势结合得挺到位,特别是做数字电源控制时,12位ADC和PWM死区控制玩起来贼溜。最终算出来的Lr=35uH,Cr=22nF时,实测波形终于能看到漂亮的ZVS了。先看主拓扑硬件计算这块。有回把DBRED设成0,结果下管直通瞬间炸出烟花,示波器抓到的电流尖峰高达50A,直接给电流互感器干怀孕了。
首先不设置任何限制,生成一棵“枝叶茂密的满树”,然后从最底层的叶节点开始,向上遍历每一个非叶节点,判断如果把这个节点替换成叶节点,模型在验证集上的性能是否会提升(或者保持不变)。具体来说,就是在每个节点准备分裂之前,先进行判断:如果这次分裂不能提升模型的性能,或者已经满足了预先设定的停止条件,那么就直接把当前节点标记为叶节点,不再继续往下分裂。④在构建决策树的过程中,加入预剪枝的停止条件,比如最大
27届大模型岗面试准备(十一):模型蒸馏与稀疏化——从软标签到结构化剪枝的压缩全景
通过针对性剪枝,可将回溯算法时间复杂度从 $O(2^n)$ 降至 $O(n!)$ 或更低,显著提升求解效率。实际应用中需结合问题特征设计剪枝条件,这是回溯算法的核心优化手段。回溯算法通过深度优先搜索遍历解空间树,当发现当前路径不满足约束条件时立即回溯,避免无效搜索。:在 $n \times n$ 棋盘放置 $n$ 个皇后,使其互不攻击(任意两皇后不同行、列、对角线)。:给定正整数数组 $nums$
今天这篇内容,我不打算堆砌大模型的理论知识——那些教科书上都能查到的原理,对想转行、入门的朋友来说,远不如"怎么选方向"“怎么避坑"实用。作为一个从后端转大模型、带过百余名学员的训练营主理人,我想站在"过来人的实战视角”,跟你聊点真东西:
大模型-模型压缩:量化、剪枝、蒸馏、二值化 (3)一、模型压缩概述1.模型压缩的必要性2.模型压缩的目标二、量化1.量化原理2.量化方法分类3.量化的优势与局限三、剪枝1.剪枝原理2.剪枝方法分类3.剪枝的优势与局限四、蒸馏1.蒸馏原理2.蒸馏方法流程3.蒸馏的优势与局限五、二值化1.二值化原理2.二值化方法应用3.二值化的优缺点。
大模型-模型压缩:量化、剪枝、蒸馏、二值化 (3)1.模型压缩的必要性。3.量化的优势与局限。3.剪枝的优势与局限。3.蒸馏的优势与局限。
量化、剪枝和知识蒸馏是模型压缩的核心支柱,工程落地需结合数学原理和实践经验。通过分步实施、工具集成和持续微调,您可以在资源受限环境中部署高效模型。未来方向包括自动化压缩(AutoML)和硬件原生支持。建议从小规模实验开始,逐步扩展到复杂应用,确保可靠性和性能提升。
7.GroupChatAutoRouter 群聊自动路由器Agent。大模型-Qwen-Agent框架:系列Agent功能介绍 (1)8.GroupChatCreator 群聊创建助手Agent。2.BasicAgent——Agent基类的测试类。13.TIRMathAgent 数学公式代理。11.ArticleAgent 文章续写器。20.GenKeyword 关键词生成器。6.GroupCha
自动发现人工难以设计的复杂剪枝规则,例如识别: $$ \exists i,j \quad s.t. \quad \frac{\partial^2 f}{\partial x_i \partial x_j} > \delta $$ 的非凸区域。$$\mathcal{D} = { (X_i, y_i) \mid y_i = \mathbb{I}(\text{路径 } i \text{ 无解}) }$$
决策树是机器学习中经典的分类与回归模型,凭借直观的逻辑结构和易解释性,在实际场景中应用广泛。但决策树天生存在过拟合风险—— 随着树的深度增加、分支增多,模型会过度学习训练数据中的细节甚至噪声,导致在新数据上的泛化性能下降。剪枝作为解决这一问题的核心手段,通过合理削减决策树的冗余分支,在降低模型复杂度的同时,实现泛化能力的提升。本文将系统拆解剪枝的核心概念与两种主流策略(预剪枝、后剪枝),提供可直接
剪枝技术是决策树泛化能力的“关键推手”:预剪枝像“提前刹车”,用简单规则从源头控制复杂度;后剪枝像“精修优化”,用验证集和代价函数精准移除冗余分支。两者无绝对优劣,需根据数据规模、计算资源和精度需求选择。通过本文的底层代码实现,你可以清晰看到剪枝的核心逻辑——无需依赖 sklearn 等高级库,从信息增益计算、树构建到剪枝判断,每一步都可追溯。实际应用中,可基于本文代码扩展:比如添加Gini系数支
提示:机器学习实验–剪枝。
模型剪枝是一种通过移除神经网络中冗余参数来减小模型规模、提升推理效率的技术。它分为结构化剪枝(移除整个通道/层)和非结构化剪枝(随机去除权重),常用方法包括阈值剪枝、梯度驱动剪枝等。剪枝能显著降低参数量(50-90%)和计算开销,但可能带来精度损失,需配合微调恢复性能。实现时需权衡剪枝粒度与硬件支持,PyTorch等框架提供了相关工具。该技术特别适合边缘设备部署,在保持模型性能的同时优化资源占用。
想象一下,一个学生为了通过考试,不是理解概念,而是死记硬背了所有练习题和答案。当遇到新问题时,他就不知所措了。这就是过拟合!在决策树中,过拟合表现为:树过于复杂,分支过多完美拟合训练数据,但在测试数据上表现差捕捉了噪声而不是规律。
本次实验完整实现了贷款审批决策树的预剪枝流程,明确了预剪枝参数的作用与调优方法,通过对比验证了预剪枝对模型结构的优化效果。实验结果表明,预剪枝在小样本场景下可保持分类准确率,同时为大样本场景提供抗过拟合能力,是决策树工程落地的关键步骤。
在现代机器学习8*一、什么是剪枝模型**剪枝模8*二、剪枝模型的设计原理**剪枝8*三、剪枝模型的实现步骤**
识别并移除模型中冗余或贡献低的参数 / 结构,同时保持性能基本不变。② 注意力头剪枝 (Attention Head Pruning)在不显著损失模型性能的前提下,实现模型的轻量化与高效化。③通道剪枝 (Channel Pruning)①权重剪枝 (Weight Pruning)④层剪枝 (Layer Pruning)
在上一篇实验中,我们基于决策树构建了贷款审批预测模型,虽然在测试集上取得了 100% 的准确率,但这可能是由于数据集规模较小导致的 “过拟合” 风险。决策树算法天生容易过拟合:未限制的决策树会不断分裂节点,直到每个叶子节点仅包含单一类别样本,导致模型在训练数据上表现极好,但面对新数据时泛化能力差。剪枝是解决决策树过拟合的核心手段,通过移除决策树中 “冗余” 的分支,降低模型复杂度,从而提升泛化能力
为了实现上述目标,存在两个非同寻常的挑战:哪些激活函数应该被移除,以及在移除后如何用更少的剩余激活函数恢复精度。为了解决这些问题,建立在 SOTA 高效 DNN 之上的 DepthShrinker 集成了如图 2 所示的三个阶段的工作:(1) 识别冗余的激活函数,(2) 移除识别出的激活函数并微调阶段 (1) 得到的 DNN,以及 (3) 合并移除了激活函数的连续层,以交付最终的网络。需要注意的是
在决策树模型中进行和,核心目的是,同时在模型和之间找到最优平衡,让模型在训练集之外的新数据上也能有稳定的预测效果,这也是剪枝的核心意义。
决策树的会导致严重的——模型过度学习训练集的细节和噪声,形成极其复杂的决策边界,虽然在训练集上准确率极高,但对新数据的泛化能力极差。是解决决策树过拟合的核心手段,分为(训练前通过参数限制树的生长)和(训练后裁剪冗余节点),其中因实现简单、计算高效,是Sklearn中最常用的方式,也是本次学习的重点。本文基于鸢尾花数据集,先通过展示过拟合的典型特征(复杂决策边界、深度极深的树结构),再详细讲解Skl