
大模型剪枝(Pruning)技术简介
·
剪枝的目的: 在不显著损失模型性能的前提下,实现模型的轻量化与高效化
剪枝的定义: 识别并移除模型中冗余或贡献低的参数 / 结构,同时保持性能基本不变。
剪枝分类:
结构化剪枝:移除整个结构单元 (如注意力头、通道、层),
		  生成规整模型,适合硬件加速

非结构化剪枝:将个别权重置零,形成稀疏矩阵,
		    压缩率高但需特殊硬件支持(如稀疏张量核心,否则只是节省了存储空间)

或者

全局剪枝(Global Pruning)
定义对整个模型的所有参数 / 结构,统一按一个比例剪枝(比如所有层都剪 30%)。
操作: 计算全模型所有参数的重要性,排序后剪掉排名靠后的 X%。


局部剪枝
对模型的不同层 / 模块,根据其 “冗余程度” 设置不同的剪枝比例(比如输入层剪 10%,中间层剪 50%)。
操作方式:每层单独计算参数重要性,再按该层的剪枝比例剪枝。
常见的剪枝方案:
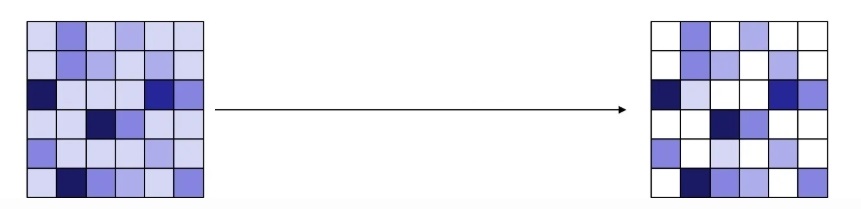
①权重剪枝 (Weight Pruning)
原理: 计算每个权重绝对值,将低于阈值的置零
大概就这么个意思吧
② 注意力头剪枝 (Attention Head Pruning)
Transformer 模型特化技术,移除低贡献的注意力头
对 BERT 等模型效果显著,可减少 50% 参数量而精度损失 < 1%
③通道剪枝 (Channel Pruning)
移除卷积层或全连接层中不重要的通道
适用于 CNN 和 Transformer 的前馈网络部分
④层剪枝 (Layer Pruning)
删除整个 Transformer 层 (深度剪枝)
通常从模型顶部 (输出层) 开始剪,对精度影响较小
剪枝建议与注意事项:
- 结构化剪枝优先原则
除非有专用稀疏计算硬件,否则优先选择结构化剪枝 (如注意力头剪枝、通道剪枝)
在通用硬件上,结构化剪枝的实际加速效果远超非结构化剪枝
- 剪枝比例控制
单次剪枝比例不超过 30%,过大比例会导致难以恢复的性能损失
推荐采用渐进式剪枝:10%→20%→30%,每步后微调
- 敏感层保护
输入层 (嵌入层) 和输出层对性能影响大,剪枝比例应控制在 10-20%
注意力机制中的 query/key 矩阵比 value 矩阵更重要,剪枝比例应更低
- 微调是必须环节
无论何种剪枝方法,微调都是恢复性能的关键
使用 LoRA 等轻量级微调技术可加速恢复并减少计算资源需求
- 与其他技术结合(增-剪-量)
剪枝 + 量化:先剪枝再量化,可减少量化误差,进一步提升压缩率 (可达 80-95%)
剪枝 + 蒸馏:先蒸馏获得轻量级模型,再剪枝进一步压缩,形成 "压缩流水线"
蒸馏--> 剪枝 --> 量化
剪枝工具对比:
工具对比表
| 工具 | 支持框架 | 核心剪枝类型 | 适用模型规模 | 特点 |
|---|---|---|---|---|
torch.nn.utils.prune | PyTorch | 非结构化/基础结构化 | 中小模型 | 原生集成、简单易用 |
| Intel Distiller | PyTorch/TensorFlow | 全类型剪枝 | 中小模型 | 功能全面、多策略组合 |
| SparseGPT | PyTorch | 非结构化(块稀疏) | 超大模型 | 快速无微调、适配大模型 |
| Wanda | PyTorch | 结构化剪枝 | 大模型 | 精度高、性能损失小 |
| Hugging Face剪枝工具 | PyTorch | 结构化剪枝(头/层) | 大模型 | 适配预训练模型、便捷 |
更多推荐

 1
 0
- 0


 已为社区贡献12条内容

所有评论(0)