
DepthShrinker: A New Compression Paradigm Towards BoostingReal-Hardware Efficiency of Compact Neura
Abstract
配备紧凑算子(例如深度卷积,depthwise convolutions)的高效深度神经网络(DNN)模型在降低 DNN 的理论复杂度(例如总权重数/操作数)方面显示出巨大潜力,同时保持了不错的模型精度 。然而,现有的高效 DNN 由于普遍采用的紧凑算子硬件利用率较低,在提升真实硬件效率方面仍难以兑现其承诺 。在这项工作中,我们开启了一种新的压缩范式来开发真实硬件高效的 DNN,从而在保持模型精度的同时提升硬件效率 。有趣的是,我们观察到虽然某些 DNN 层的激活函数有助于 DNN 的训练优化和可达到的精度,但在训练后可以适当地移除它们而不损害模型精度 。受此观察启发,我们提出了一个名为 DepthShrinker 的框架,通过将现有高效 DNN 中具有不规则计算模式的基本构建块收缩(Shrink)为硬件利用率更高、从而真实硬件效率更高的密集构建块,来开发硬件友好的紧凑网络 。令人兴奋的是,我们的 DepthShrinker 框架生成的硬件友好型紧凑网络优于最先进的高效 DNN 和压缩技术,例如,在 Tesla V100 上,相比 SOTA 通道剪枝方法 MetaPruning,精度提高了 3.06%,吞吐量提高了 1.53 倍 。我们的代码已在 GitHub 上开源 。
1. Introduction
深度神经网络(DNN)的最新突破推动了在现实世界设备中部署 DNN 的需求日益增长 。然而,DNN 极高的复杂性与通常受限的设备资源之间存在矛盾 。因此,许多旨在提升 DNN 硬件效率的技术应运而生,包括剪枝(Han et al., 2015a)、量化(Zhu et al., 2016; Zhou et al., 2016),以及利用紧凑算子(例如深度卷积)的高效 DNN 模型(Howard et al., 2017; Google., 2020)。然而,上述技术生成的 DNN 模型大多需要专用的 DNN 加速器才能达到预期的硬件效率 。
与此同时,高效 DNN 设计的趋势与现代计算平台的进步之间存在着两难境地:虽然现代计算平台(如 GPU 和 TPU)不断进步以支持更高程度的并行计算,但现有的高效 DNN 模型通常采用轻量级算子,导致硬件利用率低,从而实际可达到的硬件效率较差 。例如,在紧凑型 DNN(如 MobileNetV2 和 EfficientNet)中广泛采用的深度卷积(Howard et al., 2017),与标准卷积层相比,具有更加不规则的计算模式,由于数据重用机会减少,这使得它们难以充分利用设备上的资源,并限制了现有高效 DNN 发挥其理论潜力(Chen et al., 2019)。因此,人们越来越关注开发硬件利用率更高的硬件友好型 DNN,以便更好地利用现代计算平台的并行能力(Chen & Zhao, 2018; Elkerdawy et al., 2020; Zhou et al., 2021)。
为了解决上述(1)现有高效 DNN 的低硬件利用率与(2)现代计算平台不断增加的计算并行度之间的差距,我们提出了一个有趣的问题:“我们如何设计出既能享受最先进(SOTA)高效 DNN 结构的强大表达能力,又能利用现代计算平台增强的并行计算能力的高效 DNN?” 。受 RepVGG(Ding et al., 2021)的启发(该方法合并并行分支以构建优秀的单分支网络),一个自然的思路是将连续的层合并为一个具有密集计算模式且硬件利用率更高的单层。然而,由于相关的激活函数旨在引入更多的非线性以增强模型容量,因此沿深度维度合并层并非易事 。
有趣的是,我们观察到虽然某些 DNN 层的激活函数有助于 DNN 的训练优化和可达到的精度,但在训练后可以适当地移除它们而不损害模型精度 。一个令人兴奋的结果是,移除了激活函数后的剩余连续线性运算可以合并为一个单一的线性运算 。值得注意的是,如果移除了倒残差块(Inverted Residual Block,SOTA 高效 DNN 的基本构建块)中的两个激活函数,其两个逐点卷积(pointwise convolution)层、一个深度卷积层以及相关的残差连接可以合并为一个密集卷积,且该密集卷积具有(1)与原始深度卷积相同大小的卷积核,以及(2)与原始倒残差块相同的输入/输出通道数 。令人兴奋的是,与原始倒残差块中的逐点卷积(核大小为 1x1)和深度卷积相比,所得的密集卷积享有显著提升的硬件利用率,从而使派生的 DNN 在保持原始精度的同时获得提升的硬件效率 。
受上述令人兴奋的发现驱动,我们提出了一种面向真实硬件高效紧凑网络的新压缩范式,并做出了以下贡献 :
我们通过实验表明,现有高效 DNN 中普遍采用的构建块,在具有相同理论复杂度的前提下,其硬件效率不如密集运算 。
受此启发,我们提出了 DepthShrinker,主张将连续的层(这些层之间的激活函数被学习判定为对推理不重要)合并为一个单一的密集层 。DepthShrinker 派生的 DNN 可以很大程度上利用现代计算平台的高度并行性,从而在保持原始模型精度的同时提升硬件效率 。
DepthShrinker 为强大且硬件高效的 DNN 开辟了新视角,并且可以被视为某种形式的“软”层级剪枝,这与层级剪枝形成对比,即“合并”与“硬剪枝” 。值得注意的是,DepthShrinker 生成的 DNN 优于 SOTA 的通道级和层级剪枝技术,例如,在 Tesla V100 上,相比 SOTA 通道剪枝方法 MetaPruning(Liu et al., 2019),精度提高了 3.06%,吞吐量提高了 1.53 倍 。
大量的实验和消融研究验证了 DepthShrinker 可以(1)大幅推进 DNN 可达到的精度-效率权衡的前沿,以及(2)作为一种增强技术来提升微型 DNN 的精度 。
2. Related Works
高效 DNN (Efficient DNNs)。 各种高效的 DNN 已经被开发出来。早期的高效 DNN 主要依赖于人类专家的手动设计,例如 MobileNets (Howard et al., 2017; Sandler et al., 2018) 通过深度卷积(depthwise convolution)提升了模型效率和精度的权衡,深度卷积已成为高效 DNN 的标准算子 。与此同时,硬件高效的算子(Wu et al., 2017; Chen et al., 2020)被提出作为卷积的替代方案 。得益于神经架构搜索(NAS)(Zoph & Le, 2016; Zoph et al., 2018) 的巨大成功,基于强化学习(Tan et al., 2019; Howard et al., 2019; Tan & Le, 2019)和可微搜索(Liu et al., 2018; Wu et al., 2019; Cai et al., 2018)的自动化高效 DNN 设计已被提出 。然而,现有的高效 DNN 在硬件效率方面仍然受限,因为其基本构建块(例如深度卷积)的硬件利用率较低 。
DNN 压缩技术 (DNN compression techniques)。 现有的 DNN 压缩技术通过剪枝(Han et al., 2015b;a; Wen et al., 2016; He et al., 2018; Liu et al., 2019; He et al., 2017; 2020; 2019; Dong et al., 2017)、量化(Courbariaux et al., 2015; 2016; Rastegari et al., 2016; Fu et al., 2020; 2021a)、低秩分解(Yin et al., 2021; Sainath et al., 2013; Nakkiran et al., 2015)或动态推理(Teerapittayanon et al., 2016; Wang et al., 2018; Shen et al., 2020)来降低模型复杂度,同时努力保持良好的精度 。尽管如此,众所周知,通用计算平台(如 GPU 和 CPU)在硬件效率方面无法完全从基于低比特量化、低秩分解或动态推理的 DNN 压缩中受益,并且在实现剪枝带来的效率提升方面仍然受到限制 。
层级剪枝 (Layer-wise pruning)。 与 DepthShrinker 最相关的工作是层级剪枝(Chen & Zhao, 2018; Elkerdawy et al., 2020; Zhou et al., 2021; Xu et al., 2020),其动机是与通道级剪枝相比,修剪整个层/块在降低硬件延迟方面更有效 (Xu et al., 2020) 。具体而言,(Chen & Zhao, 2018; Elkerdawy et al., 2020) 根据他们提出的标准修剪层 ;而 (Zhou et al., 2021) 和 (Xu et al., 2020) 分别通过进化搜索和可微优化来确定要修剪哪些层/块 。然而,在大压缩率下,激进的层级剪枝不可避免地会遭受显著的精度下降,因为难以恢复被剪枝模型的精度 。我们的 DepthShrinker 不是进行硬剪枝,而是在训练后将连续的线性运算合并为一个密集运算,得益于(1)其更好地保持了模型表达能力以及(2)合并后密集运算的高利用率和由此带来的更低延迟,它能够同时赢得精度和硬件效率 。
3. Motivating Inspiration and Observations
3.1. Inspiration Drawn from Previous Works
具有更高利用率的浅层网络有利于提升真实硬件效率。 最近的研究(Elkerdawy 等人, 2020; Xu 等人, 2020)表明,浅层网络倾向于更高程度的并行处理,从而具有更高的硬件利用率,这使得它们在现代计算设备(如 GPU)上比计算成本相当的深层网络具有更好的真实硬件效率 ;这一结论也得到了我们在 3.2 节中性能分析实验的进一步验证 。然而,现有的浅层网络仍然无法达到与其深层对应网络相近的精度,这激励我们去创新具有更高精度的浅层网络 。
DNN 中的线性运算可以被合并。 众所周知,线性运算是可以被适当合并的 。RepVGG(Ding 等人, 2021)表明,DNN 并行分支中的线性运算可以合并,从而提供具有竞争力的单分支网络 。受此启发,构建强大的紧凑型网络的一个自然想法是合并 SOTA DNN 中的连续层以减少模型深度 。然而,由于存在非线性激活函数,无法直接沿深度维度合并层 。这促使我们提出一个问题:“是否可以在推理阶段适当地移除某些激活函数” 。
激活函数的作用。 基于现有的 DNN 压缩(Han 等人, 2016; Jacob 等人, 2018)和训练(Zhou 等人, 2020; Cai 等人, 2021)工作,我们假设上述问题的答案是肯定的,这些工作表明 DNN 更高的复杂性有利于训练,但在推理过程中可以被削减而不损害精度 。具体而言,迭代剪枝(Han 等人, 2016)和感知量化训练(Jacob 等人, 2018)以原始复杂度训练 DNN,然后对模型进行稀疏化/量化以用于推理,而不会损害精度 ;同时,(Zhou 等人, 2020; Cai 等人, 2021)在训练期间通过扩展宽度来增强 DNN 以提高精度,而推理期间的模型保持不变 。这些先前技术带来的一个启示是,激活函数可以被视为增强 DNN 复杂性和表达能力的一个特定模型维度,因此有些激活函数可能在训练后被适当地移除而不损害精度 。
3.2. Motivating Observations from Real-device Profiling
由于我们的工作是硬件驱动的,旨在提高真实设备效率而非理论效率,我们进行了广泛的真实设备性能分析实验来验证我们的假设并更好地理解设计空间,本小节对这些内容进行了总结 。
核心假设/动机。 虽然常用的瓶颈块(He 等人, 2016)和更高效的倒残差块(Sandler 等人, 2018)已表现出令人印象深刻的理论效率和精度权衡,但在相同的计算复杂度下,它们的真实设备效率不如其对应的密集(dense)模块,这是因为它们更不规则的计算模式导致了数据重用减少和硬件利用率降低 。
实验设置。 在我们的性能分析中,我们将 MobileNetV2(Sandler 等人, 2018)(包括 EfficientNet-Lite0(Google., 2020))和 ResNet(He 等人, 2016)系列中的每个构建块替换为一个密集卷积层,该层具有(1)与每个块的第二个卷积层相同的卷积核大小,这是瓶颈/倒残差块中唯一卷积核大小大于 1×1 的卷积,以及(2)缩放后的通道数,以保持与原始块相同的浮点运算数(FLOPs) 。我们在表 1 中总结了这两个网络系列(以两种不同类型的基本构建块为特征)及其对应的密集版本在 ImageNet(分辨率为 224×224)上的真实设备吞吐量 。
所选设备和测量设置。 我们考虑了三种商用设备,包括(1)NVIDIA Tesla V100 GPU(NVIDIA., c),(2)NVIDIA RTX 2080Ti GPU(NVIDIA., b),以及(3)Jetson TX2 Edge GPU(NVIDIA., a),以覆盖桌面级和边缘级 GPU 。参照(Ding 等人, 2021),对于前两个设备我们采用的批大小(batch size)为 128,对于最后一个设备为 64,并采用每秒帧数(FPS)作为效率指标 。
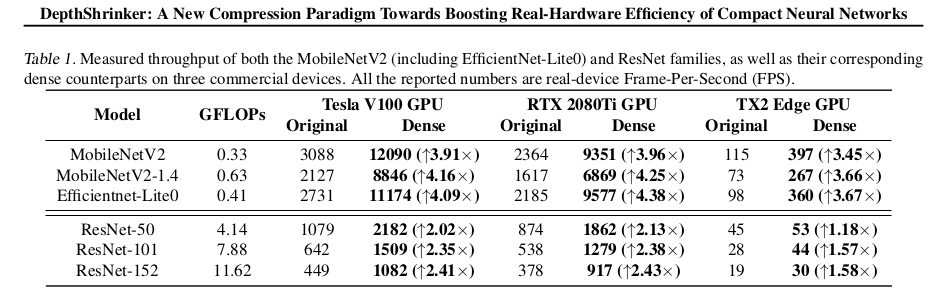
结果与分析。 如表 1 所示,我们可以观察到(1)无论模型系列和分析设备如何,在相同 FLOPs 下,密集对应版本始终比原始网络实现更高的吞吐量 。具体而言,基于 MobileNetV2 系列的密集卷积对应版本在 Tesla V100/RTX 2080Ti GPU 和 TX2 Edge GPU 上分别将吞吐量提升了 3.91×∼4.38× 和 3.45×∼3.67× ;同样地,基于 ResNet 系列,它们在 Tesla V100/RTX 2080Ti GPU 和 TX2 Edge GPU 上分别将吞吐量提高了 2.02×∼2.43× 和 1.18×∼1.58× 。为了进一步理解这一点,我们在图 1 中可视化了 MobileNetV2/MobileNetV2-1.4 在 RTX 2080Ti GPU 上的分块延迟,包括原始块和相应密集卷积的延迟 。结果显示,每个块的密集对应版本可以一致地减少高达 88.2% 的延迟 。
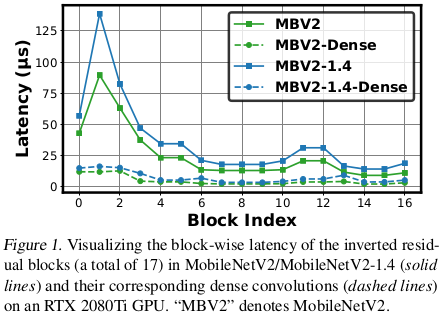
这组性能分析实验表明:(1)用相同 FLOPs 的密集运算替换常用的构建块可以显著提高真实设备效率,这归功于硬件资源利用率的提高 ;(2)MobileNetV2 系列的吞吐量提升比 ResNet 系列更为显著,因为前者中的深度卷积(广泛应用于现有高效 DNN 中)引入了更多不规则的计算模式,因此在将其替换为密集卷积后,我们看到了更明显的提升 ;(3)吞吐量的提升在不同设备上均可观察到,且在 Tesla V100/2080Ti GPU 上比在 TX2 Edge GPU 上更大,因为前者具有更高程度的并行处理能力,有利于密集对应版本实现更高的吞吐量,这表明随着现代 AI 驱动计算平台并行度增加的趋势,我们的 DepthShrinker 能够带来更大的效率提升 。
备注。 硬件利用率以及随之而来的真实设备效率提升主要归因于两个方面:(1)从运算角度来看,不规则运算的数据重用机会较少,因此需要更多的数据移动成本(Chen 等人, 2019),例如,在我们的分析实验中,核大小为 1×1 的标准卷积和深度卷积均被替换为核大小更大的 3×3 密集卷积,从而在相同 FLOPs 下带来更多的数据重用机会和更少的数据移动 ;(2)从深度/宽度权衡的角度来看,用具有相同 FLOPs 的一个密集卷积替换一个构建块会使原始网络变浅并变宽,从而在具有越来越高并行度特征的现代计算平台上运行时有利于获得更高的利用率 。我们在附录 C 中进一步研究了上述观点(2)的独立影响 。
4. The Proposed DepthShrinker Framework
4.1. Overview
核心思想。 DepthShrinker 旨在通过移除冗余的激活函数并合并随后的连续线性运算,来开发具有高硬件利用率的真实硬件高效 DNN 。其核心思想是,通过移除倒残差块(Inverted Residual Block,大多数高效 DNN 中的基本构建块,Sandler et al., 2018)内的两个激活函数,整个模块就可以合并为一个单一的密集卷积层 。这个密集卷积层具有与原始模块的深度卷积(depthwise convolution)相同的卷积核大小,以及与原始模块相同的输入/输出通道数 。令人兴奋的结果是,正如 3.2 节所分析的那样,真实硬件效率得到了显著提升 。
框架概述。 为了实现上述目标,存在两个非同寻常的挑战:哪些激活函数应该被移除,以及在移除后如何用更少的剩余激活函数恢复精度 。为了解决这些问题,建立在 SOTA 高效 DNN 之上的 DepthShrinker 集成了如图 2 所示的三个阶段的工作:(1) 识别冗余的激活函数,(2) 移除识别出的激活函数并微调阶段 (1) 得到的 DNN,以及 (3) 合并移除了激活函数的连续层,以交付最终的网络 。需要注意的是,我们遵循模型压缩中的常见做法(He et al., 2018; Wen et al., 2016; Han et al., 2015a; Jacob et al., 2018),将 DepthShrinker 应用于公开可用的预训练模型之上 。
4.2. Stage 1: Identify Redundant Activation Functions
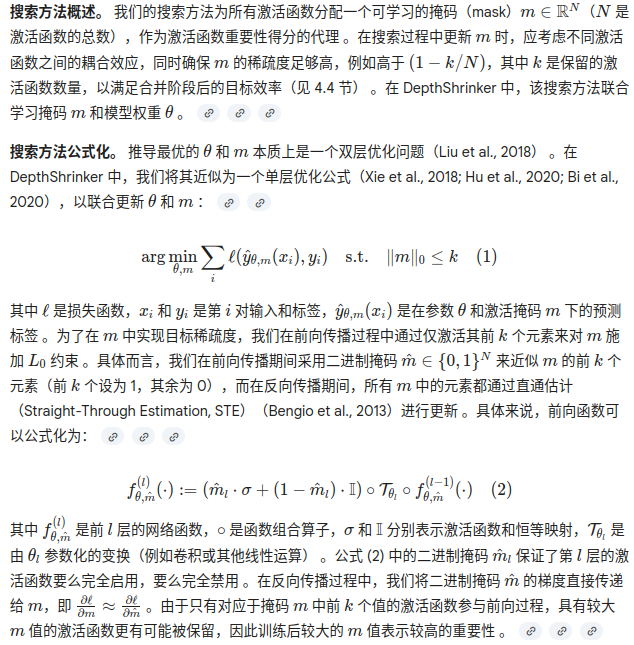
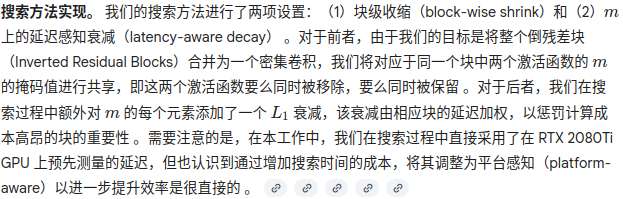
为了识别不重要的激活函数,像层级剪枝(Layer-wise pruning)那样的预定义标准(Li et al., 2016; Wen et al., 2016)可能并不适用,因为不同层的激活函数是相互耦合的,例如,移除前面的激活函数可能会改变后续层的特征分布 。因此,受近期剪枝工作(Kang & Han, 2020; Ramanujan et al., 2020; Fu et al., 2021b)的启发,我们提出了一种可微搜索方法,在考虑其联合影响的情况下学习所有激活函数的重要性 。
4.3. Stage 2: How to Fine-tune
在上述搜索过程之后,具有最小 m 值的最不重要的激活函数会被移除,并执行微调以恢复精度 。以下解决方案已被提出并验证:
免费添加额外的激活函数。 由于倒残差块(Sandler et al., 2018)仅包含两个激活函数,在合并阶段之后,密集卷积后面没有非线性函数 。为了提升所达到的精度,我们在每个合并卷积之后额外添加一个激活函数(在本工作中即为 ReLU6),这只会产生可忽略不计的硬件成本 。
自蒸馏。 在 DepthShrinker 中,我们可以在微调期间选择性地启用自蒸馏机制,即在开启所有激活函数的原始网络的指导下进行知识蒸馏(Hinton et al., 2015),以进一步提升衍生网络的精度 。需要注意的是,我们仅使用原始网络作为教师网络,而不引入额外的模型 。
4.4.Stage 3: How to Merge
在对移除了不重要激活函数的所得网络进行微调之后,最后一步是合并相邻的线性运算(例如:卷积/全连接层、平均池化层或批量归一化层)。
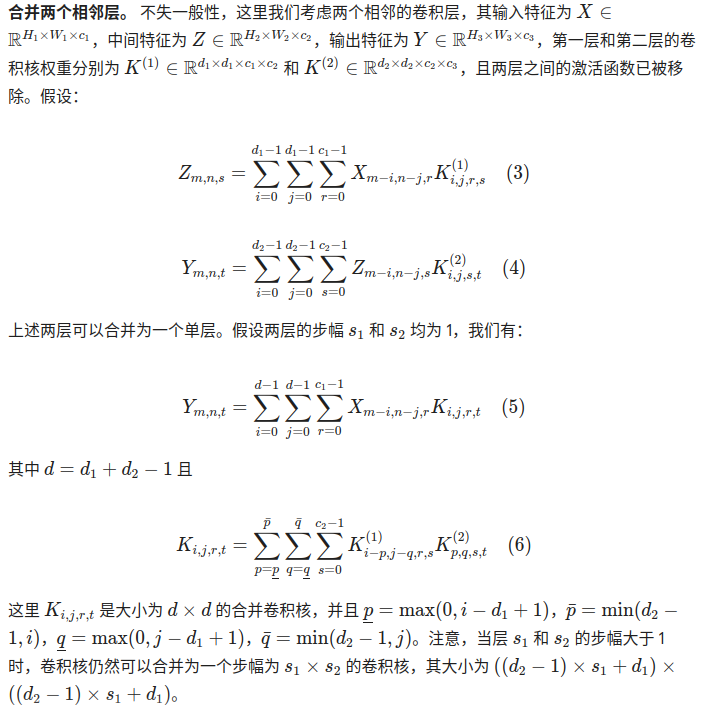
合并倒残差块。 从上述分析中得出的一个重要见解是,当连续的卷积层合并为一个卷积层时,所得卷积层的输入和输出通道数仅由第一个卷积层的输入通道数和最后一个卷积层的输出通道数决定,而与中间层的结构无关。因此,倒残差块(Sandler et al., 2018)的设计规则,即由三个卷积层组成且通道数先扩展后减少,天然有利于 DepthShrinker 派生的网络,因为这些网络由仅具有减少后的输入和输出通道数的合并卷积组成。我们相信这也为未来的硬件高效 DNN 设计提供了启示。
4.5. DepthShrinker+:Expand-then-Shrink
上述 DepthShrinker 的基础设计利用了一个见解,即不重要的激活函数可以在训练后适当地移除而不损害推理精度 。令人兴奋的是,这一见解也可以用于改进 DNN 训练 。具体而言,我们建议通过“先扩展后收缩”(Expand-then-Shrink)策略来训练给定的 DNN,并将其称为 DepthShrinker+ 。在 DepthShrinker+ 训练中,我们首先 (1) 将一个或部分卷积层扩展为倒残差块,得益于扩展模型中增加的过参数化,这有利于训练优化;(2) 训练扩展后的 DNN;然后 (3) 应用 DepthShrinker 来合并上述新引入的块,以恢复原始网络结构 。因此,这种训练方案可以被视为在训练期间通过增强复杂性来增强原始 DNN,以利于其训练优化和可达到的精度,而推理效率保持不变 。
5. Experiment Results
5.1. Experiment Setup
网络和数据集 (Networks and datasets)
我们将 DepthShrinker 应用于 MobileNetV2 (Howard et al., 2017) 和 EfficientNet-Lite (Google., 2020)(即 EfficientNet (Tan & Le, 2019) 的一个硬件高效变体)系列模型,并在 ImageNet 数据集 (Russakovsky et al., 2015) 上进行了实验。
搜索设置 (Search settings)
我们采用与微调阶段(见下文)相同的训练超参数,并且发现重要的激活函数可以被快速识别,搜索过程通常在 20 个 epoch 内趋于稳定。
微调设置 (Fine-tuning settings)
默认情况下,我们使用 SGD 优化器和余弦学习率(cosine learning rate)微调 180 个 epoch,并参照 (Wang et al., 2021) 的做法配备了标签平滑(label smoothing)(Müller et al., 2019) 和 RandAugment (Cubuk et al., 2020)。除非明确说明,我们在报告结果的实验中未启用自蒸馏(self-distillation)。
设备和测量设置 (Devices and measurement settings)
我们考虑了三种常用的计算平台,包括 NVIDIA Tesla V100 GPU (NVIDIA., c)、RTX 2080Ti GPU (NVIDIA., b) 和 Jetson TX2 Edge GPU (NVIDIA., a),并采用了与第 3.2 节相同的测量设置。
5.2. Benchmark with SOTA Pruning Methods
我们首先将 DepthShrinker 与最先进的(SOTA)剪枝技术进行对比,包括通道级(channel-wise)和层级(layer-wise)剪枝方法。
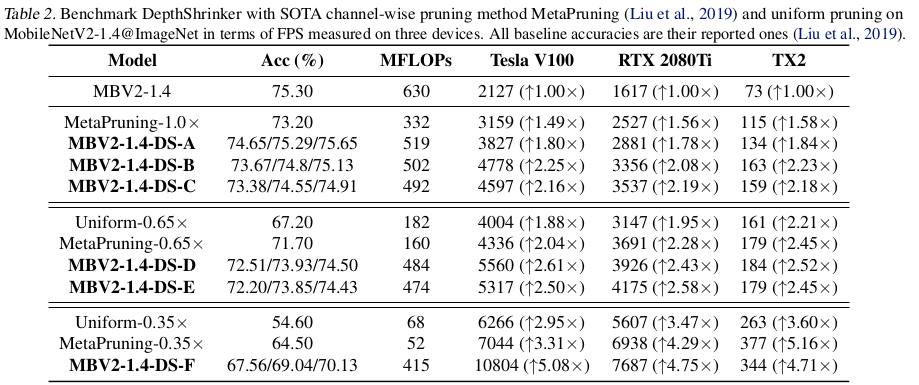
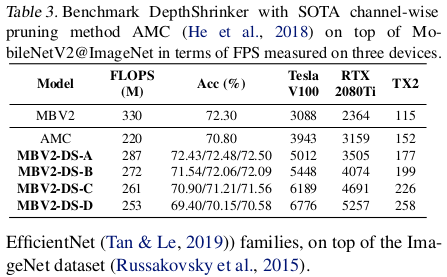
与通道级剪枝的基准对比 (Benchmark with channel-wise pruning)我们在 ImageNet 上与两种在压缩高效 DNN 方面达到 SOTA 性能的通道级剪枝方法 AMC (He et al., 2018) 和 MetaPruning (Liu et al., 2019),以及 (Liu et al., 2019) 中的统一通道级剪枝基准(uniform channel-wise pruning baseline)进行了对比。如表 2 和表 3 所示,我们将 DepthShrinker 生成的模型系列标记为 “DS-X”(详细结构见附录 E),并报告了它们在三种训练设置下的精度:标准训练 180 个 epoch,以及按照第 4.3 节所述启用自蒸馏分别训练 180 和 360 个 epoch。
结果与分析 (Results and analysis) 我们可以观察到:
-
权衡优势: 在标准训练设置下,DepthShrinker 在所有三款设备上相对于这三个基准方法,始终能实现更好的精度-效率权衡(accuracy-efficiency trade-offs)。特别是在 RTX 2080Ti GPU 上测量的 MobileNetV2 上,DepthShrinker 相比 MetaPruning-1.0×,在 1.40 倍吞吐量下精度提高了 0.18%,或者在 1.14 倍吞吐量下精度提高了 1.45%;相比 AMC,在 1.48 倍吞吐量下精度提高了 0.1%。
-
自蒸馏提升: 配备自蒸馏和更多的训练 epoch 后,DepthShrinker 可达到的精度显著提升了高达 2.57%,进一步拉大了与通道级剪枝基准的精度差距。
-
可扩展性: DepthShrinker 对不同的压缩率表现出良好的可扩展性,并且在极度高效的情况下优于 SOTA 通道级剪枝,例如在 Tesla V100 上,相比 MetaPruning-0.35×,精度提高了 3.06% 且吞吐量达到了 1.53 倍。
-
硬件利用率: DepthShrinker 倾向于更好的数据重用(data reuses)和更高的利用率,因为与其生成的模型相比,虽然其 FLOPs 比通道级剪枝方法的模型更大,但其真实硬件效率却更好。
与层级剪枝的基准对比 (Benchmark with layer-wise pruning)
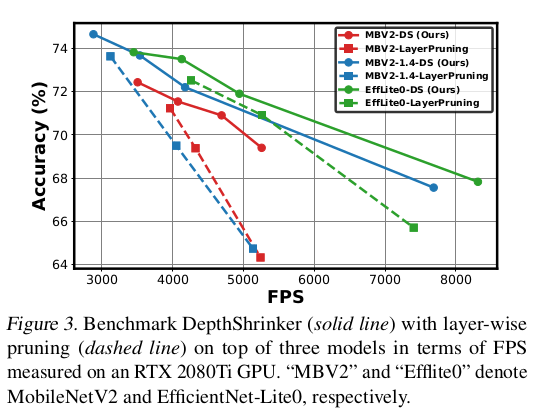
为了与层级剪枝方法(在本例中即修剪整个块)进行对比,为了公平起见,我们基于这样一个假设:具有冗余激活函数的块本身也是冗余的,因为它们的复杂性对最终精度的贡献较小,因此我们直接移除由 DepthShrinker 的可微搜索方案识别出的整个块。 如图 3 所示,我们可以看到:
-
DepthShrinker 在所有三个模型中仍然始终实现更好的精度-效率权衡。
-
在高压缩率(修剪更多块)的情况下,DepthShrinker 显著优于层级剪枝,因为后者会遭受更大的精度下降。例如,在 MobileNetV2-1.4 上,DepthShrinker 相比层级剪枝得到的最小模型,实现了 2.80% 更高的精度和 1.50 倍的吞吐量。这表明在可扩展性方面,“合并”(merging)优于“硬剪枝”(hard pruning)
可视化 (Visualization)
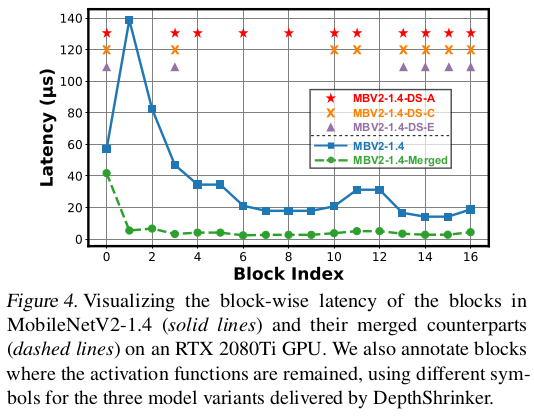
在图 4 中,我们可视化了基于 MobileNetV2-1.4 的 DepthShrinker 生成的模型变体中保留的激活函数,以及合并每个块前后的块级延迟分解(block-wise latency breakdown)。 我们可以看到:
-
将构建块(building blocks)收缩为密集卷积(dense convolutions)可以显著降低延迟高达 96.1%。
-
得益于延迟感知衰减(latency-aware decay,见第 4.2 节),DepthShrinker 能够成功识别出延迟方面的瓶颈层。
需要注意的是,合并后的密集卷积具有与原始块相同的输入/输出通道数,这与第 3.2 节中的设置不同,那里的输入/输出通道数经过了缩放以保持相同的 FLOPs。
在图 5 中,我们还可视化了应用 DepthShrinker 前后的块级内存占用(block-wise memory footprint),包括权重的占用和峰值激活图(peak activation maps)的占用(即在块中执行每个卷积时,输入/输出/残差激活图的最大总和,假设为 16 位精度)。我们可以看到,DepthShrinker 有效地降低了主导内存占用的峰值激活使用量,因为它移除了通道扩展(channel expansion)和残差连接(residual connections),从而降低了数据移动成本,进而提升了真实硬件效率。
备注 (Remark)
我们的 DepthShrinker 开启了一种新的压缩范式,为压缩高效 DNN 结构提供了一个具有成本效益的视角,同时赢得了通道级和层级/块级剪枝的优势,即实现了前者的高精度以及后者良好的硬件效率。
更多推荐
 26
 0
- 0


 已为社区贡献1条内容

所有评论(0)