
机器学习实验——后剪枝与预剪枝
在机器学习领域,决策树是一种既直观又强大的分类模型。不过,未经优化的决策树很容易因为过度生长而产生过拟合问题——也就是模型在训练数据上表现得非常好,但面对新的未知数据时,泛化能力却很差。剪枝是解决决策树过拟合的关键方法,主要分为预剪枝(Pre-pruning)和后剪枝(Post-pruning)两种策略。本文会详细讲解这两种剪枝方法的原理,并基于testset.txt数据文件完成完整的代码案例,以此对比它们的实际效果。
一、决策树剪枝基础:预剪枝与后剪枝
1.1 预剪枝(先剪枝)
预剪枝的核心思路是在决策树构建的过程中,提前阻止它继续生长。具体来说,就是在每个节点准备分裂之前,先进行判断:如果这次分裂不能提升模型的性能,或者已经满足了预先设定的停止条件,那么就直接把当前节点标记为叶节点,不再继续往下分裂。
常见的预剪枝策略:
ⅰ限制决策树的最大深度(max_depth)
ⅱ规定节点分裂时需要的最少样本数量(min_samples_split)
ⅲ规定叶节点必须包含的最少样本数量(min_samples_leaf)
当分裂带来的信息增益或增益比低于某个阈值时,就不进行分裂
优缺点:
优点:计算效率高,不需要构建完整的决策树,训练速度更快。
缺点:很容易因为“停止得太早”而导致欠拟合,而且模型效果对停止条件的参数设置非常敏感。
1.2 后剪枝(后剪枝)
后剪枝的核心思路是先构建一棵完整的决策树,再从下往上回溯进行剪枝。首先不设置任何限制,生成一棵“枝叶茂密的满树”,然后从最底层的叶节点开始,向上遍历每一个非叶节点,判断如果把这个节点替换成叶节点,模型在验证集上的性能是否会提升(或者保持不变)。如果答案是肯定的,就进行剪枝——删除该节点的所有子节点,将其设为叶节点。
常见的后剪枝策略:
1.REP(错误率降低剪枝):通过验证集判断剪枝后,模型的错误率是否下降(本文将实现这种方法)
2.CCP(代价复杂度剪枝):引入复杂度惩罚项,找到最优的剪枝点(sklearn 库默认使用这种方法)
优缺点:
优点:泛化能力更强,不容易出现欠拟合,剪枝效果也更稳定。
缺点:计算成本高,不仅需要先构建完整的决策树,还需要多次遍历验证集进行评估。
二、基于自定义数据集的代码实现
2.1 实现思路
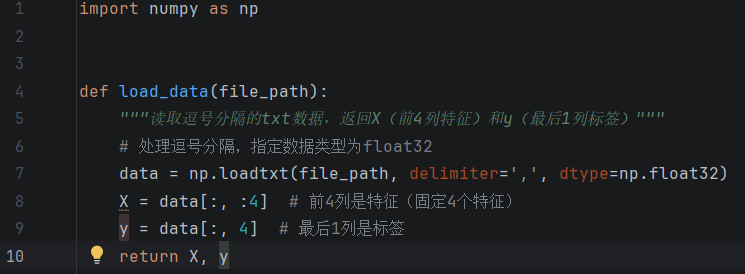
①读取dataset.txt(训练集)和testset.txt(测试集),处理以逗号分隔的数据格式,从中分离出4个特征和1个标签。
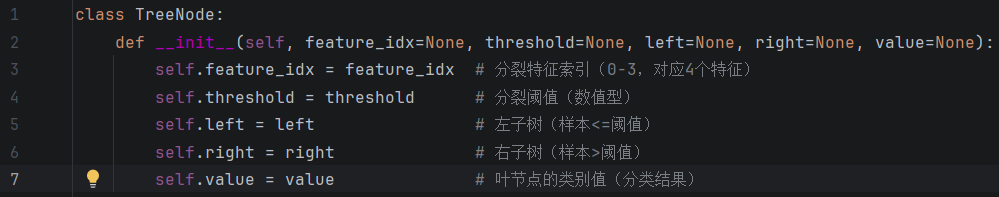
②定义TreeNode类,用来存储决策树节点的分裂特征、分裂阈值、左右子树,以及叶节点的类别值。
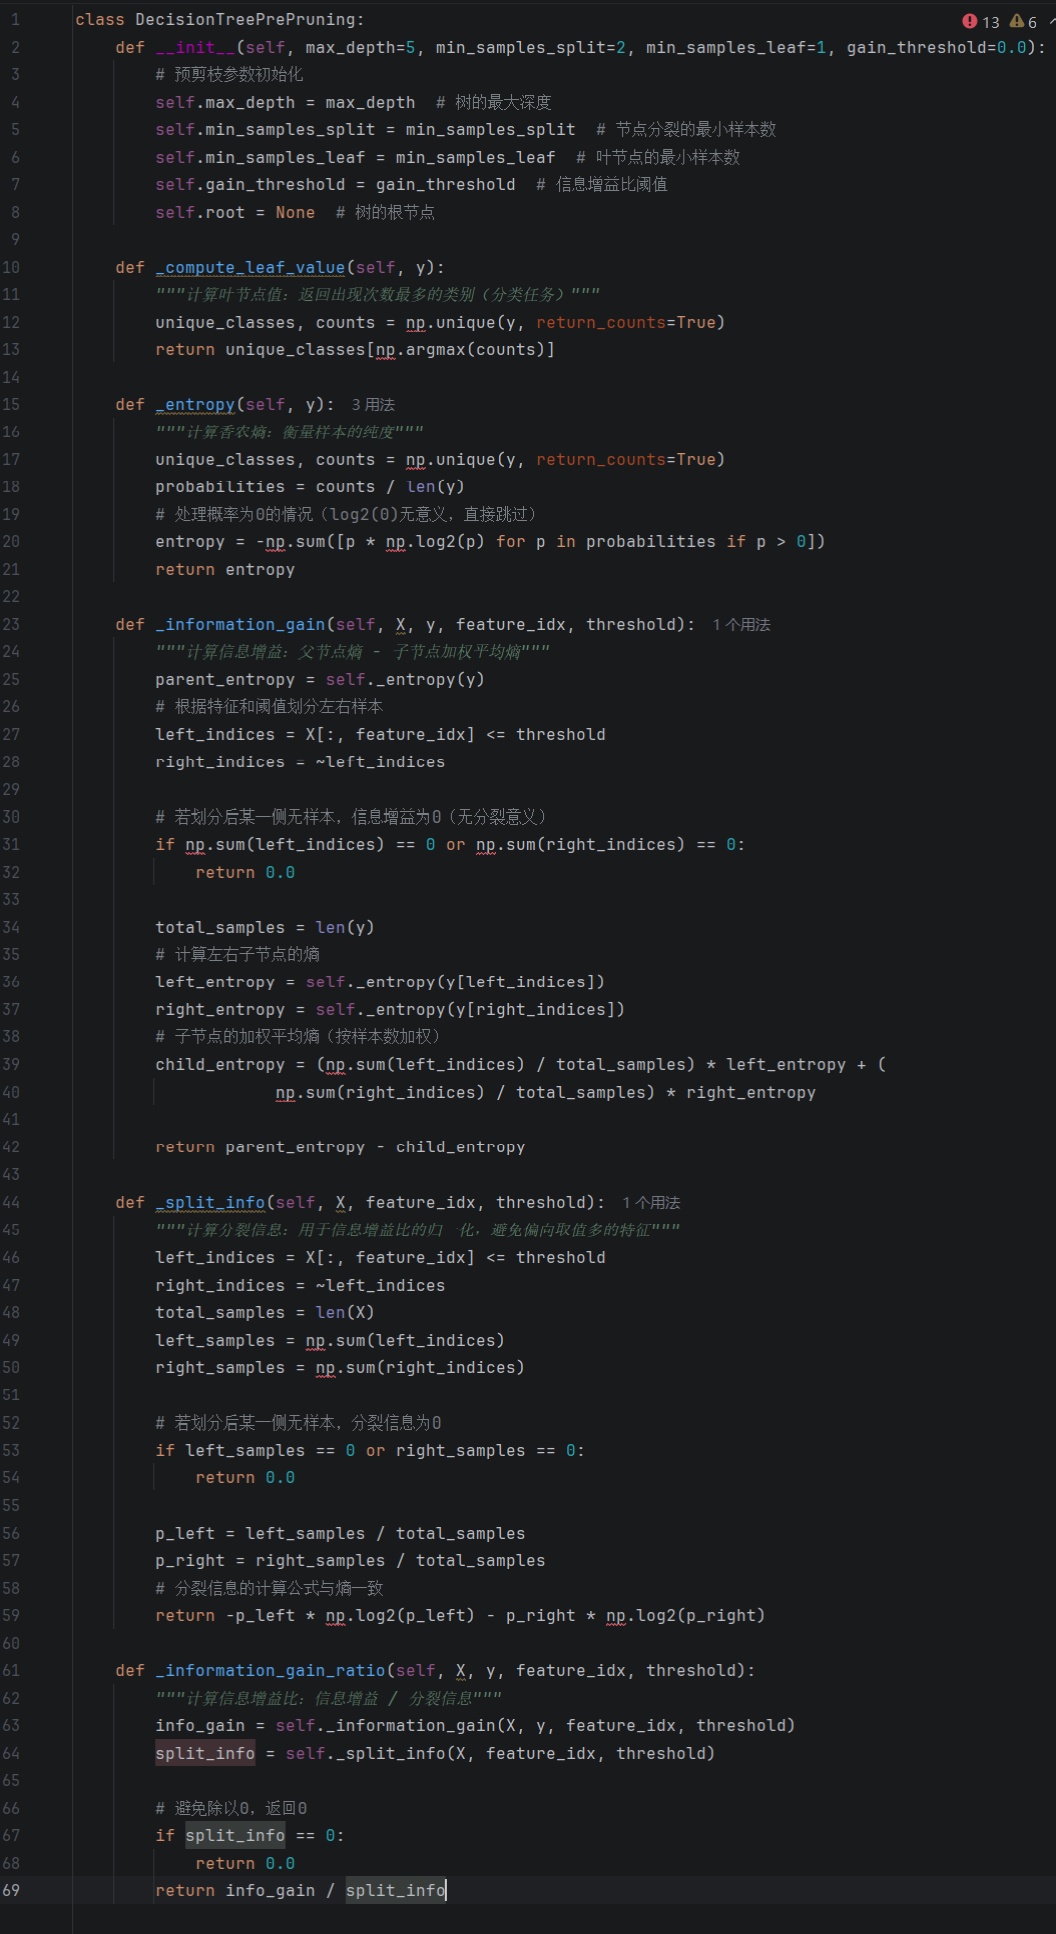
③实现决策树的基础功能,包括熵的计算、信息增益比的计算,以及寻找最优分裂点的逻辑。
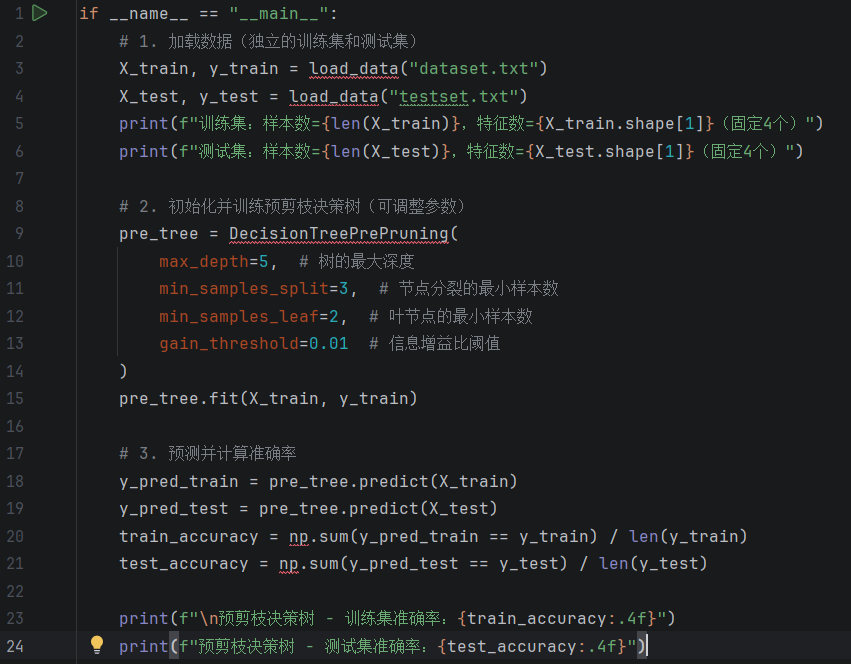
④在构建决策树的过程中,加入预剪枝的停止条件,比如最大深度、节点分裂的最小样本数、叶节点的最小样本数,以及增益比阈值。
⑤用训练集训练模型,再用测试集评估模型的效果。
1.读取训练集和测试集
2.定义TreeNode类,存储决策树节点的核心属性,包括分裂特征索引、分裂阈值、左右子树和叶节点类别值。
3.定义DecisionTreePrePruning类,实现熵计算、信息增益、分裂信息、信息增益比等基础功能,为决策树分裂提供依据。
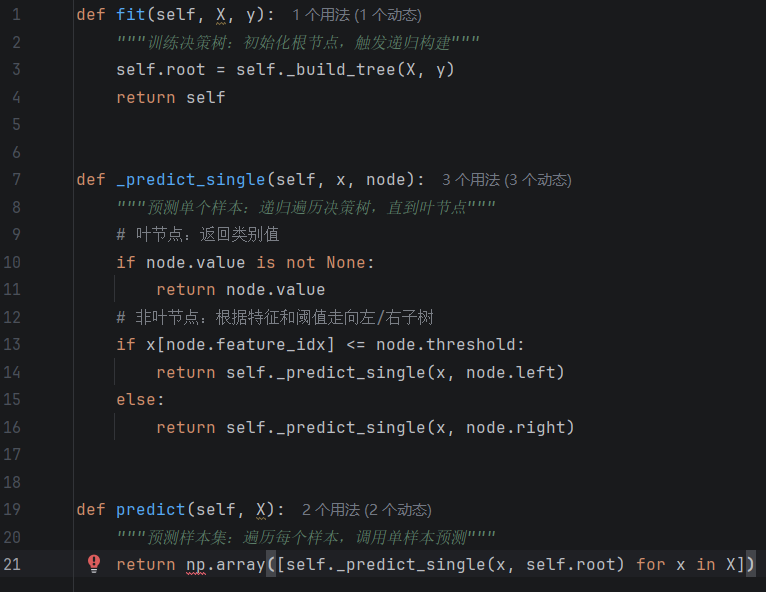
4.实现模型的训练(初始化根节点)和预测(单样本 / 样本集)方法。
5.加载训练集和测试集,初始化并训练预剪枝决策树,评估模型准确率。
6.测试结果
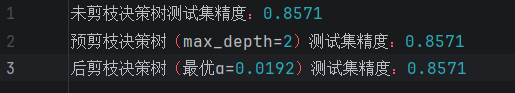
三、总结与思考
预剪枝是通过在决策树生长过程中提前终止,来避免模型过拟合;后剪枝则是先让树完整生长,再通过从下往上的回溯剪枝来优化树的结构。这两种方法各有长处和不足,在实际项目里,需要结合数据规模和性能需求来选择合适的策略:
处理小规模数据时:可以采用后剪枝,目的是追求更好的模型泛化能力。
处理大规模数据时:建议优先使用预剪枝,这样能更好地保证模型的训练效率。
更多推荐


 18
 0
- 0


 已为社区贡献4条内容

所有评论(0)