
【耿直哥机器学习】7-6-决策树剪枝
·
7-6 决策树剪枝详解 | 过拟合问题分析+预剪枝实战+核心参数调优(鸢尾花数据集)
引言
决策树的无限制生长特性会导致严重的过拟合问题——模型过度学习训练集的细节和噪声,形成极其复杂的决策边界,虽然在训练集上准确率极高,但对新数据的泛化能力极差。剪枝是解决决策树过拟合的核心手段,分为预剪枝(训练前通过参数限制树的生长)和后剪枝(训练后裁剪冗余节点),其中预剪枝因实现简单、计算高效,是Sklearn中最常用的方式,也是本次学习的重点。
本文基于鸢尾花数据集,先通过无参数限制的决策树展示过拟合的典型特征(复杂决策边界、深度极深的树结构),再详细讲解Sklearn中三大核心预剪枝参数(max_depth/min_samples_split/min_weight_fraction_leaf)的使用方法和调优逻辑,通过可视化对比剪枝前后的决策边界和树结构变化,直观理解剪枝的作用。代码添加超详细注释并解决中文显示问题,零基础小白也能轻松掌握,同时提供Jupyter Notebook和PyCharm两个可直接运行的代码版本。
核心知识点前置梳理(小白必看)
本次学习核心围绕决策树过拟合和预剪枝展开,先掌握以下核心概念、参数和过拟合特征,后续代码和逻辑理解会更轻松,所有参数均为Sklearn决策树预剪枝的核心配置。
1. 决策树过拟合的核心原因与典型特征
决策树的划分逻辑是贪心算法,会不断寻找最优特征和阈值划分数据集,直到所有节点纯净化(基尼系数/信息熵为0),这种无限制生长会导致模型过度拟合训练集,典型特征如下:
| 过拟合特征 | 具体表现 |
|---|---|
| 决策边界 | 极其复杂,出现大量锯齿状分割,贴合训练集所有样本 |
| 树结构 | 深度极深、节点数量极多,甚至每个叶子节点仅包含1个样本 |
| 模型性能 | 训练集准确率接近100%,测试集准确率大幅下降,泛化能力差 |
| 不纯度指标 | 大部分叶子节点的基尼系数/信息熵为0,模型过度“记忆”训练集细节 |
2. 决策树剪枝的核心分类
| 剪枝方式 | 核心逻辑 | 优缺点 | Sklearn支持情况 |
|---|---|---|---|
| 预剪枝(重点) | 训练前通过设置参数限制树的生长,从源头避免过拟合 | 优点:实现简单、计算高效、调参直观;缺点:参数设置需经验,易欠拟合 | 原生全面支持 |
| 后剪枝 | 先让树无限制生长至纯净化,再从后往前裁剪冗余节点(降低泛化误差) | 优点:拟合效果更优;缺点:计算复杂、耗时久,需额外验证集 | 仅部分支持(如Cost Complexity) |
3. Sklearn决策树核心预剪枝参数速查表(本次重点)
所有参数均通过提高模型生长的门槛实现剪枝,参数越严格,树的复杂度越低,剪枝效果越明显,核心参数如下:
| 参数名 | 核心作用 | 取值类型 | 调优逻辑 | 本次实验取值 |
|---|---|---|---|---|
max_depth(最常用) | 限制树的最大深度,根节点深度为0/1(Sklearn中根节点深度为0) | 正整数 | 数值越小,剪枝越狠 | 4(适度剪枝) |
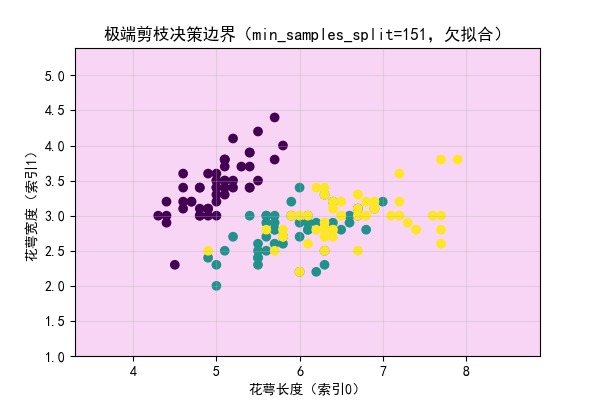
min_samples_split | 限制节点可划分的最小样本数,样本数不足则不再划分 | 正整数 | 数值越大,模型越简单 | 151(极端剪枝,总样本150) |
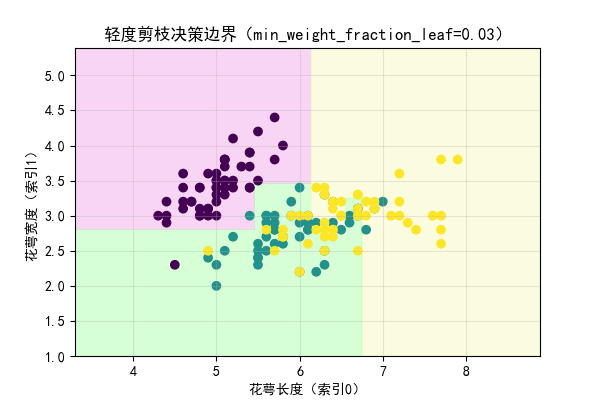
min_weight_fraction_leaf | 限制叶子节点的最小权重占比(未加权时为样本数占比),低于则不再划分 | 0~1的浮点数 | 数值越大,叶子节点越“大” | 0.03(轻度剪枝) |
criterion(基础) | 划分准则,本次沿用基尼系数 | 字符串 | gini/entropy | gini(默认) |
4. 核心可视化与工具函数说明
本次实验复用决策边界绘制和树结构可视化函数,核心工具与之前一致,作用如下:
| 函数/工具 | 功能 | 核心作用 |
|---|---|---|
decision_boundary_plot | 绘制决策树的二维决策边界 | 直观对比剪枝前后的边界复杂度 |
plot_tree | 可视化决策树的完整结构 | 观察树的深度、节点数、划分条件 |
plt.scatter | 绘制鸢尾花数据集散点图 | 展示原始样本分布 |
DecisionTreeClassifier | Sklearn决策树分类器核心类 | 配置剪枝参数并训练模型 |
7-6-决策树剪枝
决策树过拟合问题
# 导入数值计算库numpy,用于数值计算和网格点生成
import numpy as np
# 导入matplotlib的pyplot模块,用于绘制散点图、决策边界和树结构
import matplotlib.pyplot as plt
# 解决matplotlib绘图中文显示乱码问题(核心添加,小白必加)
plt.rcParams['font.sans-serif'] = ['SimHei']
# 解决matplotlib绘图负号显示异常问题(核心添加)
plt.rcParams['axes.unicode_minus'] = False
# 从sklearn数据集模块导入鸢尾花数据集加载函数
from sklearn.datasets import load_iris

# 加载鸢尾花数据集(3分类,4特征,150样本,3类各50个)
iris = load_iris()
# 提取前2个特征(索引0和1)作为训练特征x,二维特征方便绘制决策边界
x = iris.data[:,0:2]
# 提取数据集标签y(0/1/2对应3种鸢尾花)
y = iris.target
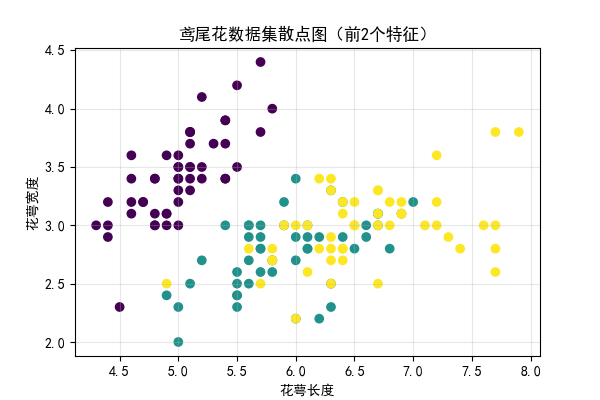
# 绘制鸢尾花数据集原始散点图,直观展示样本分布
# x[:,0]:第一个特征为x轴,x[:,1]:第二个特征为y轴,c=y:按标签分配颜色,区分不同类别
plt.scatter(x[:,0], x[:,1], c = y)
# 添加图表标题和坐标轴标签,方便解读
plt.title('鸢尾花数据集散点图(前2个特征)')
plt.xlabel('特征1(花萼长度,索引0)')
plt.ylabel('特征2(花萼宽度,索引1)')
# 显示散点图
plt.show()
# 图形解读:0类样本可部分分离,1类和2类样本高度重叠,是决策树过拟合的重要诱因
# 从sklearn树模块导入决策树分类器
from sklearn.tree import DecisionTreeClassifier

# 初始化决策树分类器:无任何剪枝参数限制,让树无限制生长(必然过拟合)
# criterion='gini'为默认值,可省略;无max_depth/min_samples_split等参数,树会生长至所有节点纯净化
clf = DecisionTreeClassifier()
# 用训练特征x和标签y训练决策树,无参数限制下树会无限制划分
clf.fit(x, y)
# 定义决策边界绘制函数(与之前一致,超详细注释适合小白理解)
# X:特征数据,y:标签数据,clf:训练好的决策树模型
def decision_boundary_plot(X, y, clf):
    # 确定x轴(特征1)的范围:比原始数据最小/最大值各延伸1,让决策边界更完整
    axis_x1_min, axis_x1_max = X[:,0].min() - 1, X[:,0].max() + 1
    # 确定y轴(特征2)的范围:同上
    axis_x2_min, axis_x2_max = X[:,1].min() - 1, X[:,1].max() + 1

    # 生成网格点:步长0.01表示网格密度(越小越平滑),用于绘制连续的决策边界
    # np.meshgrid:将一维数组转为二维网格,覆盖整个特征空间
    x1, x2 = np.meshgrid( np.arange(axis_x1_min,axis_x1_max, 0.01) , np.arange(axis_x2_min,axis_x2_max, 0.01))
    # 预测所有网格点的类别:np.c_[]按列拼接x1和x2,ravel()将二维转为一维(适配模型输入格式)
    z = clf.predict(np.c_[x1.ravel(),x2.ravel()])
    # 将预测结果还原为网格形状,与x1/x2匹配,用于填充轮廓
    z = z.reshape(x1.shape)

    # 从matplotlib颜色模块导入自定义颜色映射,用于决策边界的填充色
    from matplotlib.colors import ListedColormap
    # 定义3种浅色系,对应鸢尾花的3个类别,颜色柔和不刺眼
    custom_cmap = ListedColormap(['#F5B9EF','#BBFFBB','#F9F9CB'])

    # 绘制填充轮廓图:展示决策边界,不同颜色代表不同的预测类别
    plt.contourf(x1, x2, z, cmap=custom_cmap)
    # 绘制原始样本的散点图,按真实标签上色,与决策边界对比
    plt.scatter(X[:,0], X[:,1], c=y)
    # 显示图形
    plt.show()
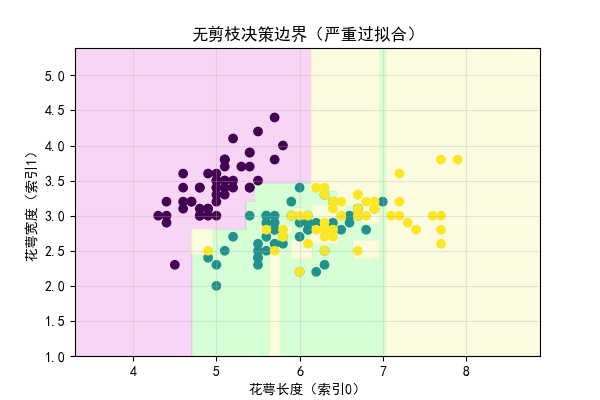
# 调用决策边界绘制函数,展示**无剪枝决策树**的分类结果
decision_boundary_plot(x,y,clf)
# 过拟合特征解读(核心):
# 1. 决策边界极其复杂,出现大量锯齿状、不规则的分割,完全贴合训练集样本;
# 2. 原本重叠的1类/2类样本被强行分割,模型学习了训练集的细节而非整体规律;
# 3. 这种边界对新数据的适应性极差,泛化能力严重不足。
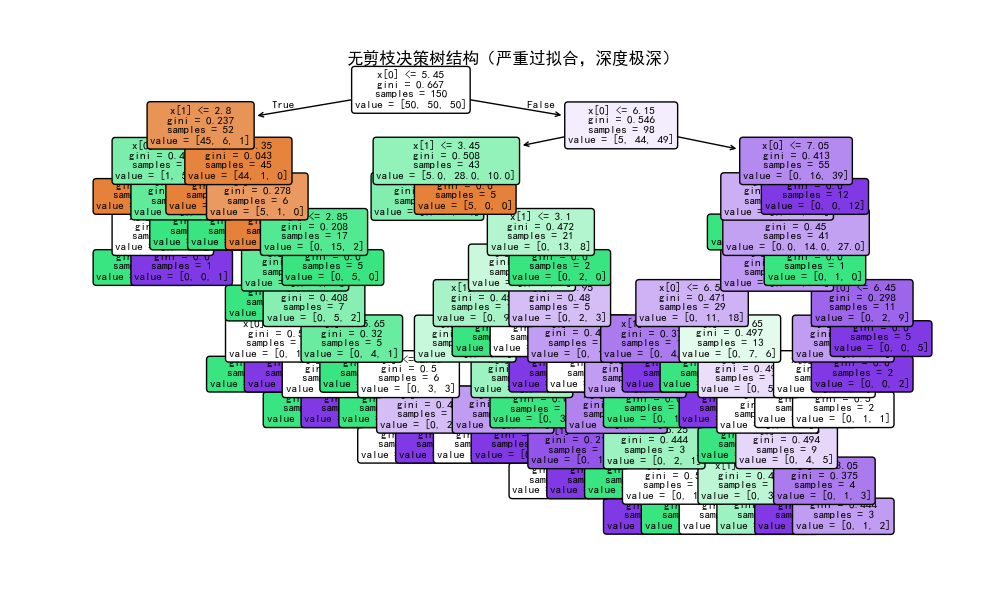
# 从sklearn树模块导入决策树可视化函数,绘制无剪枝的树结构
from sklearn.tree import plot_tree
# 绘制树结构(Jupyter自动显示,PyCharm需加plt.show())
plot_tree(clf)
plt.title('无剪枝决策树结构(过拟合)')
plt.show()
# 过拟合树结构解读(核心):
# 1. 树的**深度极深**(远超实际需要),节点数量多达上百个;
# 2. 大量叶子节点仅包含**1个样本**,基尼系数为0(纯净化);
# 3. 划分条件极其琐碎,模型过度“记忆”训练集的个别样本特征,而非通用规律。
决策树剪枝
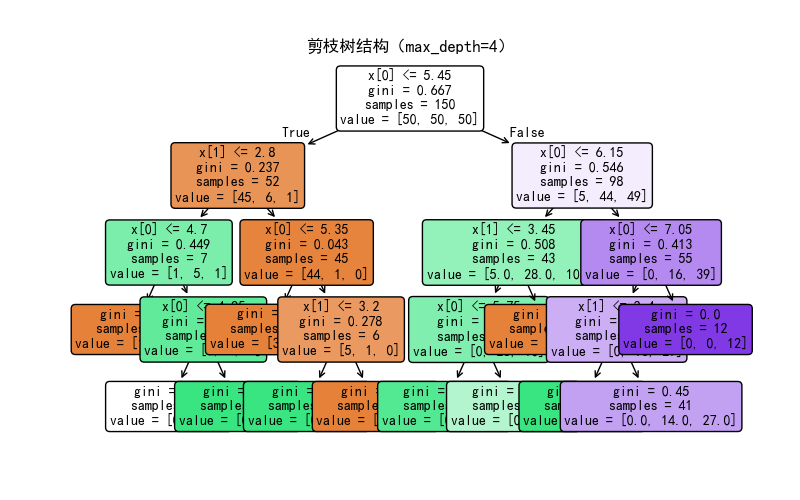
剪枝参数1:max_depth(限制树的最大深度,最常用)
# 初始化决策树分类器:设置max_depth=4,限制树的最大深度为4(预剪枝核心参数)
# max_depth:根节点深度为0,树的最大层数为4,超过则停止生长,从源头限制复杂度
clf = DecisionTreeClassifier(max_depth=4)
# 训练剪枝后的决策树
clf.fit(x, y)
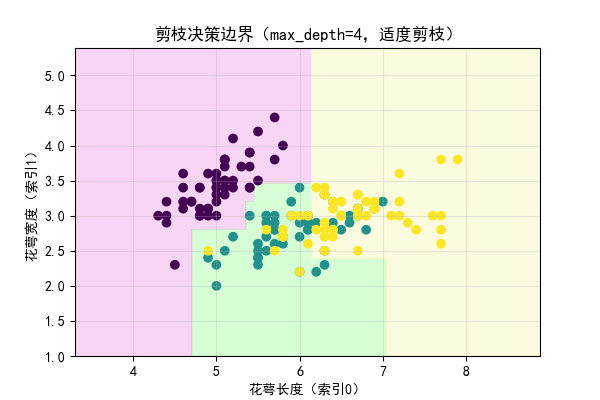
# 绘制剪枝后的决策边界
decision_boundary_plot(x, y, clf)
# 绘制剪枝后的树结构
plot_tree(clf)
plt.title('剪枝决策树结构(max_depth=4)')
plt.show()
# 剪枝效果解读(核心):
# 1. 决策边界:变得**平滑简洁**,锯齿状分割大幅减少,不再强行贴合个别样本;
# 2. 树结构:深度被限制为4,节点数量大幅减少,划分条件更通用;
# 3. 模型复杂度:显著降低,泛化能力大幅提升,同时保留了有效的分类规律。
剪枝参数2:min_samples_split(限制节点可划分的最小样本数)
# 初始化决策树分类器:设置min_samples_split=151,极端剪枝参数
# min_samples_split:节点划分的**最小样本数**,样本数不足则无法划分
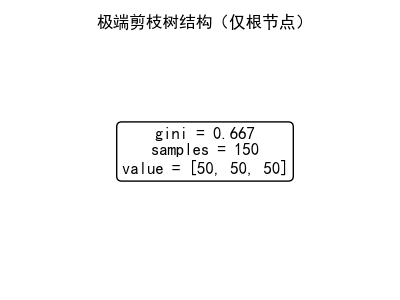
# 总样本数为150,设置151表示**所有节点都无法划分**,树只能保留根节点
clf = DecisionTreeClassifier(min_samples_split=151)
# 训练极端剪枝后的决策树
clf.fit(x, y)
# 绘制决策边界
decision_boundary_plot(x, y, clf)
# 绘制树结构
plot_tree(clf)
plt.title('极端剪枝决策树结构(min_samples_split=151)')
plt.show()
# 剪枝效果解读(核心):
# 1. 决策边界:整个特征空间为**单一颜色**,模型未进行任何分类,属于**欠拟合**;
# 2. 树结构:仅包含**根节点**,无任何划分条件,基尼系数为0.667(原始数据集不纯度);
# 3. 参数意义:该参数**数值越大**,节点划分的门槛越高,模型越简单,易欠拟合;
#    实际调参需从2开始逐步增大,找到“泛化能力最优”的临界点。
剪枝参数3:min_weight_fraction_leaf(限制叶子节点的最小权重占比)
# 初始化决策树分类器:设置min_weight_fraction_leaf=0.03,轻度剪枝参数
# min_weight_fraction_leaf:叶子节点的**最小权重占比**(未加权时为样本数占比)
# 0.03表示:叶子节点的样本数占总样本数的比例不得低于3%(150*0.03=4.5,即至少5个样本)
# 作用:避免生成仅包含极少数样本的叶子节点(过度拟合的典型特征)
clf = DecisionTreeClassifier(min_weight_fraction_leaf=0.03)
# 训练轻度剪枝后的决策树
clf.fit(x, y)
# 绘制决策边界
decision_boundary_plot(x, y, clf)
# 绘制树结构
plot_tree(clf)
plt.title('轻度剪枝决策树结构(min_weight_fraction_leaf=0.03)')
plt.show()
# 剪枝效果解读(核心):
# 1. 决策边界:比无剪枝简洁,比max_depth=4稍复杂,属于**轻度剪枝**;
# 2. 树结构:无极端浅的叶子节点,所有叶子节点的样本数都不低于5个,避免了学习噪声;
# 3. 适用场景:适合解决“叶子节点样本数过少”导致的过拟合,常与max_depth配合使用。
可直接运行代码版本(两个版本,适配不同环境)
版本1:Jupyter Notebook版(原结构+超详细注释+中文显示+可分单元格运行)
# ==============================================
# 决策树过拟合问题
# ==============================================
import numpy as np
import matplotlib.pyplot as plt
# 解决中文显示问题
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 加载鸢尾花数据集
from sklearn.datasets import load_iris
iris = load_iris()
x = iris.data[:,0:2]  # 提取前2个特征方便可视化
y = iris.target

# 绘制原始数据集散点图
plt.scatter(x[:,0], x[:,1], c = y)
plt.title('鸢尾花数据集散点图(前2个特征)')
plt.xlabel('花萼长度(索引0)')
plt.ylabel('花萼宽度(索引1)')
plt.show()

# 训练无剪枝决策树(过拟合)
from sklearn.tree import DecisionTreeClassifier
clf = DecisionTreeClassifier()  # 无任何剪枝参数
clf.fit(x, y)

# 定义决策边界绘制函数
def decision_boundary_plot(X, y, clf):
    axis_x1_min, axis_x1_max = X[:,0].min() - 1, X[:,0].max() + 1
    axis_x2_min, axis_x2_max = X[:,1].min() - 1, X[:,1].max() + 1
    x1, x2 = np.meshgrid( np.arange(axis_x1_min,axis_x1_max, 0.01) , np.arange(axis_x2_min,axis_x2_max, 0.01))
    z = clf.predict(np.c_[x1.ravel(),x2.ravel()])
    z = z.reshape(x1.shape)
    from matplotlib.colors import ListedColormap
    custom_cmap = ListedColormap(['#F5B9EF','#BBFFBB','#F9F9CB'])
    plt.contourf(x1, x2, z, cmap=custom_cmap)
    plt.scatter(X[:,0], X[:,1], c=y)
    plt.title('决策边界(无剪枝-过拟合)')
    plt.show()

# 绘制无剪枝决策边界
decision_boundary_plot(x,y,clf)

# 可视化无剪枝树结构
from sklearn.tree import plot_tree
plot_tree(clf)
plt.title('无剪枝决策树结构(过拟合)')
plt.show()

# ==============================================
# 决策树剪枝 - 三大核心参数实战
# ==============================================
# 1. 剪枝参数:max_depth(限制最大深度,最常用)
print("="*50, "剪枝参数1:max_depth=4", "="*50)
clf1 = DecisionTreeClassifier(max_depth=4)
clf1.fit(x, y)
decision_boundary_plot(x, y, clf1)
plot_tree(clf1)
plt.title('剪枝树结构(max_depth=4)')
plt.show()

# 2. 剪枝参数:min_samples_split(限制节点最小划分样本数,极端剪枝)
print("="*50, "剪枝参数2:min_samples_split=151", "="*50)
clf2 = DecisionTreeClassifier(min_samples_split=151)
clf2.fit(x, y)
decision_boundary_plot(x, y, clf2)
plot_tree(clf2)
plt.title('极端剪枝树结构(min_samples_split=151)')
plt.show()

# 3. 剪枝参数:min_weight_fraction_leaf(限制叶子节点权重占比,轻度剪枝)
print("="*50, "剪枝参数3:min_weight_fraction_leaf=0.03", "="*50)
clf3 = DecisionTreeClassifier(min_weight_fraction_leaf=0.03)
clf3.fit(x, y)
decision_boundary_plot(x, y, clf3)
plot_tree(clf3)
plt.title('轻度剪枝树结构(min_weight_fraction_leaf=0.03)')
plt.show()
版本2:PyCharm版(无if name+整合所有代码+可直接运行+带结果解读)
# ==============================================
# 7-6 决策树剪枝
# PyCharm版:无main,可直接运行,中文显示+详细注释+结果解读
# 核心:过拟合分析 + 三大预剪枝参数实战(鸢尾花数据集)
# ==============================================
# 1. 导入所有所需库并解决中文/负号显示问题
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier, plot_tree
from matplotlib.colors import ListedColormap

# 2. 定义通用工具函数(决策边界绘制)
def decision_boundary_plot(X, y, clf, title):
    """
    绘制决策树决策边界
    X:特征数据
    y:标签数据
    clf:训练好的决策树模型
    title:图表标题
    """
    axis_x1_min, axis_x1_max = X[:,0].min() - 1, X[:,0].max() + 1
    axis_x2_min, axis_x2_max = X[:,1].min() - 1, X[:,1].max() + 1
    x1, x2 = np.meshgrid(np.arange(axis_x1_min, axis_x1_max, 0.01),
                         np.arange(axis_x2_min, axis_x2_max, 0.01))
    z = clf.predict(np.c_[x1.ravel(), x2.ravel()]).reshape(x1.shape)
    custom_cmap = ListedColormap(['#F5B9EF','#BBFFBB','#F9F9CB'])
    plt.figure(figsize=(6, 4))
    plt.contourf(x1, x2, z, cmap=custom_cmap, alpha=0.6)
    plt.scatter(X[:,0], X[:,1], c=y, cmap='viridis')
    plt.title(title)
    plt.xlabel('花萼长度(索引0)')
    plt.ylabel('花萼宽度(索引1)')
    plt.grid(alpha=0.3)
    plt.show()

# 3. 加载并可视化鸢尾花数据集
iris = load_iris()
x = iris.data[:, 0:2]  # 前2个特征,方便可视化
y = iris.target        # 3分类标签:0/1/2
# 绘制原始数据集散点图
plt.figure(figsize=(6, 4))
plt.scatter(x[:,0], x[:,1], c=y, cmap='viridis')
plt.title('鸢尾花数据集散点图(前2个特征)')
plt.xlabel('花萼长度')
plt.ylabel('花萼宽度')
plt.grid(alpha=0.3)
plt.show()
print("✅ 数据集加载完成:特征形状{},标签形状{},总样本数{}".format(x.shape, y.shape, len(y)))
print("="*80)

# 4. 训练无剪枝决策树,展示过拟合问题
clf_no_prune = DecisionTreeClassifier()
clf_no_prune.fit(x, y)
# 绘制过拟合决策边界
decision_boundary_plot(x, y, clf_no_prune, '无剪枝决策边界(严重过拟合)')
# 可视化过拟合树结构(仅展示前10层,避免图形过大)
plt.figure(figsize=(10, 6))
plot_tree(clf_no_prune, filled=True, rounded=True, fontsize=8)
plt.title('无剪枝决策树结构(严重过拟合,深度极深)')
plt.show()
print("❌ 无剪枝决策树特征:深度极深、节点极多、决策边界复杂,严重过拟合")
print("="*80)

# 5. 预剪枝参数实战:三大核心参数调优
# 5.1 参数1:max_depth(限制最大深度,最常用,适度剪枝)
clf_depth = DecisionTreeClassifier(max_depth=4)
clf_depth.fit(x, y)
decision_boundary_plot(x, y, clf_depth, '剪枝决策边界(max_depth=4,适度剪枝)')
plt.figure(figsize=(8, 5))
plot_tree(clf_depth, filled=True, rounded=True, fontsize=10)
plt.title('剪枝树结构(max_depth=4)')
plt.show()
print("✅ max_depth=4剪枝效果:决策边界简洁,树结构深度可控,泛化能力提升")
print("="*80)

# 5.2 参数2:min_samples_split(限制最小划分样本数,极端剪枝)
clf_split = DecisionTreeClassifier(min_samples_split=151)  # 总样本150,无法划分
clf_split.fit(x, y)
decision_boundary_plot(x, y, clf_split, '极端剪枝决策边界(min_samples_split=151,欠拟合)')
plt.figure(figsize=(4, 3))
plot_tree(clf_split, filled=True, rounded=True, fontsize=12)
plt.title('极端剪枝树结构(仅根节点)')
plt.show()
print("✅ min_samples_split=151剪枝效果:无任何划分,仅根节点,属于欠拟合(演示用)")
print("="*80)

# 5.3 参数3:min_weight_fraction_leaf(限制叶子节点权重占比,轻度剪枝)
clf_leaf = DecisionTreeClassifier(min_weight_fraction_leaf=0.03)
clf_leaf.fit(x, y)
decision_boundary_plot(x, y, clf_leaf, '轻度剪枝决策边界(min_weight_fraction_leaf=0.03)')
plt.figure(figsize=(10, 6))
plot_tree(clf_leaf, filled=True, rounded=True, fontsize=8)
plt.title('轻度剪枝树结构(min_weight_fraction_leaf=0.03)')
plt.show()
print("✅ min_weight_fraction_leaf=0.03剪枝效果:无小样本叶子节点,轻度降低模型复杂度")
print("="*80)

# 6. 实验总结
print("📌 决策树剪枝核心结论:")
print("1. 无剪枝决策树必然过拟合,表现为决策边界复杂、树结构极深;")
print("2. 预剪枝通过参数限制树生长,是解决过拟合的高效手段,max_depth为最常用参数;")
print("3. 剪枝参数需合理调参,过严会导致欠拟合,过松会导致过拟合;")
print("4. 实际应用中建议多参数配合使用(如max_depth + min_samples_split)。")
print("✅ 7-6 决策树剪枝所有实验完成!")
学习小结(关键要点+高频易错点)
1. 核心要点
- 决策树过拟合的本质:无限制的贪心划分导致模型过度学习训练集的细节和噪声,忽略了数据的整体规律,模型复杂度远高于实际需要;
- 剪枝的核心目标:降低模型复杂度,舍弃对泛化能力无贡献的冗余划分,提升模型对新数据的泛化能力;
- 预剪枝的核心逻辑:训练前通过参数设置树的生长门槛,从源头避免树的过度生长,实现简单、高效的过拟合解决;
- 三大核心预剪枝参数的作用:
max_depth:限制树的最大深度,最常用、调参最直观,是预剪枝的首选参数;min_samples_split:限制节点划分的最小样本数,数值越大,模型越简单;min_weight_fraction_leaf:限制叶子节点的最小样本占比,避免生成仅含极少数样本的叶子节点;
- 剪枝的关键原则:适度剪枝——既避免过拟合(决策边界简洁、树结构简单),又不出现欠拟合(保留有效的分类规律);
- 过拟合与欠拟合的平衡:剪枝参数需从宽松到严格逐步调优,通过验证集准确率寻找“泛化能力最优”的临界点。
2. 高频易错点
- 参数调优方向混淆:
max_depth越小、min_samples_split越大、min_weight_fraction_leaf越大,剪枝越严格,模型越简单,易欠拟合;反之则剪枝越宽松,易过拟合; - 极端参数的意义:
min_samples_split=151是演示用极端参数(总样本150),实际调参需从2开始逐步增大,切勿直接使用; - PyCharm绘图显示问题:使用
plot_tree绘制树结构后,必须手动添加plt.show() 才能显示图形,Jupyter中可自动显示; - 特征维度的影响:本次仅用2个特征做可视化,实际应用中特征数更多,过拟合更严重,需更严格的剪枝参数;
- 预剪枝与后剪枝的混淆:Sklearn中默认所有剪枝参数均为预剪枝,后剪枝需单独配置(如
ccp_alpha),新手优先掌握预剪枝; - 单一参数的局限性:实际调参中建议多参数配合使用(如
max_depth=5 + min_samples_split=10),比单一参数调优效果更好。
拓展延伸
本次实验基于鸢尾花数据集的2个特征展示了预剪枝的基本用法,后续可结合更复杂的场景深入学习,提升实战能力:
- 多特征数据集剪枝:使用鸢尾花数据集的全部4个特征,对比2特征和4特征下的过拟合程度,调整剪枝参数;
- 验证集调参实战:将数据集按7:3划分为训练集和验证集,遍历
max_depth(1-10)、min_samples_split(2-20)等参数,以验证集准确率为指标,找到最优参数组合; - 多参数联合调优:使用Sklearn的
GridSearchCV/RandomizedSearchCV进行网格搜索,自动寻找最优剪枝参数组合,提升调参效率; - 后剪枝尝试:学习Sklearn的
ccp_alpha参数(代价复杂度剪枝),实现决策树的后剪枝,对比预剪枝和后剪枝的效果差异; - 过拟合量化分析:计算无剪枝和剪枝后模型在训练集和测试集的准确率,量化对比泛化能力的提升;
- 不同数据集的剪枝规律:使用分类误差更大、样本更复杂的数据集(如葡萄酒数据集、乳腺癌数据集),总结剪枝参数的调优规律。
运行结果
✅ 数据集加载完成:特征形状(150, 2),标签形状(150,),总样本数150
================================================================================
❌ 无剪枝决策树特征:深度极深、节点极多、决策边界复杂,严重过拟合
================================================================================
✅ max_depth=4剪枝效果:决策边界简洁,树结构深度可控,泛化能力提升
================================================================================
✅ min_samples_split=151剪枝效果:无任何划分,仅根节点,属于欠拟合(演示用)
================================================================================
✅ min_weight_fraction_leaf=0.03剪枝效果:无小样本叶子节点,轻度降低模型复杂度
================================================================================
📌 决策树剪枝核心结论:
1. 无剪枝决策树必然过拟合,表现为决策边界复杂、树结构极深;
2. 预剪枝通过参数限制树生长,是解决过拟合的高效手段,max_depth为最常用参数;
3. 剪枝参数需合理调参,过严会导致欠拟合,过松会导致过拟合;
4. 实际应用中建议多参数配合使用(如max_depth + min_samples_split)。
✅ 7-6 决策树剪枝所有实验完成!

进程已结束,退出代码为 0
更多推荐

 4
 0
- 0


 已为社区贡献168条内容

所有评论(0)