
机器学习-决策树剪枝处理(C++/Python实现)
一、剪枝
1.1剪枝的作用
在决策树模型中进行预剪枝和后剪枝,核心目的是解决决策树的过拟合问题,同时在模型复杂度和泛化能力之间找到最优平衡,让模型在训练集之外的新数据上也能有稳定的预测效果,这也是剪枝的核心意义。
1.2预剪枝
构建树的过程中提前停止分支(如限制树的最大深度、设置叶节点最小样本数),从源头避免生成复杂的树,防止过拟合。
优点:高效,计算量小
缺点:过于简单粗暴,容易出现欠拟合的情况
算法:基于验证集的早停法
算法思路:
比较长出枝干和没长出枝干的模型的准确率,如果长出枝干后模型效果更好,就保留枝干,否则剪枝。
优点:泛化能力强,逻辑直观
缺点:需要额外划分验证集的数据出来,训练数据减少,噪点的影响被放大,可能提前停止生长,导致欠拟合。
1.3后剪枝
后剪枝是一类在决策树生成后,对模型进行剪枝处理的算法。
算法:错误率降低剪枝
算法思路:
和“基于验证集的早停法”类似,我们还是通过比较剪枝前后的准确率来决定是否需要剪枝。
优点:逻辑直观,实现简单
缺点:依赖验证集,占用数据集资源,导致噪声的影响变大,容易使生成的模型泛化能力降低,通过后剪枝可能进一步降低模型的泛化能力,甚至导致模型欠拟合。
二、C++实现
2.1 C++实现
2.1.1 预剪枝
double tree_accuracy(DecisionTreeNode* root, std::vector<std::vector<int>>& features, std::vector<int>& tags)
{
	if (!tags.size())
		return 0.0;
	double passive = 0;
	std::vector<std::vector<int>> test(features[0].size(), std::vector<int>(features.size()));
	for (int i = 0; i < features.size(); ++i)
	{
		for (int j = 0; j < features[i].size(); ++j)
		{
			test[j][i] = features[i][j];
		}
	}
	for (int i = 0; i < test.size(); ++i)
		passive += predict_type(root, test[i]) == tags[i];
	return passive / tags.size();
}

double tree_accuracy(int tag, std::vector<int>& tags)
{
	double passive = 0;
	for (int t : tags)
		passive += t == tag;
	return passive / tags.size();
}
为了正常使用predict_type函数,我们需要将features数据转换回以样本为行、以样本内容为列的数据。第一个重载的tree_accuracy函数,传入的features数据是已经转置的(在main函数中实现),下面update_mask生成的行遍历行为处理转置。然后两个重载函数都统计正确预测出来的比率,返回。这样就实现了“基于验证集的早停法”中的准确率的计算。
2.1.2后剪枝
DecisionTreeNode* post_pruning(DecisionTreeNode* root, std::vector<std::vector<int>>& verify_fs, std::vector<int>& verify_ts)
{
	if (root == nullptr)
		return nullptr;
	if (root->is_leaf)
		return root;
	for (int i = 0; i < root->Children.size(); ++i)
		root->Children[i] = post_pruning(root->Children[i], verify_fs, verify_ts);

	DecisionTreeNode* node = new DecisionTreeNode(root->major_type, -1, root->major_type);
	double origin = tree_accuracy(root, verify_fs, verify_ts);
	double modify = tree_accuracy(node, verify_fs, verify_ts);

	if (origin >= modify)
		return root;
	else
		return node;
}
为了实现剪枝的算法,我们需要提前将当前节点下的最多的结果类型保存下来,在DecisionTreeNode中添加一个major_type成员专门负责记录这个数据。
采用后序遍历的方法来实现决策树的递归遍历。比较两颗子树的准确率,选择合适的保留下来,返回最终选择的节点。
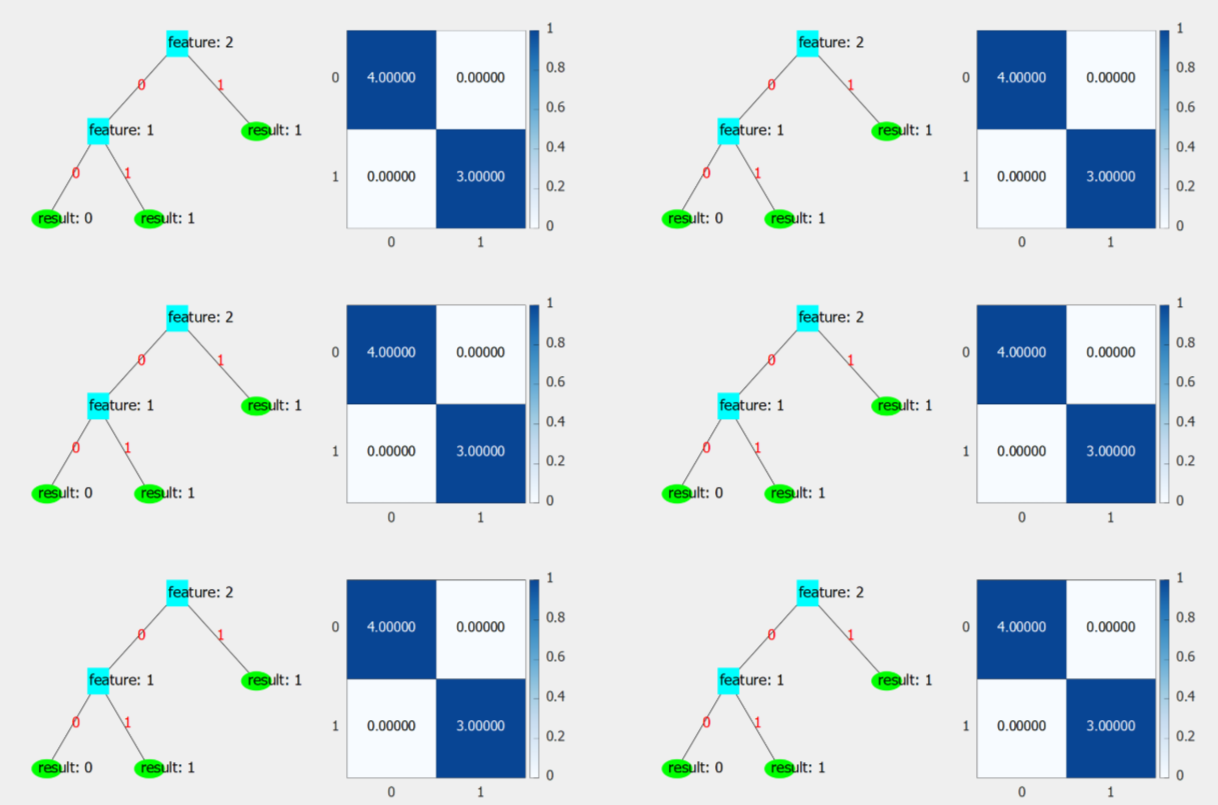
2.1.3运行结果
三、Python实现
3.1预剪枝
def core_create_tree(features: np.ndarray, tags: np.ndarray, idx_list: list[int], train_mask: np.ndarray,
                     classifier: callable([[np.ndarray, np.ndarray], int]),
                     verify_f: np.ndarray = None, verify_t: np.ndarray = None,
                     mask: np.ndarray = None, pruning = False
                     ) -> DecisionTreeNode | None:
    # 生成对应的训练集
    current_features = features[train_mask][:, idx_list]
    current_tags = tags[train_mask]
    max_tag = int(np.argmax(np.bincount(tags)))
    if len(np.unique(current_tags)) == 1:  # 如果预测类别只有一种,就停止决策树的生长
        return DecisionTreeNode(-1, current_tags[0], max_tag)
    if len(idx_list) == 0:  # 如果特征类别没了,没有能选择的特征,就停止决策树的生长
        return DecisionTreeNode(-1, max_tag, max_tag)

    # 获取最佳特征下标
    idx = classifier(current_features, current_tags)
    if idx == -1:
        return None
    value = current_features[:, idx]  # 获取特征列
    classes = np.unique(value)  # 获取特征类别

    # 更新数据集
    new_idx_list = copy.deepcopy(idx_list)
    new_idx_list.pop(idx)  # 删除特征列表中被选中的特征

    # 生成子节点
    children = []
    for cls in classes:
        # 生成训练集划分掩码
        sub_mask = copy.deepcopy(train_mask)
        sub_mask[train_mask] &= (value == cls)

        update_mask = (cls == verify_f[:, idx_list[idx]]) & mask if not mask is None else mask
        child = core_create_tree(features, tags, new_idx_list, sub_mask, classifier,
                                 verify_f, verify_t, update_mask, pruning)
        child.val = cls
        children.append(child)

    root = DecisionTreeNode(idx_list[idx], idx, max_tag, children)
    if pruning:
        from src.evaluation.evaluator import tree_accuracy

        current_ver_features = verify_f[mask]
        current_ver_tags = verify_t[mask]

        # 获取生成子树前的精度
        pre = tree_accuracy(None, max_tag, current_ver_tags)
        print(f"生成子树前的精度:{pre}")

        # 获取分裂后的精度
        mod = tree_accuracy(root, current_ver_features, current_ver_tags)
        print(f"生成子树后的精度:{mod}")

        if mod <= pre:
            return DecisionTreeNode(-1, max_tag, max_tag)

    return root
和C++一样,剪枝的相关操作都可以被放到一个代码块中实现,算法思路很简单,获取准确率->比较出最佳的子树->返回子树。
3.2后剪枝
def post_pruning(root: DecisionTreeNode, verify_f: np.ndarray, verify_t: np.ndarray) -> DecisionTreeNode | None:
    if root is None:
        return None
    if root.is_leaf:
        return root
    for idx, child in enumerate(root.children):
        root.children[idx] = post_pruning(child, verify_f, verify_t)
    post = tree_accuracy(root, verify_f, verify_t)
    node = DecisionTreeNode(-1, root.major_tag, root.major_tag)
    mod = tree_accuracy(node, verify_f, verify_t)

    return node if mod > post else root
和C++实现一样,采用先后序遍历,然后比较准确率,选择最佳子树返回。
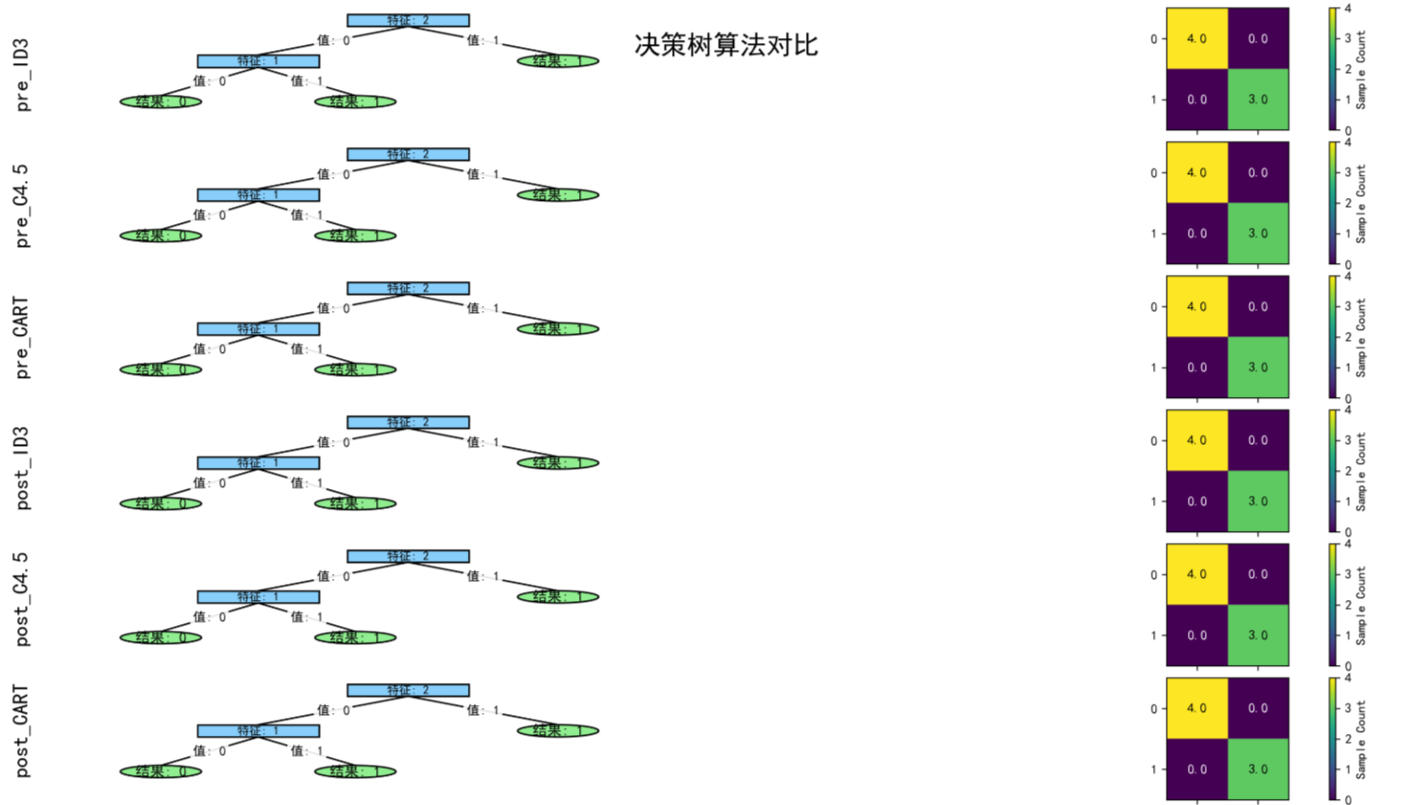
3.3运行结果
更多推荐

 6
 0
- 0


 已为社区贡献5条内容

所有评论(0)