- @weixin_47505105


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
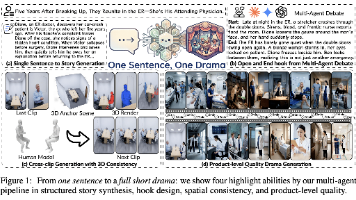
这篇工作的核心价值不在于某个单点技术的突破,而在于对短剧生成这一复杂系统工程的全面、深入的问题分解与方案设计——从叙事智能、空间智能到质量控制,构建了一条从"一句话创意"到"可发布短剧"的完整技术路径。
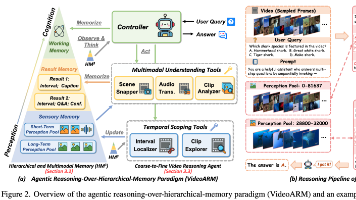
最大化利用MLLM自身的推理和规划能力。其运行方式类似ReAct,但以HM³作为持久化的层级记忆来接地。
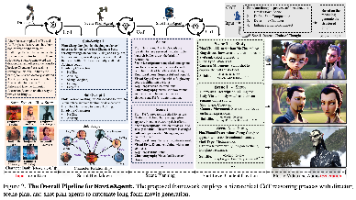
给定剧本摘要SSS和角色库CcharkIkAkk1LC{[charkIkAkk1L(包含角色名、肖像图、音频样本),目标是生成长视频V\hat{V}V,包含多场景、多镜头,同时保证叙事连贯、角色一致和音画同步。FSC→VFSC→V。
当前的视频生成模型(Sora、Veo、Wan、LTX-Video 等)已经能生成视觉上非常逼真的视频,但在物理规律层面存在系统性错误:球无缘无故变速、下落的物体无视重力、碰撞违反动量守恒。20 名志愿者对 197 组视频做盲评,NEWTON 在物理正确性(79.8%)和整体质量(47.4%)上均大幅领先 LTX-Video(11.3% / 31.9%)和 Wan2.2(8.9% / 20.7%)。
现代图像生成模型(如 Stable Diffusion、FLUX、Nano Banana Pro 等)的生成质量已经很强,但开放式图像生成远不是一个简单的"prompt → 图像"问题。现有的 agentic 生成系统(如 GenAgent、Gen-Searcher、Mind-Brush 等)已经开始用搜索、工具、记忆等方式增强图像生成,但它们通常只解决了生成过程中的某一环(获取外部证据、包装黑盒
VideoWeaver 将长视频生成定义为一个智能体技能组合任务:给定一个一次性的用户指令,智能体需要规划、调用多个基础技能、管理中间产物,最终生成一个连贯的长视频。数据集包含16 个任务类别、285 个测试用例,输入模态覆盖文本、图像、音频、视频及其组合。训练集 + 测试集:13 个类别(119 训练 + 123 测试)OOD 集:3 个类别(43 用例),用于评估泛化能力任务类别丰富多样,包括


它关注的问题不是“视频是否看起来真实”,而是“视频中的碰撞过程是否符合物理规律”。随着视频生成模型和 world model 的发展,自动驾驶领域开始希望利用生成模型来模拟真实交通场景,尤其是一些现实中很少见但非常重要的安全关键场景,例如车辆碰撞、突然变道、交叉路口冲突等。CrashTwin 通过“视频 → 3D 碰撞轨迹重建 → 物理一致性评估”的方式,评估 world model 是否真的能生
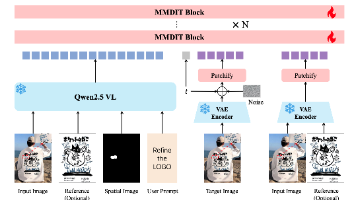
本文提出RefineAnything,一种针对图像局部细节修复的多模态区域精细化方法。针对现有模型在区域可控性、微细节恢复和背景漂移方面的问题,作者设计了Focus-and-Refine机制:通过区域裁剪-聚焦生成-无缝粘贴的三步策略,显著提升局部修复质量。方法基于Qwen-Image构建,结合多模态编码器和VAE潜空间表示,仅需LoRA微调。为支持训练,构建了包含30K样本的Refine-30K