- @weixin_44115575


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
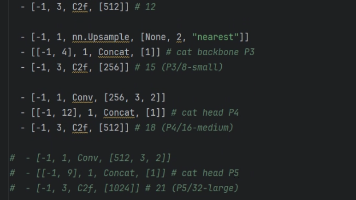
YOLOv8在速度和精度之间取得了卓越的平衡。然而,在许多实际应用场景中,我们可能并不需要模型具备检测所有尺寸目标的能力。例如,在针对行人或常规车辆的监控场景中,对超大尺寸目标的检测能力就显得有些多余。这些“多余”的能力不仅占用了宝贵的计算资源,也拖慢了模型的推理速度,尤其是在资源受限的边缘设备上。那么能否通过“裁剪”模型中负责大目标检测的部分,来为速度“减负”,实现更高效的推理呢?本文将以YOL
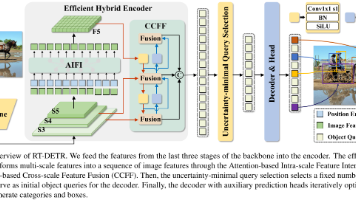
最近在啃 RT-DETR v1,一边对着论文,一边翻官方仓库的 PyTorch 实现,发现网上的很多介绍要么只停留在“架构大图”,要么只讲训练命令,真正把“每一层在干什么、张量长什么样、为什么这么设计”说清楚的资料不多。所以写了这篇学习笔记。下面我把在学习RT-DETR v1过程中的的整体思想 + 算法流程 + 各模块细节记录下来分享给大家
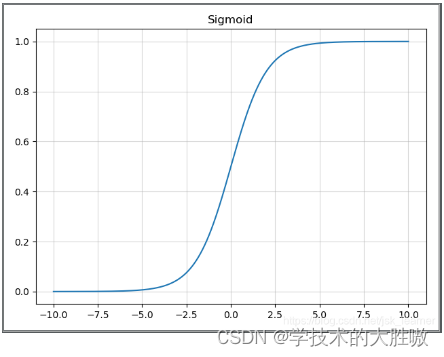
不同的激活函数有不同的输出范围,比如Sigmoid函数的输出在(0, 1)之间,Tanh函数的输出在(-1, 1)之间,ReLU函数的输出在[0, ∞)之间。在神经网络的基本结构中,每个神经元接收输入信号,对其进行加权求和后加上偏置项,然后将这个结果通过激活函数进行转换,得到神经元的输出。由于大多数实际问题都是非线性的,非线性激活函数使得神经网络能够拟合复杂的函数映射关系,从而解决非线性问题。:某
深度学习推理优化中常见"灵异现象"解析:首帧推理慢(400ms vs 6ms)源于CUDA初始化、cuDNN算法搜索等固定开销;正确计时需使用perf_counter()并同步GPU;batchsize影响显著但反常(14张图bs=8时更慢,16张图则快8倍),关键在于"残缺批"导致成本不均摊和算法缓存失效。解决方案:预热采用与推理一致的输入形状,确保数据集
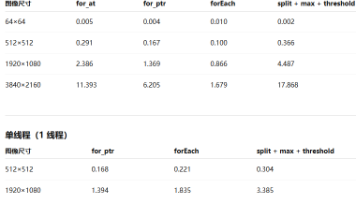
本文系统解析了OpenCV中mat.forEach<T>(lambda)的使用方法及其性能特点。该方法通过指定元素类型(如cv::Vec3b)和Lambda回调函数,实现了更现代的像素遍历方式。性能测试表明:在单线程下,传统for+ptr循环通常更快;但在大图(1080p/4K)和多线程场景下,forEach可显著提升性能(4K图像处理速度提升3.7倍)。关键优势在于将多步操作合并为单
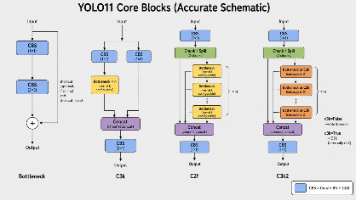
YOLO11在YOLOv8框架基础上进行了网络结构的优化改进,主要包括:1)用C3k2模块替换大量C2f模块,提高卷积特征提取效率;2)在Backbone深层加入C2PSA结构,通过分流设计(部分通道保留卷积特征、部分通道引入自注意力)实现全局关系建模;3)对检测头进行轻量化调整。这些改进使模型在保持检测性能的同时,提升了特征提取能力并降低了计算成本。其中C2PSA的创新设计尤为关键,它通过注意力
本文系统解析了OpenCV中mat.forEach<T>(lambda)的使用方法及其性能特点。该方法通过指定元素类型(如cv::Vec3b)和Lambda回调函数,实现了更现代的像素遍历方式。性能测试表明:在单线程下,传统for+ptr循环通常更快;但在大图(1080p/4K)和多线程场景下,forEach可显著提升性能(4K图像处理速度提升3.7倍)。关键优势在于将多步操作合并为单
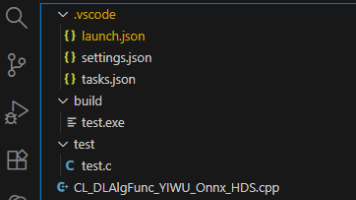
VSCode 通过插件的形式扩展了功能,支持各种编程语言和工具,但它不像 Visual Studio 那样开箱即用。因此,对于习惯了 VS 的开发者,理解和配置 VSCode 可能会让人觉得有些繁琐。尤其是调试配置和编译任务的管理,可能需要一些额外的理解。本文将结合一个 C++ 项目的实际目录结构,通过详细的分析 tasks.json、launch.json 和 settings.json 配置文
深度学习推理优化中常见"灵异现象"解析:首帧推理慢(400ms vs 6ms)源于CUDA初始化、cuDNN算法搜索等固定开销;正确计时需使用perf_counter()并同步GPU;batchsize影响显著但反常(14张图bs=8时更慢,16张图则快8倍),关键在于"残缺批"导致成本不均摊和算法缓存失效。解决方案:预热采用与推理一致的输入形状,确保数据集
实进行深度学习时,由于GPU都在服务器上,编辑代码很麻烦。并且服务器上配置了docker的环境,所以用pycharm连接远程服务器的docker进行深度学习,这样在本地调用远程服务器的GPU和环境,更方便一点,将这个过程记录下来,希望对大家有所帮助。