


- @weixin_43923463


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
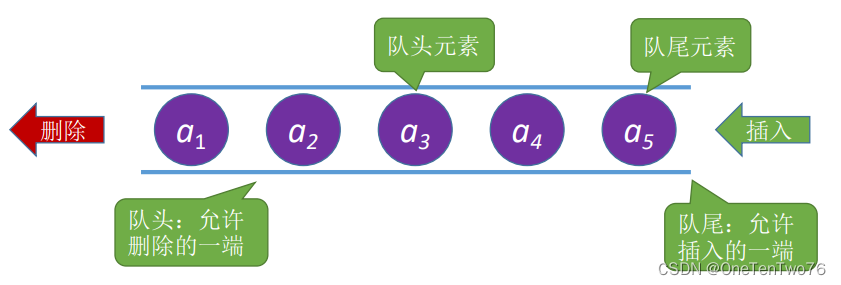
- 队列是一个有序列表,可以用数组或是链表来实现,只允许在一端进行插入,在另一端删除。- 遵循先入先出的原则。即:先存入队列的数据,要先取出。后存入的要后取出- 队列示意图如下:约定rear总是指向队尾元素,front指向当前队中队头元素的前一位置 。元素进队,rear增1,元素出队,front增1。当rear=MaxSize\-1时不能再进队。存入队列时称为”enQueue”,enQueue 的
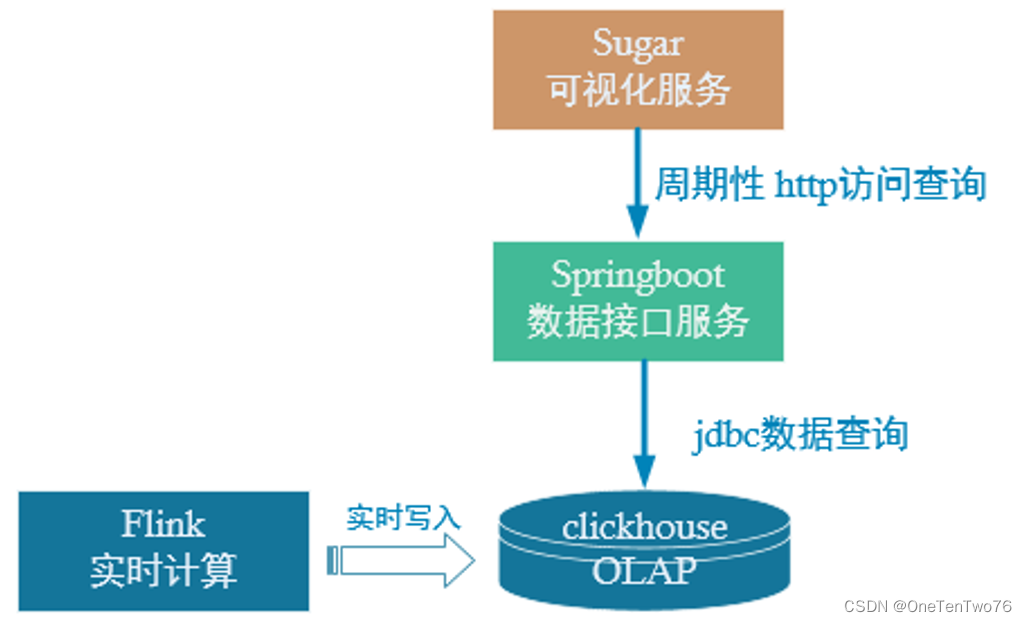
将表与表函数的结果进行 join 操作。左表(outer)中的每一行将会与调用表函数所产生的所有结果中相关联行进行 join 。用户自定义表函数( User-defined table functions,UDTFs ) 在执行前必须先注册。请参考 [UDF 文档]以获取更多关于指定和注册UDF的信息。之前数据分层处理,最后把轻度聚合的结果保存到ClickHouse中,主要的目的就是提供即时的数据
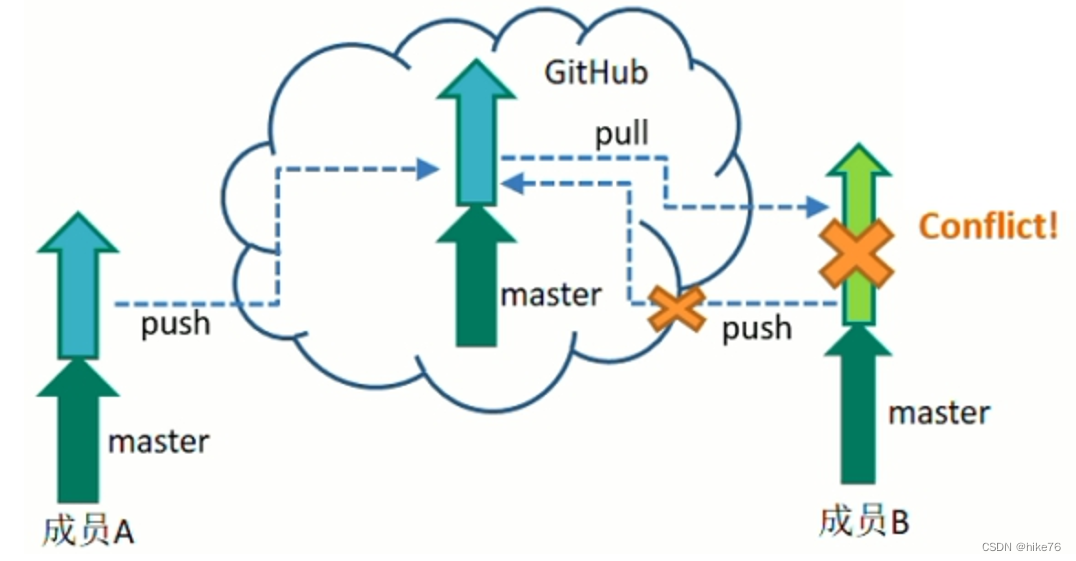
系统上线后,又要修改bug,又要开发新的功能。由于新功能没有开发完,所以需要建立分支,一边修改bug,一边开发新功能,最终合并。3 版本冲突(1)冲突产生新功能继续开发,但开发中途主干修复了bug,新功能也需要使用修复好的主干,这时就要以分支为主注意bug修复之后与新功能之间是否存在冲突也需要注意分支上和主干上同时进行了bug的修复,但修复的方式不一样,无论是主干与分支合并,还是分支与主干合并,最
拉链表,记录每条信息的生命周期,一旦一条记录的生命周期结束,就重新开始一条新的记录,并把当前日期放入生效开始日期。如果当前信息至今有效,在生效结束日期中填入一个极大值(如9999-99-99 )。表现的就是数据的变化过程。用户ID姓名手机号码开始日期结束日期1张三2019-01-012019-01-011张三2019-01-022019-01-091张三2019-01-109999-99-99。
Hive引擎包括:默认MR、tez、sparktez:MR的改进版,将MR静态的计算方法改成DAG有向图的计算,MR每进行一次MR都会落一次盘,然后再执行一次MR,DAG有向图则可以进行map、map、map、reduce、reduce…方式的计算,tez可以看做是弱化版的spark。Hive on Spark:Hive既作为存储元数据又负责SQL的解析优化,语法是HQL语法,执行引擎变成了Spa
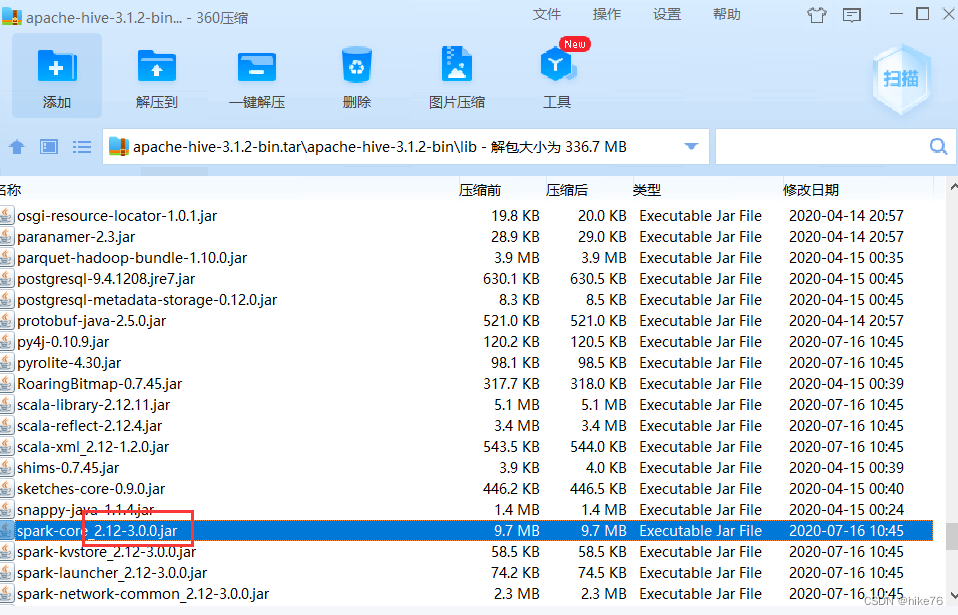
更换tez引擎后,如果执行任务卡住,修改调节容量调度器的资源调度策略,修改以下配置信息cd /opt/module/hadoop-3.1.3/etc/hadoop/vim tez-site.xml<!--容器给AM分配的资源--><property><name>tez.am.resource.memory.mb</name><value>
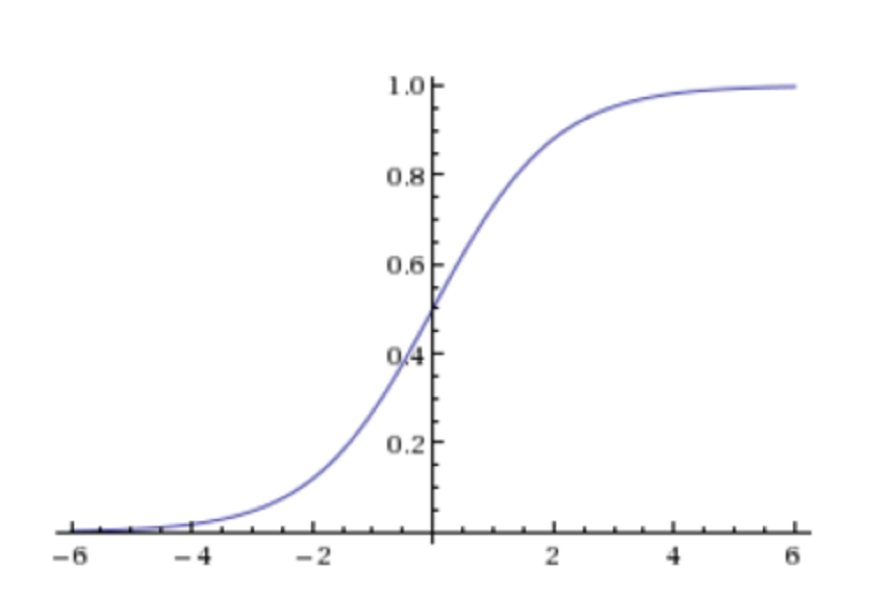
逻辑回归(Logistic Regression)是机器学习中的一种分类模型,逻辑回归是一种分类算法,它与回归之间有一定的联系,逻辑回归的输入就是线性回归的输出。由于算法的简单和高效,在实际中应用非常广泛。solver可选参数:{'liblinear', 'sag', 'saga','newton-cg', 'lbfgs'},默认: 'liblinear';用于优化问题的算法。对于小数据集来说,“
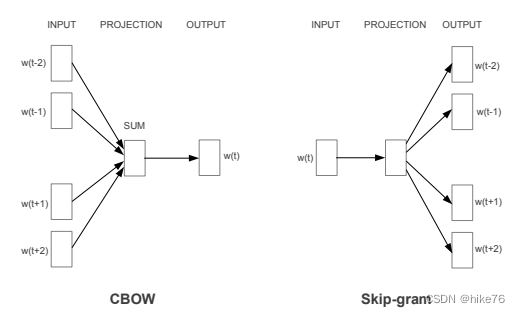
提出了两种新的模型架构,从大数据集中计算单词的连续向量表示1 介绍将words看做原子单位,词间没有相似度,因为word在词汇表中用索引表示,例如N-grams1.1 目标希望相似的单词往往彼此互相靠近,并且单词能够有多重相似度发现单词表示的相似度高于简单的语法规则,使用词偏移技术:V(“king”)- V(“man”) + V(“woman”)约等于V(“queen”“)设计1.2 前人工作词向
对句子进行分词之后,句子中不重要的词fastText是一个单词表示学习和文本分类的库优点:在标准的多核CPU上, 在10分钟之内能够训练10亿词级别语料库的词向量,能够在1分钟之内给30万多类别的50多万句子进行分类。fastText 模型输入一个词的序列(一段文本或者一句话),输出这个词序列属于不同类别的概率。
逻辑回归(Logistic Regression)是机器学习中的一种分类模型,逻辑回归是一种分类算法,它与回归之间有一定的联系,逻辑回归的输入就是线性回归的输出。由于算法的简单和高效,在实际中应用非常广泛。solver可选参数:{'liblinear', 'sag', 'saga','newton-cg', 'lbfgs'},默认: 'liblinear';用于优化问题的算法。对于小数据集来说,“